
Einführung
Daten und Informationen im Web wachsen exponentiell. Heute, wir alle nutzen Google als unsere erste Wissensquelle, entweder um Rezensionen zu einem Ort zu finden, um einen neuen Begriff zu verstehen. All diese Informationen sind bereits im Web verfügbar.
Mit der Menge der im Web verfügbaren Daten, eröffnet neue Horizonte der Möglichkeiten für a Datenwissenschaftler. Ich bin fest davon überzeugt, dass Web Scraping ein Muss für jeden Datenwissenschaftler ist.. In der realen Welt, alle benötigten Daten sind bereits im Internet verfügbar; Das einzige, was Sie daran hindert, sie zu verwenden, ist die Möglichkeit, darauf zuzugreifen. Mit Hilfe dieses Artikels, Du kannst auch diese Barriere überwinden.
Die meisten im Internet verfügbaren Daten sind nicht verfügbar. Es liegt in einem unstrukturierten Format vor (HTML-Format) und kann nicht heruntergeladen werden. Deswegen, Wissen und Erfahrung sind erforderlich, um diese Daten zu verwenden, um schließlich ein nützliches Modell bauen.
In diesem Artikel, Ich werde Sie durch den Web-Scraping-Prozess in R . führen. Mit diesem Artikel, Sie sammeln Erfahrungen mit jeder Art von Daten, die im Internet verfügbar sind.
Inhaltsverzeichnis
- Was ist Web-Scraping??
- Warum brauchen wir Web Scraping in Datenwissenschaft?
- Möglichkeiten zum Extrahieren von Daten
- Voraussetzungen
- Scraping einer Webseite mit R
- Analysieren Sie aus dem Web extrahierte Daten
1. Was ist Web-Scraping??
Web Scraping ist eine Technik, um die vorliegenden Daten in ein unstrukturiertes Format zu konvertieren (HTML-Tags) im Web in das strukturierte Format, das leicht zugänglich und verwendet werden kann.
Fast alle wichtigen Sprachen bieten Möglichkeiten zum Web-Scraping. In diesem Artikel, Wir werden R verwenden, um die Daten der beliebtesten Spielfilme von . zu extrahieren 2016 des IMDb Webseite.
Wir erhalten eine Reihe von Funktionen für jede der 100 beliebte Spielfilme veröffentlicht in 2016. Was ist mehr, Wir werden uns die häufigsten Probleme ansehen, die beim Extrahieren von Daten aus dem Internet aufgrund mangelnder Konsistenz auf der Website auftreten können. Code und sehen Sie, wie Sie diese Probleme lösen können.
Wenn Sie sich mit Python wohler fühlen, Ich empfehle Ihnen, diese Anleitung zu lesen, um mit dem Web-Scraping mit Python zu beginnen.
2. Warum brauchen wir Web Scraping?
Ich bin mir sicher, die ersten Fragen, die Ihnen bisher in den Sinn gekommen sein müssen, sind „Warum brauchen wir Web-Scraping“? Wie ich bereits gesagt habe, die Möglichkeiten mit Web Scraping sind immens.
Um Ihnen praktisches Wissen zu vermitteln, lass uns Daten aus IMDB extrahieren. Einige andere mögliche Anwendungen, für die Sie Web-Scraping verwenden können, sind:
- Extraktion von Filmbewertungsdaten, um Engines für Filmempfehlungen zu erstellen.
- Extrahieren Sie Textdaten aus Wikipedia und anderen Quellen, um NLP-basierte Systeme zu erstellen oder NLP-Modelle zu trainieren. tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... für Aufgaben wie das Erkennen von Themen aus dem vorgegebenen Text.
- Extrahieren Sie Daten aus markierten Bildern von Websites wie Google, Flickr, etc. um Bildklassifizierungsmodelle zu trainieren.
- Datensammlung von Social-Networking-Sites wie Facebook und Twitter zur Durchführung von Sentiment-Analyseaufgaben, Meinungsforschung, etc.
- Extrahieren Sie Meinungen und Kommentare von Benutzern von E-Commerce-Sites wie Amazon, Flipkart, etc.
3. Möglichkeiten zum Extrahieren von Daten
Es gibt mehrere Möglichkeiten, Daten aus dem Web zu extrahieren. Einige der beliebtesten Wege sind:
- Menschen kopieren und einfügen: Dies ist eine langsame und effiziente Möglichkeit, Daten aus dem Web zu extrahieren. Dies impliziert, dass der Mensch selbst die Daten analysiert und in den lokalen Speicher kopiert.
- Textmusterabgleich: Ein weiterer einfacher, aber leistungsstarker Ansatz zum Extrahieren von Informationen aus dem Web besteht darin, die Matching-Funktionen für reguläre Ausdrücke von Programmiersprachen zu verwenden.. Weitere Informationen zu regulären Ausdrücken finden Sie hier.
- Interfaz-API: Viele Websites wie Facebook, Twitter, LinkedIn, etc. öffentliche APIs bereitstellen und / oder privat, die mit Standardcode aufgerufen werden können, um die Daten im vorgeschriebenen Format abzurufen.
- DOM-Analyse: Durch die Verwendung von Webbrowsern, Programme können durch clientseitige Skripte generierte dynamische Inhalte abrufen. Es ist auch möglich, Webseiten in einem DOM-Baum zu parsen, abhängig von den Programmen, die Teile dieser Seiten abrufen können.
Im Verlauf dieses Artikels werden wir den DOM-Parsing-Ansatz verwenden.. Und verlassen Sie sich auf die CSS-Selektoren der Webseite, um die relevanten Felder zu finden, die die gewünschten Informationen enthalten. Aber bevor wir anfangen, Es gibt einige Voraussetzungen, die erforderlich sind, um Daten von einer Website kompetent zu extrahieren.
4. Bisherige Anforderungen
Die Voraussetzungen für die Durchführung von Web Scraping in R sind in zwei Gruppen unterteilt:
- Um mit Web-Scraping zu beginnen, muss über Kenntnisse der R-Sprache verfügen. Wenn Sie gerade erst anfangen oder die Grundlagen auffrischen möchten, Ich empfehle dringend, diesem Lernpfad in R . zu folgen. Im Laufe dieses Artikels, Wir werden das Paket verwenden ‚RVEST‘ in R geschrieben von Hadley Wickham. Sie können auf die Dokumentation des rvest-Pakets zugreifen hier. Stellen Sie sicher, dass Sie dieses Paket installiert haben. Wenn Sie dieses Paket noch nicht haben, Sie können dem folgenden Code folgen, um es zu installieren.
install.pakete('rvest')
- Das Hinzufügen von HTML- und CSS-Kenntnissen ist ein zusätzlicher Bonus. Eine der besten Quellen, die ich zum Erlernen von HTML und CSS finden konnte, ist ist. Ich habe beobachtet, dass die meisten Data Scientists nicht sehr solide technische Kenntnisse in HTML und CSS haben. Deswegen, Wir werden eine Open-Source-Software namens Selector Gadget verwenden, die für jeden mehr als ausreichend ist, um Web-Scraping durchzuführen. Sie können auf die Selector Gadget-Erweiterung zugreifen und diese herunterladen hier. Stellen Sie sicher, dass Sie diese Erweiterung installiert haben, indem Sie den Anweisungen auf der Website folgen. ich habe das gleiche gemacht. Ich verwende Google Chrome und kann in der Erweiterungsleiste oben rechts auf die Erweiterung zugreifen.
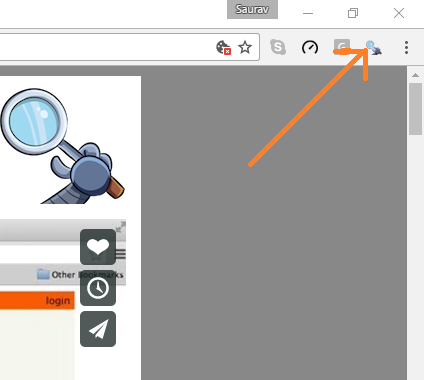
Mit diesem, Sie können die Teile einer beliebigen Website auswählen und die entsprechenden Tags abrufen, um auf diesen Teil zuzugreifen, indem Sie einfach auf diesen Teil der Website klicken. Bitte beachten Sie, dass dies eine Möglichkeit ist, HTML und CSS zu lernen und dies manuell zu tun. Aber um die Kunst des Web-Scrapings zu beherrschen, Ich empfehle Ihnen dringend, HTML und CSS zu lernen, um besser zu verstehen und zu schätzen, was unter der Haube passiert.
4. Scraping einer Webseite mit R
Jetzt, Beginnen wir mit der Suche auf der IMDb-Website nach dem 100 Die beliebtesten Spielfilme, die in veröffentlicht wurden 2016. Sie können darauf zugreifen hier.
#Laden des rvest-Pakets
Bücherei('rvest')

#Angeben der URL für die gewünschte Website, die gescrapt werden soll
URL <- 'http://www.imdb.com/search/title?zählen=100&release_date=2016,2016&title_type=feature'

#Reading the HTML code from the website
webpage <- read_html(URL)
Jetzt, Wir werden die folgenden Daten von dieser Website extrahieren.
- Rang: Die Bandbreite des Films von 1 ein 100 in der Liste der 100 Die beliebtesten Filme, die in . veröffentlicht wurden 2016.
- Qualifikation: Der Titel des Spielfilms.
- Beschreibung: Die Beschreibung des Spielfilms.
- Ausführungszeit: Die Länge des Spielfilms.
- Geschlecht: Das Genre des Spielfilms,
- Einstufung: Das IMDb-Rating des Spielfilms.
- Metascore: Der Metascore auf der IMDb-Website zum Spielfilm.
- Stimmen: Stimmen für den Spielfilm.
- Brutto_Einkommen_in_Tausenden: Der Bruttogewinn des Spielfilms in Millionen.
- Direktor: Der Hauptregisseur des Spielfilms. Beachten Sie, dass, bei mehreren Direktoren, Ich nehme nur die erste.
- Schauspieler: Der Hauptdarsteller des Spielfilms. Beachten Sie, dass, bei mehreren Akteuren, Ich nehme nur die erste.
Hier ist ein Screenshot, der zeigt, wie all diese Felder organisiert sind.
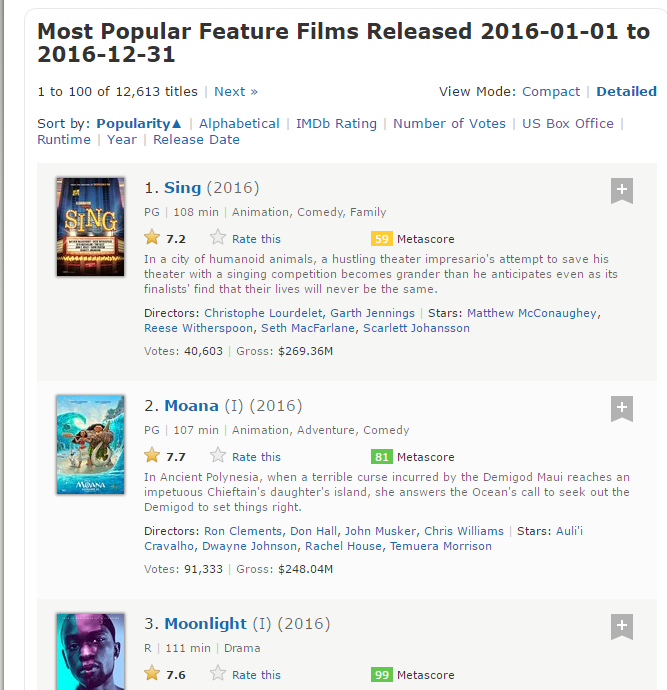
Paso 1: Jetzt, Wir beginnen damit, das Bereichsfeld abzukratzen. Dafür, Wir verwenden das Selektor-Gadget, um die spezifischen CSS-Selektoren zu erhalten, die die Klassifizierungen einschließen. Sie können in Ihrem Browser auf die Erweiterung klicken und mit dem Cursor das Sortierfeld auswählen.
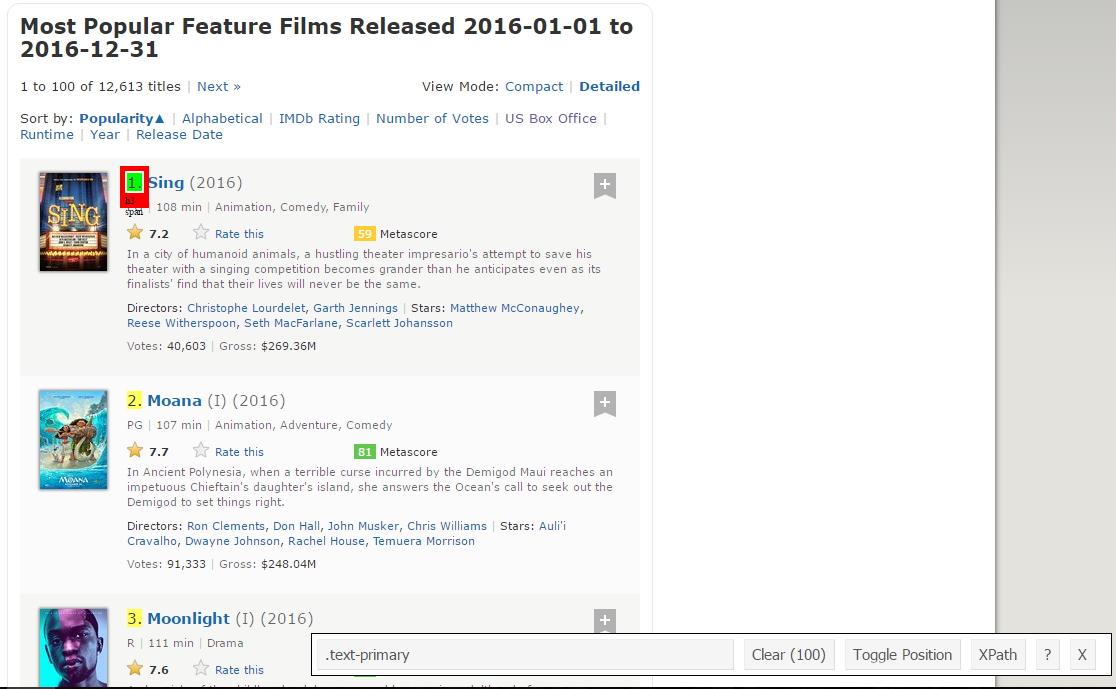
Stellen Sie sicher, dass alle Klassifizierungen ausgewählt sind. Sie können einige weitere Sortierabschnitte auswählen, falls Sie nicht alle davon erhalten, und Sie können sie auch abwählen, indem Sie auf den ausgewählten Abschnitt klicken, um sicherzustellen, dass Sie nur die markierten Abschnitte haben, die Sie für diese Zeit abkratzen möchten. .
Paso 2: Sobald Sie sicher sind, dass Sie die richtige Auswahl getroffen haben, Sie müssen den entsprechenden CSS-Selektor kopieren, den Sie unten in der Mitte sehen können.
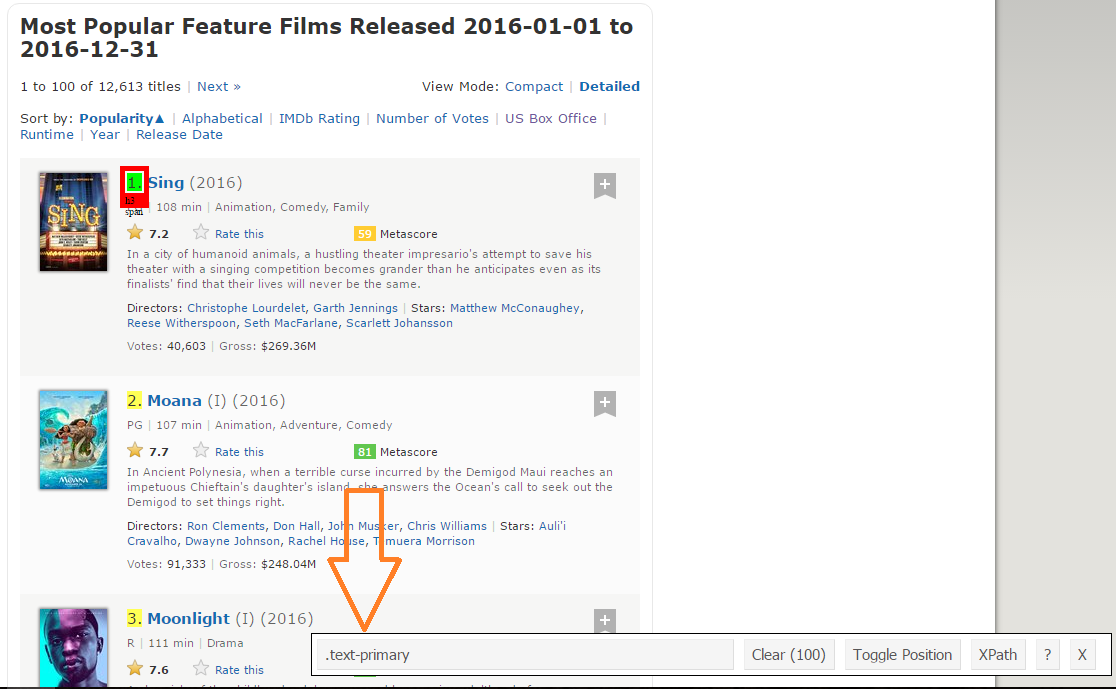
Paso 3: Sobald Sie den CSS-Selektor kennen, der die Klassifizierungen enthält, Sie können diesen einfachen R-Code verwenden, um alle Bewertungen zu erhalten:
#Verwenden von CSS-Selektoren, um den Ranking-Bereich abzukratzen
rank_data_html <- html_nodes(Website,'.text-primary')

#Konvertieren der Rankingdaten in Text
Rang_Daten <- html_text(rank_data_html)

#Let's have a look at the rankings
head(Rang_Daten)

[1] "1." "2." "3." "4." "5." "6."
Paso 4: Sobald Sie die Daten haben, Stellen Sie sicher, dass sie im gewünschten Format aussehen. Ich verarbeite meine Daten vor, um sie in ein numerisches Format zu konvertieren.
#Datenvorverarbeitung: Umwandeln von Rankings in Zahlen
Rang_Daten<-as.numerisch(Rang_Daten)

#Let's have another look at the rankings
head(Rang_Daten)

[1] 1 2 3 4 5 6
Paso 5: Jetzt können Sie den Auswahlbereich löschen und alle Titel auswählen. Sie können visuell überprüfen, ob alle Titel ausgewählt sind. Nehmen Sie die notwendigen Ergänzungen und Löschungen mit Hilfe Ihres Cursors vor. Das habe ich hier auch gemacht.
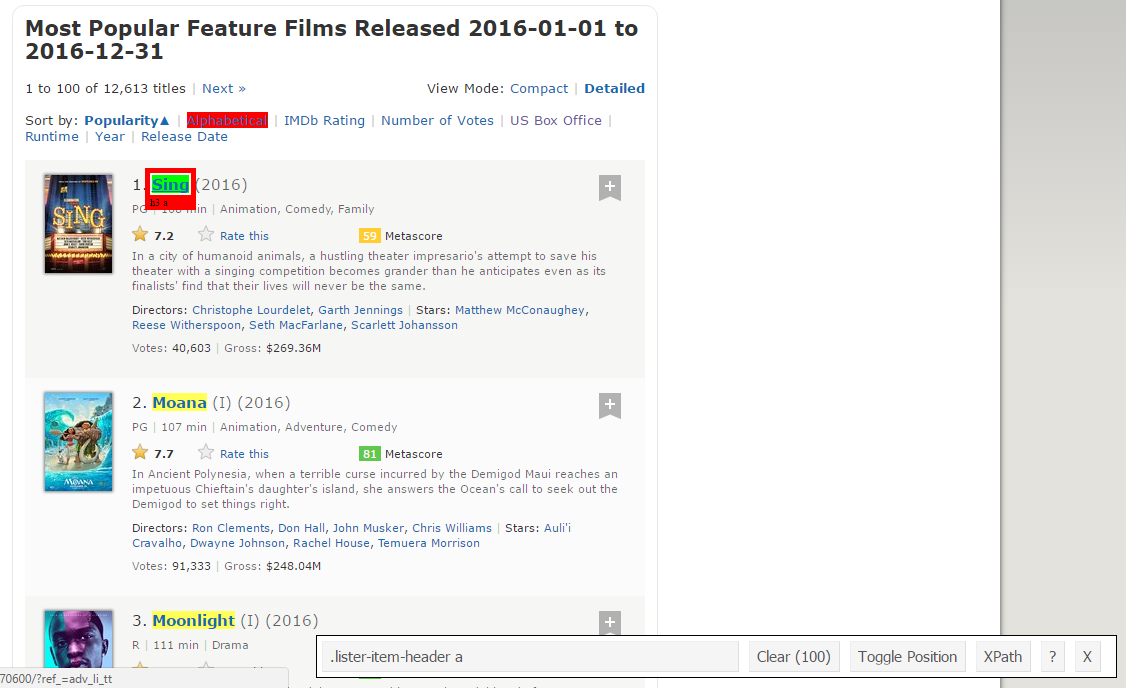
Paso 6: Nochmal, Ich habe den entsprechenden CSS-Selektor für die Titel: .lister-item-header a. Ich werde diesen Selektor verwenden, um alle Titel mit dem folgenden Code zu kratzen.
#Verwenden von CSS-Selektoren zum Scrapieren des Titelabschnitts
title_data_html <- html_nodes(Website,'.lister-item-header a')

#Konvertieren der Titeldaten in Text
title_data <- html_text(title_data_html)

#Let's have a look at the title
head(title_data)

[1] "Singen"          "Moana"         "Mondlicht"     "Bügelsägengrat"

[5] "Passagiere"    "Trolle"
Paso 7: Im folgenden Code, Das gleiche habe ich mit dem Schaben gemacht: Bezeichnung, Ausführungszeit, Geschlecht, Qualifikation, Metapunktur, Stimmen, Bruttoeinkommen in Tausend, Regisseur- und Schauspielerdaten.
#Verwenden von CSS-Selektoren zum Scrapen des Beschreibungsabschnitts
description_data_html <- html_nodes(Website,'.ratings-bar+ .text-muted')

#Konvertieren der Beschreibungsdaten in Text
Beschreibung_Daten <- html_text(description_data_html)

#Let's have a look at the description data
head(Beschreibung_Daten)

[1] "nIn einer Stadt der humanoiden Tiere, a hustling theater impresario's attempt to save his theater with a singing competition becomes grander than he anticipates even as its finalists' find that their lives will never be the same."

[2] "nIm antiken Polynesien, when a terrible curse incurred by the Demigod Maui reaches an impetuous Chieftain's daughter's island, she answers the Ocean's call to seek out the Demigod to set things right."

[3] "nEine Chronik der Kindheit, Adoleszenz und aufkeimendes Erwachsensein eines jungen, Afroamerikaner, schwuler Mann, der in einem rauen Viertel von Miami aufwächst."

[4] "nWKII amerikanischer Armeesanitäter Desmond T. Doss, die während der Schlacht von Okinawa gedient haben, weigert sich, Menschen zu töten, und wird der erste Mann in der amerikanischen Geschichte, der die Ehrenmedaille erhält, ohne einen Schuss abzufeuern."

[5] "nEin Raumschiff, das zu einem fernen Kolonieplaneten reist und Tausende von Menschen transportiert, hat eine Fehlfunktion in seinen Schlafkammern. Als Ergebnis, zwei Passagiere werden geweckt 90 Jahre zu früh."

[6] "nNach dem Einmarsch der Bergens in das Trolldorf, Mohn, der glücklichste Troll aller Zeiten, und die mürrische Branch macht sich auf den Weg, um ihre Freunde zu retten.

#Datenvorverarbeitung: removing 'n'
description_data<-gsub("n","",Beschreibung_Daten)

#Let's have another look at the description data
head(Beschreibung_Daten)

[1] "In einer Stadt der humanoiden Tiere, a hustling theater impresario's attempt to save his theater with a singing competition becomes grander than he anticipates even as its finalists' find that their lives will never be the same."

[2] "Im alten Polynesien, when a terrible curse incurred by the Demigod Maui reaches an impetuous Chieftain's daughter's island, she answers the Ocean's call to seek out the Demigod to set things right."

[3] "Eine Chronik der Kindheit, Adoleszenz und aufkeimendes Erwachsensein eines jungen, Afroamerikaner, schwuler Mann, der in einem rauen Viertel von Miami aufwächst."

[4] "WWII amerikanischer Armeesanitäter Desmond T. Doss, die während der Schlacht von Okinawa gedient haben, weigert sich, Menschen zu töten, und wird der erste Mann in der amerikanischen Geschichte, der die Ehrenmedaille erhält, ohne einen Schuss abzufeuern."

[5] "Ein Raumschiff, das zu einem fernen Kolonieplaneten reist und Tausende von Menschen transportiert, hat eine Fehlfunktion in seinen Schlafkammern. Als Ergebnis, zwei Passagiere werden geweckt 90 Jahre zu früh."

[6] "Nach dem Einmarsch der Bergens in das Trolldorf, Mohn, der glücklichste Troll aller Zeiten, und die mürrische Branch macht sich auf den Weg, um ihre Freunde zu retten."

#Verwenden von CSS-Selektoren zum Scrapen des Abschnitts zur Filmlaufzeit
runtime_data_html <- html_nodes(Website,'.text-muted .runtime')

#Konvertieren der Laufzeitdaten in Text
Laufzeit_Daten <- html_text(runtime_data_html)

#Let's have a look at the runtime
head(Laufzeit_Daten)

[1] "108 Mindest" "107 Mindest" "111 Mindest" "139 Mindest" "116 Mindest" "92 Mindest"

#Datenvorverarbeitung: Mins entfernen und in Zahlen umwandeln

Laufzeit_Daten<-gsub(" Mindest","",Laufzeit_Daten)
Laufzeit_Daten<-as.numerisch(Laufzeit_Daten)

#Let's have another look at the runtime data
head(Laufzeit_Daten)

[1] 1 2 3 4 5 6

#Verwenden von CSS-Selektoren, um den Abschnitt "Filmgenre" zu kratzen
genre_data_html <- html_nodes(Website,'.genre')

#Konvertieren der Genredaten in Text
genre_data <- html_text(genre_data_html)

#Let's have a look at the runtime
head(genre_data)

[1] "nAnimation, Komödie, Familie "

[2] "nAnimation, Abenteuer, Komödie "

[3] "nDrama "

[4] "nBiografie, Theater, Geschichte "

[5] "nAbenteuer, Theater, Romantik "

[6] "nAnimation, Abenteuer, Komödie "

#Datenvorverarbeitung: entfernen n
genre_data<-gsub("n","",genre_data)

#Datenvorverarbeitung: überschüssige Leerzeichen entfernen
genre_data<-gsub(" ","",genre_data)

#nur das erste Genre jedes Films nehmen
genre_data<-gsub(",.*","",genre_data)

#Konvertieren jedes Genres vom Text zum Faktor
genre_data<-as.faktor(genre_data)

#Let's have another look at the genre data
head(genre_data)

[1] Animation Animation Drama Biografie Abenteuer Animation

10 Ebenen: Action Abenteuer Animation Biografie Komödie Krimi ... Thriller

#Verwenden von CSS-Selektoren, um den IMDB-Bewertungsbereich abzukratzen
rating_data_html <- html_nodes(Website,'.ratings-imdb-rating strong')

#Konvertieren der Bewertungsdaten in Text
Bewertungsdaten <- html_text(rating_data_html)

#Let's have a look at the ratings
head(Bewertungsdaten)

[1] "7.2" "7.7" "7.6" "8.2" "7.0" "6.5"

#Datenvorverarbeitung: Konvertieren von Bewertungen in Zahlen
Bewertungsdaten<-as.numerisch(Bewertungsdaten)

#Let's have another look at the ratings data
head(Bewertungsdaten)

[1] 7.2 7.7 7.6 8.2 7.0 6.5

#Verwenden von CSS-Selektoren, um den Abstimmungsbereich zu kratzen
votes_data_html <- html_nodes(Website,'.sort-num_votes-visible span:n-Kind(2)')

#Konvertieren der Abstimmungsdaten in Text
votes_data <- html_text(votes_data_html)

#Let's have a look at the votes data
head(votes_data)

[1] "40,603"  "91,333"  "112,609" "177,229" "148,467" "32,497"

#Datenvorverarbeitung: Kommas entfernen
votes_data<-gsub(",","",votes_data)

#Datenvorverarbeitung: Stimmen in Zahlen umwandeln
votes_data<-as.numerisch(votes_data)

#Let's have another look at the votes data
head(votes_data)

[1]  40603  91333 112609 177229 148467  32497

#Verwenden von CSS-Selektoren zum Scrapen des Director-Bereichs
Directors_data_html <- html_nodes(Website,'.text-muted+ p a:n-Kind(1)')

#Konvertieren der Direktorendaten in Text
Directors_data <- html_text(Directors_data_html)

#Let's have a look at the directors data
head(Directors_data)

[1] "Christophe Lourdelet" "Ron Clements"         "Barry Jenkins"

[4] "Mel Gibson"           "Morten Tyldum"        "Walt Dohrn"

#Datenvorverarbeitung: Umwandlung von Direktorendaten in Faktoren
Directors_data<-as.faktor(Directors_data)

#Verwenden von CSS-Selektoren zum Scrapen des Schauspielerabschnitts
Schauspieler_data_html <- html_nodes(Website,'.lister-item-content .ghost+ a')

#Umwandlung der Bruttoakteursdaten in Text
Schauspieler_Daten <- html_text(Schauspieler_data_html)

#Let's have a look at the actors data
head(Schauspieler_Daten)

[1] "Matthew McConaughey" "Auli'i Cravalho"     "Mahershala Ali"

[4] "Andrew Garfield"     "Jennifer Lawrence"   "Anna Kendrick"

#Datenvorverarbeitung: Akteursdaten in Faktoren umwandeln
Schauspieler_Daten<-as.faktor(Schauspieler_Daten)
Aber ich möchte, dass Sie genau im Auge behalten, was passiert, wenn ich dasselbe mit Metascore-Daten mache.
#Verwenden von CSS-Selektoren zum Scrapieren des Metascore-Abschnitts
metascore_data_html <- html_nodes(Website,'.metascore')

#Konvertieren der Laufzeitdaten in Text
metascore_data <- html_text(metascore_data_html)

#Let's have a look at the metascore
data head(metascore_data)

[1] "59        " "81        " "99        " "71        " "41        "

[6] "56        "

#Datenvorverarbeitung: Entfernen von zusätzlichem Leerzeichen im Metascore
metascore_data<-gsub(" ","",metascore_data)

#Lassen Sie uns die Länge der Metascore-Daten überprüfen
Länge(metascore_data)

[1] 96
Paso 8: Die Länge der Metascore-Daten beträgt 96 während wir die Daten auskratzen 100 Filme. Der Grund dafür ist, dass es 4 Filme, die keine entsprechenden Metascore-Felder haben.
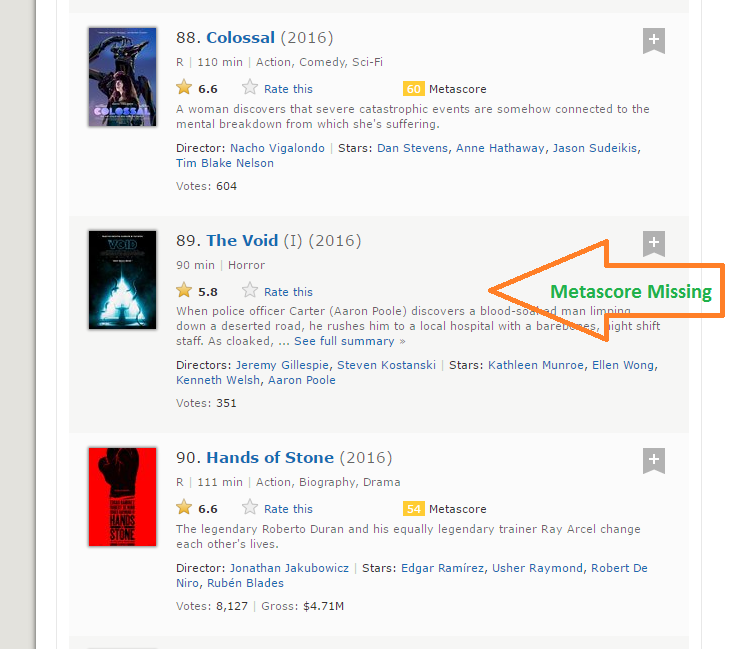
Paso 9: Dies ist eine praktische Situation, die beim Scrapen einer Website auftreten kann. Leider, wenn wir einfach NA zum letzten hinzufügen 4 Karten, NA wird als Metascore für Filme zugewiesen 96 ein 100, während in der Realität, Für einige andere Filme fehlen Daten. Nach einer Sichtprüfung, Ich habe festgestellt, dass der Metascore für die Filme fehlt 39, 73, 80 Ja 89. Ich habe die folgende Funktion geschrieben, um dieses Problem zu beheben.
zum (ich in c(39,73,80,89)){

ein<-metascore_data[1:(i-1)]

B<-metascore_data[ich:Länge(metascore_data)]

metascore_data<-anhängen(ein,aufführen("N / A"))

metascore_data<-anhängen(metascore_data,B)

}

#Datenvorverarbeitung: Metascore in numerisch umwandeln
metascore_data<-as.numerisch(metascore_data)

#Let's have another look at length of the metascore data

length(metascore_data)

[1] 100

#Let's look at summary statistics
summary(metascore_data)

Mindest. 1st Qu.  Median Mittelwert 3. Qu.    Max.    NA's

23.00   47.00   60.00   60.22   74.00   99.00       4
Paso 10: Das Gleiche gilt für die VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Brutto entspricht den Bruttoeinnahmen dieses Films in Millionen. Ich habe die gleiche Lösung verwendet, um meinen Weg zu arbeiten:
#Verwenden von CSS-Selektoren zum Scrapieren des Abschnitts Bruttoumsatz
gross_data_html <- html_nodes(Website,'.ghost~ .text-muted+ span')

#Umwandlung der Bruttoumsatzdaten in Text
brutto_daten <- html_text(gross_data_html)

#Let's have a look at the votes data
head(brutto_daten)

[1] "$269.36m" "$248.04m" "$27.50m"  "$67.12m"  "$99.47m"  "$153.67m"

#Datenvorverarbeitung: removing '$' and 'M' signs
gross_data<-gsub("m","",brutto_daten)

brutto_daten<-Teilzeichenfolge(brutto_daten,2,6)

#Let's check the length of gross data
length(brutto_daten)

[1] 86

#Füllen fehlender Einträge mit NA
zum (ich in c(17,39,49,52,57,64,66,73,76,77,80,87,88,89)){

ein<-brutto_daten[1:(i-1)]

B<-brutto_daten[ich:Länge(brutto_daten)]

brutto_daten<-anhängen(ein,aufführen("N / A"))

brutto_daten<-anhängen(brutto_daten,B)

}

#Datenvorverarbeitung: Brutto in numerisch umrechnen
brutto_daten<-as.numerisch(brutto_daten)

#Let's have another look at the length of gross data
length(brutto_daten)

[1] 100

Zusammenfassung(brutto_daten)

Mindest. 1st Qu.  Median Mittelwert 3. Qu.    Max.    NA's

0.08   15.52   54.69   96.91  119.50  530.70      14
Paso 11: Wir haben jetzt erfolgreich entfernt die 11 Funktionen von 100 Die beliebtesten Filme, die in . veröffentlicht wurden 2016. Lassen Sie uns sie kombinieren, um einen Datenrahmen zu erstellen und seine Struktur zu untersuchen.
#Zusammenfassen aller Listen zu einem Datenrahmen
Filme_df<-data.frame(Rang = Rang_Daten, Titel = title_data,

Beschreibung = Beschreibung_Daten, Laufzeit = runtime_data,

Genre = genre_data, Bewertung = rating_data,

Metascore = metascore_data, Stimmen = votes_data,                                                             Brutto_Earning_in_Mil = brutto_data,

Direktor = Direktoren_Daten, Schauspieler = Schauspieler_Daten)

#Aufbau des Datenrahmens

str(Filme_df)

'Datenrahmen':            100 obs. von  11 Variablen:

$ Rang                : Auf eins  1 2 3 4 5 6 7 8 9 10 ...

$ Titel               : Faktor mit 99 Ebenen "10 Cloverfield Lane",..: 66 53 54 32 58 93 8 43 97 7 ...

$ Beschreibung         : Faktor mit 100 Ebenen "19-Der einjährige Billy Lynn wird nach einer erschütternden Irakschlacht für eine Siegestour nach Hause gebracht. Durch Rückblenden zeigt der Film was"| __gekürzt__,..: 57 59 3 100 21 33 90 14 13 97 ...

$ Laufzeit             : Auf eins  108 107 111 139 116 92 115 128 111 116 ...

$ Genre               : Faktor mit 10 Ebenen "Handlung","Abenteuer",..: 3 3 7 4 2 3 1 5 5 7 ...

$ Bewertung              : Auf eins  7.2 7.7 7.6 8.2 7 6.5 6.1 8.4 6.3 8 ...

$ Metascore           : Auf eins  59 81 99 71 41 56 36 93 39 81 ...

$ Stimmen               : Auf eins  40603 91333 112609 177229 148467 ...

$ Brutto_Earning_in_Mil: Auf eins  269.3 248 27.5 67.1 99.5 ...

$ Direktor            : Faktor mit 98 Ebenen "Andrew Stanton",..: 17 80 9 64 67 95 56 19 49 28 ...

$ Schauspieler               : Faktor mit 86 Ebenen "Aaron Eckhart",..: 59 7 56 5 42 6 64 71 86 3 ...
Sie haben nun erfolgreich die IMDb-Website für die 100 Die beliebtesten Spielfilme, die in veröffentlicht wurden 2016.
6. Analysieren Sie aus dem Web extrahierte Daten
Sobald Sie die Daten haben, kann verschiedene Aufgaben ausführen, wie z. B. die Daten analysieren, Schlüsse daraus ziehen, Trainieren Sie Machine-Learning-Modelle auf diesen Daten, etc. Ich habe aus den Daten, die wir gerade extrahiert haben, immer wieder eine interessante Visualisierung erstellt. Folgen Sie den Visualisierungen und beantworten Sie die unten gestellten Fragen. Posten Sie Ihre Antworten im Kommentarbereich unten.
Bücherei('ggplot2')

qplot(Daten = Filme_df,Laufzeit,füllen = Genre,Behälter = 30)
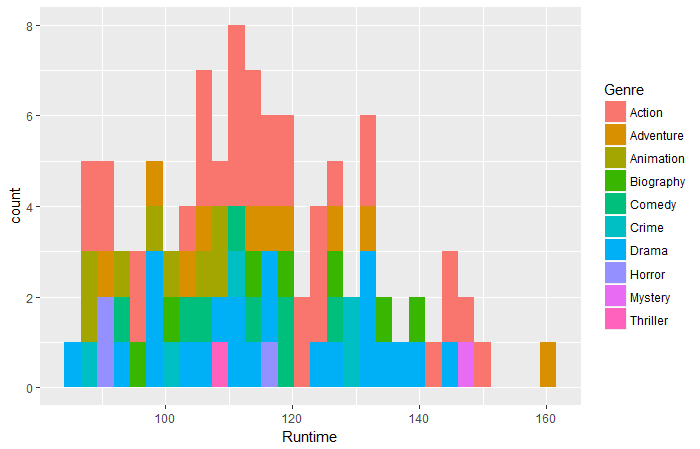
Frage 1: Nach den obigen Daten, Welcher Film aus welchem Genre hatte die längste Laufzeit?
ggplot(Filme_df,aes(x=Laufzeit,y=Bewertung))+
geom_point(aes(Größe=Stimmen,col = Geschlecht))
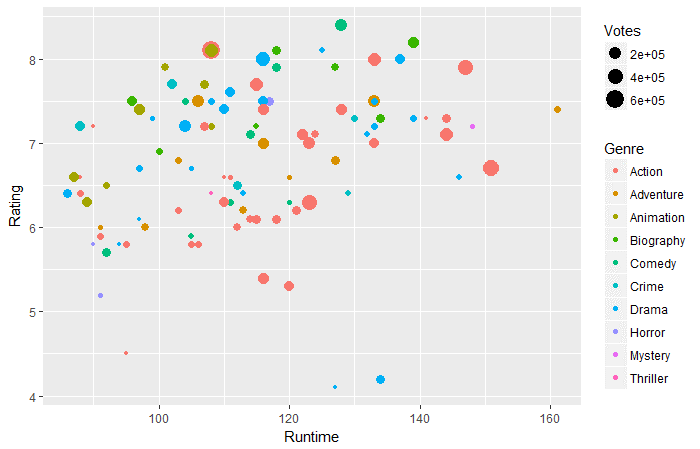
Frage 2: Nach den obigen Daten, zur Laufzeit von 130-160 Protokoll, Welches Genre hat die höchsten Stimmen?
ggplot(Filme_df,aes(x=Laufzeit,y=Brutto_Earning_in_Mil))+
geom_point(aes(Größe=Bewertung,col = Geschlecht))
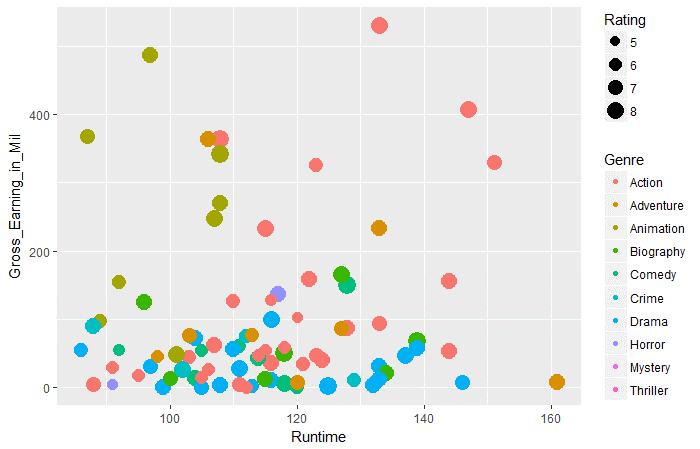
Frage 3: Nach den obigen Daten, in allen Genres, welches Genre hat die höchsten durchschnittlichen Bruttoeinnahmen zur Laufzeit von 100 ein 120.
Abschließende Anmerkungen
Ich denke, dieser Artikel hätte Ihnen ein umfassendes Verständnis von Web-Scraping in R vermittelt. Jetzt, Sie haben auch eine klare Vorstellung von den Problemen, auf die Sie stoßen könnten und wie Sie sie beheben können. Da die meisten Daten im Web in einem unstrukturierten Format vorliegen, Web Scraping ist eine sehr nützliche Fähigkeit für jeden Datenwissenschaftler.
Was ist mehr, Sie können die Antworten auf die obigen drei Fragen im Kommentarbereich unten posten. Hat es dir Spaß gemacht diesen Artikel zu lesen? Teile deine Meinung mit mir. Wenn Sie Zweifel haben / Frage, gerne weiter unten senden.





