
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Einführung
In diesem Artikel, wir werden lernen, wie eine der Techniken von tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... verwendet wird, um die Genauigkeit von zu finden Brustkrebs-Datensatz, Aber ich weiß, dass die meisten Techniker nicht wissen, wovon wir reden, Wir beginnen mit den Grundlagen und gehen dann zu unserem Thema über. Zuerst, wir machen eine kurze Einführung in Deep Learning und dann, was ist die rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. künstlich?
Was ist Deep Learning??
Wenn wir über Deep Learning sprechen, Verstehe einfach, dass es sich um eine Teilmenge oder einen Teilbereich des maschinellen Lernens handelt. Wir können sagen, dass Deep Learning eine KI-Funktion ist, die das menschliche Gehirn nachahmt und diese Daten verarbeitet und Muster erstellt, die bei der Entscheidungsfindung verwendet werden können.
Deep Learning ist die Art des maschinellen Lernens, die dem menschlichen Gehirn ähnlich ist. Verwendet eine mehrschichtige Struktur von Algorithmen, die als neuronale Netze bezeichnet werden. Ihre Algorithmen versuchen, die Daten, die Menschen mit einer bestimmten logischen Struktur analysieren würden, zu kopieren. Auch bekannt als Deep Neural Network oder Deep Neural Learning.
Beim Deep Learning gibt es ein Konzept namens Artificial Neural Network, das wir im Folgenden kurz diskutieren werden.:
Rote neuronale künstliche
Wie der Name schon sagt, künstliches neuronales Netz, ist das Netzwerk künstlicher Neuronen. Bezieht sich auf ein biologisch inspiriertes Modell im Gehirn. Wir können sagen, dass es sich normalerweise um ein Computernetzwerk handelt, das auf biologischen neuronalen Netzwerken basiert, die die Struktur des menschlichen Gehirns aufbauen.
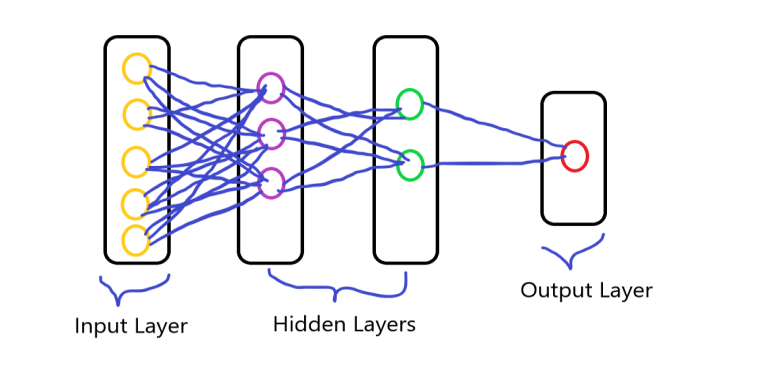
Sie alle wissen, dass Neuronen in unserem Gehirn und dem Prozess der Datenübertragung miteinander verbunden sind. Es ist vergleichbar mit Neuronen im menschlichen Gehirn, die miteinander verbunden sind, Das neuronale Netz besteht aus einer Vielzahl künstlicher Neuronen, sogenannte Einheiten, die in einer Abfolge von Schichten angeordnet sind. die verschiedenen Schichten von Neuronen haben und ein vollständiges Netzwerk bilden. diese Neuronen werden Knoten genannt.
Es besteht aus drei Schichten, die:
- EingabeebeneDas "Eingabeschicht" bezieht sich auf die Anfangsebene in einem Datenanalyseprozess oder in neuronalen Netzwerkarchitekturen. Seine Hauptfunktion besteht darin, Rohinformationen zu empfangen und zu verarbeiten, bevor sie von nachfolgenden Schichten transformiert werden. Im Kontext des maschinellen Lernens, Die richtige Konfiguration der Eingabeschicht ist entscheidend, um die Effektivität des Modells zu gewährleisten und seine Leistung bei bestimmten Aufgaben zu optimieren....
- Versteckter Umhang
- AusgabeschichtDas "Ausgabe-Layer" ist ein Konzept, das im Bereich der Informationstechnologie und des Systemdesigns verwendet wird. Es bezieht sich auf die letzte Schicht eines Softwaremodells oder einer Architektur, die für die Präsentation der Ergebnisse für den Endbenutzer verantwortlich ist. Diese Schicht ist entscheidend für die Benutzererfahrung, Da es eine direkte Interaktion mit dem System und die Visualisierung der verarbeiteten Daten ermöglicht....
KNN mithilfe eines Brustkrebs-Datensatzes erstellen
Kommen wir nun zu unserem Thema, hier nehmen wir den Datensatz und erstellen dann das künstliche neuronale Netz und klassifizieren die Diagnose, erste, wir nehmen einen Brustkrebs-Datensatz und dann machen wir weiter.
Datensatz: Brustkrebs-Datensatz
Nach dem Herunterladen des Datensatzes, wir importieren die wichtigen Bibliotheken, die für die Weiterverarbeitung benötigt werden.
Bibliotheken importieren
#Pandas importieren
Pandas als pd importieren
#import numpy
numpy als np importieren
import matplotlib.pyplot als plt
Seegeborenen als jdn importieren
Hier importieren wir Pandas, NumPy und einige Anzeigebibliotheken.
Jetzt laden wir unseren Datensatz mit Pandas:
df = pd.read_csv('Breast_cancer.csv')
df
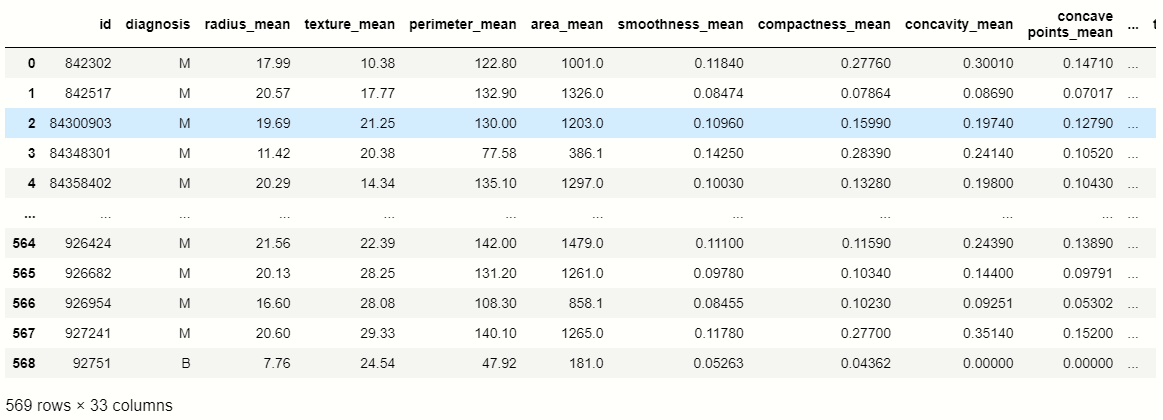
In diesem Datensatz, wir zielen auf die ‚Diagnose‘ Spalte "Eigenschaften", Also überprüfen wir die Anzahl der Werte dieser Spalte mit Pandas:
# counting values of variables in 'diagnosis'
df['diagnosis'].value_counts()
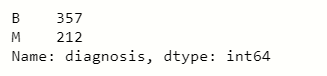
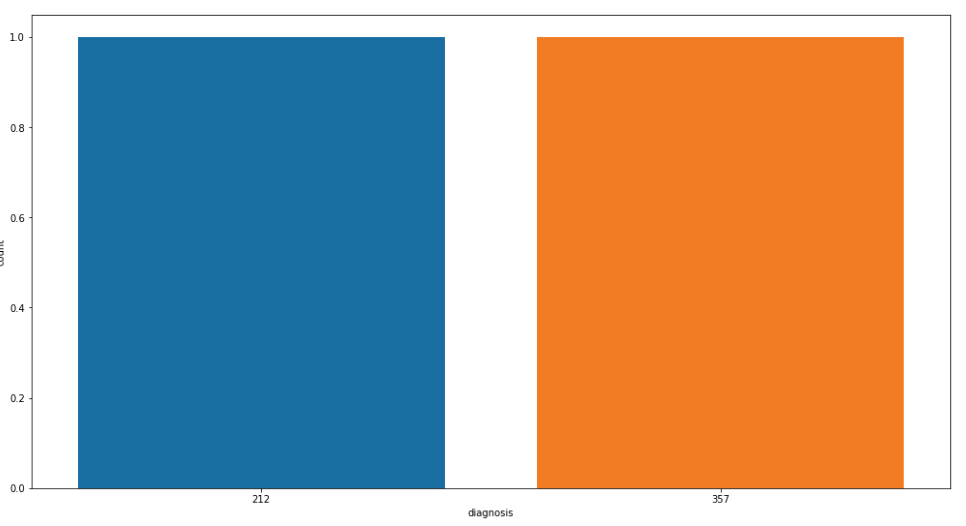
Jetzt visualisieren wir die Zählungen der Werte der ‚Diagnosespalten: zum besseren Verständnis
Wertkonten anzeigen
plt.figur(Feigengröße=[17,9])
sb.countplot(df['diagnosis'].value_counts())
plt.zeigen()
Nullwerte
Im Datensatz, Wir müssen die Nullwerte überprüfen, die in den Variablen vorhanden sind, für die wir Pandas verwenden:
df.isnull().Summe()
Nach dem Ausführen des Programms, kommen wir zu dem Schluss, dass der Name der Funktion ‚Namenlos: 32‘ enthält alle Nullwerte, Also löschen oder verwerfen wir diese Spalte.
#Drop-Funktion
df.drop(['Unnamed': 32','id'],Achse=1,inplace=True)
Unabhängige und abhängige Variablen
Jetzt ist es an der Zeit, den Datensatz in unabhängige und abhängige Variablen zu unterteilen, dafür erstellen wir zwei Variablen, einer steht für unabhängig und der andere für abhängig.
# unabhängige Variablen
x = df.drop('diagnosis',Achse=1)
#abhängigen Variablen
y = df.Diagnose
Verwaltung des kategorialen Wertes
Wenn wir die drucken VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängig Ja dann sehen wir, dass sie kategoriale Daten enthalten und müssen kategoriale Daten zur weiteren Verarbeitung in das Binärformat umwandeln. Deswegen, Wir verwenden Scikit Learn Label Encoder, um die kategorialen Daten zu codieren.
aus sklearn.preprocessing import LabelEncoder
#das Objekt erstellen
lb = LabelEncoder()
y = lb.fit_transform(Ja)
Datenteilung
Jetzt ist es an der Zeit, die Daten in Teile zu teilen von AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... und testen:
aus sklearn.model_selection import train_test_split
xtrain,xtest,ytrain,ytest = train_test_split(x,Ja,test_size=0.3,random_state=40)
Skalieren Sie die Daten
Als wir das künstliche neuronale Netz geschaffen haben, wir müssen die Daten auf kleinere Zahlen skalieren, weil der Deep-Learning-Algorithmus die Gewichte und Eingabedaten der Knoten multipliziert und es lange dauert, Um diese Zeit zu verkürzen, skalieren wir die Daten.
klettern, wir verwenden scikit learn Standardkletterer Modul, wir skalieren den Trainings- und Testdatensatz:
#Importieren von StandardScaler
aus sklearn.preprocessing import StandardScaler
#Objekt erstellen
sc = Standardskalierer()
xtrain = sc.fit_transform(xtrain)
xtest = sc.transform(xtest)
Von hier aus beginnen wir mit der Erstellung des künstlichen neuronalen Netzes, dafür importieren wir die wichtigen Bibliotheken, die verwendet werden, um ANN zu erstellen:
#keras importieren
keras importieren
#sequentielles Modul importieren
von keras.models importieren Sequential
# Dichtemodul für versteckte Ebenen importieren
aus keras.layers importieren dicht
#Aktivierungsfunktionen importieren
aus keras.layers importieren LeakyReLU,PRELU,ELU
aus keras.layers importieren Dropout
Ebenen erstellen
Nach dem Importieren dieser Bibliotheken, Wir erstellen die drei Arten von Ebenen:
- Eingabeebene
- Versteckter Umhang
- Ausgabeschicht
Zuerst, wir erstellen das modell:
#Modell erstellen
Klassifikator = Sequentiell()
EIN sequentiell Das Modell ist geeignet für einen einfachen Stapel von Schichten, bei dem jede Schicht genau einen TensorTensoren sind mathematische Strukturen, die Konzepte wie Skalare und Vektoren verallgemeinern. Sie werden in verschiedenen Disziplinen eingesetzt, einschließlich Physik, Ingenieurwesen und maschinelles Lernen, um mehrdimensionale Daten darzustellen. Ein Tensor kann als mehrdimensionale Matrix visualisiert werden, , die es ermöglicht, komplexe Beziehungen zwischen verschiedenen Variablen zu modellieren. Ihre Vielseitigkeit und Fähigkeit, große Informationsmengen zu verarbeiten, machen sie zu grundlegenden Werkzeugen in der Datenanalyse und -verarbeitung.... Eingang und einen Ausgangstensor hat.
Jetzt erstellen wir die Schichten des neuronalen Netzes:
#erste versteckte Schicht
Klassifikator.add(Dicht(Einheiten=9,kernel_initializer="er_uniform",aktivierung='relu',input_dim=30))
#zweite versteckte Schicht
Klassifikator.add(Dicht(Einheiten=9,kernel_initializer="er_uniform",aktivierung='relu'))
# letzte Schicht oder Ausgabeschicht
Klassifikator.add(Dicht(Einheiten=1,kernel_initializer="glorot_uniform",activation='sigmoid'))
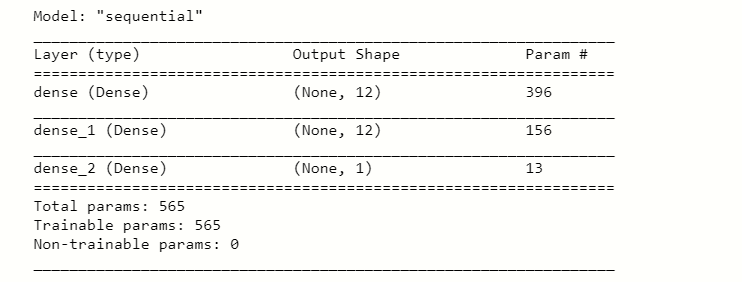
Im folgenden Code, die Dense-Methode wird verwendet, um die Ebenen zu erstellen, in dem wir verwenden ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... grundlegend. Der erste Parameter ist Ausgangsknoten, das Der zweite ist der Initialisierer für die Kernel-Gewichtsmatrix, die dritte ist die WeckfunktionDie Aktivierungsfunktion ist eine Schlüsselkomponente in neuronalen Netzen, da es den Output eines Neurons auf der Grundlage seiner Eingabe bestimmt. Sein Hauptzweck besteht darin, Nichtlinearitäten in das Modell einzuführen, Ermöglicht das Erlernen komplexer Muster in Daten. Es gibt verschiedene Aktivierungsfunktionen, wie das Sigmoid, ReLU und tanh, jedes mit besonderen Eigenschaften, die sich auf die Leistung des Modells in verschiedenen Anwendungen auswirken.... und der letzte Parameter sind die Eingabeknoten oder die Anzahl der unabhängigen Merkmale.
Nachdem wir diesen Code ausgeführt haben, nehmen wir die Zusammenfassung mit:
#Zusammenfassung der Schichten nehmen
Klassifikator.Zusammenfassung()
Durch das Ausfüllen von ANN
Jetzt kompilieren wir unser Modell mit dem Optimierer:
#Zusammenstellung der ANN
classifier.compile(Optimierer="Adam",Verlust="binäre_kreuzentropie",Metriken=[Genauigkeit])
Anpassung des KNN an die Trainingsdaten
Nach dem Kompilieren des Modells, wir müssen das ANN in die Trainingsdaten für die Vorhersage einpassen:
 #fitting the ANN to the training set
model = classifier.fit(xtrain,ytrain,batch_size=100,epochen=100)
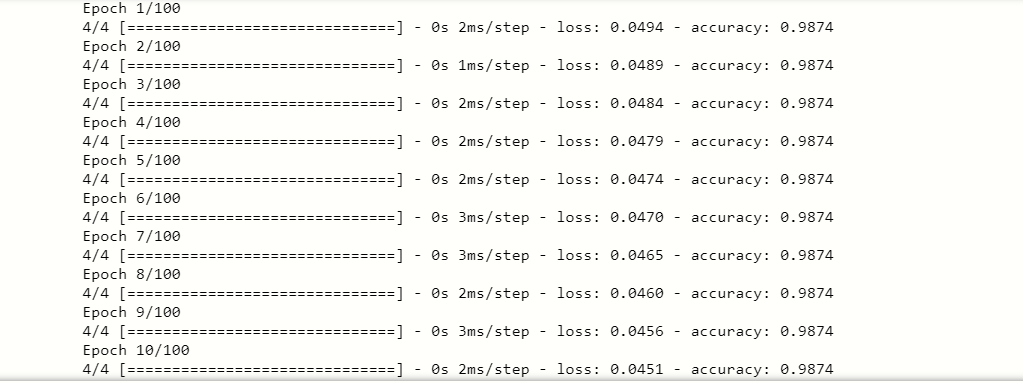
das hineinpassen() Die Methode passt das KNN an die Trainingsdaten an, in den Parametern setzen wir die spezifischen Werte jeder Variablen als Losgröße, Epochen, etc. Schließlich, Wir haben eine ausgezeichnete Genauigkeitsbewertung gefunden, somit ist unser Modell perfekt an die Trainingsdaten angepasst.
Nach dem Training der Daten, wir müssen auch die Genauigkeitsbewertung der Testdaten testen, mal sehen als nächstes:
#jetzt auf Testdaten testen
y_pred = classifier.predict(Prüfung)
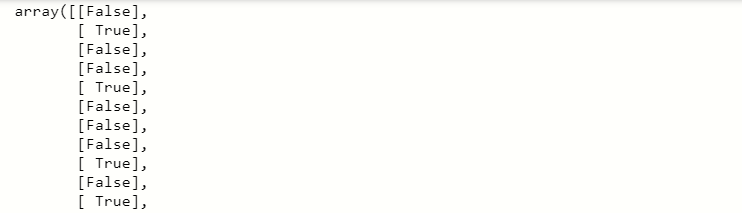
Beim Ausführen dieses Codes, Wir haben festgestellt, dass y_pred die verschiedenen Werte enthält, also wandeln wir Vorhersagewerte in Schwellenwerte als True um, Gefälscht.
#Werte umwandeln
y_pred = (y_pred>0.5)
drucken(y_pred)
Interpunktions- und Verwechslungsmatrix
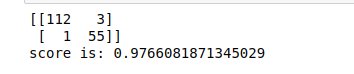
Jetzt überprüfen wir die Konfusionsmatrix und die Punktzahl der vorhergesagten Werte.
von sklearn.metrics importieren Confusion_matrix
von sklearn.metrics import precision_score
cm = verwirrt_matrix(ytest,y_pred)
Punktzahl = Genauigkeit_Punktzahl(ytest,y_pred)
drucken(cm)
drucken('Score ist':',Spielstand)
Produktion:-
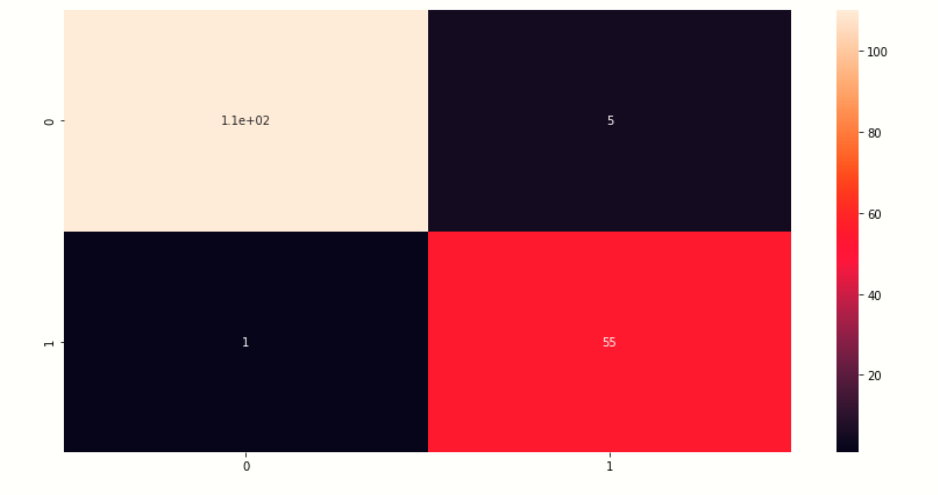
Verwirrungsmatrix visualisieren
Hier visualisieren wir die Konfusionsmatrix der Vorhersagewerte.
# Erstellen einer Heatmap der Komfusionsmatrix
plt.figur(Feigengröße=[14,7])
jdm.Heatmap(cm,annot=Wahr)
plt.zeigen()
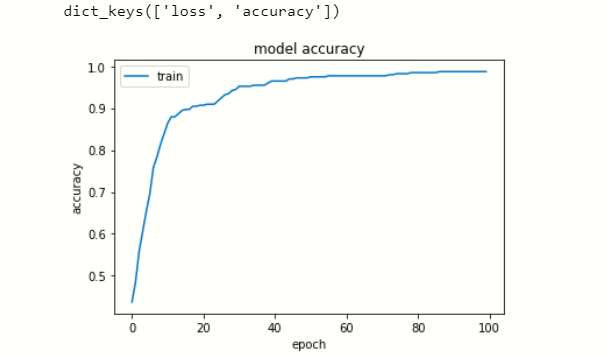
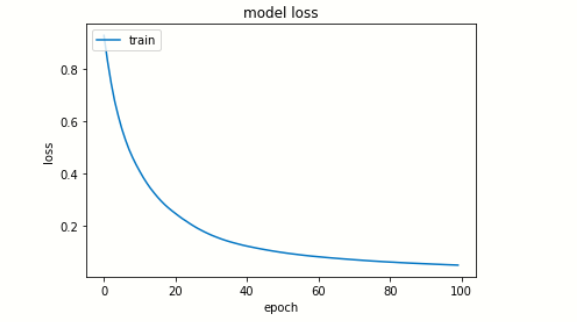
Datenverlauf anzeigen
Jetzt visualisieren wir den Verlust und die Präzision in jeder Epoche.
# alle Daten im Verlauf auflisten
drucken(model.history.keys())
# Historie auf Genauigkeit zusammenfassen
plt.plot(model.history[Genauigkeit])
plt.titel('Modellgenauigkeit')
plt.ylabel(Genauigkeit)
plt.xlabel('Epoche')
plt.legende(['train', 'test'], loc ="Oben links")
plt.zeigen()
# Geschichte für Verlust zusammenfassen
plt.plot(model.history[Verlust])
plt.titel('Modellverlust')
plt.ylabel(Verlust)
plt.xlabel('Epoche')
plt.legende(['train', 'test'], loc ="Oben links")
plt.zeigen()
Sparmodell
Schließlich, wir retten unser modell.
#Modell speichern
Klassifikator.speichern('File_name.h5')
EndNote
Dies ist mein erstes KNN, das in Deep Learning erstellt wurde, Ich bin ein Anfänger im Deep Learning. Ich tue mein Bestes, um diesen Artikel zu erklären, hoffe dir gefällt. Danke, dass du diesen Artikel gelesen hast.
Verbinden Sie sich mit mir auf LinkedIn: Profil
Vielen Dank.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





