
Reflexe
- Tokenisierung ist ein wichtiger Aspekt (und obligatorisch) des Arbeitens mit Textdaten
- Wir werden die verschiedenen Nuancen der Tokenisierung diskutieren, einschließlich des Umgangs mit Wörtern außerhalb des Vokabulars (OOV)
Einführung
Sprache ist etwas Schönes. Aber eine neue Sprache von Grund auf zu beherrschen, ist eine ziemlich entmutigende Aussicht.. Wenn Sie jemals eine Sprache gelernt haben, die nicht Ihre Muttersprache war, Werde mich damit identifizieren! Es gibt so viele Ebenen zu entfernen und Syntax zu berücksichtigen, es ist eine ziemliche herausforderung.
Und genau so ist es auch bei unseren Maschinen. Damit unser Computer jeden Text versteht, Wir müssen dieses Wort so aufschlüsseln, dass unsere Maschine es verstehen kann. Hier kommt das Konzept der Tokenisierung in der Verarbeitung natürlicher Sprache ins Spiel. (NLP).
In einer Nussschale, wir können nicht mit Textdaten arbeiten, wenn wir keine Tokenisierung durchführen. Jawohl, es ist wirklich so wichtig!
Und hier ist das Faszinierende an der Tokenisierung: Es ist nicht Solo über das Aufbrechen des Textes. Die Tokenisierung spielt eine wichtige Rolle beim Umgang mit Textdaten. Dann, In diesem Artikel, Wir werden die Tiefen der Tokenisierung in der Verarbeitung natürlicher Sprache untersuchen und wie Sie sie in Python implementieren können.
Ich empfehle, sich etwas Zeit zu nehmen, um die folgende Ressource zu lesen, wenn Sie neu bei NLP sind.:
Inhaltsverzeichnis
- Ein kurzer Überblick über die Tokenisierung
- Die wahren Gründe für die Tokenisierung
- Welche Tokenisierung? (Wort, Zeichen oder Unterwort) Wir sollten ... benutzen?
- Tokenisierungsimplementierung: Byte-Paar-Codierung in Python
Ein kurzer Überblick über die Tokenisierung
Tokenisierung ist eine häufige Aufgabe in der Verarbeitung natürlicher Sprache (NLP). Es ist ein grundlegender Schritt in traditionellen NLP-Methoden wie Count Vectorizer und Advanced Deep Learning-basierten Architekturen wie Transformers.
Token sind die Bausteine der natürlichen Sprache.
Die Tokenisierung ist eine Möglichkeit, einen Textabschnitt in kleinere Einheiten zu unterteilen, die Tokens genannt werden. Hier, Token können Wörter sein, Zeichen oder Unterwörter. Deswegen, Tokenisierung kann grob unterteilt werden in 3 Typen: Wort-Tokenisierung, Zeichen und Unterwort (N-Gramm-Zeichen).
Zum Beispiel, bedenke den Satz: „Gib niemals auf“.
Die gebräuchlichste Art, Token zu bilden, basiert auf Leerzeichen. Angenommen Leerzeichen ist ein Trennzeichen, Satztokenisierung führt zu 3 Token: Gib niemals auf. Da jedes Token ein Wort ist, wird ein Beispiel für die Wort-Tokenisierung.
Ähnlich, Token können Zeichen oder Unterwörter sein. Zum Beispiel, betrachten wir „klügste“:
- Charakter-Token: klügste
- Unterwort-Tabs: klügste
Aber ist das dann notwendig? Brauchen wir wirklich Tokenisierung, um das alles zu tun??
Notiz: Wenn Sie neu bei NLP sind, Überprüfen Sie unsere Online-NLP-Kurs
Die wahren Gründe für die Tokenisierung
Da Token die Bausteine der natürlichen Sprache sind, die gängigste Methode zur Verarbeitung von Klartext erfolgt auf Token-Ebene.
Zum Beispiel, Transformatorbasierte Modelle, las arquitecturas de tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... de vanguardia (UNTER) und NLP, Verarbeiten Sie den Rohtext auf Token-Ebene. Ähnlich, die beliebtesten Deep-Learning-Architekturen für NLP wie RNN, GRU und LSTM verarbeiten auch Rohtext auf Token-Ebene.
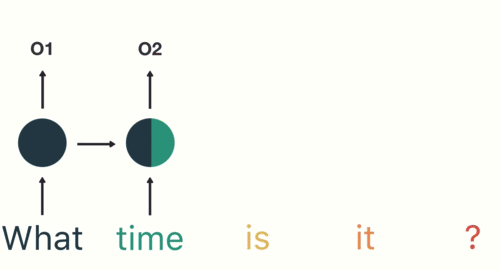
Funcionamiento de la rotes neuronales RezidivRekurrente neuronale Netze (RNN) sind eine Art von neuronaler Netzwerkarchitektur, die für die Verarbeitung von Datenströmen entwickelt wurde. Im Gegensatz zu herkömmlichen neuronalen Netzen, RNNs verwenden interne Verbindungen, die es ermöglichen, Informationen aus früheren Einträgen zu speichern. Dies macht sie besonders nützlich für Aufgaben wie die Verarbeitung natürlicher Sprache, Maschinelle Übersetzung und Zeitreihenanalyse, wo Kontext und Reihenfolge für die...
Wie hier gezeigt, RNN empfängt und verarbeitet jedes Token in einem bestimmten Zeitschritt.
Deswegen, Die Tokenisierung ist der wichtigste Schritt bei der Modellierung von Textdaten. Die Tokenisierung erfolgt im Korpus, um Token zu erhalten. Die folgenden Karten dienen dann zur Vorbereitung eines Vokabulars. Das Vokabular bezieht sich auf den Satz einzigartiger Token im Korpus. Denken Sie daran, dass das Vokabular unter Berücksichtigung jedes einzelnen Tokens im Korpus oder unter Berücksichtigung der K-häufigsten Wörter erstellt werden kann.
Der Aufbau von Vokabeln ist das ultimative Ziel der Tokenisierung.
Einer der einfachsten Tricks, um die Leistung des NLP-Modells zu verbessern, besteht darin, ein Vokabular aus den K-häufigsten Wörtern zu erstellen..
Jetzt, den Gebrauch von Vokabeln in traditionellen und fortgeschrittenen NLP-Methoden verstehen, die auf Deep Learning basieren.
- Traditionelle NLP-Ansätze, como Count Vectorizer und TF-IDF, Vokabeln als Merkmale verwenden. Jedes Wort des Vokabulars wird als einzigartiges Merkmal behandelt:
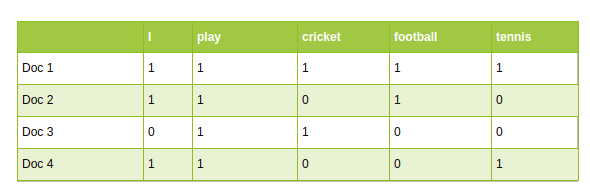
Traditionelles NLP: Zählvektorisierer
- In NLP-Architekturen basierend auf Advanced Deep Learning, das Vokabular wird verwendet, um die tokenisierten Eingabesätze zu erstellen. Schließlich, die Token dieser Sätze werden als Eingaben an das Modell übergeben.
Welche Tokenisierung sollte ich verwenden??
Wie bereits erwähnt, Tokenisierung kann auf Wortebene erfolgen, Zeichen oder Unterwort. Es ist eine häufige Frage: Welche Tokenisierung sollten wir verwenden, wenn wir eine NLP-Aufgabe lösen?? Lassen Sie uns diese Frage hier angehen.
Wort-Tokenisierung
Die Wort-Tokenisierung ist der am weitesten verbreitete Tokenisierungsalgorithmus. Teilen Sie einen Textabschnitt anhand eines festgelegten Trennzeichens in einzelne Wörter auf. Abhängig von den Trennzeichen, Es werden verschiedene Wortebenen-Token gebildet. Vortrainierte Worteinbettungen wie Word2Vec und GloVe sind in der Wort-Tokenisierung enthalten.
Aber das hat einige Nachteile.
Nachteile der Wort-Tokenisierung
Eines der Hauptprobleme bei Wort-Tokens ist der Umgang mit Wörter ohne Wortschatz (OOV). Die OOV-Wörter beziehen sich auf die neuen Wörter, die in den Tests gefunden wurden. Diese neuen Wörter existieren nicht im Vokabular. Deswegen, diese Methoden können OOV-Wörter nicht verarbeiten.
Aber warte, Ziehe noch keine voreiligen Schlüsse!
- Ein kleiner Trick kann Wort-Tokenizer aus OOV-Wörtern retten. El truco consiste en formar el vocabulario con las K palabras frecuentes más frecuentes y reemplazar las palabras raras en los datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... mit Unbekannt Token (UNK). Dies hilft dem Modell, die Darstellung von OOV-Wörtern in Bezug auf UNK-Token zu lernen
- Deswegen, während der Testzeit, Jedes Wort, das nicht im Vokabular vorhanden ist, wird einem UNK-Token zugeordnet. So können wir das OOV-Problem in Wort-Tokenizern angehen.
- Das Problem bei diesem Ansatz besteht darin, dass alle Wortinformationen verloren gehen, wenn wir OOV auf UNK-Token abbilden. Die Struktur des Wortes kann nützlich sein, um es genau darzustellen. Und ein weiteres Problem ist, dass jedes OOV-Wort dieselbe Darstellung hat
Ein weiteres Problem bei Wortmarken hängt mit der Größe des Vokabulars zusammen. Allgemein, vortrainierte Modelle werden an einem großen Volumen des Textkorpus trainiert. Dann, Stellen Sie sich vor, Sie bauen einen Wortschatz mit all den einzigartigen Wörtern in einem so großen Korpus auf. Das explodiert das Vokabular!
Dies öffnet die Tür zur Charakter-Tokenisierung.
Charakter-Tokenisierung
Die Zeichen-Tokenisierung teilt jeden Text in einen Zeichensatz auf. Überwindet die Nachteile, die wir zuvor bei der Wort-Tokenisierung gesehen haben.
- Zeichen-Tokenizer verarbeiten OOV-Wörter konsistent, indem sie Wortinformationen beibehalten. Teilen Sie das Wort OOV in Zeichen auf und stellen Sie das Wort anhand dieser Zeichen dar.
- Es begrenzt auch die Größe des Wortschatzes. Möchten Sie die Größe des Vokabulars erraten?? 26 da das Vokabular einen einzigartigen Satz von Zeichen enthält
Nachteile der Charakter-Tokenisierung
Charaktertoken lösen das OOV-Problem, aber die Länge der Eingabe- und Ausgabesätze nimmt schnell zu, wenn wir einen Satz als Folge von Zeichen wiedergeben. Infolge, Es wird zu einer Herausforderung, die Beziehung zwischen den Charakteren zu lernen, um bedeutungsvolle Wörter zu bilden.
Dies bringt uns zu einer anderen Tokenisierung, die als Subword-Tokenisierung bekannt ist, das ist zwischen einer Tokenisierung von Wörtern und Zeichen.
Teilwort-Tokenisierung
Die Teilwort-Tokenisierung teilt den Textausschnitt in Teilwörter auf (oder N-Gramm-Zeichen). Zum Beispiel, Wörter wie niedrigste können als niedrigste segmentiert werden, schlauer als schlauer, etc.
Transformationsbasierte Modelle, die SOTA im NLP, verlassen sich auf Subword-Tokenisierungsalgorithmen, um Vokabeln vorzubereiten. Jetzt, Ich werde einen der beliebtesten Subword-Tokenisierungsalgorithmen diskutieren, der als Byte Pair Encoding bekannt ist (BPE).
Willkommen bei der Byte-Paar-Kodierung (BPE)
Bytepaar-Kodierung (BPE) ist eine weit verbreitete Tokenisierungsmethode unter transformatorbasierten Modellen. BPE spricht die Probleme von Zeichen- und Wort-Tokenizern an:
- BPE bekämpft OOV effektiv. Segmentieren Sie OOV als Unterwörter und stellen Sie das Wort in Bezug auf diese Unterwörter dar.
- Die Länge der Eingabe- und Ausgabesätze nach BPE ist kürzer als bei der Zeichen-Tokenisierung
BPE es un algoritmo de SegmentierungDie Segmentierung ist eine wichtige Marketingtechnik, bei der ein breiter Markt in kleinere, homogenere Gruppen unterteilt wird. Diese Praxis ermöglicht es Unternehmen, ihre Strategien und Botschaften an die spezifischen Merkmale jedes Segments anzupassen, So verbessern Sie die Effektivität Ihrer Kampagnen. Das Targeting kann auf demografischen Kriterien basieren, psychografisch, geografisch oder verhaltensbezogen, Erleichterung einer relevanteren und persönlicheren Kommunikation mit der Zielgruppe.... de palabras que fusiona los caracteres o secuencias de caracteres que ocurren con más frecuencia de forma iterativa. Hier ist eine Schritt-für-Schritt-Anleitung zum Erlernen von BPE.
Schritte zum Erlernen von BPE
- Teilen Sie die Wörter im Korpus nach dem Hinzufügen in Zeichen auf
- Initialisieren Sie das Vokabular mit eindeutigen Zeichen im Korpus.
- Berechnen Sie die Häufigkeit eines Zeichenpaares oder einer Zeichenfolge im Korpus
- Das häufigste Paar im Korpus zusammenführen
- Speichern Sie das beste Wortschatzpaar
- Schritte wiederholen 3 ein 5 für eine bestimmte Anzahl von Iterationen
Wir werden die Schritte anhand eines Beispiels verstehen.
Betrachten Sie ein Korpus: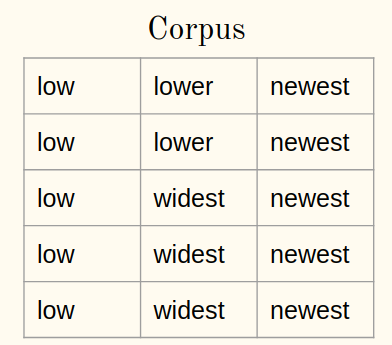
1ein) Füge das Symbol am Ende des Wortes hinzu (Sag es ) zu jedem Wort des Korpus:
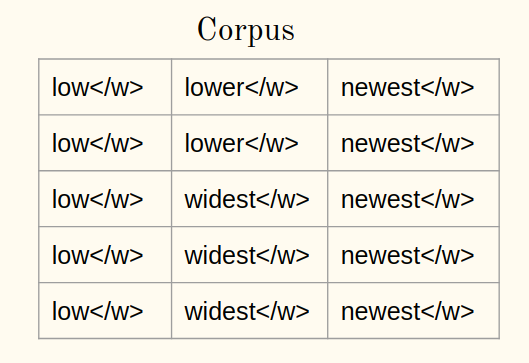
1B) Markiere die Wörter eines Korpus in Zeichen:
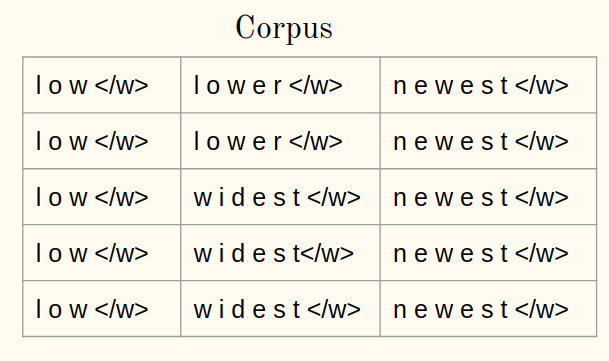
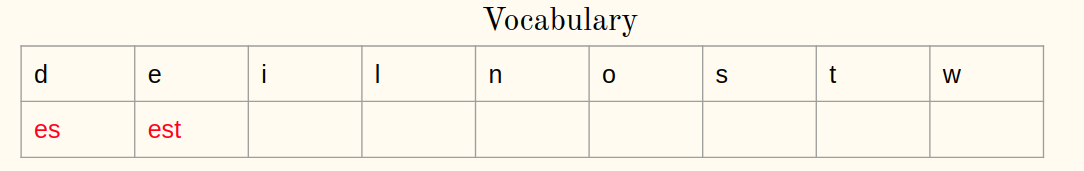
2. Initialisieren Sie das Vokabular:
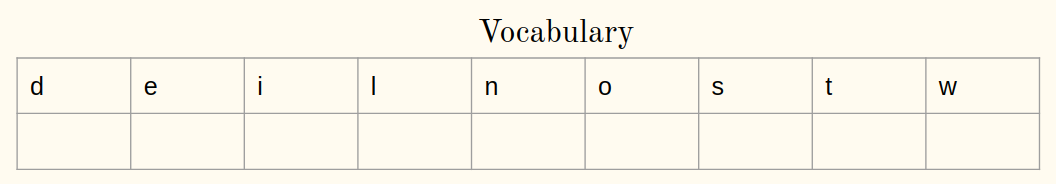
Wiederholung 1:
3. Frequenz berechnen:
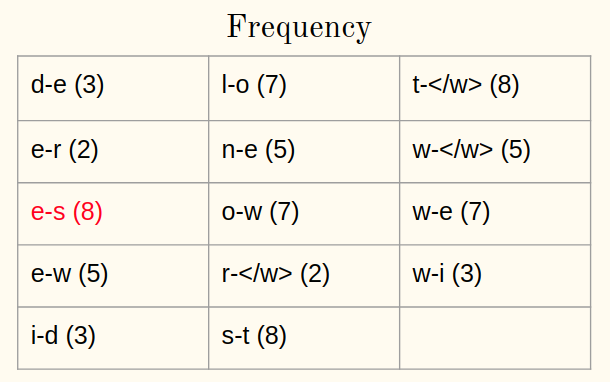
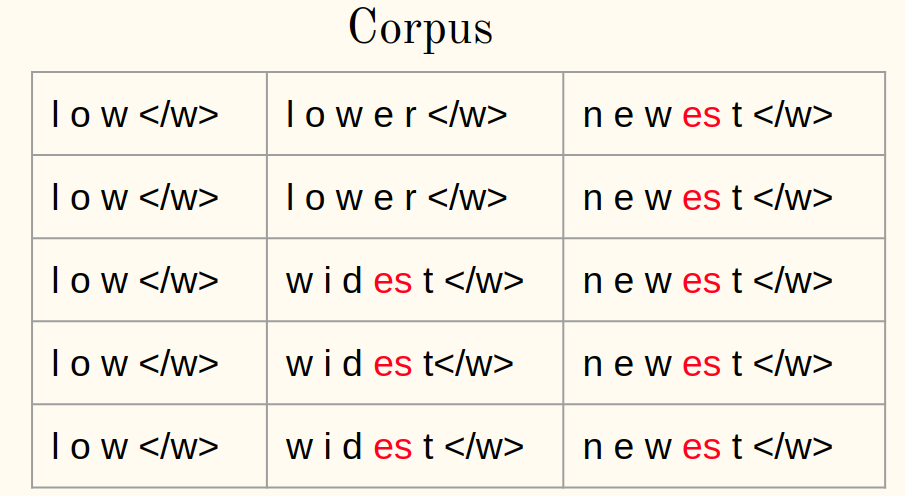
4. Das häufigste Paar zusammenführen:
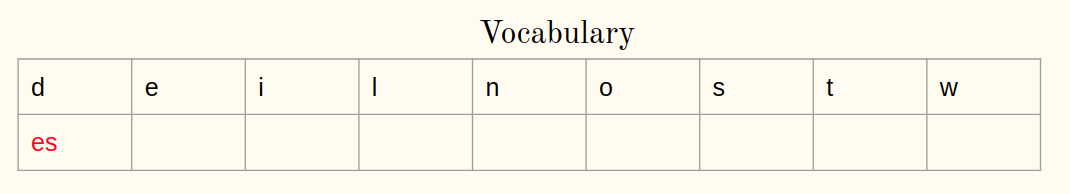
5. Speichern Sie das beste Paar:
Schritte wiederholen 3-5 für jede Iteration von nun an. Lassen Sie mich eine weitere Iteration veranschaulichen.
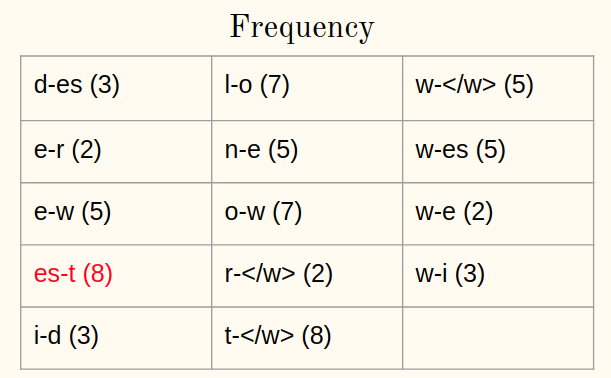
Wiederholung 2:
3. Frequenz berechnen:
4. Das häufigste Paar zusammenführen:
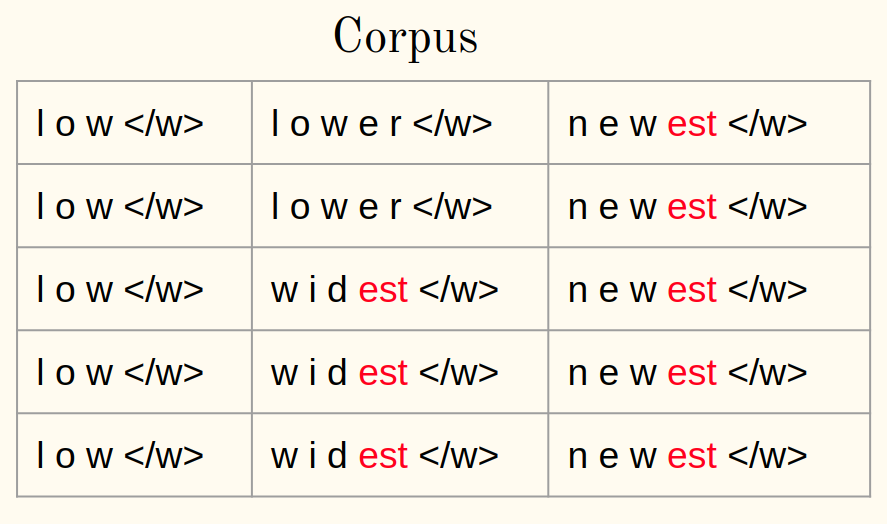
5. Speichern Sie das beste Paar:
Nach 10 Iterationen, BPE-Merge-Operationen sehen so aus:
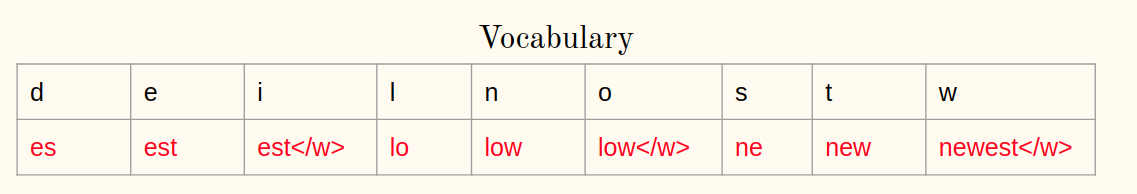
Ziemlich einfach, Wahrheit?
BPE auf OOV Palabras anwenden
Aber, Wie können wir das Wort OOV zur Testzeit mithilfe von BPE-erlernten Operationen darstellen?? Irgendwelche Ideen? Beantworten wir diese Frage jetzt.
Zum Zeitpunkt des Tests, das Wort OOV ist in Zeichenfolgen unterteilt. Später, erlernte Operationen werden angewendet, um Zeichen zu größeren bekannten Symbolen zusammenzuführen.
– Neuronale maschinelle Übersetzung seltener Wörter mit Teilworteinheiten, 2016
Dann, ein schrittweises Verfahren zum Rendern von OOV-Wörtern wird gezeigt:
- Teilen Sie das Wort OOV nach dem Hinzufügen in Zeichen auf
- Berechnen Sie ein paar Zeichen oder Zeichenfolgen in einem Wort
- Wählen Sie die Paare aus, die in den erlernten Operationen vorhanden sind
- Das häufigste Paar zusammenführen
- Schritte wiederholen 2 Ja 3 bis eine Verschmelzung möglich ist
Lassen Sie uns das alles unten in Aktion sehen!!
Tokenisierungsimplementierung: Byte-Paar-Codierung in Python
Jetzt wissen wir, wie BPE funktioniert: OOV-Wörter lernen und anwenden. Dann, es ist Zeit unser Wissen in Python umzusetzen.
Python-Code für BPE ist jetzt im Originaldokument verfügbar (Neuronale maschinelle Übersetzung seltener Wörter mit Teilworteinheiten, 2016)
Lesekorpus
Wir betrachten ein einfaches Korpus, um die Idee von BPE zu veranschaulichen. Aber trotzdem, die gleiche Idee gilt auch für ein anderes Korpus:
Vorbereitung von Texten
Markiere die Wörter in Zeichen im Korpus und füge am Ende jedes Wortes hinzu:
BPE lernen
Berechnen Sie die Häufigkeit jedes Wortes im Korpus:
Produktion:

Lassen Sie uns eine Funktion definieren, um die Häufigkeit eines Zeichenpaars oder einer Zeichenfolge zu berechnen. Akzeptiert den Korpus und gibt das Paar mit seiner Frequenz zurück:
Jetzt, die nächste Aufgabe besteht darin, das häufigste Paar des Korpus zusammenzuführen. Wir definieren eine Funktion, die den Korpus akzeptiert, bestes Paar und gibt den modifizierten Korpus zurück:
Dann, Es ist Zeit, BPE-Operationen zu lernen. Wie BPE ein iteratives Verfahren ist, wir werden die Schritte für eine Iteration durchführen und verstehen. Berechnen wir die Häufigkeit der Bigramme:
Produktion: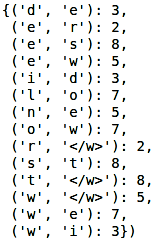
Finden Sie das häufigste Paar:
Produktion: (‚e‘, ‚S‘)
Schließlich, ordne das beste Paar zu und speichere es in Vokabeln:
Produktion: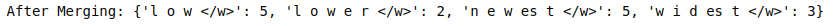
Wir werden ähnliche Schritte für bestimmte Iterationen befolgen:
Produktion: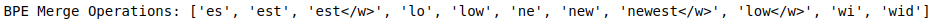
Der interessanteste Teil kommt noch!! Das ist die Anwendung von BPE auf OOV-Wörter.
Wenden Sie BPE auf das OOV-Wort an
Jetzt, wir werden sehen, wie man das Wort OOV mit gelernten Operationen in Unterwörter segmentiert. Betrachten Sie das Wort OOV als „niedriger“:
Das Anwenden von BPE auf ein OOV-Wort ist ebenfalls ein iterativer Prozess. Wir werden die zuvor im Artikel besprochenen Schritte implementieren:
Produktion:
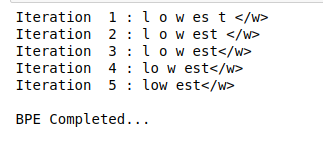
Wie Sie hier sehen können, das unbekannte Wort „niedriger“ ist als niedrigste segmentiert.
Abschließende Anmerkungen
Die Tokenisierung ist eine leistungsstarke Methode zum Umgang mit Textdaten. Wir haben in diesem Artikel einen Blick darauf geworfen und auch die Tokenisierung mit Python implementiert.
Testen Sie dies mit jedem textbasierten Datensatz, den Sie haben. Je mehr ich übe, desto besser verstehen Sie, wie die Tokenisierung funktioniert (und warum ist es ein so kritisches NLP-Konzept). Zögern Sie nicht, mich in den Kommentaren unten zu kontaktieren, wenn Sie Fragen oder Ideen zu diesem Artikel haben..





