
Einführung:
Einer der wichtigsten Schritte im Rahmen der Datenvorverarbeitung ist das Erkennen und Behandeln von Ausreißern, da sie sich negativ auf die statistische Analyse und den Prozess der AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... eines Machine-Learning-Algorithmus, was zu einer geringeren Präzision führt.
1. Was sind Ausreißer? 🤔
Wir alle haben schon von Redewendungen gehört ‚seltsam, was etwas Ungewöhnliches im Vergleich zu anderen in einer Gruppe bedeutet.
Ähnlich, Ein Ausreißer ist eine Beobachtung in einem bestimmten Datensatz, die weit von den übrigen Beobachtungen entfernt ist. Das heißt, ein Ausreißer ist viel größer oder kleiner als die restlichen Werte im Set..
2. Warum treten sie auf??
Ein Ausreißer kann aufgrund von Schwankungen in den Daten auftreten, oder aufgrund experimenteller Fehler / menschlicher Fehler.
Kann auf experimentelle Fehler oder große Schiefe in den Daten hinweisen (starke Leimverteilung).
3. Das beeinflusst?
In der Statistik, wir haben drei Maße der zentralen Tendenz: Medien, MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... & Mode. Helfen Sie uns, die Daten zu beschreiben.
Der Mittelwert ist das genaue Maß zur Beschreibung der Daten, wenn keine Ausreißer vorhanden sind..
Der Median wird verwendet, wenn der Datensatz einen Ausreißer enthält.
Der Modus wird verwendet, wenn ein Ausreißer vorhanden ist UND etwa die Hälfte oder mehr der Daten gleich sind.
Das „Medien“ ist das einzige Maß für die zentrale Tendenz, das von Ausreißern beeinflusst wird, was wiederum die Standardabweichung beeinflusst.
Beispiel:
Betrachten Sie einen kleinen Datensatz, Probe = [15, 101, 18, 7, 13, 16, 11, 21, 5, 15, 10, 9]. Es anschauen, Man kann schnell sagen, dass ‚101‘ ist ein Ausreißer, der viel größer ist als die anderen Werte.
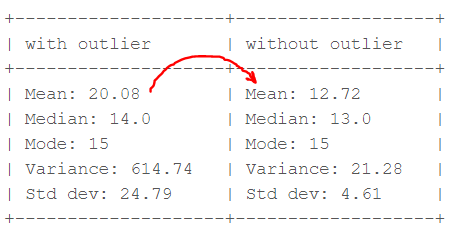
Aus den obigen Berechnungen, Wir können eindeutig sagen, dass der Durchschnitt stärker betroffen ist als der Median.
4. Erkennung atypischer Werte
Wenn unser Datensatz klein ist, wir können den Ausreißer erkennen, indem wir uns einfach den Datensatz ansehen. Aber, Was ist, wenn wir einen großen Datensatz haben?, wie wir Ausreißer identifizieren? Wir müssen Visualisierungstechniken und Mathematik anwenden.
Hier sind einige der Techniken, um Ausreißer zu erkennen.
- BoxplotsBox-Diagramme, Auch bekannt als Box- und Whisker-Diagramme, sind statistische Werkzeuge, die die Verteilung eines Datensatzes darstellen. Diese Diagramme zeigen den Median, Quartile und Ausreißer, Ermöglicht die Visualisierung von Datenvariabilität und -symmetrie. Sie sind nützlich für den Vergleich zwischen verschiedenen Gruppen und in der explorativen Analyse, So lassen sich Trends und Muster in den Daten leichter erkennen....
- Z-Score
- Intervall zwischen Quantilen (IQR)
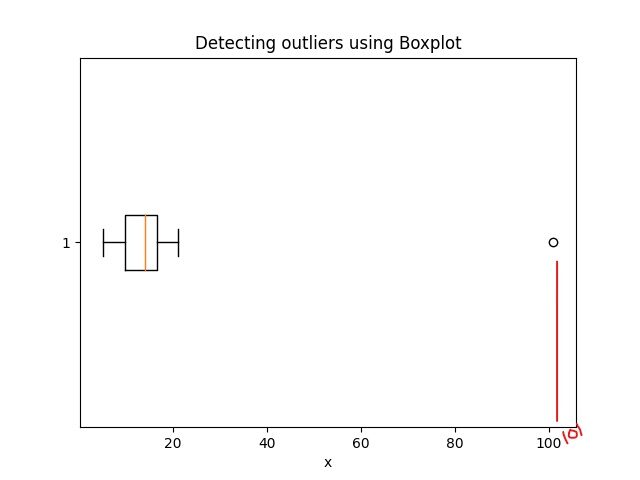
4.1 Erkennung atypischer Werte mittels Boxplot:
Der Python-Code für den Boxplot ist:
import matplotlib.pyplot als plt
plt.boxplot(Stichprobe, vert=Falsch)
plt.titel("Erkennen von Ausreißern mit Boxplot")
plt.xlabel(Beispiel)
4.2 Ausreißererkennung mit Z-Scores
Kriterien: jeder Datenpunkt, dessen Z-Score außerhalb der 3. Standardabweichung liegt, ist ein Ausreißer.
Schritte:
- Schleife alle Datenpunkte durch und berechne den Z-Score mit der Formel (Xi-bedeuten) / std.
- setzen Sie einen Schwellenwert von 3 und markieren Sie die Datenpunkte, deren absoluter Wert des Z-Scores größer als der Schwellenwert ist, als Ausreißer.
numpy als np importieren
Ausreißer = []
def detect_outliers_zscore(Daten):
    thres = 3
    Mittelwert = np.Mittelwert(Daten)
    std = z.B. std(Daten)
    # drucken(bedeuten, std)
    für ich in daten:
        z_score = (ich meine)/std
        wenn (np.abs(z_score) > thres):
            Ausreißer.anhängen(ich)
    geben Ausreißer zurück# Treibercode
sample_outliers = detect_outliers_zscore(Stichprobe)
drucken("Ausreißer von der Z-Scores-Methode: ", sample_outliers)
Die Ergebnisse des obigen Codes: Ausreißer der Z-Score-Methode: [101]
4.3 Ausreißererkennung anhand des Bereichs zwischen Quantilen (IQR)
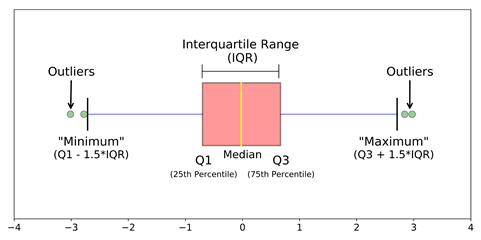
Kriterien: die gefundenen Datenpunkte 1,5 mal der IQR über Q3 und unter Q1 sind Ausreißer.
Schritte:
- Sortieren Sie den Datensatz in aufsteigender Reihenfolge
- berechne das erste und dritte Quartil (Q1, Q3)
- IQR berechnen = Q3-Q1
- untere Grenze berechnen = (Q1–1,5 * IQR), obere Grenze = (Q3 + 1.5 * IQR)
- Durchlaufen Sie die Datensatzwerte und überprüfen Sie diejenigen, die die Untergrenze unter- und die Obergrenze überschreiten, und markieren Sie sie als Ausreißer
Python-Code:
Ausreißer = []
def detect_outliers_iqr(Daten):
    Daten = sortiert(Daten)
    q1 = np.Perzentil(Daten, 25)
    q3 = np.Perzentil(Daten, 75)
    # drucken(q1, q3)
    IQR = q3-q1
    lwr_bound = q1-(1.5*IQR)
    upr_bound = q3+(1.5*IQR)
    # drucken(lwr_bound, upr_bound)
    für ich in daten:
        Wenn (ich<lwr_bound oder i>upr_bound):
            Ausreißer.anhängen(ich)
    geben Ausreißer zurück# Treibercode
sample_outliers = detect_outliers_iqr(Stichprobe)
drucken("Ausreißer aus der IQR-Methode: ", sample_outliers)
Die Ergebnisse des obigen Codes: Ausreißer der IQR-Methode: [101]
5. Umgang mit Ausreißern
Bisher haben wir etwas über die Ausreißererkennung gelernt. Die Hauptfrage ist WAS machen wir mit den Ausreißern?
Hier sind einige der Methoden zum Umgang mit Ausreißern.
- Trimmen / Ausreißer entfernen
- Quantilbasierte Beschichtungen und Beläge
- Durchschnittliche Anrechnung / Median
5.1 Ausgeschnitten / Ausreißer entfernen
Bei dieser Technik, wir entfernen Ausreißer aus dem Datensatz. Obwohl es keine gute Praxis ist, zu folgen.
Python-Code zum Entfernen des Ausreißers und Kopieren der restlichen Elemente in ein anderes Array.
# Trimmen
für i in sample_outliers:
    a = np.löschen(Stichprobe, np.wo(Probe==i))
drucken(ein)
# drucken(len(Stichprobe), len(ein))
Der Ausreißer ‚101‘ wird gelöscht und die restlichen Datenpunkte werden in ein anderes Array kopiert ‚ein‘.
5.2 Quantilbasierte Beläge und Beläge
Bei dieser Technik, der Ausreißer ist auf einen bestimmten Wert oberhalb des Perzentilwertes begrenzt 90 oder um einen Faktor unter dem Perzentilwert reduziert 10.
Python-Code:
# Computer 10th, 90Perzentile und Ersetzen der Ausreißer
zehntes_perzentil = np.perzentil(Stichprobe, 10)
neunzigstes_Perzentil = np.Perzentil(Stichprobe, 90)
# drucken(zehntes_perzentil, neunzigstes_perzentil)b = np.wo(Stichprobe<zehntes_perzentil, zehntes_perzentil, Stichprobe)
b = np.wo(B>neunzigstes_perzentil, neunzigstes_perzentil, B)
# drucken("Stichprobe:", Stichprobe)
drucken("Neues Array:",B)
Die Ergebnisse des obigen Codes: Neue Matrix: [15, 20.7, 18, 7.2, 13, 16, 11, 20.7, 7.2, 15, 10, 9]
Datenpunkte, die kleiner als das Perzentil sind 10 werden durch den Perzentilwert ersetzt 10 und Datenpunkte, die größer als das Perzentil sind 90 werden durch den Perzentilwert ersetzt 90.
5.3 gemeine Anrechnung / Median
Da der Mittelwert stark von Ausreißern beeinflusst wird, Es wird empfohlen, Ausreißer durch den Medianwert zu ersetzen.
Python-Code:
Median = np.median(Stichprobe)# Durch Median ersetzen
für i in sample_outliers:
    c = np.wo(Probe==i, 14, Stichprobe)
drucken("Stichprobe: ", Stichprobe)
drucken("Neues Array: ",C)
# drucken(x.dtype)
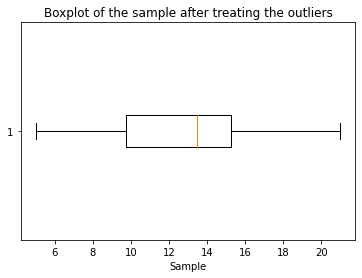
Anzeigen der Daten nach der Behandlung des Ausreißers
plt.boxplot(C, vert=Falsch)
plt.titel("Boxplot der Stichprobe nach Behandlung der Ausreißer")
plt.xlabel("Stichprobe")
Zusammenfassung:
In diesem Blog, Wir haben eine wichtige Phase der Datenvorverarbeitung kennengelernt, nämlich den Umgang mit Ausreißern. Jetzt kennen wir verschiedene Methoden, um Ausreißer zu erkennen und zu behandeln.
Verweise:
Z-Score für Ausreißererkennung
IQR zur Erkennung atypischer Werte
GitHub-Repository zur Abfrage des Jupyter-Notebooks
Ich hoffe, dieser Blog hilft Ihnen, das Konzept der Ausreißer zu verstehen. Bitte, stimme ab, wenn es dir gefällt. Viel Spaß beim Lernen !! 😊
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





