
Dieser Artikel wurde im Rahmen der Data Science Blogathon
Ein Empfehlungssystem ist eine der Hauptanwendungen der Data Science. Jedes Consumer-Internet-Unternehmen benötigt ein Empfehlungssystem wie Netflix, Youtube, ein Nachrichtendienst, etc. Was Sie aus einer Vielzahl von Artikeln zeigen möchten, ist ein Empfehlungssystem.
Inhaltsverzeichnis
- Einführung in ein Empfehlungssystem
- Arten von Empfehlungssystemen
- Buchempfehlungssystem
- Inhaltsbasierte Filterung
- Kollaboratives Filtern
- Hybridfilterung
- System der praktischen Empfehlungen
- Beschreibung des Datensatzes
- Daten vorverarbeiten
- EDA durchführen
- Gruppierung
- Vorhersagen
- Abschließende Anmerkungen
Was ist das Empfehlungssystem wirklich?
Eine Empfehlungsmaschine ist eine Klasse für maschinelles Lernen, die dem Kunden relevante Vorschläge macht. Vor dem Empfehlungssystem, die größte Kaufneigung bestand darin, einen Vorschlag von Freunden anzunehmen. Aber jetzt weiß Google, welche Nachrichten es lesen wird, Youtube weiß, welche Art von Videos Sie basierend auf Ihrem Suchverlauf sehen werden, Wiedergabehistorie oder Kaufhistorie.
Ein Empfehlungssystem hilft einem Unternehmen, treue Kunden zu gewinnen und Vertrauen in die gewünschten Produkte und Dienstleistungen für diejenigen aufzubauen, die Ihre Website besucht haben.. Das aktuelle Empfehlungssystem ist so leistungsfähig, dass es auch mit dem Neukunden, der die Seite zum ersten Mal besucht hat, umgehen kann.. Sie empfehlen Produkte, die im Trend liegen oder hoch bewertet sind, und können auch Produkte empfehlen, die dem Unternehmen den maximalen Nutzen bringen.
Arten von Empfehlungssystemen
Ein Empfehlungssystem wird im Allgemeinen unter Verwendung von 3 Techniken zur inhaltsbasierten Filterung, kollaboratives Filtern und eine Kombination aus beidem.
1) Inhaltsbasierte Filterung
Der Algorithmus empfiehlt ein ähnliches Produkt wie die Blicke. In einfachen Worten, in diesem Algorithmus, Wir versuchen, ein Element zu finden, das aussieht wie. Zum Beispiel, eine Person sieht gerne Aufnahmen von Sachin Tendulkar, Vielleicht möchten Sie also auch Aufnahmen von Ricky Ponting sehen, da die beiden Videos ähnliche Tags und Kategorien haben.
Nur sieht es zwischen den Inhalten ähnlich aus und konzentriert sich nicht mehr auf die Person, die dies sieht. Empfehlen Sie nur das Produkt mit der höchsten Punktzahl basierend auf früheren Präferenzen.
2) Zusammenarbeitsbasierte Filterung
Kollaborationsbasierte Filterempfehlungssysteme basieren auf vergangenen Interaktionen von Benutzern und Zielelementen. In einfachen Worten, Wir versuchen, ähnliche Kunden zu finden und Produkte anzubieten, die auf ihrem Aussehen basieren. Lass es uns mit einem Beispiel verstehen. X und Y sind zwei ähnliche Benutzer und Benutzer X hat Filme A gesehen, Von C. UND Benutzer Y hat B-Filme gesehen, C und D, dann empfehlen wir dem Benutzer Y einen Film und dem Benutzer X einen Film D.
YouTube hat sein Empfehlungssystem von einer inhaltsbasierten Filtertechnik zu einer auf Zusammenarbeit umgestellt.. Wenn Sie schon einmal erlebt haben, es gibt auch Videos, die nichts mit deiner Geschichte zu tun haben, aber es empfiehlt es auch, weil die andere Person, die dir ähnlich ist, es gesehen hat.
3) Hybride Filtermethode
Es ist im Grunde eine Kombination der beiden vorherigen Methoden. Es ist ein zu komplexes Modell, das ein Produkt aufgrund seiner Geschichte und ähnlicher Benutzer wie Sie empfiehlt.
Es gibt einige Organisationen, die diese Methode verwenden, wie z. B. Facebook, das Nachrichten zeigt, die für Sie und andere auch in Ihrem Netzwerk wichtig sind, und dasselbe wird auch von Linkedin verwendet..
Buchempfehlungssystem
Ein Buchempfehlungssystem ist eine Art Empfehlungssystem, bei dem wir dem Leser aufgrund seines Interesses ähnliche Bücher empfehlen müssen. Das Buchempfehlungssystem wird von Online-Websites verwendet, die E-Books anbieten, wie z. B. Google Play Books, Bibliothek öffnen, gute lektüre, etc.
In diesem Artikel, Wir werden die kollaborative Filtermethode verwenden, um ein Buchempfehlungssystem zu erstellen. Sie können den Datensatz herunterladen von hier
Praktische Umsetzung des Empfehlungssystems
Machen wir uns die Hände schmutzig, während wir versuchen, ein Buchempfehlungssystem mit kollaborativer Filterung zu implementieren.
Beschreibung des Datensatzes
haben 3 Dateien in unserem Datensatz, die aus einigen Büchern stammen, die Websites verkaufen.
- Bücher: Zuerst sind es Bücher, die alle Informationen zu den Büchern enthalten, als Autor, Titel, das Erscheinungsjahr, etc.
- Benutzer: die zweite Datei enthält Informationen des registrierten Benutzers, als Benutzerkennung, Ort.
- Bewertungen: Noten enthalten Informationen, z. B. welcher Benutzer welchem Buch die Note gegeben hat.
Dann, basierend auf diesen drei Dateien, Wir können ein leistungsstarkes kollaboratives Filtermodell erstellen. Lasst uns beginnen.
Lade Daten
Beginnen wir mit dem Importieren von Bibliotheken und Laden von Datensätzen. Beim Laden der Datei haben wir einige Probleme wie.
- CSV-Dateiwerte werden durch Semikolons getrennt, nicht im Koma.
- Es gibt einige Zeilen, die nicht funktionieren, da wir sie nicht mit Pandas importieren konnten und es wird ein Fehler ausgegeben, da Python eine interpretierte Sprache ist.
- Die Kodierung einer Datei ist in Latein
Dann, beim Laden von Daten, wir müssen diese Ausnahmen behandeln und nach der Ausführung des folgenden Codes, Sie erhalten eine Warnung und es wird angezeigt, welche Zeilen einen Fehler aufweisen, den wir beim Laden übersehen haben.
numpy als np importieren
Pandas als pd importieren
Bücher = pd.read_csv("BX-Books.csv", sep=';', Kodierung="lateinisch-1", error_bad_lines=Falsch)
Benutzer = pd.read_csv("BX-Users.csv", sep=';', Kodierung="lateinisch-1", error_bad_lines=Falsch)
Bewertungen = pd.read_csv("BX-Buch-Bewertungen.csv", sep=';', Kodierung="lateinisch-1", error_bad_lines=Falsch)
Datenvorverarbeitung
Jetzt, im Bucharchiv, wir haben einige zusätzliche Spalten, die für unsere Aufgabe nicht benötigt werden, wie die URLs der Bilder. Und wir werden die Spalten jeder Datei umbenennen, da der Spaltenname Leerzeichen und Großbuchstaben enthält, damit wir ihn korrigieren können, um die Verwendung zu vereinfachen.
Bücher = Bücher[['ISBN', 'Buchtitel', 'Buchautor', 'Veröffentlichungsjahr', 'Verlag']]
Bücher.umbenennen(Spalten = {'Buchtitel':'Titel', 'Buchautor':'Autor', 'Veröffentlichungsjahr':'Jahr', 'Verlag':'Verlag'}, inplace=Wahr)
Benutzer.umbenennen(Spalten = {'Benutzer-ID':'user_id', 'Standort':'Standort', 'Alter':'age'}, inplace=Wahr)
Bewertungen.umbenennen(Spalten = {'Benutzer-ID':'user_id', 'Buchbewertung':'Bewertung'}, inplace=Wahr)
Jetzt, wenn Sie den Header jedes Datenrahmens sehen, du kannst sowas sehen.
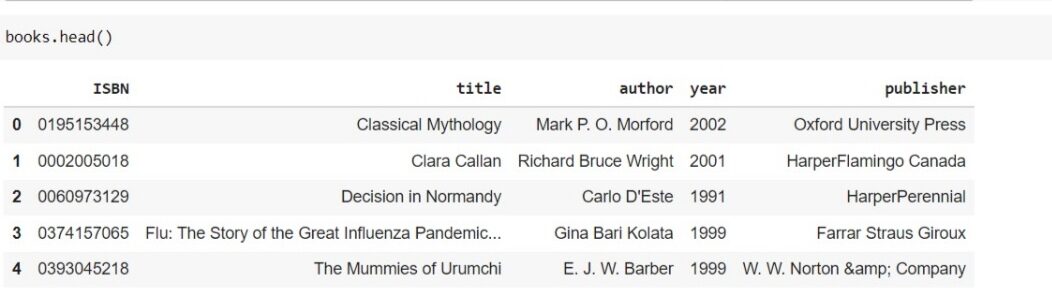
Der Datensatz ist zuverlässig und kann als großer Datensatz betrachtet werden. Verfügen über 271360 Datenbücher und die Gesamtzahl der auf der Website registrierten Benutzer beträgt ungefähr 278000 und haben eine Bewertung von nahe abgegeben 11 lakh. Daher, Wir können sagen, dass der Datensatz, den wir haben, gut und zuverlässig ist.
Herangehensweise, ein Problem zu stellen
Wir möchten keine Ähnlichkeiten zwischen Benutzern oder Büchern finden. Wir wollen das tun Wenn es einen Benutzer A gibt, der die Bücher x und y gelesen und gemocht hat, und Benutzer B hat auch diese beiden Bücher gemocht und jetzt hat Benutzer A ein Buch z gelesen und gemocht, das nicht von B gelesen wird, also müssen wir dem Benutzer B z book empfehlen. Das ist kollaboratives Filtern.
Dann, dies wird durch Matrixfaktorisierung erreicht, Wir werden eine Matrix erstellen, in der die Spalten die Benutzer und die Indizes die Bücher sind und der Wert die Note ist. Como si tuviéramos que crear una dynamische TabellePivotTable ist ein leistungsstarkes Tool in Tabellenkalkulationsprogrammen, wie Microsoft Excel und Google Sheets. Ermöglicht es Ihnen, zusammenzufassen, Große Datenmengen effizient analysieren und visualisieren. Durch seine intuitive Benutzeroberfläche, Benutzer können Informationen neu anordnen, Anwenden von Filtern und Erstellen von benutzerdefinierten Berichten, Erleichterung einer fundierten Entscheidungsfindung in verschiedenen Kontexten, Von der Wirtschaft bis zur akademischen Forschung.....
Ein großer Fehler mit einer Problemstellung im Datensatz.
Wenn wir alle Bücher und alle Benutzer zum Modellieren nehmen, Glaubst du nicht, dass es ein Problem sein wird?? Wir müssen also die Anzahl der Benutzer und Bücher reduzieren, da wir einen Benutzer, der sich nur auf der Website registriert hat oder nur ein oder zwei Bücher gelesen hat, nicht berücksichtigen können. Bei solchen Benutzern, Wir können uns nicht darauf verlassen, dass wir anderen Bücher empfehlen, weil wir Wissen aus den Daten extrahieren müssen. Dann, Wir werden diese Anzahl begrenzen und einen Benutzer nehmen, der mindestens eine Bewertung abgegeben hat 200 Bücher und wir werden auch die Bücher begrenzen und nur die Bücher nehmen, die mindestens erhalten haben 50 Benutzerbewertungen.
Explorative Datenanalyse
Beginnen wir also mit der Analyse und bereiten wir den Datensatz wie besprochen für die Modellierung vor. Sehen wir uns an, wie viele Benutzer Bewertungen abgegeben haben, und extrahieren Sie die Benutzer, die mehr als gegeben haben 200 Bewertungen.
Bewertungen['user_id'].value_counts()
Paso 1) Extrahieren Sie Benutzer und Bewertungen aus mehr als 200
wenn Sie den obigen Code ausführen, das können wir nur sehen 105283 Leute haben eine Bewertung zwischen . abgegeben 278000. Jetzt werden wir die Benutzer-IDs extrahieren, die mehr als gewährt haben 200 Noten und wenn wir die Benutzer-IDs haben, werden wir die Qualifikationen nur aus diesen Benutzer-IDs aus dem Qualifikationsdatenrahmen extrahieren.
x = Bewertungen['user_id'].value_counts() > 200
y = x[x].index  #user_ids
print(y.form)
Bewertungen = Bewertungen[Bewertungen['user_id'].Strahl(Ja)]
2. Schritt) Noten mit Büchern zusammenführen
Dann ist da 900 Benutzer, die eine Bewertung von . abgegeben haben 5.2 lakh und das wollen wir. Jetzt werden wir die Bewertungen mit den Büchern basierend auf der ISBN zusammenführen, sodass wir die Bewertung jedes Benutzers für jede Buch-ID und des Benutzers, der diese Buch-ID nicht bewertet hat, erhalten, der Wert ist null.
rating_with_books = ratings.merge(Bücher, on='ISBN')
rating_with_books.head()
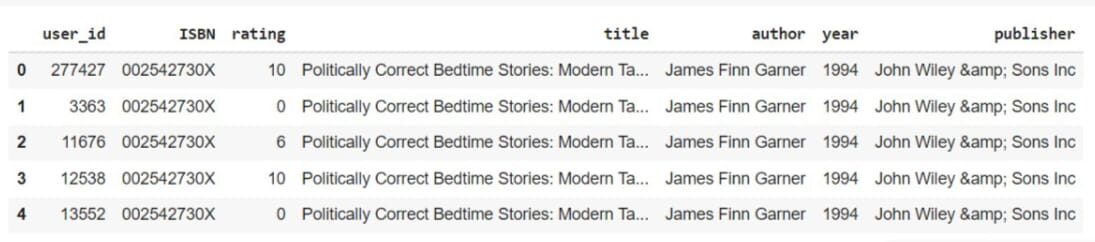
3. Schritt) Schauen Sie sich Bücher an, die mehr als erhalten haben 50 Bewertungen.
Jetzt hat sich die Größe des Datenrahmens verringert und wir haben 4.8 lakh, denn wenn wir den Datenrahmen zusammenführen, wir hatten nicht alle Identifikationsdaten des Buches. Jetzt werden wir die Note jedes Buches zählen, Daher werden wir die Daten basierend auf dem Titel und aggregierte Daten basierend auf der Bewertung gruppieren.
number_rating = rating_with_books.groupby('Titel')['Bewertung'].zählen().reset_index()
number_rating.rename(Spalten= {'Bewertung':'number_of_ratings'}, inplace=Wahr)
final_rating = rating_with_books.merge(number_rating, on='Titel')
final_rating.shape
final_rating = final_rating[final_rating['number_of_ratings'] >= 50]
final_rating.drop_duplicates(['user_id','Titel'], inplace=Wahr)
wir müssen doppelte Werte entfernen, weil derselbe Benutzer dasselbe Buch mehrmals bewertet hat, wird ein problem machen. Schließlich, Wir haben einen Datensatz mit diesem Benutzer, der mehr als bewertet hat 200 Bücher und Bücher, die mehr als erhalten haben 50 Bewertungen. die Form des endgültigen Datenrahmens ist 59850 Reihen und 8 Säulen.
Paso 4) Pivot-Tabelle erstellen
Wie wir bereits besprochen haben, Wir erstellen eine Pivot-Tabelle, in der die Spalten die Benutzerkennungen sind, das IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... será el título del libro y el valor las calificaciones. Und die Benutzer-ID, die kein Buch bewertet hat, hat den Wert NAN, also unterstelle es mit null.
book_pivot = final_rating.pivot_table(Spalten="Benutzeridentifikation", index='title', Werte="Bewertung")
book_pivot.fillna(0, inplace=Wahr)
Wir können sehen, dass die mehr als 11 Benutzer wurden entfernt, weil ihre Noten in den Büchern enthalten waren, die nicht mehr als . erhalten 50 Bewertungen, also werden sie aus dem Bild entfernt.
Modellieren
Wir haben unseren Datensatz zum Modellieren vorbereitet. Wir verwenden den Algorithmus der nächsten Nachbarn, das ist das gleiche wie das nächste K, die für die Gruppierung basierend auf dem euklidischen Abstand verwendet wird.
Aber hier, in der Pivot-Tabelle, wir haben viele Nullwerte und in der Gruppierung, diese Rechenleistung wird erhöht, um den Abstand von Nullwerten zu berechnen, Also konvertieren wir die Pivot-Tabelle in die Sparse-Matrix und füttern sie dann an das Modell.
aus scipy.sparse import csr_matrix
book_sparse = csr_matrix(book_pivot)
Jetzt trainieren wir den Algorithmus der nächsten Nachbarn. hier müssen wir einen Algorithmus angeben, der grob den Abstand von jedem Punkt zu allen anderen Punkten ermittelt.
von sklearn.neighbors import NearestNeighbors
Modell = Nächste Nachbarn(algorithm=''brute')
model.fit(book_sparse)
Lass uns eine Vorhersage machen und sehen, ob sie Bücher vorschlägt oder nicht. wir finden die nächsten Nachbarn zur Eintragsbuch-ID und danach, wir drucken die 5 Hauptbücher, die diesen Büchern am nächsten sind. Es liefert uns die Entfernung und die Identifizierung des Buches in dieser Entfernung. Kommen wir zu Harry Potter, Was stimmt damit nicht 237 Indizes.
Entfernungen, Vorschläge = model.kneighbors(book_pivot.iloc[237, :].Werte.umformen(1, -1))
Lass uns alle vorgeschlagenen Bücher drucken.
für mich in Reichweite(len(Vorschläge)):
  drucken(book_pivot.index[Vorschläge[ich]])
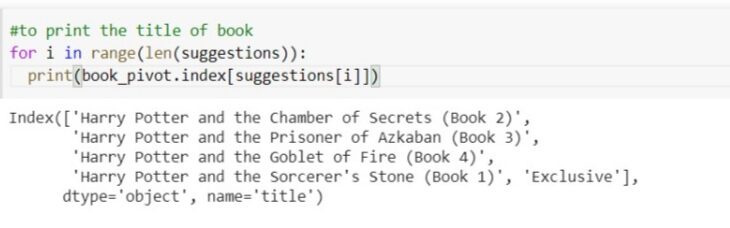
Daher, wir haben erfolgreich ein Buchempfehlungssystem aufgebaut.
Abschließende Anmerkungen
Viva! Wir müssen ein zuverlässiges Buchempfehlungssystem aufbauen und Sie können es modifizieren und in ein endgültiges Projekt verwandeln. Dies ist ein wunderbares Projekt für unbeaufsichtigtes Lernen, bei dem wir viel Vorverarbeitung gemacht haben und Sie den Datensatz weiter erkunden können und, wenn du etwas interessanteres findest, teile es im Kommentarfeld.
Ich hoffe, es war einfach, jede Methode nachzuholen und dem Artikel zu folgen. Wenn Sie eine Frage haben, poste es im Kommentarbereich unten. Bei Fragen helfe ich dir gerne.
Über den Autor
Raghav Agrawal
Ich studiere Informatik. Ich mag Data Science und Big Data sehr. Ich liebe es, mit Daten zu arbeiten und neue Technologien zu lernen. Bitte, melde dich gerne bei mir Linkedin.
Wenn dir mein Artikel gefällt, bitte, lies es auch anderen vor. Verknüpfung
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





