
Einführung
Mit dem wachsenden Bedarf an Data-Science-Administratoren, Wir brauchen Tools, die Data Science stressfrei machen und Spaß machen. Nicht jeder ist bereit, das Programmieren zu lernen, obwohl ich gerne lernen würde / Data Science anwenden. Hier können GUI-basierte Tools hilfreich sein..
Heute, Ich werde Ihnen ein weiteres GUI-basiertes Tool vorstellen: Orange. Dieses Tool ist ideal für Anfänger, die Muster visualisieren und ihre Daten verstehen möchten, ohne wirklich zu wissen, wie man codiert.
In meinem vorherigen Artikel, Ich habe Ihnen ein weiteres GUI-basiertes KNIME-Tool vorgestellt. Wenn Sie nicht programmieren lernen möchten, aber dennoch Data Science anwenden möchten, Sie können jedes dieser Tools ausprobieren.
Am Ende dieses Tutorials, Sie können vorhersagen, welche Person aus einem bestimmten Personenkreis für einen Kredit bei Orange in Frage kommt.
Inhaltsverzeichnis:
- Warum Orange??
- Einrichten Ihres Systems:
- Erstellen Sie Ihren ersten Workflow
- Machen Sie sich mit den Grundlagen vertraut
- Problemstellung
- Importieren der Datendateien
- Die Daten verstehen
- Wie bereinigen Sie Ihre Daten?
- Trainiere dein erstes Modell
1. Warum Orange??
Orange ist eine Plattform für Mining und Analyse in einem GUI-basierten Workflow. Das bedeutet, dass Sie nicht wissen müssen, wie man codiert, um mit Orange arbeiten und Daten extrahieren zu können., Nummern bearbeiten und Informationen einholen.
Kann Aufgaben ausführen, die von einfachen visuellen Elementen bis hin zu Datenmanipulationen reichen, Transformationen und Data Mining. Konsolidieren Sie alle Funktionen des gesamten Prozesses in einem einzigen Workflow.
Das Beste und das Alleinstellungsmerkmal von Orange ist, dass es einige wundervolle Bilder hat. Sie können Silhouetten ausprobieren, Heatmaps, geografische Karten und alle Arten von Visualisierungen verfügbar.
2. Einrichten Ihres Systems
Orange ist in das Anaconda-Tool integriert, wenn Sie es zuvor installiert haben. Andererseits, Befolgen Sie diese Schritte, um Orange herunterzuladen.
Paso 1: und ein https://orange.biolab.si und klicke auf Herunterladen.
Paso 2: Installieren Sie die Plattform und konfigurieren Sie das Arbeitsverzeichnis für Orange, um Ihre Dateien zu speichern.
So sieht die Orange-Homepage aus. Hat Optionen, mit denen Sie neue Projekte erstellen können, Öffnen Sie aktuelle Projekte oder sehen Sie sich Beispiele an und legen Sie los.
Bevor Sie sich mit der Funktionsweise von Orange befassen, Lassen Sie uns einige Schlüsselbegriffe definieren, die uns helfen, das zu verstehen:
- Ein Widget ist der grundlegende Verarbeitungspunkt jeder Datenmanipulation. Sie können eine Reihe von Aktionen ausführen, je nachdem, was Sie in der Widget-Auswahl auf der linken Seite des Bildschirms auswählen.
- Ein Arbeitsablauf ist die Abfolge von Schritten oder Aktionen, die Sie auf Ihrer Plattform ausführen, um eine bestimmte Aufgabe zu erfüllen.
Du kannst auch gehen zu „Workflow-Beispiele“ auf dem Startbildschirm, um weitere Workflows anzuzeigen, sobald Sie den ersten erstellt haben.
Zur Zeit, klicke auf „Neu“ und beginnen wir mit der Erstellung Ihres ersten Workflows.
3. Erstellen Sie Ihren ersten Workflow
Dies ist der erste Schritt zur Entwicklung einer Lösung für jedes Problem.. Wir müssen zuerst verstehen, welche Schritte wir unternehmen müssen, um unser endgültiges Ziel zu erreichen. Nach dem Klicken „Neu“ im vorherigen Schritt, das hätte ich erschaffen sollen.
Dies ist Ihr leerer Workflow in Orange. Jetzt, Sie sind bereit, jedes Problem zu untersuchen und zu lösen, indem Sie ein beliebiges Widget aus dem Widget-Menü in Ihren Workflow ziehen.
4. Machen Sie sich mit den Grundlagen vertraut
Orange ist eine Plattform, die uns helfen kann, die meisten der heutigen Data-Science-Probleme zu lösen. Temas que van desde las visualizaciones más básicas hasta modelos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen..... Incluso puede evaluar y realizar un Unüberwachtes LernenUnüberwachtes Lernen ist eine Technik des maschinellen Lernens, die es Modellen ermöglicht, Muster und Strukturen in Daten ohne vordefinierte Beschriftungen zu identifizieren. Durch Algorithmen wie k-means und Hauptkomponentenanalyse, Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, wie z. B. Kundensegmentierung, Anomalieerkennung und Datenkomprimierung. Seine Fähigkeit, verborgene Informationen preiszugeben, macht es zu einem wertvollen Werkzeug in der... en conjuntos de datos:
4.1 Ärger
Das Problem, das wir in diesem Tutorial zu lösen versuchen, ist das Übungsproblem. Kreditvorhersage auf die zugegriffen werden kann dieser Link Über Datenhack.
4.2 Importieren von Datendateien
Wir beginnen mit dem ersten und notwendigen Schritt, um unsere Daten zu verstehen und Vorhersagen zu treffen: Importieren unserer Daten
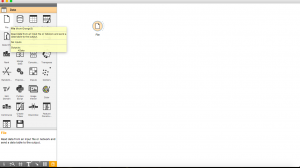
Paso 1: Klicken Sie auf die Registerkarte „Daten“ im Widget-Auswahlmenü und ziehen Sie das Widget „Archiv“ zu unserem Blanko-Workflow.
Paso 2: Doppelklick auf das Widget „Archiv“ und wählen Sie die Datei aus, die Sie in den Workflow hochladen möchten. In diesem Artikel, wie wir lernen, das Übungsproblem der Kreditvorhersage zu lösen, Ich werde den Trainingsdatensatz daraus importieren.
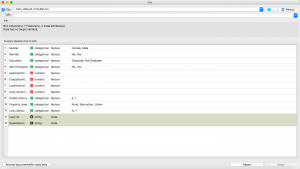
Paso 3: Sobald Sie die Struktur Ihres Datensatzes mit dem Widget sehen können, Rückkehr durch Schließen dieses Menüs.
Paso 4: Jetzt haben wir die rohen .csv-Details, wir müssen sie in ein Format konvertieren, das wir in unserem Mining verwenden können. Klicken Sie auf die gestrichelte Linie um das Widget „Archiv“ und ziehen, und dann irgendwo in das leere Feld klicken.
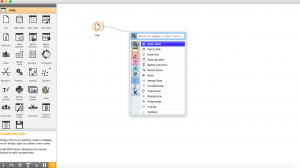
Paso 5: Wie wir eine Datentabelle brauchen, um unsere Ergebnisse besser zu visualisieren, wir klicken auf das Widget „Datentabelle“.
Paso 6: Doppelklicken Sie nun auf das Widget, um seine Tabelle anzuzeigen.
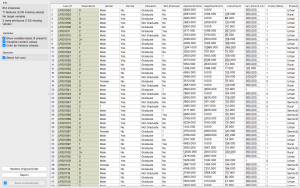
Gereinigt! Es ist nicht so?
Lassen Sie uns nun einige Spalten visualisieren, um interessante Muster in unseren Daten zu finden..
4.3 Unsere Daten verstehen
4.3.1 StreudiagrammEin Streudiagramm ist eine visuelle Darstellung, die die Beziehung zwischen zwei numerischen Variablen mithilfe von Punkten auf einer kartesischen Ebene zeigt. Jede Achse stellt eine Variable dar, und die Position jedes Punktes gibt seinen Wert in Bezug auf beide an.. Diese Art von Diagramm ist nützlich, um Muster zu erkennen, Korrelationen und Trends in den Daten, Erleichterung der Analyse und Interpretation quantitativer Zusammenhänge....
Klicken Sie auf den Halbkreis vor dem Widget „Archiv“ und ziehen Sie es an eine leere Stelle im Workflow und wählen Sie das Widget aus „Ausbreitungsdiagramm“.
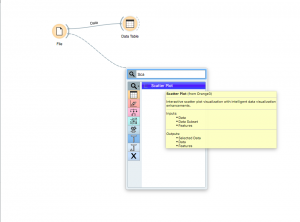
Sobald Sie ein Streudiagramm-Widget erstellt haben, Doppelklicken Sie darauf und erkunden Sie Ihre Daten wie folgt. Sie können die X- und Y-Achsen auswählen, Farben, Formen, Größen und viele andere Manipulationen.
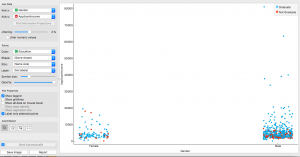
Die Handlung, die ich untersucht habe, ist eine Genrehandlung nach Einkommen, mit den in den Bildungsstufen festgelegten Farben. Wie wir bei Männern sehen können, Die höchste Einkommensgruppe gehören natürlich die Absolventen!
Obwohl bei Frauen, wir sehen, dass viele der weiblichen Absolventen wenig oder gar nichts verdienen. Irgendein bestimmter Grund? Averigüemos usando el AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.....
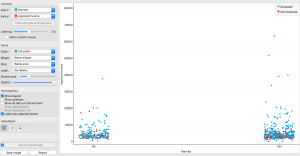
Ein möglicher Grund, den ich gefunden habe, war die Ehe. Es wurde festgestellt, dass eine große Zahl verheirateter Absolventen zu niedrigeren Einkommensgruppen gehört; dies kann auf familiäre Verpflichtungen oder zusätzliche Anstrengungen zurückzuführen sein. Macht perfekt Sinn, Wahrheit?
4.3.2 Verteilung
Eine andere Möglichkeit, unsere Distributionen zu visualisieren, wäre das Widget „Ausschüttungen“. Klicken Sie erneut auf den Halbkreis und ziehen Sie, um das Widget zu finden „Ausschüttungen“.
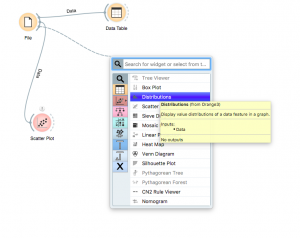
Jetzt doppelklicken Sie darauf und sehen Sie sich an!
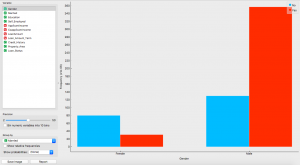
Was wir sehen, ist eine sehr interessante Verteilung. Wir haben mehr verheiratete Männer als Frauen in unserem Datensatz.
4.3.3 Siebdiagramm
Wie hängt das Einkommen mit dem Bildungsniveau zusammen?? Verdienen Absolventen mehr als Absolventen??
Lassen Sie uns mit einem Siebdiagramm visualisieren.
Klicken und ziehen Sie aus dem Widget „Archiv“ und suche nach „Siebdiagramm“.
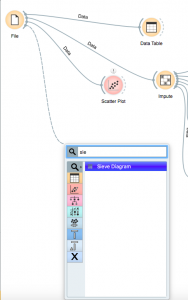
Sobald du es angezogen hast, doppelklicke darauf und wähle deine Achsen aus.
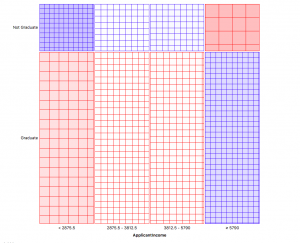
Dieses Diagramm unterteilt die Verteilungsabschnitte in 4 Behälter. Abschnitte können untersucht werden, indem Sie mit der Maus darüber fahren.
Zum Beispiel, Absolventen und Studenten sind geteilt 78% von 22%. Später, Unterteilungen der 25% jeder teilt das Einkommen des Antragstellers auf in 4 gleiche Gruppen. Hier die Aufgabe für dich, Generieren Sie Informationen aus diesen Diagrammen und teilen Sie sie im Kommentarbereich.
Sehen wir uns nun an, wie wir unsere Daten bereinigen, um mit der Erstellung unseres Modells zu beginnen.
5. Wie bereinigen Sie Ihre Daten?
Hier, zu Reinigungszwecken, wir werden die fehlenden Werte imputieren. Die Imputation ist ein sehr wichtiger Schritt, um unsere Daten zu verstehen und optimal zu nutzen.
Klicken Sie auf das Widget „Archiv“ und ziehen Sie, um das Widget zu finden „Zurechnen“.
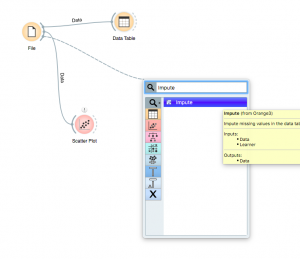
Wenn Sie nach dem Platzieren auf das Widget doppelklicken, Sie werden sehen, dass es eine Vielzahl von Imputationsmethoden gibt, die Sie verwenden können. Sie können auch Standardmethoden verwenden oder einzelne Methoden für jede Klasse separat auswählen.
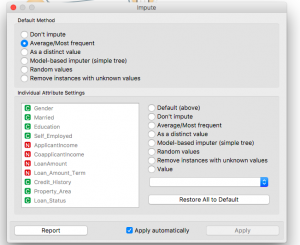
Hier, Ich habe als Standardmethode Durchschnitt für numerische Werte und Häufigste für textbasierte Werte ausgewählt (kategorisch).
Sie können aus einer Vielzahl von Imputationen wählen, wie z:
- Unterschiedlicher Wert
- Zufallswerte
- Zeilen mit fehlenden Werten löschen
- Basierend auf Modellen
Die anderen Dinge, die Sie in Ihren Ansatz zum Trainieren Ihres Modells einbeziehen können, sind die Merkmalsextraktion und -generierung.. Zum besseren Verständnis, Folgen Sie diesem Artikel über Datenexploration und Feature-Engineering (https://www.analyticsvidhya.com/blog/2016/01/guide -data-scan /)
6. Trainiert sein erstes Modell
Angefangen mit den Grundlagen, Wir werden zunächst ein lineares Modell trainieren, das alle Funktionen umfasst, nur um zu verstehen, wie Modelle ausgewählt und erstellt werden.
Paso 1: Zuerst, necesitamos establecer una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... de destino para aplicar la Regresión logística en ella.
Paso 2: Gehe zum Widget „Archiv“ und doppelklicke darauf.
Paso 3: Jetzt, doppelklicken Sie auf die Darlehensstatus Spalte und wählen Sie sie als Zielvariable aus. Klicken Sie auf Übernehmen.
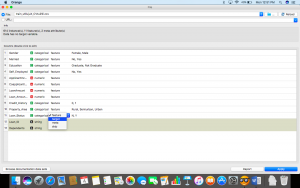
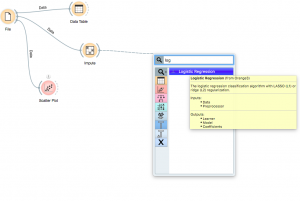
Paso 4: Sobald wir unsere Zielvariable festgelegt haben, finde die sauberen Widget-Daten „Zurechnen“ wie folgt und platzieren Sie das Widget „Logistische Regression“.
Paso 5: Haga doble clic en el widget y seleccione el tipo de RegulierungDie Regularisierung ist ein administrativer Prozess, der darauf abzielt, die Situation von Personen oder Organisationen zu formalisieren, die außerhalb des gesetzlichen Rahmens tätig sind. Dieses Verfahren ist unerlässlich, um Rechte und Pflichten zu gewährleisten, sowie zur Förderung der sozialen und wirtschaftlichen Inklusion. In vielen Ländern, Die Regularisierung wird in Migrationskontexten angewendet, Arbeit und Steuern, denjenigen, die sich in irregulären Situationen befinden, den Zugang zu Leistungen zu ermöglichen und sich vor möglichen Sanktionen zu schützen.... que desea realizar.
- Ridge-Regression:
- L2-Regularisierung durchführen, nämlich, fügt eine Strafe in Höhe von hinzu Betragsquadrat Koeffizienten
- Minimierungsziel = LS Obj + ein * (Summe des Quadrats der Koeffizienten)
- Schleifenregression:
- L1-Regularisierung durchführen, nämlich, fügt eine Strafe in Höhe von hinzu Absolutwert der Größe Koeffizienten
- Minimierungsziel = LS Obj + ein * (Summe der Absolutwerte der Koeffizienten)
Um diese besser zu verstehen, Besuchen Sie den Link zu Ridge- und Lasso-Regressionen https://www.analyticsvidhya.com/blog/2016/01/complete-tutorial-ridge-lasso-regression-python/
Ich habe Ridge für meine Analyse ausgewählt, du kannst zwischen beiden wählen.
Paso 6: Dann, klicke auf das Widget „Zurechnen“ Ö „Logistische Regression“ und finde das Widget „Testen und bewerten“. Stellen Sie sicher, dass Sie beide verbinden Daten und Modell zum Testen des Widgets.
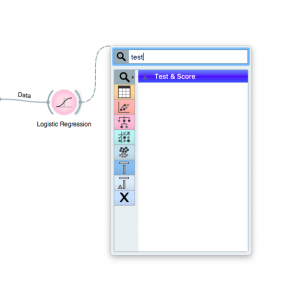 Paso 7: Jetzt, klicke auf das Widget „Testen und bewerten“ um zu sehen, wie gut dein Modell abschneidet.
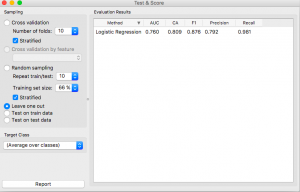
Paso 8: Um die Ergebnisse besser zu visualisieren, Drag & Drop aus dem Widget „Testen und bewerten“ finden „Verwirrung Matrix“.
Paso 9: Sobald Sie es platziert haben, Klicken Sie darauf, um Ihre Ergebnisse anzuzeigen.
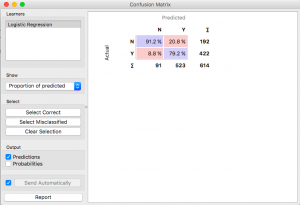
Diesen Weg, Sie können verschiedene Modelle ausprobieren und sehen, wie genau sie funktionieren.
Versuchen wir es zu bewerten, Wie würde ein Random Forest funktionieren?? Ändern Sie die Modellierungsmethode in Random Forest und sehen Sie sich die Konfusionsmatrix an.
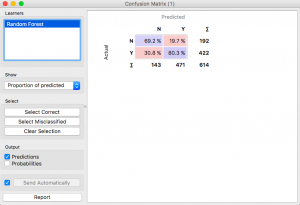
Sieht anständig aus, aber die logistische Regression hat besser funktioniert.
Wir können es noch einmal mit einer Support-Vektor-Maschine versuchen.
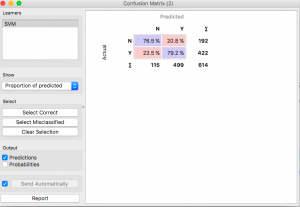
Besser als der Random Forest, aber immer noch nicht so gut wie das logistische Regressionsmodell.
Manchmal, die einfachsten Methoden sind die besten, Es ist nicht so?
So würde Ihr endgültiger Workflow aussehen, wenn Sie mit dem gesamten Prozess fertig sind.
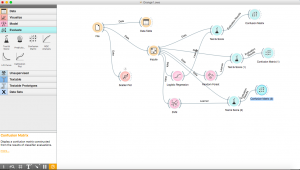
Für Leute, die in Gruppen arbeiten möchten, Sie können auch Ihre Workflows exportieren und an Freunde senden, die mit Ihnen zusammenarbeiten können.
Die resultierende Datei hat die Erweiterung (.ows) und kann in jeder anderen Orange Konfiguration geöffnet werden.
Abschließende Anmerkungen
Orange ist eine Plattform, die für fast jede Art von Analyse verwendet werden kann, aber das wichtigste, für schöne und einfache Bilder. In diesem Artikel, Wir untersuchen, wie man einen Datensatz visualisiert. Ein Vorhersagemodell wurde ebenfalls durchgeführt, Verwendung eines logistischen Regressionsprädiktors, SVM und ein Random Forest-Prädiktor, um den Kreditstatus für jede Person entsprechend zu finden.
Ich hoffe, dieses Tutorial hat Ihnen geholfen, Aspekte des Problems zu entdecken, die Sie möglicherweise nicht verstanden haben oder die Sie zuvor nicht verstanden haben. Es ist sehr wichtig, die Data-Science-Pipeline und die Schritte zu verstehen, die wir zum Trainieren eines Modells unternehmen, Und das sollte Ihnen sicherlich helfen, bald bessere Vorhersagemodelle zu erstellen!!





