Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Verstehen Sie das Problem der Überanpassung in Entscheidungsbäumen und lösen Sie es, indem Sie Komplexität und minimale Kosten mit Scikit-Learn in Python reduzieren
Decision Tree ist eines der intuitivsten und effektivsten Tools im Toolkit eines Data Scientists.. Es hat eine invertierte Baumstruktur, die früher nur in der Entscheidungsanalyse verwendet wurde, aber jetzt ist es auch ein brillanter Algorithmus für maschinelles Lernen, besonders wenn wir ein Sortierproblem haben.
Diese Entscheidungsbäume sind für ihre Fähigkeit bekannt, Muster in den Daten zu erfassen.. Aber, Übermaß an allem ist schädlich, Wahrheit? Entscheidungsbäume sind berüchtigt, da sie sich zu sehr an die Daten klammern können, mit denen sie trainiert werden.
Deswegen, unser Baum liefert schlechte Implementierungsergebnisse, weil er mit einem neuen Satz von Werten nicht umgehen kann.
Aber keine Sorge! Wie ein gelernter Mechaniker hat er Schraubenschlüssel aller Größen in seinem Werkzeugkasten vorrätig, ein erfahrener Datenwissenschaftler hat auch seine Techniken, um mit jeder Art von Problem umzugehen. Und das werden wir in diesem Artikel untersuchen..
Die Rolle des Beschneidens in Entscheidungsbäumen
Das Beschneiden ist eine der Techniken, die verwendet werden, um unser Überanpassungsproblem zu überwinden. Beschneidung, im wahrsten Sinne des Wortes, ist eine Praxis, bei der bestimmte Teile eines Baumes selektiv entfernt werden (die Pflanze), wie Zweige, Triebe oder Wurzeln, zur Verbesserung der Baumstruktur und zur Förderung eines gesunden Wachstums. Genau das macht das Beschneiden auch mit unseren Entscheidungsbäumen. Es macht es vielseitig, so dass es sich anpassen kann, wenn wir ihm neue Informationen geben, damit das Problem der Überanpassung gelöst.
Reduzieren Sie die Größe eines Entscheidungsbaums, lo que puede aumentar ligeramente el error de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen...., aber den Testfehler drastisch verringern, was macht es anpassungsfähiger.
Beschneidung mit minimalen Kosten und Komplexität ist eine der Arten des Beschneidens von Entscheidungsbäumen.
Dieser Algorithmus ist parametrisiert durch α (≥0) bekannt als Komplexitätsparameter.
Der Komplexitätsparameter wird verwendet, um das Kosten-Komplexitäts-Maß zu definieren, Rein(T) eines gegebenen Baumes T: Rein(T) = R (T) + ein | T |
wo | T | ist die Anzahl der Endknoten in T und R (T) wird traditionell als die Gesamtfehlklassifizierungsrate der Endknoten definiert.
In seiner Version 0.22, Scikit-learn hat diesen Parameter namens ccp_alpha eingeführt (Jawohl! Es ist kurz für Beschneidung der Kostenkomplexität – Alfa) zu Entscheidungsbäumen, mit denen das gleiche getan werden kann.
Aufbau des Entscheidungsbaums in Python
Wir werden den Iris-Datensatz verwenden, um den Entscheidungsbaum anzupassen. Sie können den Datensatz herunterladen hier.
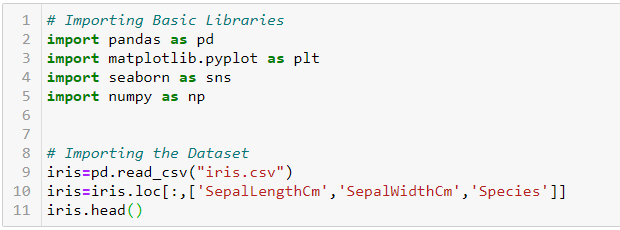
Zuerst, Lassen Sie uns die erforderlichen Basisbibliotheken und den Datensatz importieren:
Der Datensatz sieht so aus:
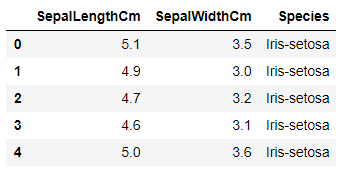
Unser Ziel ist es, die Art einer Blüte anhand der Länge und Breite ihrer Kelchblätter vorherzusagen.
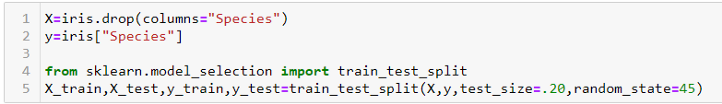
Wir werden den Datensatz in zwei Teile aufteilen: trainieren und testen. Wir tun dies, damit wir sehen können, wie unser Modell auch bei unsichtbaren Daten funktioniert. Wir werden die verwenden train_test_split Die Funktion von sklearn.model_selection den Datensatz teilen.
Jetzt, lasst uns einen Entscheidungsbaum an den Teil des Zuges anpassen und sowohl im Test als auch im Training vorhersagen. wir werden verwenden DecisionTreeClassifier von sklearn.baum für diesen Zweck.
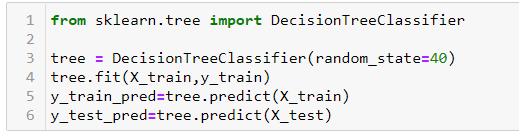
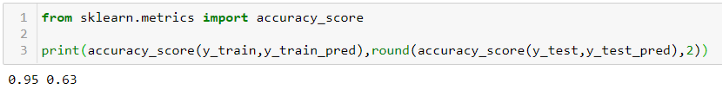
Standardmäßig, Die Entscheidungsbaumfunktion führt keine Beschneidung durch und lässt den Baum so weit wachsen, wie er kann. Wir erhalten eine Genauigkeit von 0,95 Ja 0,63 im Zug und auf dem Prüfling, beziehungsweise, wie im Folgenden gezeigt. Wir können sagen, dass unser Modell überangepasst ist, nämlich, den Teil des Zuges auswendig lernen, aber es kann im Testteil nicht so gut funktionieren.
Entscheidungsbaum in sklearn hat es eine Funktion namens cost_complexity_pruning_path, was die effektiven Alphas der Teilbäume beim Beschneiden und auch die entsprechenden Verunreinigungen ergibt. Mit anderen Worten, wir können diese Alpha-Werte verwenden, um unseren Entscheidungsbaum zu beschneiden:
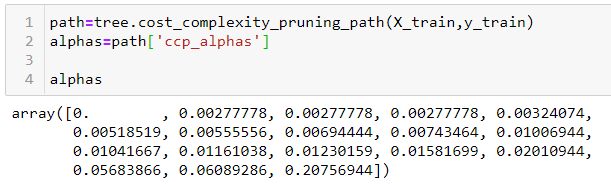
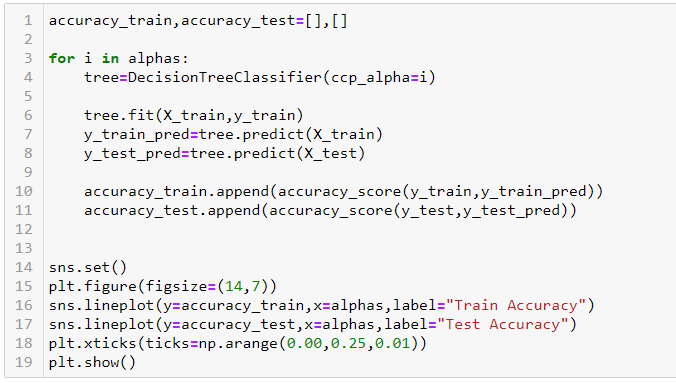
Wir werden diese Alpha-Werte setzen und an weitergeben ccp_alpha Parameter unserer DecisionTreeClassifier. Schleife drüber alfas Hauptquartier, Wir finden die Präzision in den Trainings- und Testteilen unseres Datensatzes.
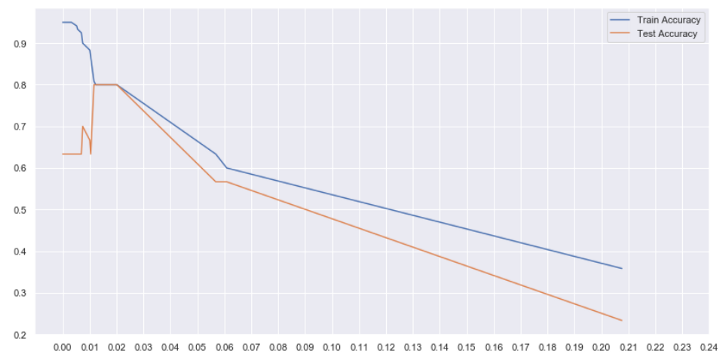
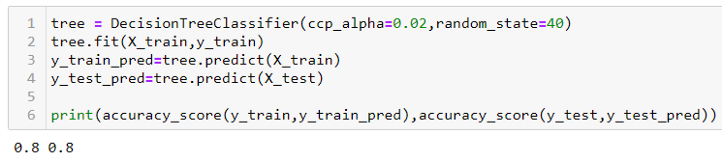
In der Grafik oben, wir sehen, dass zwischen alpha = 0.01 Ja 0.02, wir erreichen höchste Prüfpräzision. Obwohl die Genauigkeit unseres Zuges auf gesunken ist 0,8, unser Modell ist jetzt generalisierter und funktioniert besser mit unsichtbaren Daten.