
Überblick
- Einführung
- Ausführungszeit verkürzen
- Datensatz
- Datensatz lesen
- Verwaltung kategorialer Variablen
- abhängiges und unabhängiges Merkmal
- AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... de modelos con núcleos de CPU
- Schlussbemerkung
Einführung
„Das 65.536 Prozessoren befanden sich in der Verbindungsmaschine“
~ Philip Emeagwali
Wir alle haben einen Hintergrund in Informatik, Wir benutzen täglich einen Computer und verstehen besser, was der Computer ist. Computer haben Herzen wie Menschen, es heißt CPU.
Wir alle kennen die CPU, Wenn dies nicht der Fall ist, das UPC ist die zentrale Recheneinheit im Computer, oder ist es eine elektronische Schaltung, die die verschiedenen Anweisungen ausführt, die ein Computerprogramm umfassen. Die CPU führt Grundrechenarten durch, Logik, etc.
Frühere CPU-Generationen wurden als diskrete Komponenten und zahlreiche kleine ICs auf einer oder mehreren Leiterplatten implementiert. Im Laufe der Zeit, CPUs werden getauscht, Sind aktualisiert. Sie sind in einem integrierten Schaltkreis implementiert, mit einer oder mehreren CPUs auf einem einzigen IC-Chip. Es gibt viele Funktionen oder Vorgänge, die der Computer ausführt, also dauert es lange, dafür entwarf der Wissenschaftler die Mehrkernprozessoren, es war eine Kombination von Mikroprozessorchips mit mehreren CPUs.
Mehrkernprozessoren sind sehr schnell, kann mal arbeiten. Als Datenwissenschaftler, Wir haben festgestellt, dass einige der Python-Bibliotheken sehr langsam und auch lang sind, Programmausführung verlangsamen, se necesita mucho tiempo para la ejecución de nuestros modelos de aprendizaje automático o tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit.... Wenn Sie sehen möchten, wie viele Kerne sich in Ihrem Computer befinden, öffne einfach dein GremiumEin Panel ist eine Gruppe von Experten, die sich trifft, um ein bestimmtes Thema zu diskutieren und zu analysieren. Diese Foren sind bei Konferenzen üblich, Seminare und öffentliche Debatten, wo die Teilnehmer ihr Wissen und ihre Perspektiven teilen. Panels können eine Vielzahl von Bereichen abdecken, Von der Wissenschaft bis zur Politik, Ziel ist es, den Gedankenaustausch und die kritische Reflexion unter den Teilnehmern zu fördern.... Steuerung und suchen System Sie sehen alle Informationen zu Ihrem Computer.
Wenn wir über die Python-Panda-Bibliothek sprechen, die beim maschinellen Lernen zur Datenmanipulation und Datenanalyse verwendet wird, Wenn wir eine kleine Datenmenge analysieren, dauert es nicht so lange, die Operationen durchzuführen, aber was ist, wenn unser Datensatz groß ist?? ohne es zu wissen, Es wird lange dauern, Berechnungen mit einer großen Datenmenge durchzuführen. Dann, Das ist ein großes Problem, mit denen alle Datenwissenschaftler in ihrer Karriere konfrontiert sind. Was ist, wenn wir diese Zeit verkürzen? es ist gut für uns?
wir werden unten diskutieren:
Reduzieren Sie die Ausführungszeit
Oben haben wir eine kurze Diskussion über die CPU, dann, was bedeutet es? Significa que usamos núcleos de la unidad central de procesamiento para entrenar nuestro modelo de aprendizaje automático. Hay uno de los ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... especiales dentro del algoritmo de aprendizaje automático que normalmente lo usamos, aber wir haben kein Wissen darüber oder nicht. Ich kenne die genaue Bedeutung davon, Das hört sich toll an!
Diese CPU-Kerne sind sehr wichtige Bestandteile des Trainings jedes Modells für maschinelles Lernen., das ist auch wichtig bei der Arbeit mit Deep Learning, weil diese CPU-Kerne eine parallele Programmierung oder parallele Ausführung des Programms möglich sein werden. Wir können Machine-Learning-Modelle nicht mit Hilfe von GPUs trainieren, Daher, CPUs sind in diesem Zustand nützlicher.
Für ein schnelleres Machine-Learning-Training in jedem Machine-Learning-Projekt, Sie können diese CPU-Kerne verwenden, solange Sie eine große Datenmenge im Dataset haben, um das Modell für maschinelles Lernen zu trainieren.
Jetzt, Wir sehen, wie wir das Machine-Learning-Modell mit CPU-Kernen trainieren, um die Leistung gegenüber dem Machine-Learning-Modell zu verbessern:
Datensatz
Um diese spezielle Problemstellung zu trainieren, wir müssen die nehmen Wein_Qualität Datensatz, der Referenzlink für diesen Datensatz ist hier.
Um diesen Datensatz besser zu verstehen, Sie können diesen Link überprüfen: Klicke hier
Denken Sie daran, wenn Sie dieses spezielle Problem mit CPU-Kernen lösen müssen, Sie müssen also einen einfachen Datensatz mit einer großen Datenmenge haben.
Der Grund für die Verwendung dieses Datensatzes ist, dass es sich um einen einfachen Datensatz mit einer großen Datenmenge handelt, die in diesem Datensatz vorhanden ist..
Mal sehen, wie groß diese Daten sind:
Datensatz lesen
Zuerst, Wir müssen den Weinqualitätsdatensatz mit Pandas lesen.
#Pandas importieren
df = pd.read_csv('wine_quality.csv')
df.kopf()

df.shape()

Nach dem Ausführen dieses Codes, kannst du sehen, dass wir 6497 Reihen Ja 13 Säulen im Weinqualitätsdatensatz.
Jetzt, Wir überprüfen die einzigartigen Kategorien, die in a . vorhanden sind Qualität VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern....,
unique_points= df['qualität'].einzigartig()
unique_points

Wie wir sehen, Es gibt 6, 5, 7, 8, 4, 3, 9 eindeutige Datenpunkte in der Qualitätsvariablen, wobei diese Datenpunkte die Weinqualitätsmaße sind.
Händels kategoriale Variablen
# kategoriale vars
next_df = pd.get_dummies(new_df,drop_first=Wahr)
# neuen Datenrahmen anzeigen
next_df

Abhängiges und unabhängiges Merkmal
So wenden Sie das Modell für maschinelles Lernen an, wir müssen die abhängigen und unabhängigen Merkmale aufteilen:
# unabhängige Funktionen
x= next_df.drop(['qualität','best quality'],Achse=1)
# abhängige Funktion
y= next_df['best quality']
Modelltraining mit CPU-Kernen
Kommt jetzt zur Ausführung, Wir tun es, indem wir einige Schritte anwenden:
Paso 1: Verwenden des maschinellen Lernalgorithmus RandomForestClassifier.
Paso 2: Verwenden von RepeatedStratifiedKFold für die Kreuzvalidierung.
Paso 3: Trainieren Sie das Modell mit dem Kreuzvalidierungs-Score.
Wenn wir all diese Dinge initialisieren, Die Zeit wird basierend auf dieser Kreuzvalidierungspunktzahl berechnet. Vor der Zeitkontrolle importieren wir die benötigten Module:
Modulimport:
ab Zeit Importzeit
# Importieren von RepeatedStratifiedKFold
from sklearn.model_selection import RepeatedStratifiedKFold
aus sklearn.ensemble importieren RandomForestClassifier
aus sklearn.model_selection import cross_val_score
# RandomForestClassifier importieren
Jetzt, Wir überprüfen die Zeit mit den verschiedenen CPU-Kernen:
Hier verwenden wir den maschinellen Lernalgorithmus RandomForestClassifie, wenn Sie die Parameter von RandomForestClassifier überprüfen, du findest, dass es ein gibt n_jobs Parameter.

n_jobs Es ist der Parameter, der Ihnen wirklich hilft, im Grunde zuzuweisen, wie viele Kerne ein bestimmtes Systemtraining benötigen sollte.
Zum Beispiel, wenn wir nehmen wollen n_jobs = 1 dann dauert 1 CPU-Kern, ja nimm 2, es wird dauern 2 CPU-Kerne, usw. Wenn Sie alle CPU-Kerne zum Training verwenden möchten und nicht wissen, wie viele Kerne sich im System befinden, benutz einfach n_jobs = -1.
1 CPU-Kerne:
## CPU-Kerne verwenden wir n_jobs
random = RandomForestClassifier(n_Schätzer = 100)
# Erstellen eines Objekts von RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits=5, n_wiederholungen=3, random_state=4)
# Beginn der Ausführungszeit
start_time=time()
n_scores =cross_val_score(willkürlich,x,Ja,scoring='accuracy', Lebenslauf = Lebenslauf, n_jobs=1)
# Endzeit der Ausführung
end_time=time()
final_time = end_time-start_time
# Ausführungszeit anzeigen
drucken('final execution time is : {}'.format(das letzte Mal))

Hier sehen wir das mit 1 Kern werden benötigt um 10 Sekunden zu laufen, und das ist eine riesige zeit.
Wir schreiben nicht die n_jobs innerhalb des RandomForestClassifier schreiben wir ihn stattdessen in den cross_val_score weil es uns hilft, eine Kreuzvalidierung mit RepeatedStratifiedKFold durchzuführen
Jetzt, Wir verwenden denselben Code mit einer kleinen Änderung für mehr Kerne:
2 CPU-Kerne:
## CPU-Kerne verwenden wir n_jobs
random = RandomForestClassifier(n_Schätzer = 100)
# Erstellen eines Objekts von RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits=5, n_wiederholungen=3, random_state=4)
# Beginn der Ausführungszeit
start_time=time()
n_scores =cross_val_score(willkürlich,x,Ja,scoring='accuracy', Lebenslauf = Lebenslauf, n_jobs=2) # 2 Kerne
# Endzeit der Ausführung
end_time=time()
final_time = end_time-start_time
# Ausführungszeit anzeigen
drucken('final execution time is : {}'.format(das letzte Mal))

Jawohl, Hier können Sie sehen, was der Unterschied ist? 1 Kern und 2 Kerne, Ausführungszeit unterscheidet sich stark von 1 Ader.
3 CPU-Kerne:
## CPU-Kerne verwenden wir n_jobs
random = RandomForestClassifier(n_Schätzer = 100)
# Erstellen eines Objekts von RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits=5, n_wiederholungen=3, random_state=4)
# Beginn der Ausführungszeit
start_time=time()
n_scores =cross_val_score(willkürlich,x,Ja,scoring='accuracy', Lebenslauf = Lebenslauf, n_jobs=3)   # 3 Kerne
# Endzeit der Ausführung
end_time=time()
final_time = end_time-start_time
# Ausführungszeit anzeigen
drucken('final execution time is : {}'.format(das letzte Mal))

Nimm alle Kerne:
## CPU-Kerne verwenden wir n_jobs
random = RandomForestClassifier(n_Schätzer = 100)
# Erstellen eines Objekts von RepeatedStratifiedKFold
cv = RepeatedStratifiedKFold(n_splits=5, n_wiederholungen=3, random_state=4)
# Beginn der Ausführungszeit
start_time=time()
n_scores =cross_val_score(willkürlich,x,Ja,scoring='accuracy', Lebenslauf = Lebenslauf, n_jobs= -1) # alle Kerne
# Endzeit der Ausführung
end_time=time()
final_time = end_time-start_time
# Ausführungszeit anzeigen
drucken('final execution time is : {}'.format(das letzte Mal))

Core-Timing-Vergleich:
## CPU-Kerne verwenden wir n_jobs
für Kern in [1,2,3,4,5,6,7,8,9,10]:
    random = RandomForestClassifier(n_Schätzer = 100)
    # Erstellen eines Objekts von RepeatedStratifiedKFold
    cv = RepeatedStratifiedKFold(n_splits=5, n_wiederholungen=3, random_state=4)
    # Beginn der Ausführungszeit
    start_time=time()
    n_scores =cross_val_score(willkürlich,x,Ja,scoring='accuracy', Lebenslauf = Lebenslauf, n_jobs = Kern)
    # Endzeit der Ausführung
    end_time=time()
    final_time = end_time-start_time
    # Ausführungszeit anzeigen
    drucken('final execution time of core {} ist : {}'.format(Ader,das letzte Mal))
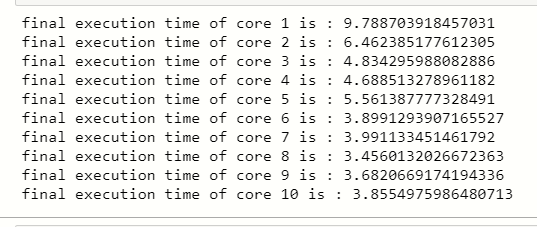
Sie können sehen, dass es einen großen Unterschied gibt, wenn wir verwenden 1 Kern, um unser ML-Modell zu trainieren und 10 Kerne zum Trainieren des ML-Modells.
Abschließende Anmerkungen
Hallo, In diesem Artikel haben Sie das Training von ML-Modellen mit CPU-Kernen kennengelernt, Jetzt ist es an der Zeit, diese Technik in Ihrem Machine-Learning-Modell zu implementieren, um die Ausführungszeit zu verkürzen.
Ich hoffe, Sie genießen diesen Artikel., Teile es mit deinen Freunden.
Sie können sich mit mir auf LinkedIn verbinden: www.linkedin.com/in/mayur-badole-189221199
Schauen Sie sich meine anderen Artikel an: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Vielen Dank.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





