
Für jede Einstellung, Unternehmen schalten Online-Anzeigen, Referenzen und überprüfen Sie sie manuell.
Unternehmen senden normalerweise Tausende von Lebensläufen für jede Veröffentlichung.
Wenn Unternehmen Lebensläufe über Online-Anzeigen sammeln, klassifizieren Sie sie nach Ihren Anforderungen.
Nach dem Sammeln von Lebensläufen, Unternehmen schließen Anzeigen und Online-Bewerbungsportale.
Später, senden Sie die gesammelten Lebensläufe an das Recruiting-Team.
Für die einstellenden Teams wird es sehr schwierig, den Lebenslauf zu lesen und den Lebenslauf basierend auf den Anforderungen auszuwählen, kein Problem, wenn es ein oder zwei Lebensläufe gibt, aber es ist sehr schwierig, die Lebensläufe von zu überprüfen 1000 und wähle das Beste aus.
Um dieses Problem zu lösen, Heute werden wir in diesem Artikel den Lehrplan mit maschinellem Lernen mit Python lesen und überprüfen, damit wir Arbeitstage in wenigen Minuten erledigen können.
2. Was ist eine Lebenslaufbewertung??
Die Auswahl der richtigen Leute für den Job ist die größte Verantwortung aller Unternehmen, da die Auswahl der richtigen Personengruppe das Geschäftswachstum exponentiell beschleunigen kann.
Wir werden hier ein Beispiel für ein Unternehmen dieser Art analysieren, was wir als IT-Abteilung kennen. Wir wissen, dass die IT-Abteilung mit den wachsenden Märkten nicht Schritt hält.
Aufgrund vieler Großprojekte mit großen Unternehmen, Ihr Team hat keine Zeit, Lebensläufe zu lesen und den besten Lebenslauf basierend auf Ihren Anforderungen auszuwählen.
Um diese Art von Problemen zu lösen, das Unternehmen wählt immer einen Dritten aus, dessen Aufgabe es ist, den Lebenslauf gemäß den Anforderungen zu erstellen. Diese Unternehmen sind als Hiring Service Organization bekannt. Dies ist der Bildschirm mit der Informationszusammenfassung.
Die Aufgabe, die besten Talente auszuwählen, Zuordnungen, Online-Codierungswettbewerbe, unter vielen anderen, auch bekannt als Lebenslauf-Bildschirm.
Zeitmangel, große Unternehmen haben nicht genug Zeit, um Lebensläufe zu öffnen, Sie müssen also auf die Hilfe anderer Unternehmen zurückgreifen. Also müssen sie Geld bezahlen. Was ein sehr ernstes Problem ist.
Um dieses Problem zu lösen, das Unternehmen möchte die Bildschirmarbeit des Lebenslaufs mithilfe eines maschinellen Lernalgorithmus selbstständig starten.
3. Wiederaufnahme des Screenings mit maschinellem Lernen
In diesem Abschnitt, Wir werden die schrittweise Implementierung des Resume-Screenings mit Python sehen.
3.1 Verwendete Daten
Wir haben öffentlich zugängliche Daten von Kaggle. Unter folgendem Link können Sie die Daten herunterladen.
https://www.kaggle.com/gauravduttakiit/resume-dataset
3.2 Explorative Datenanalyse
Werfen wir einen kurzen Blick auf die Daten, die wir haben.
fortsetzenDataSet.head()
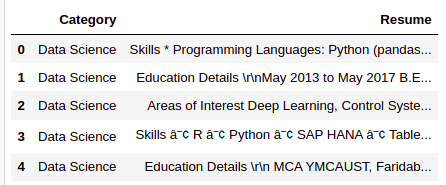
Es gibt nur zwei Spalten, die wir in den Daten haben. Unten ist die Definition jeder Spalte.
Kategorie: Art der Arbeit, für die der Lebenslauf angepasst ist.
Lebenslauf: Bewerber-Lebenslauf
fortsetzenDataSet.shape
Produktion:
(962, 2)
Es gibt 962 Beobachtungen, die wir in den Daten haben. Jede Beobachtung repräsentiert die vollständigen Details jedes Kandidaten, für das, was wir haben 962 Lebensläufe zur Auswahl.
Mal sehen, welche verschiedenen Kategorien wir in den Daten haben.
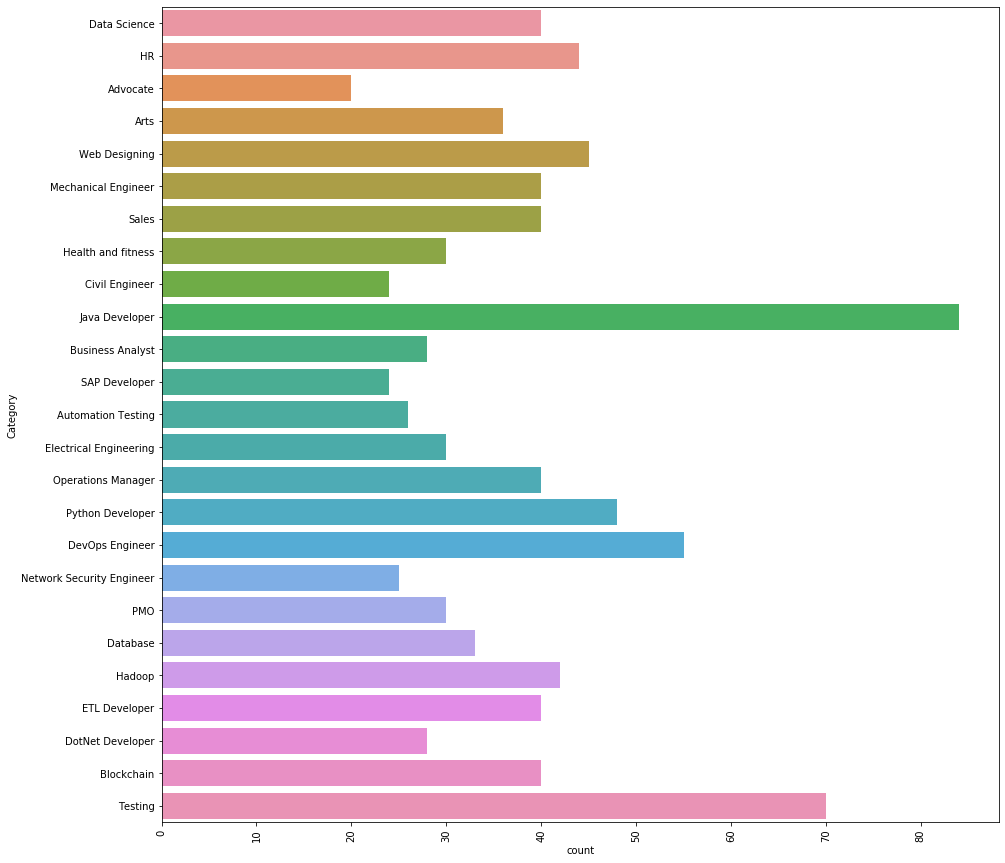
Es gibt 25 verschiedene Kategorien, die wir in den Daten haben. Das 3 Die wichtigsten Jobkategorien, die wir in den Daten haben, sind wie folgt.
Java Entwickler, Testen und DevOps-Ingenieur.
Statt Anzahl oder Häufigkeit, Wir können auch die prozentuale Verteilung der Arbeitskategorien wie unten gezeigt visualisieren:
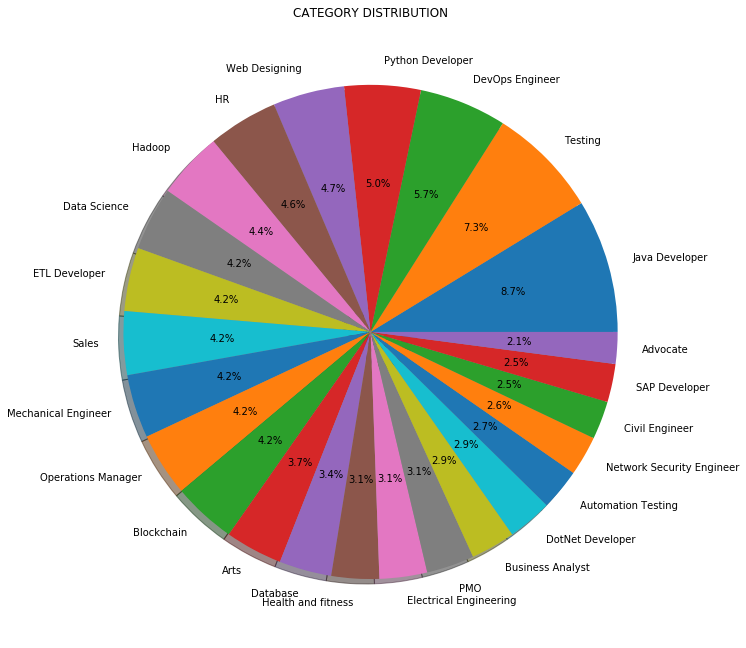
3.3 Datenvorverarbeitung
Paso 1: Limpiar la columna ‚Lebenslauf‘
In diesem Schritt, Wir entfernen alle unnötigen Informationen aus Lebensläufen wie URL, Hashtags und Sonderzeichen.
def cleanResume(LebenslaufText):
    LebenslaufText = re.sub('httpS+s*', 'Review', LebenslaufText)  # remove URLs
    resumeText = re.sub('RT|cc', 'Review', LebenslaufText)  # remove RT and cc
    resumeText = re.sub('#S+', '', LebenslaufText)  # remove hashtags
    resumeText = re.sub('@S+', ' ', LebenslaufText)  # remove mentions
    resumeText = re.sub('[%S]' % wieder entkommen("""!"#$%&'()*+,-./:;<=>[E-Mail geschützt][]^_`{|}~"""), 'Review', LebenslaufText)  # remove punctuations
    resumeText = re.sub(r'[^x00-x7f]',r' ', LebenslaufText)
    LebenslaufText = re.sub('s+', 'Review', LebenslaufText)  # remove extra whitespace
    return resumeText
resumeDataSet['cleaned_resume'] = resumeDataSet.resume.apply(Lambda x: cleanResume(x))
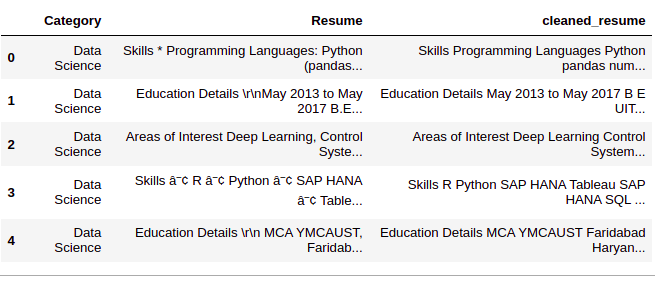
Paso 2: codificación de ‚Kategorie‘
Jetzt, codificaremos la columna ‚Kategorie‘ Verwenden von LabelEncoding. Aunque la columna ‚Kategorie‘ sind Daten ‚Nominales‘, estamos usando LabelEncong porque la columna ‚Kategorie‘ es nuestra columna ‚Zielsetzung‘. Al realizar LabelEncoding, Jede Kategorie wird zu einer Klasse und wir erstellen ein Klassifizierungsmodell mit mehreren Klassen.
var_mod = ['Kategorie']
le = LabelEncoder()
für ich in var_mod:
    LebenslaufDataSet[ich] = le.fit_transform(LebenslaufDataSet[ich])
Paso 3: preprocesamiento de la columna ‚clean_resume‘
Aquí preprocesaremos y convertiremos la columna ‚clean_resume‘ in Vektoren. Es gibt viele Möglichkeiten, es zu tun, Was ‚Beutel voller Worte‘, ‚Tf-Idf‘, ‚Word2Vec‘ und eine Kombination dieser Methoden.
Usaremos el método ‚Tf-Idf‘ Gehen Sie folgendermaßen vor, um die Vektoren in diesem Ansatz abzurufen.
requiredText = resumeDataSet['cleaned_resume'].values
requiredTarget = resumeDataSet['Kategorie'].values
word_vectorizer = TfidfVectorizer(
    sublinear_tf=Wahr,
    stop_words="Español",
    max_features=1500)
word_vectorizer.fit(erforderlichText)
WordFeatures = word_vectorizer.transform(erforderlichText)
Verfügen über ‚Wortfunktionen‘ como vectores y ‚erforderlichZiel‘ y target después de este paso.
3.4 Modellbau
Usaremos el método ‚One vs Rest‘ mit ‚KNeighborsClassifier‘ um dieses Mehrklassen-Klassifizierungsmodell zu erstellen.
wir werden verwenden 80% de datos para AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... Ja 20% Daten zur Validierung. Teilen wir die Daten jetzt in Trainings- und Test-Set auf.
X_Zug,X_test,y_train,y_test = train_test_split(Wortfunktionen,erforderlichZiel,random_state=0, test_size=0.2)
drucken(X_train.shape)
drucken(X_test.shape)
Produktion:
(769, 1500)
(193, 1500)
Da wir jetzt Test- und Trainingsdaten haben, lass uns das modell bauen.
clf = OneVsRestClassifier(KNeighborsClassifier())
clf.fit(X_Zug, y_train)
Vorhersage = clf.predict(X_test)
3.5 Ergebnisse
Schauen wir uns die Ergebnisse an, die wir haben.
drucken('Genauigkeit des KNeighbors-Klassifikators auf dem Trainingsset: {:.2F}'.format(clf.score(X_Zug, y_train)))
drucken('Genauigkeit des KNeighbors-Klassifizierers auf dem Testset: {:.2F}'.format(clf.score(X_test, y_test)))
Produktion:
Genauigkeit des KNeighbors-Klassifikators im Trainingsset: 0.99
Genauigkeit des KNeighbors-Klassifikators am Testset: 0.99
Wir können sehen, dass die Ergebnisse erstaunlich sind. Wir können jede Kategorie eines gegebenen Lebenslaufs mit a klassifizieren 99% Präzision.
Wir können auch den detaillierten Klassifizierungsbericht für jede Klasse oder Kategorie überprüfen.
drucken(metrics.classification_report(y_test, Vorhersage))
Produktion:
              Unterstützung für Präzisionsrückruf f1-Score

           0       1.00      1.00      1.00         3
           1       1.00      1.00      1.00         3
           2       1.00      0.80      0.89         5
           3       1.00      1.00      1.00         9
           4       1.00      1.00      1.00         6
           5       0.83      1.00      0.91         5
           6       1.00      1.00      1.00         9
           7       1.00      1.00      1.00         7
           8       1.00      0.91      0.95        11
           9       1.00      1.00      1.00         9
          10       1.00      1.00      1.00         8
          11       0.90      1.00      0.95         9
          12       1.00      1.00      1.00         5
          13       1.00      1.00      1.00         9
          14       1.00      1.00      1.00         7
          15       1.00      1.00      1.00        19
          16       1.00      1.00      1.00         3
          17       1.00      1.00      1.00         4
          18       1.00      1.00      1.00         5
          19       1.00      1.00      1.00         6
          20       1.00      1.00      1.00        11
          21       1.00      1.00      1.00         4
          22       1.00      1.00      1.00        13
          23       1.00      1.00      1.00        15
          24       1.00      1.00      1.00         8

    Richtigkeit                           0.99       193
   Makrodurchschnitt       0.99      0.99      0.99       193
gewichteter Durchschnitt       0.99      0.99      0.99       193
Wo, 0, 1, 2…. sind die Jobkategorien. Die tatsächlichen Tags erhalten wir von dem von uns verwendeten Tag-Encoder.
die Klassen_
Produktion:
['Advocate', 'Arts', 'Automatisierungstests', 'Blockchain','Business Analyst', 'Bauingenieur', 'Data Science', 'Datenbank',DevOps Engineer', 'DotNet Developer', 'ETL Developer','Elektrotechnik', 'HR', 'Hadoop', 'Gesundheit und Fitness','Java Developer', 'Maschinenbauingenieur','Netzwerksicherheitsingenieur', 'Betriebsleiter, 'PMO','Python Developer', 'SAP-Entwickler', 'Verkäufe', 'Testing','Webdesigning']
Hier ‚Abogado‘ es la clase 0, ‚Artes‘ es la clase 1, usw …
4. Code
Aquí puedes ver la implementación completa....
#Loading Libraries
import warnings
warnings.filterwarnings('ignorieren')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from matplotlib.gridspec import GridSpec
import re
from sklearn.preprocessing import LabelEncoder
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from scipy.sparse import hstack
from sklearn.multiclass import OneVsRestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn import metrics
#Loading Data
resumeDataSet = pd.read_csv('.. /input/ResumeScreeningDataSet.csv' ,coding='utf-8')
#EDA
plt.figure(Feigengröße=(15,15))
plt.xticks(Drehung=90)
sns.countplot(y ="Kategorie", data=resumeDataSet)
plt.savefig('.. /output/jobcategory_details.png')
#Pie-chart
targetCounts = resumeDataSet['Kategorie'].value_counts().reset_index()['Kategorie']
targetLabels = resumeDataSet['Kategorie'].value_counts().reset_index()['index']
# Make square figures and axes
plt.figure(1, Feigengröße=(25,25))
the_grid = GridSpec(2, 2)
plt.subplot(the_grid[0, 1], Aspekt=1, Titel="KATEGORIE-VERTEILUNG")
source_pie = plt.pie(targetCounts, labels=targetLabels, autopct="%1.1F%%", Schatten=Wahr, )
plt.savefig('.. /output/category_dist.png')
#Data Preprocessing
def cleanResume(LebenslaufText):
    LebenslaufText = re.sub('httpS+s*', 'Review', LebenslaufText)  # remove URLs
    resumeText = re.sub('RT|cc', 'Review', LebenslaufText)  # remove RT and cc
    resumeText = re.sub('#S+', '', LebenslaufText)  # remove hashtags
    resumeText = re.sub('@S+', ' ', LebenslaufText)  # remove mentions
    resumeText = re.sub('[%S]' % wieder entkommen("""!"#$%&'()*+,-./:;<=>[E-Mail geschützt][]^_`{|}~"""), 'Review', LebenslaufText)  # remove punctuations
    resumeText = re.sub(r'[^x00-x7f]',r' ', LebenslaufText)
    LebenslaufText = re.sub('s+', 'Review', LebenslaufText)  # remove extra whitespace
    return resumeText
resumeDataSet['cleaned_resume'] = resumeDataSet.resume.apply(Lambda x: cleanResume(x))
var_mod = ['Kategorie']
le = LabelEncoder()
für ich in var_mod:
    LebenslaufDataSet[ich] = le.fit_transform(LebenslaufDataSet[ich])
requiredText = resumeDataSet['cleaned_resume'].values
requiredTarget = resumeDataSet['Kategorie'].values
word_vectorizer = TfidfVectorizer(
    sublinear_tf=Wahr,
    stop_words="Español",
    max_features=1500)
word_vectorizer.fit(erforderlichText)
WordFeatures = word_vectorizer.transform(erforderlichText)
#Model Building
X_train,X_test,y_train,y_test = train_test_split(Wortfunktionen,erforderlichZiel,random_state=0, test_size=0.2)
drucken(X_train.shape)
drucken(X_test.shape)
clf = OneVsRestClassifier(KNeighborsClassifier())
clf.fit(X_Zug, y_train)
Vorhersage = clf.predict(X_test)
#Results
print('Genauigkeit des KNeighbors-Klassifikators auf dem Trainingsset: {:.2F}'.format(clf.score(X_Zug, y_train)))
drucken('Genauigkeit des KNeighbors-Klassifizierers auf dem Testset: {:.2F}'.format(clf.score(X_test, y_test)))
drucken("n Klassifizierungsbericht für Klassifikator %s:n%sn" % (clf, metrics.classification_report(y_test, Vorhersage)))
5. Fazit
In diesem Artikel, Am Beispiel der CV-Erkennung haben wir gelernt, wie maschinelles Lernen und die Verarbeitung natürlicher Sprache angewendet werden können, um unser tägliches Leben zu verbessern. Wir haben gerade fast sortiert 1000 wird in wenigen Minuten in ihren jeweiligen Kategorien mit a . fortgesetzt 99% Präzision.
Bei Fragen einfach im Kommentarbereich melden.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





