
Überblick
- Erfahren Sie mehr über das innovative Modell von Transformers.
- Bitte haben Sie Verständnis dafür, wie wir Transformer in das Bildunterschriftsproblem implementieren können, das Sie bereits mit Tensorflow gesehen haben
- Vergleich der Ergebnisse von Transformers vs. Aufmerksamkeitsmodellen.
Einführung
Wir haben gesehen, dass die Mechanismen der Aufmerksamkeit (im vorherigen Artikel) sind fester Bestandteil überzeugender Sequenzmodellierungen und Transduktionsmodelle in verschiedenen Aufgabenstellungen (als Bildunterschrift), ermöglicht die Modellierung von Abhängigkeiten unabhängig von ihrem Abstand in den Eingabe- oder Ausgabesequenzen.
Der Transformator, eine Modellarchitektur, die Wiederholungen vermeidet und, jedoch, beruht vollständig auf einem Sorgfaltsmechanismus, um globale Abhängigkeiten zwischen Input und Output herzustellen. Die Transformer-Architektur ermöglicht eine deutlich höhere Parallelisierung und kann neue, topaktuelle Ergebnisse bei der Übersetzungsqualität erzielen.
In diesem Artikel, mal sehen wie das geht Implementieren Sie den Aufmerksamkeitsmechanismus zum Generieren von Untertiteln mit Transformers mit TensorFlow.
Voraussetzungen vor dem Start: –
Ich empfehle Ihnen, diesen Artikel zu lesen, bevor Sie beginnen:
Inhaltsverzeichnis
- Transformatorarchitektur
- Implementierung des Aufmerksamkeitsmechanismus zur Generierung von Untertiteln mit Transformers mit Tensorflow
- Importieren Sie erforderliche Bibliotheken
- Datenladen und Vorverarbeitung
- Modelldefinition
- Positionscodierung
- Mehrkopfpflege
- Encoder-Decoder-Schicht
- Transformator
- Modell-Hyperparameter
- AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... von Modellen
- BLEU-Bewertung
- Vergleich
- Was kommt als nächstes?
- Abschließende Anmerkungen
Transformatorarchitektur
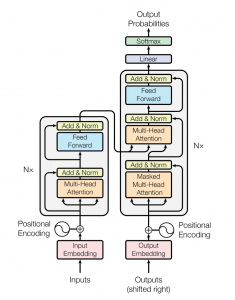
Das Transformatornetzwerk verwendet eine Encoder-Decoder-Architektur ähnlich der eines RNN. Der Hauptunterschied besteht darin, dass die Transformatoren das Gebet empfangen können / parallele Eingangssequenz, nämlich, der Eingabe ist kein Zeitschritt zugeordnet und alle Wörter im Satz können gleichzeitig übergeben werden.
Beginnen wir damit, den Eingang des Transformators zu verstehen.
Ziehen Sie eine Übersetzung aus dem Englischen ins Deutsche in Betracht. Wir füttern den gesamten Satz auf Englisch in die Eingabeeinfügung. Eine Eingabe-Insert-Schicht kann man sich als einen Punkt im Raum vorstellen, an dem Wörter mit ähnlicher Bedeutung physisch näher beieinander liegen., nämlich, Jedes Wort wird einem Vektor mit fortlaufenden Werten zugewiesen, um dieses Wort darzustellen.
Jetzt, Ein Problem dabei ist, dass das gleiche Wort in verschiedenen Sätzen unterschiedliche Bedeutungen haben kann, Hier kommt die Positionskodierung ins Spiel. Da Transformatoren keine Wiederholung oder Faltung enthalten, damit das Modell die Reihenfolge der Sequenz verwendet, muss einige Informationen über die relative oder absolute Position der Wörter in einer Sequenz verwenden. Die Idee ist, feste oder erlernte Gewichtungen zu verwenden, die Informationen zu einer bestimmten Position eines Tokens in einem Satz kodieren.
Ähnlich, das deutsche Zielwort wird der Ausgangskodierung zugeführt und sein Positionscodierungsvektor wird an den Decoderblock übergeben.
Der Encoderblock hat zwei Unterschichten. Der erste ist ein Selbstpflegemechanismus mit mehreren Köpfen, und das zweite ist ein einfaches Forward-Feed-Netzwerk, komplett angeschlossen je nach Position. Für jedes Wort, Wir können einen Aufmerksamkeitsvektor generieren, der die kontextuellen Beziehungen zwischen den Wörtern in einem Satz erfasst. Mehrköpfige Aufmerksamkeit auf dem Encoder wendet einen spezifischen Aufmerksamkeitsmechanismus an, der als Selbstaufmerksamkeit bezeichnet wird. Die Selbstaufmerksamkeit ermöglicht es Modellen, jedes Wort im Eintrag mit anderen Wörtern zu verknüpfen.
Zusätzlich zu den beiden Sublayern in jeder Encoder-Schicht, der Decoder fügt eine dritte Unterschicht ein, die Multi-Head-Aufmerksamkeit auf die Encoder-Stack-Ausgabe ausführt. Ähnlich dem Encoder, wir verwenden Restverbindungen um jede der Unterschichten, gefolgt von der Schichtnormalisierung. Die Aufmerksamkeitsvektoren der deutschen Wörter und die Aufmerksamkeitsvektoren der englischen Sätze des Encoders werden an die zweite mehrköpfige Aufmerksamkeit weitergegeben.
Dieser Aufmerksamkeitsblock bestimmt, wie eng die einzelnen Wortvektoren miteinander verbunden sind.. Hier wird das Englisch-Deutsch-Wort-Mapping durchgeführt. Der Decoder ist mit einer linearen Schicht versehen, die als Klassifikator und einem Softmax fungiert, um die Wahrscheinlichkeiten des Wortes zu erhalten.
Jetzt haben Sie einen grundlegenden Überblick über die Funktionsweise von Transformatoren, Sehen wir uns an, wie wir es mit Tensorflow für die Bildunterschriftsaufgabe implementieren und unsere Ergebnisse mit anderen Methoden vergleichen können.
Implementierung des Aufmerksamkeitsmechanismus zur Generierung von Untertiteln mit Transformers mit TensorFlow
Den vollständigen Quellcode finden Sie in meinem Github Profil.
Paso 1: – Importieren Sie die erforderlichen Bibliotheken
Hier werden wir Tensorflow verwenden, um unser Modell zu erstellen und es zu trainieren. Der größte Teil des Code-Guthabens geht an TensorFlow Tutorials. Sie können Google Colab- oder Kaggle-Notebooks verwenden, wenn Sie möchten, dass eine GPU Sie trainiert.
Import-String
numpy als np importieren
Pandas als pd importieren
aus numpy import array
aus PIL-Import Bild
Essiggurke importieren

import matplotlib.pyplot als plt
Importsystem, Zeit, Sie, Warnungen
Warnungen.Filterwarnungen("ignorieren")
Importieren

harter Import
Tensorflow als tf importieren
von tqdm importieren tqdm
from nltk.translate.bleu_score importsatz_bleu

aus keras.preprocessing.sequence import pad_sequences
aus keras.utils importieren nach_categorical
aus keras.utils import plot_model
von keras.models Modell importieren
aus keras.layers importieren Input
aus keras.layers importieren dicht, BatchNormalisierung
aus keras.layers importieren LSTM
aus keras.layers importieren Einbetten
aus keras.layers importieren Dropout
aus keras.layers.merge importieren hinzufügen
aus keras.callbacks importieren ModelCheckpoint
aus keras.preprocessing.image import load_img, img_to_array
aus keras.preprocessing.text import Tokenizer

von sklearn.utils import shuffle
aus sklearn.model_selection import train_test_split
Paso 2: – Datenladen und Vorverarbeitung
Definieren Sie unseren Bild- und Untertitelpfad und prüfen Sie, wie viele Bilder insgesamt im Datensatz vorhanden sind.
image_path = "/content/gdrive/Mein Laufwerk/FLICKR8K/Flicker8k_Dataset"
dir_Flickr_text = "/content/gdrive/Mein Laufwerk/FLICKR8K/Flickr8k_text/Flickr8k.token.txt"
jpgs = os.listdir(Bildpfad)

drucken("Gesamtzahl der Bilder im Datensatz = {}".Format(len(jpgs)))
Produktion:

Wir erstellen einen Datenrahmen, um die Bild-ID und die Bildunterschriften für eine einfache Verwendung zu speichern.
Datei = öffnen(dir_Flickr_text,'r')
text = file.read()
Datei.schließen()

datatxt = []
für Zeile in text.split('n'):
   col = line.split('t')
   wenn len(col) == 1:
       fortsetzen
   w = col[0].Teilt("#")
   datatxt.append(w + [col[1].untere()])

data = pd.DataFrame(datatxt,Spalten=["Dateiname","Index","Untertitel"])
data = data.reindex(Spalten =['index','Dateiname','caption'])
Daten = Daten[Daten.Dateiname != '2258277193_586949ec62.jpg.1']
uni_filenames = np.unique(Daten.Dateiname.Werte)

daten.kopf()
Produktion: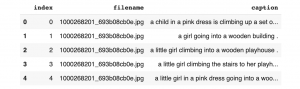
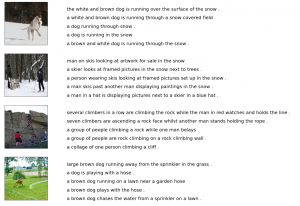
Dann, Lassen Sie uns einige Bilder und ihre Bilder visualisieren 5 Legenden:
npic = 5
npix = 224
Zielgröße = (npix,npix,3)
zählen = 1

fig = plt.figur(Feigengröße=(10,20))
für jpgfnm in uni_filenames[10:14]:
   Dateiname = Bildpfad + '/' + jpgfnm
   Bildunterschriften = Liste(Daten["Untertitel"].Platz[Daten["Dateiname"]== jpgfnm].Werte)
   image_load = load_img(Dateiname, target_size=target_size)
   ax = fig.add_subplot(npic,2,zählen,xticks=[],yticks=[])
   ax.imshow(image_load)
   zählen += 1

   ax = fig.add_subplot(npic,2,zählen)
   plt.achse('off')
   ax.plot()
   ax.set_xlim(0,1)
   ax.set_ylim(0,len(Bildunterschriften))
   für ich, Bildunterschrift in Aufzählung(Bildunterschriften):
       ax.text(0,ich,Untertitel,Schriftgröße=20)
   zählen += 1
plt.zeigen()
Produktion:
Dann, mal sehen, wie groß unser aktueller Wortschatz ist: –
Wortschatz = []
für txt in data.caption.values:
   vokabular.erweitern(txt.split())
drucken('Vocabulary Size: %d' % len(einstellen(Wortschatz)))
Produktion:
 Dann, eine Textbereinigung durchführen, So entfernen Sie Satzzeichen, einzelne Zeichen und Zahlenwerte:
def remove_punctuation(text_original):
   text_no_punctuation = text_original.translate(Zeichenfolge.Interpunktion)
   Rückkehr(text_no_punctuation)

def remove_single_character(Text):
   text_len_more_than1 = ""
   für Wort in text.split():
       wenn len(Wort) > 1:
           text_len_more_than1 += " " + Wort
   Rückkehr(text_len_more_than1)

def remove_numeric(Text):
   text_no_numeric = ""
   für Wort in text.split():
       isalpha = wort.isalpha()
       wenn isalpha:
           text_no_numeric += " " + Wort
   Rückkehr(text_no_numeric)

def text_clean(text_original):
   text = remove_punctuation(text_original)
   text = remove_single_character(Text)
   text = remove_numeric(Text)
   Rückkehr(Text)

für ich, Bildunterschrift in Aufzählung(data.caption.values):
   newcaption = text_clean(Untertitel)
   Daten["Untertitel"].iloc[ich] = neue Bildunterschrift
Schauen wir uns nun die Größe unseres Vokabulars nach der Reinigung an.
clean_vocabulary = []
für txt in data.caption.values:
   clean_vocabulary.extend(txt.split())
drucken('Clean Vocabulary Size: %d' % len(einstellen(clean_vocabulary)))
Produktion:
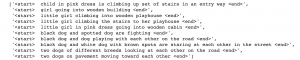
 Dann, wir speichern alle Titel und Pfade der Bilder in zwei Listen, damit wir die Bilder gleichzeitig über den festgelegten Pfad laden können. Wir fügen auch Tags hinzu “ Ja “ zu jedem Titel, damit das Modell den Anfang und das Ende jedes Titels versteht.
PFAD = "/content/gdrive/Mein Laufwerk/FLICKR8K/Flicker8k_Dataset/"
all_captions = []
für Beschriftung in Daten["Untertitel"].astyp(str):
   caption = '<Anfang> ' + caption+ ' <Ende>'
   all_captions.append(Untertitel)

all_captions[:10]
Produktion:
all_img_name_vector = []
für Annot in Daten["Dateiname"]:
   full_image_path = PFAD + Anmerkung
   all_img_name_vector.append(full_image_path)

all_img_name_vector[:10]
Produktion:
Jetzt können Sie sehen, dass wir haben 40455 Bildpfade und Bildunterschriften.
drucken(F"len(all_img_name_vector) : {len(all_img_name_vector)}")
drucken(F"len(all_captions) : {len(all_captions)}")
Produktion:

Wir nehmen alleine 40000 von jedem, damit wir die Losgröße richtig auswählen können, nämlich, 625 Lose wenn Losgröße = 64. Um dies zu tun, wir definieren eine Funktion, um den Datensatz zu begrenzen auf 40000 Bilder und Bildunterschriften.
def data_limiter(Auf eins,total_captions,all_img_name_vector):
   train_captions, img_name_vector = mischen(total_captions,all_img_name_vector,random_state=1)
   train_captions = train_captions[:Auf eins]
   img_name_vector = img_name_vector[:Auf eins]
   zurück train_captions,img_name_vector

train_captions,img_name_vector = data_limiter(40000,total_captions,all_img_name_vector)
Paso 3: – Definition des Modells
Lassen Sie uns das Modell zur Extraktion von Bildmerkmalen mit InceptionV3 definieren. Wir müssen daran denken, dass wir die Bilder hier nicht klassifizieren müssen, wir müssen nur einen Bildvektor für unsere Bilder extrahieren. Deswegen, Wir entfernen die Softmax-Schicht vom Modell. Wir müssen alle alle Bilder auf die gleiche Größe vorverarbeiten, nämlich, 299 × 299 bevor Sie sie in das Modell einsetzen, und die Ausgabeform dieser Ebene ist 8x8x2048.
def load_image(Bildpfad):
   img = tf.io.read_file(Bildpfad)
   img = tf.image.decode_jpeg(img, Kanäle=3)
   img = tf.image.resize(img, (299, 299))
   img = tf.keras.applications.inception_v3.preprocess_input(img)
   Rückgabe img, image_path

image_model = tf.keras.applications.InceptionV3(include_top=Falsch, Gewichte="imagenet")
new_input = image_model.input
hidden_layer = image_model.layers[-1].output
image_features_extract_model = tf.keras.Model(neuer_input, versteckte_schicht)
Dann, Weisen wir der Funktion zum Laden des Bildes den Namen jedes Bildes zu. Wir werden jedes Bild mit InceptionV3 vorverarbeiten und die Ausgabe auf der Festplatte zwischenspeichern und die Bildeigenschaften werden neu formatiert auf 64 × 2048.
encode_train = sortiert(einstellen(img_name_vector))
image_dataset = tf.data.Dataset.from_tensor_slices(encode_train)
image_dataset = image_dataset.map(Bild laden, num_parallel_calls=tf.data.experimental.AUTOTUNE).Charge(64)
Wir extrahieren die Merkmale und speichern sie in den jeweiligen .npy Dateien und übergeben diese Eigenschaften dann durch den Encoder.NPY-Dateien speichern alle Informationen, die zum Wiederherstellen eines Arrays auf einem beliebigen Computer erforderlich sind, inklusive Typ- und Forminformationen.
für img, Pfad in tqdm(image_dataset):
   batch_features = image_features_extract_model(img)
   batch_features = tf.reshape(batch_features,
                              (batch_features.shape[0], -1, batch_features.shape[3]))

 für bf, p in zip(batch_features, Weg):
   path_of_feature = p.numpy().dekodieren("utf-8")
   np.save(path_of_feature, bf.numpy())
Dann, Wir konvertieren die Untertitel in Token und erstellen ein Vokabular aller einzigartigen Wörter in den Daten. Wir werden auch die Größe des Vokabulars beschränken auf 5000 Hauptwörter, um Speicher zu sparen. Wir werden Wörter, die nicht im Vokabular enthalten sind, durch das Token ersetzen
top_k = 5000
Tokenizer = tf.keras.preprocessing.text.Tokenizer(num_words=top_k,
                                                 oov_token="<unk>",
                                                 Filter="!"#$%&()*+.,-/:;[E-Mail geschützt][]^_`{|}~ ")

tokenizer.fit_on_texts(train_captions)
train_seqs = tokenizer.texts_to_sequences(train_captions)
tokenizer.word_index['<Pad>'] = 0
tokenizer.index_word[0] = '<Pad>'

train_seqs = tokenizer.texts_to_sequences(train_captions)
cap_vector = tf.keras.preprocessing.sequence.pad_sequences(train_seqs, padding='post')
Dann, Erstellen Sie Trainings- und Validierungssets mit einem Split 80-20:
img_name_train, img_name_val, cap_train, cap_val = train_test_split(img_name_vector,cap_vektor, test_size=0.2, random_state=0)
Dann, Lassen Sie uns ein tf.data-Dataset erstellen, um unser Modell zu trainieren.
BATCH_SIZE = 64
BUFFER_SIZE = 1000
Anzahl_Schritte = len(img_name_train) // BATCH_SIZE

def map_func(img_name, Deckel):
   img_tensor = np.load(img_name.decode('utf-8')+'.npy')
   Rückkehr img_tensor, Deckel

dataset = tf.data.Dataset.from_tensor_slices((img_name_train, cap_train))
Datensatz = Datensatz.Karte(Lambda Gegenstand 1, Artikel2: tf.numpy_function(map_func, [Gegenstand 1, Artikel2], [tf.float32, tf.int32]),num_parallel_calls=tf.data.experimental.AUTOTUNE)
dataset = dataset.shuffle(PUFFERGRÖSSE).Charge(BATCH_SIZE)
dataset = dataset.prefetch(buffer_size=tf.data.experimental.AUTOTUNE)
Paso 4: – Positionscodierung
Die Positionscodierung verwendet Sinus- und Cosinusfunktionen unterschiedlicher Frequenzen. Für jedes IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... impar en el vector de entrada, erzeuge einen Vektor mit der cos-Funktion, für jeden geraden Index, erzeuge einen Vektor mit der Sinusfunktion. Später, füge diese Vektoren zu ihren entsprechenden Eingabeeinbettungen hinzu, das gibt dem Netzwerk Informationen über die Position jedes Vektors.
def get_angles(Pos, ich, d_model):
   angle_rates = 1 / np.leistung(10000, (2 * (ich//2)) / z.B. float32(d_model))
   Rückkehr Pos * Winkelraten

def positional_encoding_1d(Position, d_model):
   angle_rads = get_angles(np.arange(Position)[:, z.B. newaxis],
                           np.arange(d_model)[z.B. newaxis, :],
                           d_model)

   angle_rads[:, 0::2] = np.sin(angle_rads[:, 0::2])
   angle_rads[:, 1::2] = z.B. cos(angle_rads[:, 1::2])
   pos_encoding = angle_rads[z.B. newaxis, ...]
   Rückkehr tf.cast(pos_encoding, dtype=tf.float32)

def positional_encoding_2d(Reihe,col,d_model):
   behaupten d_model % 2 == 0
   row_pos = np.repeat(np.arange(Reihe),col)[:,z.B. newaxis]
   col_pos = np.repeat(np.expand_dims(np.arange(col),0),Reihe,Achse=0).umformen(-1,1)

   angle_rads_row = get_angles(row_pos,np.arange(d_modell//2)[z.B. newaxis,:],d_modell//2)
   angle_rads_col = get_angles(col_pos,np.arange(d_modell//2)[z.B. newaxis,:],d_modell//2)

   angle_rads_row[:, 0::2] = np.sin(angle_rads_row[:, 0::2])
   angle_rads_row[:, 1::2] = z.B. cos(angle_rads_row[:, 1::2])
   angle_rads_col[:, 0::2] = np.sin(angle_rads_col[:, 0::2])
   angle_rads_col[:, 1::2] = z.B. cos(angle_rads_col[:, 1::2])
   pos_encoding = np.concatenate([angle_rads_row,angle_rads_col],Achse=1)[z.B. newaxis, ...]
   Rückkehr tf.cast(pos_encoding, dtype=tf.float32)
Paso 5: – Mehrkopfpflege
Berechnen Sie die Aufmerksamkeitsgewichte. Q, k, v muss übereinstimmende Hauptdimensionen haben. k, v muss die entsprechende vorletzte Dimension haben, nämlich: seq_len_k = seq_len_v. Die Maske hat je nach Typ unterschiedliche Formen (gepolstert oder freu dich) aber es muss für die Addition übertragbar sein.
def create_padding_mask(seq):
   seq = tf.cast(tf.math.gleich(seq, 0), tf.float32)
   Rückkehr seq[:, tf.newaxis, tf.newaxis, :]  # (batch_size, 1, 1, seq_len)

def create_look_ahead_mask(Größe):
   Maske = 1 - tf.linalg.band_part(tf.ones((Größe, Größe)), -1, 0)
   Rückkehr Maske  # (seq_len, seq_len)

def scaled_dot_product_attention(Q, k, v, Maske):
   matmul_qk = tf.matmul(Q, k, transpose_b=Wahr)  # (..., seq_len_q, seq_len_k)
   dk = tf.cast(tf.form(k)[-1], tf.float32)
   scaled_attention_logits = matmul_qk / tf.math.sqrt(dk)
.
   Wenn Maske ist nicht Keine:
      scaled_attention_logits += (Maske * -1e9)

   attention_weights = tf.nn.softmax(scaled_attention_logits, Achse=-1)
   Ausgabe = tf.matmul(Aufmerksamkeit_Gewichte, v)  # (..., seq_len_q, Tiefe_v)

   Rückkehr Ausgang, Aufmerksamkeit_Gewichte

Klasse MultiHeadAchtung(tf.schwer.Schichten.Schicht):
   def __drin__(selbst, d_model, Anzahl_Köpfe):
      Super(MultiHeadAchtung, selbst).__drin__()
      selbst.Anzahl_Köpfe = Anzahl_Köpfe
      selbst.d_model = d_model
      behaupten d_model % selbst.Anzahl_Köpfe == 0
      selbst.Tiefe = d_Modell // selbst.Anzahl_Köpfe
      selbst.wq = tf.keras.layers.Dense(d_model)
      selbst.wk = tf.keras.layers.Dense(d_model)
      selbst.wv = tf.keras.layers.Dense(d_model)
      selbst.dicht = tf.keras.layers.Dense(d_model)

   def split_heads(selbst, x, batch_size):
      x = tf.reshape(x, (batch_size, -1, selbst.Anzahl_Köpfe, selbst.Tiefe))
      Rückkehr tf.transpose(x, Dauerwelle=[0, 2, 1, 3])

   def Anruf(selbst, v, k, Q, Maske=Keine):
      batch_size = tf.form(Q)[0]
      q = selbst.wq(Q)  # (batch_size, seq_len, d_model)
      k = selbst.wk(k)  # (batch_size, seq_len, d_model)
      v = selbst.wv(v)  # (batch_size, seq_len, d_model)

      q = selbst.split_heads(Q, batch_size)  # (batch_size, Anzahl_Köpfe, seq_len_q, Tiefe)
      k = selbst.split_heads(k, batch_size)  # (batch_size, Anzahl_Köpfe, seq_len_k, Tiefe)
      v = selbst.split_heads(v, batch_size)  # (batch_size, Anzahl_Köpfe, seq_len_v, Tiefe)

      skaliert_aufmerksamkeit, Aufmerksamkeit_Gewichte = scaled_dot_product_attention(Q, k, v, Maske)
      scaled_attention = tf.transpose(skaliert_aufmerksamkeit, Dauerwelle=[0, 2, 1, 3])  # (batch_size, seq_len_q,      Anzahl_Köpfe, Tiefe)

      concat_attention = tf.reshape(skaliert_aufmerksamkeit,
                                 (batch_size, -1, selbst.d_model))  # (batch_size, seq_len_q, d_model)

      Ausgabe = selbst.dicht(concat_attention)  # (batch_size, seq_len_q, d_model)
      Rückkehr Ausgang, Aufmerksamkeit_Gewichte

def point_wise_feed_forward_network(d_model, dff):
   Rückkehr tf.keras.Sequential([
                tf.harte.Schichten.Dense(dff, Aktivierung='relu'),  # (batch_size, seq_len, dff)
                tf.harte.Schichten.Dense(d_model)  # (batch_size, seq_len, d_model)])
Paso 6: – Encoder-Decoder-Schicht
Klasse EncoderLayer(tf.schwer.Schichten.Schicht):
   def __drin__(selbst, d_model, Anzahl_Köpfe, dff, Bewertung=0.1):
      Super(EncoderLayer, selbst).__drin__()
      selbst.mha = MultiHeadAchtung(d_model, Anzahl_Köpfe)
      selbst.ffn = point_wise_feed_forward_network(d_model, dff)

      selbst.layernorm1 = tf.hard.layers.LayerNormalization(Epsilon=1e-6)
      selbst.layernorm2 = tf.hard.layers.LayerNormalization(Epsilon=1e-6)

      selbst.dropout1 = tf.keras.layers.Dropout(Bewertung)
      selbst.dropout2 = tf.keras.layers.Dropout(Bewertung)


   def Anruf(selbst, x, Ausbildung, Maske=Keine):
      attn_output, _ = selbst.mha(x, x, x, Maske)  # (batch_size, input_seq_len, d_model)
      attn_output = selbst.Aussetzer1(attn_output, ausbilden=ausbilden)
      out1 = selbst.layernorm1(x + attn_output)  # (batch_size, input_seq_len, d_model)

      ffn_output = selbst.ffn(aus1)  # (batch_size, input_seq_len, d_model)
      ffn_output = selbst.Aussetzer2(ffn_output, ausbilden=ausbilden)
      out2 = selbst.layernorm2(aus1 + ffn_output)  # (batch_size, input_seq_len, d_model)
      Rückkehr aus2
Klasse DecoderLayer(tf.schwer.Schichten.Schicht):
   def __drin__(selbst, d_model, Anzahl_Köpfe, dff, Bewertung=0.1):
      Super(DecoderLayer, selbst).__drin__()
      selbst.mha1 = MultiHeadAchtung(d_model, Anzahl_Köpfe)
      selbst.mha2 = MultiHeadAchtung(d_model, Anzahl_Köpfe)

      selbst.ffn = point_wise_feed_forward_network(d_model, dff)

      selbst.layernorm1 = tf.hard.layers.LayerNormalization(Epsilon=1e-6)
      selbst.layernorm2 = tf.hard.layers.LayerNormalization(Epsilon=1e-6)
      selbst.layernorm3 = tf.hard.layers.LayerNormalization(Epsilon=1e-6)

      selbst.dropout1 = tf.keras.layers.Dropout(Bewertung)
      selbst.dropout2 = tf.keras.layers.Dropout(Bewertung)
      selbst.dropout3 = tf.keras.layers.Dropout(Bewertung)

   def Anruf(selbst, x, enc_output, Ausbildung,look_ahead_mask=Keine, padding_mask=Keine):
      attn1, attn_weights_block1 = selbst.mha1(x, x, x, look_ahead_mask)  # (batch_size, target_seq_len, d_model)
      attn1 = selbst.Aussetzer1(attn1, ausbilden=ausbilden)
      out1 = selbst.layernorm1(attn1 + x)

      attn2, attn_weights_block2 = selbst.mha2(enc_output, enc_output, aus1, padding_mask)
      attn2 = selbst.Aussetzer2(attn2, ausbilden=ausbilden)
      out2 = selbst.layernorm2(attn2 + aus1)  # (batch_size, target_seq_len, d_model)

      ffn_output = selbst.ffn(aus2)  # (batch_size, target_seq_len, d_model)
      ffn_output = selbst.Aussteiger3(ffn_output, ausbilden=ausbilden)
      out3 = selbst.layernorm3(ffn_output + aus2)  # (batch_size, target_seq_len, d_model)

      Rückkehr aus3, attn_weights_block1, attn_weights_block2
Klasse Encoder(tf.schwer.Schichten.Schicht):
   def __drin__(selbst, num_layers, d_model, Anzahl_Köpfe, dff, Zeilengröße,col_size,Bewertung=0.1):
      Super(Encoder, selbst).__drin__()
      selbst.d_model = d_model
      selbst.num_layers = num_layers

      selbst.Einbettung = tf.keras.layers.Dense(selbst.d_model,Aktivierung='relu')
      selbst.pos_encoding = positional_encoding_2d(Zeilengröße,col_size,selbst.d_model)

      selbst.enc_layers = [EncoderLayer(d_model, Anzahl_Köpfe, dff, Bewertung) zum _ in Bereich(num_layers)]
      selbst.dropout = tf.keras.layers.Dropout(Bewertung)

   def Anruf(selbst, x, Ausbildung, Maske=Keine):
      seq_len = tf.shape(x)[1]
      x = selbst.Einbettung(x)  # (batch_size, input_seq_len(H*W), d_model)
      x += selbst.pos_encoding[:, :seq_len, :]
      x = selbst.aussteigen(x, ausbilden=ausbilden)

      zum ich bin dabei Bereich(selbst.num_layers):
         x = selbst.enc_layers[ich](x, Ausbildung, Maske)

      Rückkehr x  # (batch_size, input_seq_len, d_model)
Klasse Decoder(tf.schwer.Schichten.Schicht):
   def __drin__(selbst, num_layers,d_model,Anzahl_Köpfe,dff, target_vocab_size, maximum_position_encoding,   Bewertung=0.1):
      Super(Decoder, selbst).__drin__()
      selbst.d_model = d_model
      selbst.num_layers = num_layers

      selbst.Einbettung = tf.keras.layers.Einbettung(target_vocab_size, d_model)
      selbst.pos_encoding = positional_encoding_1d(maximum_position_encoding, d_model)

      selbst.dec_layers = [DecoderLayer(d_model, Anzahl_Köpfe, dff, Bewertung)
                         zum _ In Bereich(num_layers)]
      selbst.dropout = tf.keras.layers.Dropout(Bewertung)

   def Anruf(selbst, x, enc_output, Ausbildung,look_ahead_mask=Keiner, padding_mask=Keiner):
      seq_len = tf.shape(x)[1]
      Aufmerksamkeit_Gewichte = {}

      x = selbst.Einbettung(x)  # (batch_size, target_seq_len, d_model)
      x *= tf.math.sqrt(tf.cast(selbst.d_model, tf.float32))
      x += selbst.pos_encoding[:, :seq_len, :]
      x = selbst.aussteigen(x, ausbilden=ausbilden)

      zum ich In Bereich(selbst.num_layers):
         x, Block 1, block2 = selbst.dec_layers[ich](x, enc_output, Ausbildung,
                                            look_ahead_mask, padding_mask)

         Aufmerksamkeit_Gewichte['decoder_layer{}_block1'.Format(ich+1)] = block1
         Aufmerksamkeit_Gewichte['decoder_layer{}_block2'.Format(ich+1)] = block2

      Rückkehr x, Aufmerksamkeit_Gewichte
Paso 7: – Transformator
Klasse Transformator(tf.schwer.Modell):
   def __drin__(selbst, num_layers, d_model, Anzahl_Köpfe, dff,Zeilengröße,col_size,
              target_vocab_size,max_pos_encoding, Bewertung=0.1):
      Super(Transformator, selbst).__drin__()
      selbst.Encoder = Encoder(num_layers, d_model, Anzahl_Köpfe, dff,Zeilengröße,col_size, Bewertung)
      selbst.Decoder = Decoder(num_layers, d_model, Anzahl_Köpfe, dff,
                          target_vocab_size,max_pos_encoding, Bewertung)
      selbst.final_layer = tf.keras.layers.Dense(target_vocab_size)

   def Anruf(selbst, inp, Teer, Ausbildung,look_ahead_mask=Keiner,dec_padding_mask=Keiner,enc_padding_mask=Keiner   ):
      enc_output = selbst.Encoder(inp, Ausbildung, enc_padding_mask)  # (batch_size, inp_seq_len, d_model      )
      dec_output, Aufmerksamkeit_Gewichte = selbst.Decoder(
      Teer, enc_output, Ausbildung, look_ahead_mask, dec_padding_mask)
      final_output = selbst.final_layer(dec_output)  # (batch_size, tar_seq_len, target_vocab_size)
      Rückkehr final_output, Aufmerksamkeit_Gewichte
Paso 8: – Hyperparameter-Modell
Parameter für das Training definieren:
num_layer = 4
d_model = 512
dff = 2048
Anzahl_Köpfe = 8
row_size = 8
col_size = 8
target_vocab_size = top_k + 1
dropout_rate = 0.1
Klasse Benutzerdefinierter Zeitplan(tf.schwer.Optimierer.Zeitpläne.LearningRateZeitplan):
   def __drin__(selbst, d_model, Aufwärmschritte=4000):
      Super(Benutzerdefinierter Zeitplan, selbst).__drin__()
      selbst.d_model = d_model
      selbst.d_model = tf.cast(selbst.d_model, tf.float32)
      selbst.warmup_steps = warmup_steps

   def __Anruf__(selbst, Schritt):
      arg1 = tf.math.rsqrt(Schritt)
      arg2 = Schritt * (selbst.Aufwärmschritte ** -1.5)
      Rückkehr tf.math.rsqrt(selbst.d_model) * tf.math.minimum(arg1, arg2)
learning_rate = CustomSchedule(d_model)
Optimizer = tf.hard.optimizers.Adam(Lernrate, beta_1=0.9, beta_2=0.98,
                                    Epsilon=1e-9)
loss_object = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=Wahr, Reduktion='none')

def verlustfunktion(Real, pred):
   mask = tf.math.logical_not(tf.math.gleich(Real, 0))
   loss_ = loss_object(Real, pred)
   Maske = tf.cast(Maske, dtype=loss_.dtype)
   Verlust_ *= Maske
  Rückkehr tf.reduce_sum(Verlust_)/tf.reduce_sum(Maske)
train_loss = tf.keras.metrics.Mean(name="train_loss")
train_accuracy = tf.keras.metrics.SparseCategoricalAccuracy(name="train_accuracy")
Transformator = Transformator(num_layer,d_model,Anzahl_Köpfe,dff,Zeilengröße,col_size,target_vocab_size,                                 max_pos_encoding=target_vocab_size,rate=dropout_rate)
Paso 9: – Modelltraining
def create_masks_decoder(Teer):
   look_ahead_mask = create_look_ahead_mask(tf.form(Teer)[1])
   dec_target_padding_mask = create_padding_mask(Teer)
   kombinierte_maske = tf.maximum(dec_target_padding_mask, look_ahead_mask)
   Rückkehr kombinierte_maske
@tf.Funktion
def train_step(img_tensor, Teer):
   tar_inp = tar[:, :-1]
   tar_real = tar[:, 1:]
   dec_mask = create_masks_decoder(tar_inp)
   mit tf.GradientTape() wie Band:
      Vorhersagen, _ = Transformator(img_tensor, tar_inp,Wahr, dec_mask)
      Verlust = Verlust_Funktion(tar_real, Vorhersagen)

   Farbverläufe = tape.gradient(Verlust, transformator.trainable_variables)
   optimizer.apply_gradients(Postleitzahl(Steigungen, transformator.trainable_variables))
   train_loss(Verlust)
   train_accuracy(tar_real, Vorhersagen)
zum Epoche In Bereich(30):
   start = time.time()
   train_loss.reset_states()
   train_accuracy.reset_states()
   zum (Charge, (img_tensor, Teer)) In aufzählen(Datensatz):
      train_step(img_tensor, Teer)
      Wenn Charge % 50 == 0:
         drucken ('Epoche {} Charge {} Verlust {:.4F} Genauigkeit {:.4F}'.Format(
         Epoche + 1, Charge, train_loss.result(), train_accuracy.result()))

   drucken ('Epoche {} Verlust {:.4F} Genauigkeit {:.4F}'.Format(Epoche + 1,
                                               train_loss.result(),
                                               train_accuracy.result()))
   drucken ('Time taken for 1 Epoche: {} secsn'.Format(Zeit Zeit() - Anfang))
Paso 10: – BLEU-Bewertung
def bewerten(Bild):
   temp_input = tf.expand_dims(Bild laden(Bild)[0], 0)
   img_tensor_val = image_features_extract_model(temp_eingabe)
   img_tensor_val = tf.reshape(img_tensor_val, (img_tensor_val.shape[0], -1, img_tensor_val.shape[3]))
   start_token = tokenizer.word_index['<Anfang>']
   end_token = tokenizer.word_index['<Ende>']
   Decoder_Eingang = [start_token]
   Ausgabe = tf.expand_dims(Decoder_Eingang, 0) #Token
   Ergebnis = [] #Wortliste

   Foder ich In Bereich(100):
      dec_mask = create_masks_decoder(Ausgang)
      Vorhersagen, Aufmerksamkeit_Gewichte = Transformator(img_tensor_val,Ausgang,Falsch,dec_mask)
      Vorhersagen = Vorhersagen[: ,-1:, :]  # (batch_size, 1, vocab_size)
      vorhergesagte_id = tf.cast(tf.argmax(Vorhersagen, Achse=-1), tf.int32)
      Wenn vorhergesagte_id == end_token:
         Rückkehr Ergebnis,tf.squeeze(Ausgang, Achse=0), Aufmerksamkeit_Gewichte
      Ergebnis.anhängen(tokenizer.index_word[int(vorhergesagte_id)])
      Ausgabe = tf.concat([Ausgang, vorhergesagte_id], Achse=-1)

   Rückkehr Ergebnis,tf.squeeze(Ausgang, Achse=0), Aufmerksamkeit_Gewichte
rid = np.random.randint(0, len(img_name_val))
image = img_name_val[loswerden]
real_caption = 'Review'.beitreten([tokenizer.index_word[ich] zum ich In cap_val[loswerden] Wenn ich nicht In [0]])
Untertitel,Ergebnis,Aufmerksamkeit_Gewichte = bewerten(Bild)

first = real_caption.split('Review', 1)[1]
real_caption = first.rsplit('Review', 1)[0]

zum ich In Untertitel:
   Wenn ich=="<unk>":
      Bildunterschrift.Entfernen(ich)

zum ich In real_caption:
   Wenn ich=="<unk>":
      real_caption.remove(ich)

result_join = 'Review'.beitreten(Untertitel)
result_final = result_join.rsplit('Review', 1)[0]
real_appn = []
real_appn.append(real_caption.split())
Referenz = real_appn
Kandidat = Bildunterschrift

Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(1.0,0,0,0))
drucken(F"BLAU-1-Ergebnis: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.5,0.5,0,0))
drucken(F"BLAU-2 Punktzahl: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.3,0.3,0.3,0))
drucken(F"BLAU-3 Punktzahl: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.25,0.25,0.25,0.25))
drucken(F"BLAU-4-Punktzahl: {Punktzahl*100}")
drucken ('Real Caption:', real_caption)
drucken ('Predicted Caption:', 'Review'.beitreten(Untertitel))
temp_image = np.array(Bild.offen(Bild))
plt.imshow(temp_image)
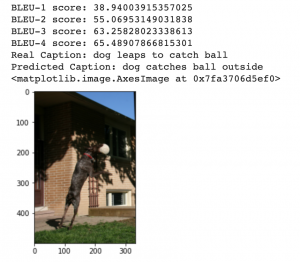
Produktion:
rid = np.random.randint(0, len(img_name_val))
image = img_name_val[loswerden]
real_caption = 'Review'.beitreten([tokenizer.index_word[ich] zum ich In cap_val[loswerden] Wenn ich nicht In [0]])
Untertitel,Ergebnis,Aufmerksamkeit_Gewichte = bewerten(Bild)

first = real_caption.split('Review', 1)[1]
real_caption = first.rsplit('Review', 1)[0]

zum ich In Untertitel:
   Wenn ich=="<unk>":
      Bildunterschrift.Entfernen(ich)

zum ich In real_caption:
   Wenn ich=="<unk>":
      real_caption.remove(ich)

result_join = 'Review'.beitreten(Untertitel)
result_final = result_join.rsplit('Review', 1)[0]
real_appn = []
real_appn.append(real_caption.split())
Referenz = real_appn
Kandidat = Bildunterschrift

Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(1.0,0,0,0))
drucken(F"BLAU-1-Ergebnis: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.5,0.5,0,0))
drucken(F"BLAU-2 Punktzahl: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.3,0.3,0.3,0))
drucken(F"BLAU-3 Punktzahl: {Punktzahl*100}")
Punktzahl = Satz_bleu(Hinweis, Kandidat, Gewichte=(0.25,0.25,0.25,0.25))
drucken(F"BLAU-4-Punktzahl: {Punktzahl*100}")
drucken ('Real Caption:', real_caption)
drucken ('Predicted Caption:', 'Review'.beitreten(Untertitel))
temp_image = np.array(Bild.offen(Bild))
plt.imshow(temp_image)
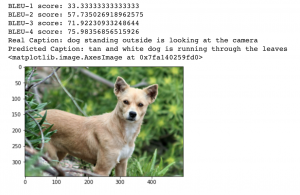
Produktion:
Paso 11: – Vergleich
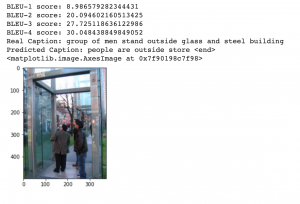
Vergleichen wir die im vorherigen Artikel erzielten BLEU-Werte mit Bahdanaus Aufmerksamkeit mit unseren Transformers.
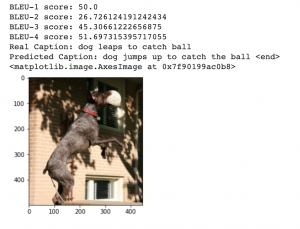
Die BLEU-Werte auf der linken Seite verwenden Bahdanaus Aufmerksamkeit und die BLEU-Werte auf der rechten Seite verwenden Transformers. Wie wir sehen können, Transformer funktioniert viel besser als nur ein Pflegemodell.
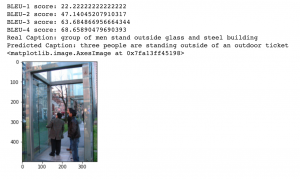
Und da ist es! Wir haben Transformers erfolgreich mit Tensorflow implementiert und haben gesehen, wie es zu Spitzenergebnissen führen kann..
Abschließende Anmerkungen
Zusammenfassend, Transformer sind besser als alle anderen Architekturen, die wir bisher gesehen haben, weil sie Rekursionen vollständig vermeiden, durch die Verarbeitung von Sätzen als Ganzes und durch das Erlernen der Beziehungen zwischen Wörtern dank mehrköpfiger Aufmerksamkeitsmechanismen und Positionseinbettungen. Es sollte auch beachtet werden, dass Transformatoren, die Tensorflow verwenden, nur Abhängigkeiten innerhalb der festen Eingangsgröße erfassen können, mit der sie trainiert werden..
Es gibt viele neue und leistungsstarke Transformatoren wie Transformer-XL, Verhedderter Transformator, Mesh-Speichertransformator, der auch für Anwendungen wie Image Captions implementiert werden kann, um noch bessere Ergebnisse zu erzielen.
Findest du diesen Artikel hilfreich? Teilen Sie Ihr wertvolles Feedback im Kommentarbereich unten mit.. Fühlen Sie sich frei, auch Ihre vollständigen Codebücher zu teilen, das wird für die Mitglieder unserer Community nützlich sein.





