Dieser Artikel wurde im Rahmen der Data Science Blogathon
Este artículo se centra en Apache SchweinDas Schwein, ein domestiziertes Säugetier aus der Familie der Suidae, Es ist bekannt für seine Vielseitigkeit in der Landwirtschaft und Lebensmittelproduktion. In Asien beheimatet, Seine Züchtung hat sich über die ganze Welt verbreitet. Schweine sind Allesfresser und haben eine hohe Anpassungsfähigkeit an verschiedene Lebensräume. Was ist mehr, spielen eine wichtige Rolle in der Wirtschaft, Bereitstellung von Fleisch, Leder und andere abgeleitete Produkte. Ihre Intelligenz und ihr Sozialverhalten sind auch .... Es ist eine High-Level-Plattform zur Verarbeitung und Analyse großer Datenmengen.
ÜBERBLICK
Wenn wir uns die Top-Level-Übersicht von Pig . ansehen, Pig es una abstracción de Karte verkleinernMapReduce ist ein Programmiermodell, das entwickelt wurde, um große Datensätze effizient zu verarbeiten und zu generieren. Unterstützt von Google, Bei diesem Ansatz wird die Arbeit in kleinere Aufgaben aufgeteilt, die auf mehrere Knoten in einem Cluster verteilt sind. Jeder Knoten verarbeitet seinen Teil und dann werden die Ergebnisse kombiniert. Mit dieser Methode können Sie Anwendungen skalieren und große Informationsmengen verarbeiten, in der Welt von Big Data von grundlegender Bedeutung zu sein..... Schwein läuft auf Hadoop. Deswegen, utiliza tanto el Verteiltes DateisystemEin verteiltes Dateisystem (DFS) Ermöglicht die Speicherung und den Zugriff auf Daten auf mehreren Servern, Erleichterung der Verwaltung großer Informationsmengen. Diese Art von System verbessert die Verfügbarkeit und Redundanz, da Dateien an verschiedene Speicherorte repliziert werden, Reduzierung des Risikos von Datenverlusten. Was ist mehr, Ermöglicht Benutzern den Zugriff auf Dateien von verschiedenen Plattformen und Geräten aus, die Zusammenarbeit zu fördern und... die Hadoop (HDFSHDFS, o Verteiltes Hadoop-Dateisystem, Es ist eine Schlüsselinfrastruktur für die Speicherung großer Datenmengen. Entwickelt für die Ausführung auf gängiger Hardware, HDFS ermöglicht die Datenverteilung über mehrere Knoten, Sicherstellung einer hohen Verfügbarkeit und Fehlertoleranz. Seine Architektur basiert auf einem Master-Slave-Modell, wobei ein Master-Knoten das System verwaltet und Slave-Knoten die Daten speichern, Erleichterung der effizienten Verarbeitung von Informationen..) wie das Hadoop-Verarbeitungssystem, Karte verkleinern. Datenflüsse laufen
durch einen Motor. Wird verwendet, um Datensätze als Datenströme zu analysieren. Enthält eine High-Level-Sprache namens Pig Latin, um diese Datenströme auszudrücken.
Der Eintrag für Pig ist Pig Latin, die zu MapReduce-Jobs werden. Pig verwendet MapReduce-Tricks, um die gesamte Datenverarbeitung durchzuführen. Kombiniert die Pig Latin-Skripte zu einer Reihe von einem oder mehreren MapReduce-Jobs, die ausgeführt werden.
Apache Pig wurde von Yahoo entwickelt, weil es einfach zu erlernen und zu handhaben ist.. Dann, Schwein macht Hadoop ziemlich einfach. Apache Pig wurde entwickelt, weil die MapReduce-Programmierung ziemlich schwierig wurde und viele MapReduce-Benutzer mit deklarativen Sprachen nicht vertraut sind. Jetzt, Pig ist ein Open-Source-Projekt unter Apache.
INHALTSVERZEICHNIS
- Schweineeigenschaften
- Cerdo vs. MapReduce
- Schweinearchitektur
- Optionen für den Schweineauslauf
- Grundlegende Pig-Ausführungsbefehle
- Datentypen für Schweine
- Schweinebetreiber
- Lateinisches Schreibbeispiel für Schwein
1. SCHWEINE EIGENSCHAFTEN
Schauen wir uns einige der Eigenschaften von Pig an.
- Verfügt über eine Vielzahl von Operatoren wie Join, bestellen, etc.
- Es ist einfach zu programmieren, da es SQL ähnlich ist.
- Aufgaben in Apache Pig wurden automatisch in MapReduce-Jobs konvertiert. Programmierer sollten sich nur auf die Sprachsemantik konzentrieren und nicht auf MapReduce.
- Sie können Ihre eigenen Funktionen mit Pig . erstellen.
- Funktionen in anderen Programmiersprachen wie Java können in Pig Latin-Skripte eingebettet werden.
- Apache Pig kann damit umgehen
alle Arten von Daten, als strukturierte Daten, unstrukturiert und halbstrukturiert und
speichert das Ergebnis in HDFS.
2. CERDO GEGEN MAPREDUCE
Sehen wir uns den Unterschied zwischen Pig und MapReduce an.
Schwein hat mehrere Vorteile gegenüber MapReduce.
Apache Pig ist eine Datenflusssprache. Dies bedeutet, dass Benutzer beschreiben können, wie sie gelesen werden sollen, verarbeiten und dann die Daten von einem oder mehreren Eingängen zu einem oder mehreren Ausgängen parallel speichern. Während MapReduce, Zweitens, ist ein Programmierstil.
Apache Pig ist eine Hochsprache, während MapReduce kompilierter Java-Code ist.
Die Pig-Syntax zum Ausführen von Joins und mehreren Dateien ist sehr intuitiv und ganz einfach wie SQL. MapReduce-Code
wird komplex, wenn Sie Join-Operationen schreiben möchten.
Die Lernkurve von Apache Pig ist sehr klein. Erfahrung mit Java- und MapReduce-Bibliotheken ist ein Muss
um den MapReduce-Code auszuführen.
Apache Pig-Skripte können das Äquivalent mehrerer Zeilen MapReduce-Code tun und MapReduce-Code benötigt mehr Codezeilen, um die gleichen Operationen auszuführen.
Apache Pig ist einfach zu debuggen und zu testen, während MapReduce-Programme viel Zeit zum Kodieren brauchen, ausprobieren, etc. Pig Latin ist günstiger als MapReduce.
3. SCHWEINE ARCHITEKTUR
Schauen wir uns nun die Architektur von Pig an.
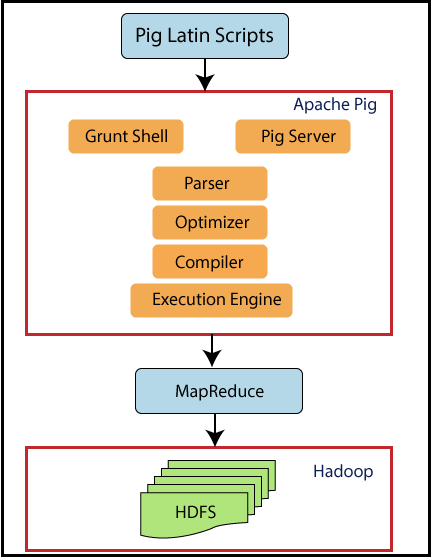
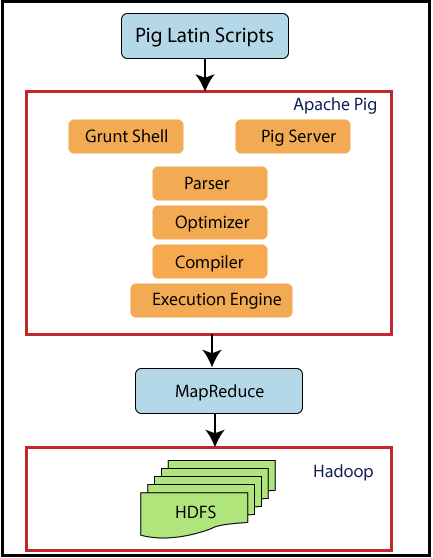
Schwein sitzt auf Hadoop. Pig-Skripte können in der Grunt-Shell oder dem Pig-Server ausgeführt werden. Die Pig the Pass-Laufzeit optimiert und kompiliert das Skript und konvertiert es schließlich in MapReduce-Jobs. Verwendet HDFS zum Speichern von Zwischendaten zwischen MapReduce-Jobs und schreibt dann die Ausgabe in HDFS.
4. AUSFÜHRUNGSOPTIONEN FÜR SCHWEINE
Apache Pig kann zwei Ausführungsmodi ausführen. Beide liefern die gleichen Ergebnisse.
4.1. Lokalbetrieb
Kommando auf Laufstegen
Schwein -x lokal
4.2. Modo Hadoop
Kommando auf Laufstegen
Schwein -exectype mapreduce
Apache Pig kann in den beiden oben genannten Modi auf drei Arten ausgeführt werden.
- Batch-Modus / Skriptdatei: Setzen Sie die Pig-Befehle in eine Skriptdatei und führen Sie das Skript aus
- Eingebettetes Programm / UDF: Betten Sie Pig-Befehle in Java ein und führen Sie die Skripte aus
5. SCHWEINEGRÜNDE SCHALENBEFEHLE
Grunt-Shells können verwendet werden, um lateinische Pig-Skripte zu schreiben. Shell-Befehle können mit den Befehlen fs und sh aufgerufen werden. Sehen wir uns einige Grundlagen an
Schweinebefehle.
5.1. fs-Befehl
Mit dem Befehl fs können Sie HDFS-Befehle von Pig . ausführen
5.1.1 Alle Verzeichnisse in HDFS auflisten
grunzen> fs -ls;
Jetzt, alle Dateien in HDFS werden angezeigt.
5.1.2. So erstellen Sie ein neues mydir-Verzeichnis in HDFS
grunzen> fs -mkdir meindir/;
Der obige Befehl erstellt ein neues Verzeichnis namens mydir in HDFS.
5.1.3. So löschen Sie ein Verzeichnis
grunzen> fs -rmdir mydir;
Der obige Befehl löscht das erstellte Verzeichnis mydir.
5.1.4. So kopieren Sie eine Datei nach HDFS
gewähren> fs -put sales.txt sales/;
Hier, Die Datei namens sales.txt ist die Quelldatei, die in das Zielverzeichnis in HDFS kopiert wird, nämlich, Der Umsatz.
5.1.5. Um Grunt Shell zu verlassen
grunzen> Verlassen;
Der obige Befehl beendet die Grunt-Shell.
5.2. Befehl sh
Mit dem Befehl sh können Sie eine Unix-Anweisung von Pig ausführen
5.2.1. Um das aktuelle Datum anzuzeigen
grunzen> sch datum;
Dieser Befehl zeigt das aktuelle Datum an.
5.2.2. Lokale Dateien auflisten
grunzen> sch ls;
Dieser Befehl zeigt alle Dateien auf dem lokalen System an.
5.2.3. So führen Sie Pig Latin aus der Grunzen-Shell aus
grunzen> starte salesreport.pig;
Der obige Befehl führt eine Pig Latin-Skriptdatei aus „verkaufsbericht.schwein“ aus Grunzenschale.
5.2.4. So führen Sie Pig Latin über die Unix-Eingabeaufforderung aus
$Schwein-Verkaufsbericht.Schwein;
Der obige Befehl führt eine Pig Latin-Skriptdatei „salesreport.pig“ von der Unix-Eingabeaufforderung aus.
6. P
Pig Latin besteht aus den folgenden Datentypen.
6.1. Datenatom
Es ist ein einzigartiger Wert. Es kann eine Zeichenfolge oder eine Zahl sein. Sie sind von skalaren Typen wie int, schweben, doppelt, etc.
Zum Beispiel, „John“, 9.0
6.2. Doppelt
Ein Tupel ähnelt einem Datensatz mit einer Folge von Feldern. Es kann sich um jede Art von Daten handeln.
Zum Beispiel, (‚John‘, ‚james‘) ist ein Tupel.
6.3. Datentasche
Es besteht aus einer Sammlung von Tupeln, die äquivalent zu a . ist „Tisch“ und SQL. Tupel sind nicht eindeutig und können eine beliebige Anzahl von Feldern haben, jeder kann von beliebiger Art sein.
Zum Beispiel, {(‚John‘, ‚James), (‚ king ‚,‘ mark ‚)} ist ein Datensack, der der folgenden Tabelle in SQL entspricht.
6.4. Datenkarte
Diese Art von Daten
enthält eine Sammlung von Schlüssel-Wert-Paaren. Hier, Der Schlüssel muss ein einzelnes Zeichen sein. Werte können von beliebiger Art sein.
Zum Beispiel, [Name#('John', 'James'), Alter #22] ist eine Datenkarte, in der name, Alter ist der Schlüssel und (‚John,‘ james ‚), 22 sind Werte.
7. SCHWEINEBETREIBER
Unten ist der Inhalt der Datei student.txt.
John,23,Hyderabad
James,45,Hyderabad
Sam,33,Chennai
,56,Delhi
,43,Mumbai
7.1. BELASTUNG
Lädt Daten aus dem angegebenen Dateisystem.
A = LOAD 'student.txt' AS (Name: chararray, Alter: int, Stadt: chararray);
Los datos del archivo del estudiante con nombres de columna como ‚Name‘, ‚Alter‘, ‚Stadt‘ se cargarán en una VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... EIN.
7.2. ENTSORGEN
Der DUMP-Operator wird verwendet, um den Inhalt einer Relation anzuzeigen. Hier, der Inhalt von A wird angezeigt.
DUMP A
//Ergebnisse
(John,23,Hyderabad)
(James,45,Hyderabad)
(Sam,33,Chennai)
(,56,Delhi)
(,43,Mumbai)
7.3. EINKAUFEN
Speicherfunktion speichert Ergebnisse im Dateisystem.
SPEICHERN Sie A in „myoutput“ mit PigStorage('*');
Hier, los datos presentes en A se almacenarán en myoutput separados por ‚*‘.
DUMP myoutput;
//results
John*23*Hyderabad
James*45*Hyderabad
Sam*33*Chennai
*56*Delhi
*43*Mumbai
7.4. FILTER
B = FILTER A nach Name ist nicht null;
Der FILTER-Operator filtert eine Tabelle mit einigen Bedingungen. Hier, der Name ist die Spalte in A. Nicht leere Werte im Namen werden in Variable B gespeichert.
DUMP B;
//Ergebnisse
(John,23,Hyderabad)
(James,45,Hyderabad)
(Sam,33,Chennai)
7.5. FÜR JEDEN ZUM GENERIEREN
C = FOREACH A GENERATE name, Stadt;
Der FOREACH-Operator wird verwendet, um auf einzelne Datensätze zuzugreifen. Hier, die im Namen vorhandenen Zeilen und die Stadt werden von A bezogen und in C gespeichert.
DUMP C
//Ergebnisse
(John,Hyderabad)
(James,Hyderabad)
(Sam,Chennai)
(,Delhi)
(,Mumbai)
8. BEISPIEL FÜR DAS LATEINISCHE SKRIPT VON SCHWEIN
Wir haben eine Datei mit Personen, deren Felder die Identifikation des Mitarbeiters sind, der Name und die Stunden.
001,Rajiv,21
002,siddarth,12
003,Rajesh,22
Zuerst, diese Daten in einen variablen Bediener laden. Filtern Sie es stundenlang weniger als 20 und Teilzeit speichern. Sortieren Sie Teilzeit in absteigender Reihenfolge und speichern Sie sie in einer anderen Datei namens part_time. Inhalt anzeigen.
Das Skript wird
Mitarbeiter = ‚Menschen‘ laden als (empid, Name, Std);
Teilzeit = FILTER Mitarbeiter NACH Stunden < 20;
sortiert = BESTELLEN Teilzeit nach Stunden DESC;
STORE sortiert IN 'part_time';
DUMP sortiert;
BESCHREIBEN sortiert;
//Ergebnisse
(003,Rajesh,22)
(001,Rajiv,21)
SCHLUSSBEMERKUNGEN
Dies sind einige der Grundlagen von Apache Pig. Ich hoffe, es hat Ihnen Spaß gemacht, diesen Artikel zu lesen. Fang an zu üben
mit der Cloudera-Umgebung.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.