
Einführung
„Daten sind der Treibstoff für maschinelle Lernalgorithmen“.
Bevor Sie nach Informationen aus den Daten suchen, Wir müssen zunächst Vorverarbeitungsaufgaben durchführen, die es uns dann nur ermöglichen, diese Daten für weitere Beobachtungen zu verwenden und unser Modell für maschinelles Lernen zu trainieren.
Die Korrektur fehlender Werte ist erforderlich, um Verzerrungen zu reduzieren und leistungsstarke geeignete Modelle zu erstellen. Die meisten Algorithmen können fehlende Daten nicht verarbeiten, Sie müssen also irgendwie handeln, um Ihren Code nicht abstürzen zu lassen. Dann, Beginnen wir mit den Methoden zur Lösung des Problems.
Methoden zum Umgang mit fehlenden Werten
Beispiel 1, Lass uns ein .... haben Dummy-Datensatz bei denen es drei unabhängige Merkmale gibt (Prädiktoren) und ein abhängiges Merkmal (Antworten).
| Funktion-1 | Funktion-2 | Funktion-3 | Produktion |
| Männlich | 23 | 24 | Jawohl |
| – – – – | 24 | 25 | Nein |
| Frau | 25 | 26 | Jawohl |
| Männlich | 26 | 27 | Jawohl |
Hier, wir haben einen fehlenden Wert in der Zeile 2 für Funktion-1.
Beliebte Methoden, die die Machine Learning-Community verwendet, um den fehlenden Wert kategorialer Variablen im Dataset zu behandeln, sind wie folgt::
1. Löschen Sie die Beobachtungen: Wenn der Datensatz eine große Anzahl von Beobachtungen enthält, wobei alle vorherzusagenden Klassen ausreichend in den Trainingsdaten dargestellt sind, Versuchen Sie, fehlende Wertbeobachtungen zu entfernen, die keine wesentlichen Änderungen an Ihrem Feed durch Ihr Modell bewirken würden.
Zum Beispiel, 1, Implementieren Sie diese Methode für einen bestimmten Datensatz, wir können die gesamte Zeile mit den fehlenden Werten entfernen (Zeile-2 löschen).
2. Ersetzen Sie fehlende Werte durch den häufigsten Wert: Sie können sie immer basierend auf berechnen Weg bei kategorialen Variablen, Stellen Sie sicher, dass Sie keine sehr verzerrten Klassenverteilungen haben.
HINWEIS: Aber in manchen Fällen, Diese Strategie kann die Daten in den wrt-Klassen unausgewogen machen, wenn in unserem Datensatz viele fehlende Werte vorhanden sind.
– Allgemein, fehlende Werte durch Mittelwert ersetzen / MedianDer Median ist ein statistisches Maß, das den zentralen Wert eines Satzes geordneter Daten darstellt. Um es zu berechnen, Die Daten werden von der niedrigsten zur höchsten sortiert und die Zahl in der Mitte wird identifiziert. Wenn es eine gerade Anzahl von Beobachtungen gibt, Die beiden Kernwerte werden gemittelt. Dieser Indikator ist besonders nützlich bei asymmetrischen Verteilungen, da es nicht von Extremwerten beeinflusst wird.... / Mode ist ein grober Umgang mit verlorenen Werten. Je nach Kontext, Como si la variación es baja o si la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... tiene un apalancamiento bajo sobre la respuesta, eine solche grobe Annäherung ist akzeptabel und könnte zu zufriedenstellenden Ergebnissen führen. In diesem Fall, da Sie sagen, dass es eine kategoriale Variable ist, Dieser Schritt ist möglicherweise nicht anwendbar.
Zum Beispiel, 1, Um diese Methode zu implementieren, Wir ersetzen den fehlenden Wert durch den häufigsten Wert für diese bestimmte Spalte, hier ersetzen wir den fehlenden Wert durch Male, da die Anzahl von Male größer ist als Female (männlich = 2 und Feminin = 1).
3. Entwickeln Sie ein Modell, um fehlende Werte vorherzusagen: Ein cleverer Weg, dies zu tun, könnte darin bestehen, einen Klassifikator für Ihre Spalten mit fehlenden Werten als abhängige Variable gegen andere Merkmale in Ihrem Datensatz zu trainieren und zu versuchen, basierend auf dem neu trainierten Klassifikator zu imputieren.
Hier ist der Algorithmus, dem Sie folgen können:
– Teilen Sie die Daten in zwei Teile auf. Ein Teil enthält die aktuellen Werte der Spalte, inklusive Originalausgabespalte, der andere Teil enthält die Zeilen mit den fehlenden Werten.
– Teile den 1. Teil (aktuelle Werte) in einem Kreuzvalidierungsset zur Modellauswahl.
– Trainieren Sie Ihre Modelle und testen Sie Ihre Metriken mit kreuzvalidierten Daten. Sie können auch eine Rastersuche oder eine Zufallssuche durchführen, um die besten Ergebnisse zu erzielen.
– Schließlich, mit dem Modell, sagt unbekannte Werte voraus, die in unserem Problem fehlen.
HINWEIS: Da Sie versuchen, fehlende Werte zu imputieren, so wird es angenehmer, da sie nicht verzerrt sind und Sie die besten Vorhersagen vom besten Modell erhalten.
Zum Beispiel, 1, Um die vorgegebene Strategie umzusetzen, Zuerst betrachten wir die Spalte Merkmal-2, Feature-3 und Ausgabe für unseren neuen Klassifikator, Was bedeutet es, dass du bist? 3 Spalten werden als unabhängige Merkmale für unseren neuen Klassifikator verwendet und Merkmal-1 wird als Ergebnis und ein objektiver Hinweis betrachtet, dass wir hier nur die Zeilen berücksichtigen, die nicht fehlen, da unsere Zugdaten und Beobachtungen, die einen fehlenden Wert haben, unsere Testdaten werden. Wir müssen die Vorhersage mit unserem Modell auf den Testdaten treffen und, nach Vorhersagen, wir haben den Datensatz ohne fehlenden Wert.
4. Eliminieren der Variablen: Wenn es einen außergewöhnlich größeren Satz an fehlenden Werten gibt, Versuchen Sie, die Variable selbst für ein zusätzliches Modell auszuschließen, aber Sie müssen sicherstellen, dass es nicht sehr signifikant ist, die Zielvariable vorherzusagen, nämlich, die Korrelation zwischen verworfener Variable und Zielvariable ist sehr gering oder redundant.
Zum Beispiel, 1, Um diese Strategie zu implementieren, um mit fehlenden Werten umzugehen, wir müssen die gesamte Spalte entfernen, die die fehlenden Werte enthält, Daher entfernen wir für einen bestimmten Datensatz Merkmal-1 vollständig und verwenden nur die Merkmale auf der linken Seite, um unsere Zielvariable vorherzusagen.
5. Wenden Sie Techniken des unbeaufsichtigten maschinellen Lernens an: bei diesem Ansatz, Wir verwenden unbeaufsichtigte Techniken wie K-bedeutet, Hierarchische Gruppierung, etc. Die Idee ist, dass Sie die Spalten mit fehlenden Werten überspringen und alle anderen Spalten außer der Zielspalte berücksichtigen und versuchen können, so viele wie keine Cluster unabhängiger Merkmale zu erstellen (nach dem Entfernen fehlender Wertespalten), endlich die Kategorie finden, in die die fehlende Zeile fällt.
Zum Beispiel, 1, Um diese Strategie umzusetzen, wir löschen die Spalte Merkmal-1 und verwenden dann Merkmal-2 und Merkmal-3 als unsere Merkmale für den neuen Klassifikator und dann, Schließlich, después de la formación del ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen...., Wir versuchen zu sehen, in welchem Cluster sich der fehlende Datensatz befindet und sind mit unserem endgültigen Datensatz für die weitere Analyse bereit.
Python-Implementierung
Importieren Sie die erforderlichen Abhängigkeiten.

Laden und lesen Sie den Datensatz.

Finden Sie die Anzahl der fehlenden Werte pro Spalte.
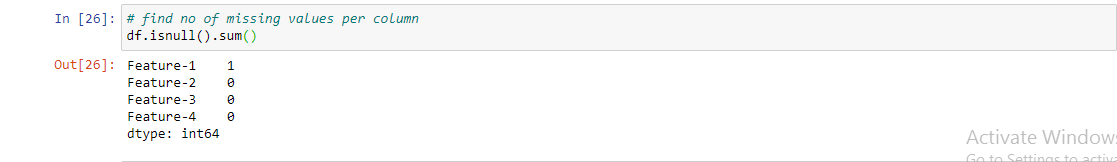
Strategie anwenden-1 (fehlende Beobachtungen entfernen).
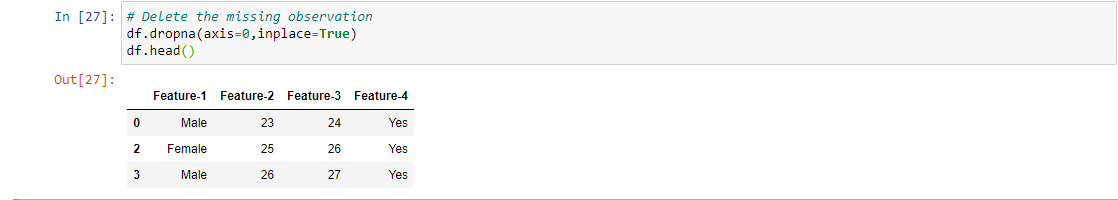
Strategie anwenden-2 (Ersetzen Sie fehlende Werte durch den häufigsten Wert).
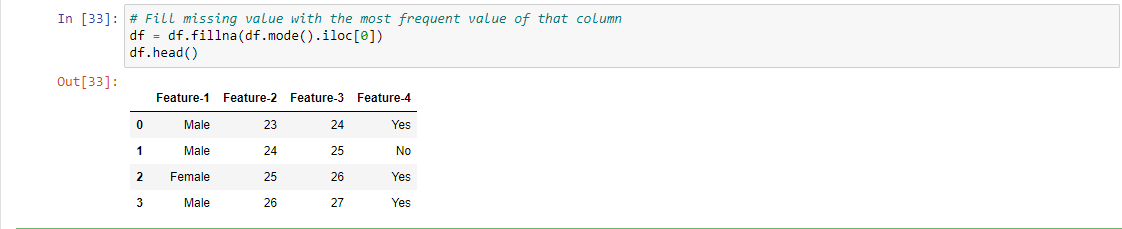
Strategie anwenden-3 (Entfernen Sie die Variable mit fehlenden Werten).
Wende die Strategie an 4 (Entwickeln Sie ein Modell, um fehlende Werte vorherzusagen).
Für diese Strategie, Zuerst codieren wir unsere unabhängigen kategorialen Spalten mit "One Hot Encoder" und abhängige kategoriale Spalten mit "Label Encoder"..
– Lesen und laden Sie den codierten Datensatz.
– Machen Sie fehlende Datensätze wie unsere Testdaten.
– Haga registros que no falten como nuestros datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.....
– Unabhängige und abhängige Variablen trennen.

– Passen Sie unser logistisches Regressionsmodell an.
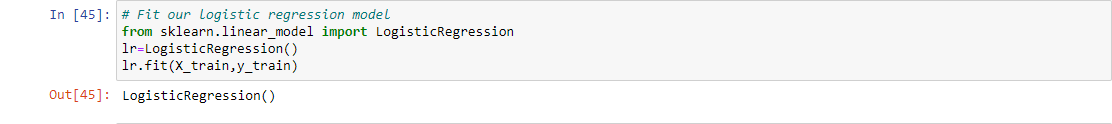
– Sagen Sie die Klasse der fehlenden Datensätze voraus.

Damit ist unser Implementierungsteil abgeschlossen!!
Abschließende Anmerkungen
Danke fürs Lesen!
Dieser Artikel stellt Ihnen verschiedene Möglichkeiten vor, um das Problem fehlender Werte für kategoriale Variablen anzugehen..
Wenn dir das gefallen hat und du mehr wissen möchtest, Besuchen Sie meine anderen Artikel zu Data Science und Machine Learning, indem Sie auf den Link klicken
Kontaktieren Sie mich gerne unter Linkedin, Email.
Alles was nicht erwähnt wurde oder du deine Gedanken teilen möchtest? Fühlen Sie sich frei, unten einen Kommentar zu hinterlassen und ich melde mich bei Ihnen.
Bis dann, zu Hause bleiben, Bleiben Sie sicher, um die Ausbreitung von zu verhindern COVID-19, Und lerne weiter!
Über den Autor
Chirag Goyal
Heutzutage, Ich studiere meinen Bachelor of Technology (B.Tech) in Informatik und Ingenieurwissenschaften von das Indian Institute of Technology, Jodhpur (IITJ). Ich freue mich sehr über maschinelles Lernen, das tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... und Künstliche Intelligenz.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





