
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Kredit: https://gifer.com/de/GxlE
Das 2 Die wichtigsten Fragen, die mir während der Arbeit an diesem Artikel in den Sinn kamen, waren „Warum schreibe ich diesen Artikel?“ & „Wie unterscheidet sich mein Artikel von anderen Artikeln?“ Gut, Die Kostenfunktion ist ein wichtiges Konzept in den Bereichen der Datenwissenschaft, aber während ich meinem Absolventen folgte, Ich habe festgestellt, dass die online verfügbaren Ressourcen zu allgemein sind und meine Bedürfnisse nicht vollständig abdecken.
Ich musste viele Artikel konsultieren und einige Videos auf YouTube anschauen, um mir ein Bild von den Kostenfunktionen zu machen. Infolge, Ich wollte die Funktionen sammeln „Dass“, „Wann“, „Wie“ Ja „Warum“ von Cost, die helfen können, dieses Thema klarer zu erklären. Ich hoffe, mein Artikel fungiert als One-Stop-Shop für Kostenfunktionen!!
Dummy-Guide zur Kostenfunktion 🤷♀️
VerlustfunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und...: se utiliza cuando nos referimos al error de un solo ejemplo de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.....
Kostenfunktion: wird verwendet, um einen Durchschnitt der Verlustfunktionen in einem vollständigen Trainingsdatensatz zu referenzieren.
Aber, * da * eine Kostenfunktion verwenden?
Warum zum Teufel brauchen wir eine Kostenfunktion? Betrachten Sie ein Szenario, in dem wir die Daten klassifizieren möchten. Angenommen, wir haben die Größen- und Gewichtsangaben einiger Hunde und Katzen. Lass uns diese verwenden 2 Merkmale, um sie richtig zu klassifizieren. Wenn wir diese Aufzeichnungen verfolgen, obtenemos el siguiente AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen....:
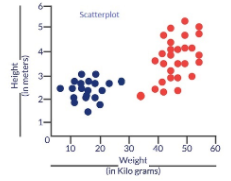
Feige 1: Streudiagramm für Größe und Gewicht verschiedener Katzen und Hunde
Die blauen Punkte sind Katzen und die roten Punkte sind Hunde. Hier sind einige Lösungen für das oben genannte Klassifizierungsproblem.
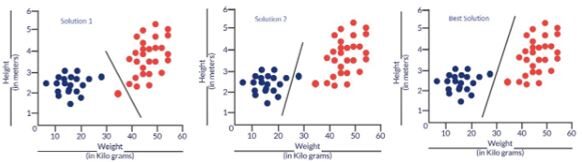
Feige: Wahrscheinliche Lösungen für unser Klassifizierungsproblem
Im Wesentlichen, alle drei Sichter haben eine sehr hohe Präzision, aber die dritte Lösung ist die beste, weil sie keine Punkte falsch klassifiziert. Der Grund, warum alle Punkte perfekt gereiht werden, ist, dass die Linie fast genau zwischen den beiden Gruppen liegt und keiner der beiden näher kommt.. Hier kommt das Konzept der Kostenfunktion ins Spiel.. Die Kostenfunktion hilft uns, die optimale Lösung zu finden. Die Kostenfunktion ist die Technik der Bewertung „die Leistung unseres Algorithmus / Modell“.
Nimmt sowohl die vom Modell erwarteten als auch die tatsächlichen Ergebnisse, und berechnen Sie, wie falsch das Modell in seiner Vorhersage war. Ergibt eine höhere Zahl, wenn unsere Vorhersagen stark von den tatsächlichen Werten abweichen. Während wir unser Modell anpassen, um die Vorhersagen zu verbessern, die Kostenfunktion dient als Indikator dafür, wie sich das Modell verbessert hat. Dies ist im Wesentlichen ein Optimierungsproblem. Optimierungsstrategien zielen immer auf „Minimierung der Kostenfunktion“.
Arten von Kostenfunktionen
Beim maschinellen Lernen gibt es viele Kostenfunktionen und jede hat ihre Anwendungsfälle, je nachdem, ob es sich um ein Regressions- oder Klassifikationsproblem handelt..
- Regressionskostenfunktion
- Kostenfunktionen für binäre Klassifikation
- Kostenfunktionen für mehrere Klassenklassifizierungen
1. Regressionskostenfunktion:
Regressionsmodelle versuchen einen kontinuierlichen Wert vorherzusagen, zum Beispiel, das Gehalt eines Mitarbeiters, der preis eines autos, einen Kredit vorhersagen, etc. Eine im Regressionsproblem verwendete Kostenfunktion heißt „Regressionskostenfunktion“. Sie werden aus dem Fehler basierend auf der Entfernung wie folgt berechnet:
Fehler = y-y ‚
Woher,
Ja – Echter Eingang
Ja ‚- Geplante Abreise
Die am häufigsten verwendeten Regressionskostenfunktionen sind unten aufgeführt,
1.1 Mittlerer Fehler (MICH)
- In dieser Kostenfunktion, der Fehler wird für alle Trainingsdaten berechnet und dann der Mittelwert all dieser Fehler abgeleitet.
- Die Berechnung des Durchschnitts der Fehler ist der einfachste und intuitivste Weg, der möglich ist.
- Fehler können sowohl negativ als auch positiv sein. Deswegen, können sich während der Summe stornieren, was einen mittleren Fehler von null für das Modell ergibt.
- Deswegen, Dies ist keine empfohlene Kostenfunktion, aber es legt die Grundlage für andere Kostenfunktionen von Regressionsmodellen.
1.2 Quadratischer Fehler (MSE)
- Dies verbessert den Nachteil, den wir im überdurchschnittlichen Fehler gefunden haben. Hier wird ein Quadrat der Differenz zwischen dem tatsächlichen und dem vorhergesagten Wert berechnet, um jegliche Möglichkeit eines negativen Fehlers zu vermeiden.
- Es wird als Durchschnitt der Summe der quadrierten Differenzen zwischen den Vorhersagen und den tatsächlichen Beobachtungen gemessen.
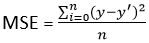
MSE = (Summe der quadrierten Fehler) / n
- Auch bekannt als L2-Verlust.
- In MSE, da jeder Fehler quadriert wird, hilft, selbst kleine Abweichungen in der Vorhersage im Vergleich zu MAE zu bestrafen. Aber wenn unser Datensatz Ausreißer hat, die zu größeren Vorhersagefehlern beitragen, Wenn Sie diesen Fehler dann noch quadrieren, wird der Fehler um ein Vielfaches größer und führt auch zu einem höheren MSE-Fehler.
- Deswegen, wir können sagen, dass es weniger robust gegenüber Ausreißern ist.
1.3 Mittlerer absoluter Fehler (VIEL)
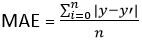
EINFACH (Summe der absoluten Fehler) / n
2. Kostenfunktionen für Klassifikationsprobleme
Die in den Klassifikationsproblemen verwendeten Kostenfunktionen unterscheiden sich von denen, die wir im Regressionsproblem verwenden.. Eine häufig zur Klassifizierung verwendete Verlustfunktion ist der Kreuzentropieverlust. Lassen Sie uns die Kreuzentropie anhand eines kleinen Beispiels verstehen. Nehmen wir an, wir haben ein Klassifikationsproblem von 3 Klassen wie folgt.
Klasse (Orange, Apfel, Tomate)
Das Modell des maschinellen Lernens wird eine Wahrscheinlichkeitsverteilung dieser Werte liefern 3 Klassen als Ausgabe für gegebene Eingabedaten. Die Klasse mit der höchsten Wahrscheinlichkeit gilt als Gewinnklasse für die Vorhersage.
Ausgabe = [P(Orange),P(Apfel),P(Tomate)]
Die tatsächliche Wahrscheinlichkeitsverteilung für jede Klasse ist unten gezeigt.
Orange = [1,0,0]
Apfel = [0,1,0]
Tomate = [0,0,1]
Wenn während der Trainingsphase, die Eingabeklasse ist Tomate, die vorhergesagte Wahrscheinlichkeitsverteilung sollte zur tatsächlichen Wahrscheinlichkeitsverteilung von Tomato tendieren. Wenn die vorhergesagte Wahrscheinlichkeitsverteilung der realen nicht näher kommt, das Modell muss sein Gewicht anpassen. Hier wird die Kreuzentropie zu einem Werkzeug, um zu berechnen, wie weit die vorhergesagte Wahrscheinlichkeitsverteilung von der tatsächlichen entfernt ist.. Mit anderen Worten, Kreuzentropie kann man sich als eine Möglichkeit vorstellen, den Abstand zwischen zwei Wahrscheinlichkeitsverteilungen zu messen. Das folgende Bild veranschaulicht die Intuition hinter der Kreuzentropie:
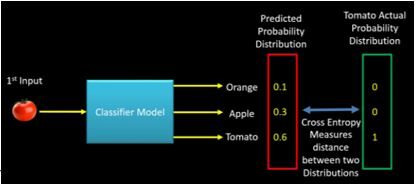
ABBILDUNG"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... 3: Intuition hinter der Croos-Entropie (Kredit – Maschinenlernwissen.ai)
Dies war nur eine Intuition hinter der Kreuzentropie. Es hat seinen Ursprung in der Informationstheorie. Jetzt, mit diesem Verständnis von Kreuzentropie, Schauen wir uns nun die Klassifizierungskostenfunktionen an.
2.1 Kostenfunktionen für mehrere Klassenklassifizierungen
Diese Kostenfunktion wird bei Klassifizierungsproblemen verwendet, bei denen mehrere Klassen vorhanden sind und die Eingabedaten zu einer einzigen Klasse gehören. Lassen Sie uns nun verstehen, wie die Kreuzentropie berechnet wird. Supongamos que el modelo da la distribución de probabilidad como se muestra a continuación para ‚n‘ Klassen und für bestimmte Eingabedaten D.
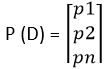
Und die tatsächliche oder Soll-Wahrscheinlichkeitsverteilung der Daten D ist
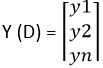
Später, die Kreuzentropie für dieses bestimmte Datum D wird berechnet als
Verlust der Kreuzentropie (Ja, P) = – JaT Anmeldung (P)
= – (Ja1 Protokoll (P1) + Ja2 Protokoll (P2) + …… undNorden Protokoll (PNorden))
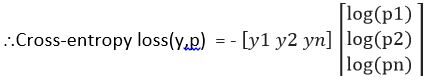
Definieren wir nun die Kostenfunktion anhand des vorherigen Beispiels (Siehe Kreuzentropie-Bild -Fig3),
P (Tomate) = [0.1, 0.3, 0.6]
Ja (Tomate) = [0, 0, 1]
Kreuzentropie (Ja, P) = – (0 * Protokoll (0.1) + 0 * Protokoll (0.3) + 1 * Protokoll (0.6)) = 0.51
Die obige Formel misst nur die Kreuzentropie für eine einzelne Beobachtung oder Eingabedaten. Der Fehler bei der Klassifikation des vollständigen Modells ergibt sich aus der kategorialen Kreuzentropie, was nichts anderes ist als der Mittelwert der Kreuzentropie für alle N Trainingsdaten.
Kategoriale Kreuzentropie = (Kreuzsumme der Entropie für N Daten) / n
2.2 Binäre Kreuzentropie-Kostenfunktion
Die binäre Kreuzentropie ist ein Sonderfall der kategorialen Kreuzentropie, wenn es nur eine Ausgabe gibt, die einfach einen binären Wert von annimmt 0 Ö 1 um die negative bzw. positive Klasse zu bezeichnen. Zum Beispiel, Einteilung zwischen Katze und Hund.
Supongamos que la salida real se denota por una sola VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Ja, dann kann die Kreuzentropie für ein bestimmtes Datum D wie folgt vereinfacht werden:
Kreuzentropie (D) = – Ja * Protokoll (P) wenn y = 1
Kreuzentropie (D) = – (1-Ja) * Protokoll (1-P) wenn y = 0
Der Fehler in der binären Klassifikation für das vollständige Modell ergibt sich aus der binären Kreuzentropie, was nichts anderes ist als der Mittelwert der Kreuzentropie für alle N Trainingsdaten.
Binäre Kreuzentropie = (Kreuzsumme der Entropie für N Daten) / n
Fazit
Ich hoffe, dieser Artikel war hilfreich für Sie!! Lass mich wissen was du denkst, vor allem wenn es Verbesserungsvorschläge gibt. Sie können sich mit mir auf LinkedIn verbinden: https://www.linkedin.com/in/saily-shah/ und hier ist mein GitHub-Profil: https://github.com/sailyshah
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





