
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Warnung: Dieser Artikel ist für absolute Anfänger, Ich schätze, du bist gerade mit einigen High-School-Mathematik-Kenntnissen und einigen grundlegenden Programmierkenntnissen in das Gebiet des maschinellen Lernens eingestiegen, aber das ist nicht mal zwingend.
Einführung
Lineare Regression ist der grundlegendste überwachte maschinelle Lernalgorithmus. Überwachen in dem Sinne, dass der Algorithmus Ihre Frage basierend auf markierten Daten beantworten kann, die Sie dem Algorithmus zuführen. Die Antwort wäre, wie man die Hauspreise vorhersagt, Klassifizieren Sie Hunde und Katzen. Hier werden wir über eine Regressionsaufgabe mit linearer Regression sprechen. Schließlich, Wir werden die Hauspreise basierend auf der Fläche des Hauses vorhersagen.
Ich möchte dich nicht langweilen, indem ich all die Wörter des Machine-Learning-Jargons wegwerfe, anfangs, Lassen Sie mich mit der grundlegendsten linearen Gleichung beginnen. (y = mx + B) das kennen wir alle aus unserer Schulzeit.
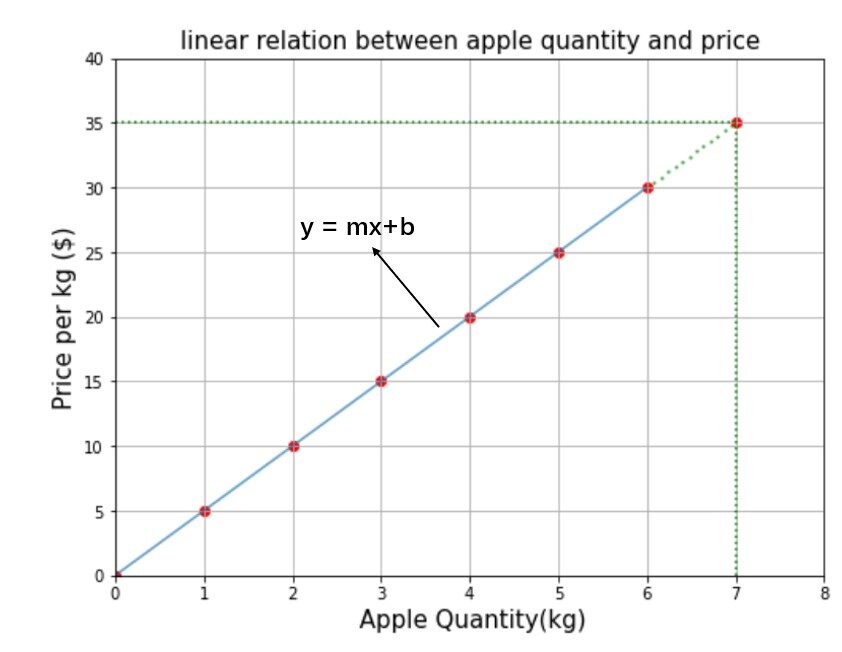
Das Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... anterior muestra la relación entre la cantidad de manzana y el precio de costo. Wie viel muss man bezahlen 7 kg Äpfel? Ich weiß, es ist einfach. Und 1 kg Kosten 5 $, dann 7 kg kosten 7 * 5 = 35 $ oder es wird einfach eine senkrechte Linie von dem Punkt gezogen 7 entlang der y-Achse, bis sie die lineare Gleichung berührt und der entsprechende Wert auf der y-Achse die angezeigte Antwort ist. durch die grüne gestrichelte Linie in der Grafik. Aber wir werden mit der Formel einer linearen Gleichung lösen.

Jetzt, wenn ich den preis von finden muss 9,5 kg Apfel, nach unserem Modell mx + B = 5 * 9.5 + 0 = $ 47.5 ist die Antwort. In diesem Stadium, das hast du vielleicht verstanden Metro Ja B sind die Hauptbestandteile der linearen Gleichung oder mit anderen Worten Metro Ja B Sie heißen ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.....
Leider, Dies ist weder das Problem des maschinellen Lernens noch ist die lineare Gleichung ein Vorhersagealgorithmus, aber glücklicherweise erzeugt die lineare Regression das Ergebnis auf die gleiche Weise wie die lineare Gleichung. Der Hauptzweck des linearen Regressionsalgorithmus besteht darin, den Wert von zu finden Metro Ja B die zum Modell passen und danach Metro Ja b verwendet werden um das Ergebnis der gegebenen Eingabedaten vorherzusagen.
Hauspreise vorhersagen
Jetzt werden wir etwas tiefer in die Lösung des Regressionsproblems eintauchen. Schauen Sie sich die Datenbeispiele an oder auch benannt als ejemplos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... in der Abbildung unten angegeben.
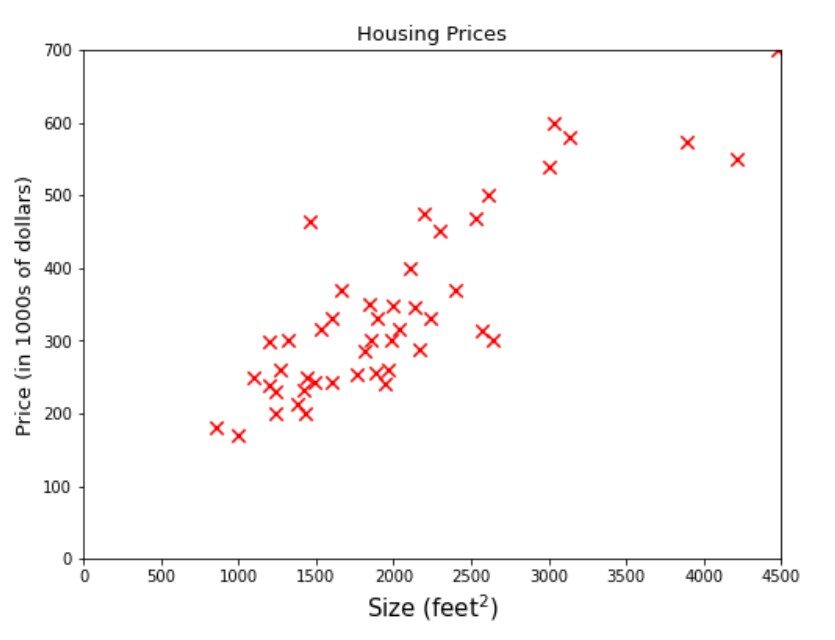
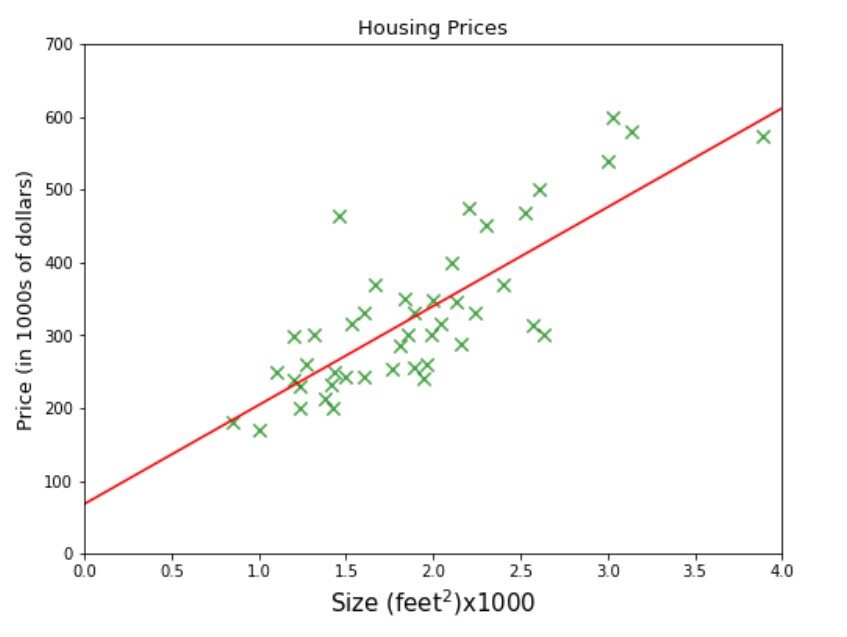
Der Name eines Unternehmens A B C bietet Ihnen eine Daten über ihn Hausgröße Ja sein Preis. Das Unternehmen benötigt sie zur Verfügung stellen Modell für maschinelles Lernen das kann Hauspreise vorhersagen für jedes gegebene Größe. Sagen wir, was wäre der beste Schätzpreis für eine Fläche von 3000 Quadratmeter. Wenn du an denkst eine Zeile umbrechen irgendwo zwischen dem Datensatz und ziehen Sie eine vertikale Linie von 3000 auf der x-Achse bis er die Linie berührt und dann der entsprechende Wert auf der y-Achse, nämlich 470 wäre die antwort, dann bist du auf dem richtigen weg, wird in der folgenden Abbildung durch die grüne gestrichelte Linie dargestellt.
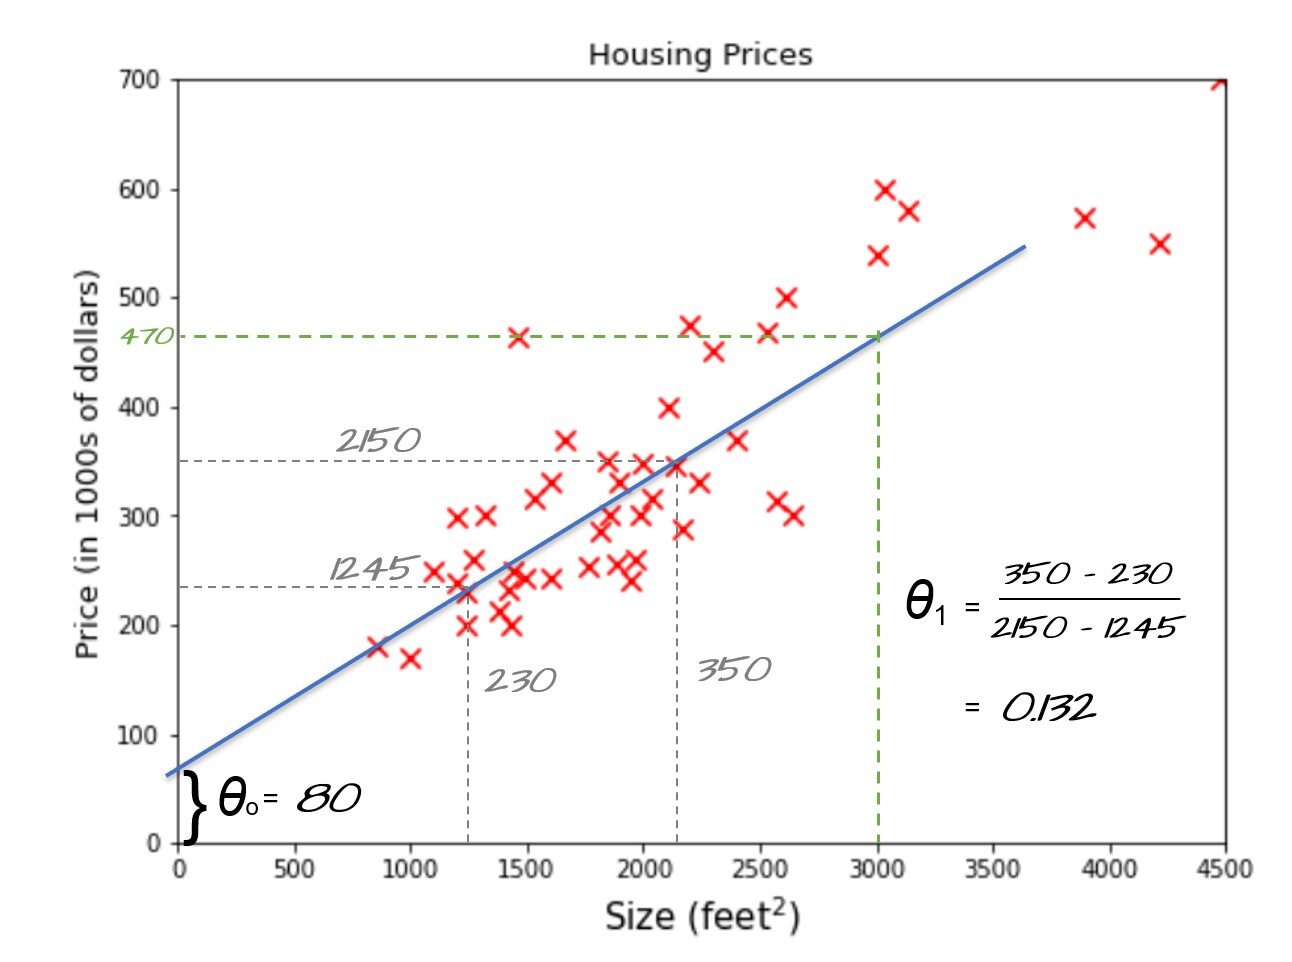
Machen wir es anders, wenn wir die Geradengleichung y = mx . finden könnten + b, die wir verwenden, um die durch die blaue schräge Linie dargestellten Daten anzupassen, dann können wir leicht das Modell finden, das die Hauspreise für eine bestimmte Gegend vorhersagen kann. . Basierend auf dem Fachjargon für maschinelles Lernen y = mx + B Es heißt auch Hypothesenfunktion wo myb kann vertreten werden durch theta0 bzw. theta1. theta0 wird auch genannt Voreingenommenheit und theta1, theta2, .. namens Pesos.
Siehe die blaue Linie im Bild oben. Bei der Entnahme von zwei Proben, die sich berühren oder sehr nahe an der Linie liegen, wir können die finden theta1 (steht aus) = 0.132 Ja Null Theta = 80 wie das bild zeigt. Jetzt können wir unsere Hypothesenfunktion verwenden, um den Hauspreis für eine Größe von . vorherzusagen 3000 Quadratmeter, nämlich. 80 + 3000 * 0,132 = 476. $ 476,000 könnte der beste Schätzpreis für ein Haus von sein 3000 Quadratmeter und dies könnte eine vernünftige Möglichkeit sein, ein Machine-Learning-Modell vorzubereiten, wenn Sie gerade fertig sind 50 Proben und mit nur eine Eigenschaft (Größe).
Aber der Datensatz der realen Welt könnte in der Größenordnung von Tausenden oder sogar Millionen liegen und die Anzahl der Funktionen kann variieren. (5-100) oder sogar in Tausenden. Zu diesem Zeitpunkt wird unsere Intuition nicht nützlich sein, um Tausende von Parametern nur durch Betrachten eines Datensatzes zu finden, Deshalb brauchen wir einen maschinellen Lernalgorithmus, um eine so komplexe Berechnung durchzuführen. Eine Tasse Kaffee trinken, erfrischen Sie sich und kommen Sie wieder zurück, denn von nun an werden Sie verstehen, wie der Algorithmus funktioniert und Sie werden mit vielen neuen Terminologien vertraut gemacht. Bereite dich vor!!
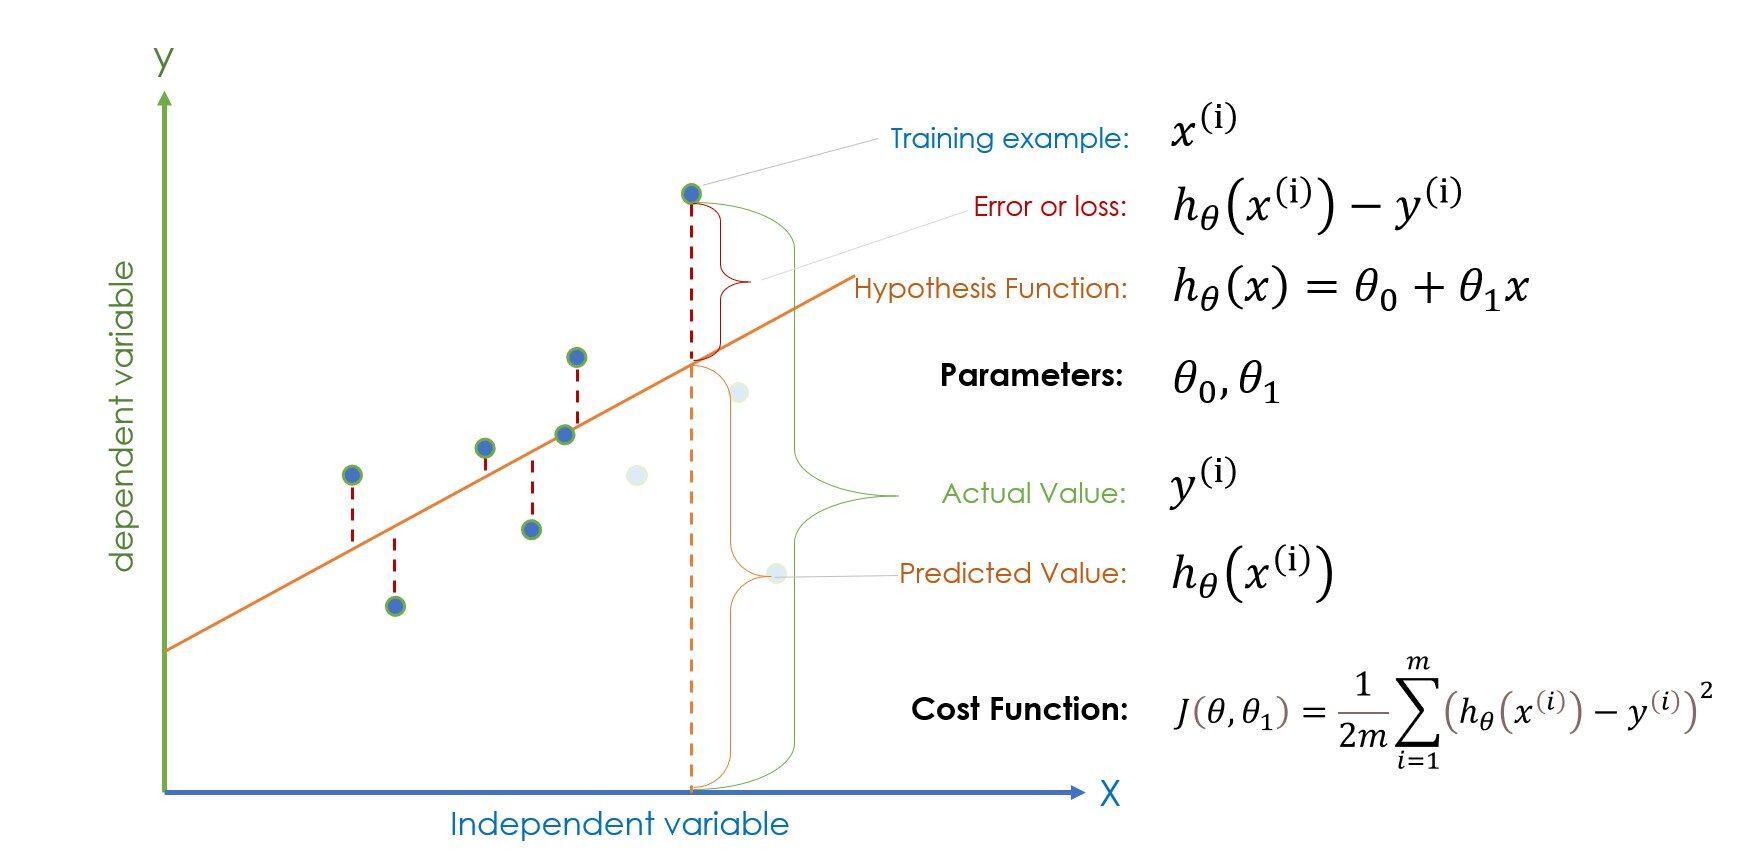
Notiz: (ich) in der Gleichung steht für das i-te Trainingsbeispiel, nicht die Macht.
Wenn Ihnen die in der obigen Abbildung angegebenen Terminologien außerirdisch erscheinen, Nehmen Sie sich ein paar Minuten Zeit, um sich vertraut zu machen und versuchen Sie, eine Verbindung zu jedem Begriff zu finden. Wenn du es bis zu einem gewissen Grad weißt, Lass uns weitermachen. Sobald die Parameterwerte, nämlich Voreingenommenheit Ja theta1 zufällig initialisieren, die Hypothesenfunktion ist bereit für die Vorhersage, und dann die Error (|vorhergesagter Wert – aktueller Wert|) wird berechnet, um zu überprüfen, ob der zufällig initialisierte Parameter die richtige Vorhersage liefert oder nicht.
Wenn der Fehler zu hoch ist, dann aktualisiert der Algorithmus die Parameter mit einem neuen Wert, wenn der fehler wieder hoch ist, aktualisiert die Parameter erneut mit dem neuen Wert. Der Algorithmus setzt diesen Prozess fort, bis der Fehler minimiert ist. Zu Fehler minimieren wir haben eine spezielle Funktion namens Gradientenabstieg SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... aber vorher, lass uns verstehen was Kostenfunktion es ist und wie es funktioniert?
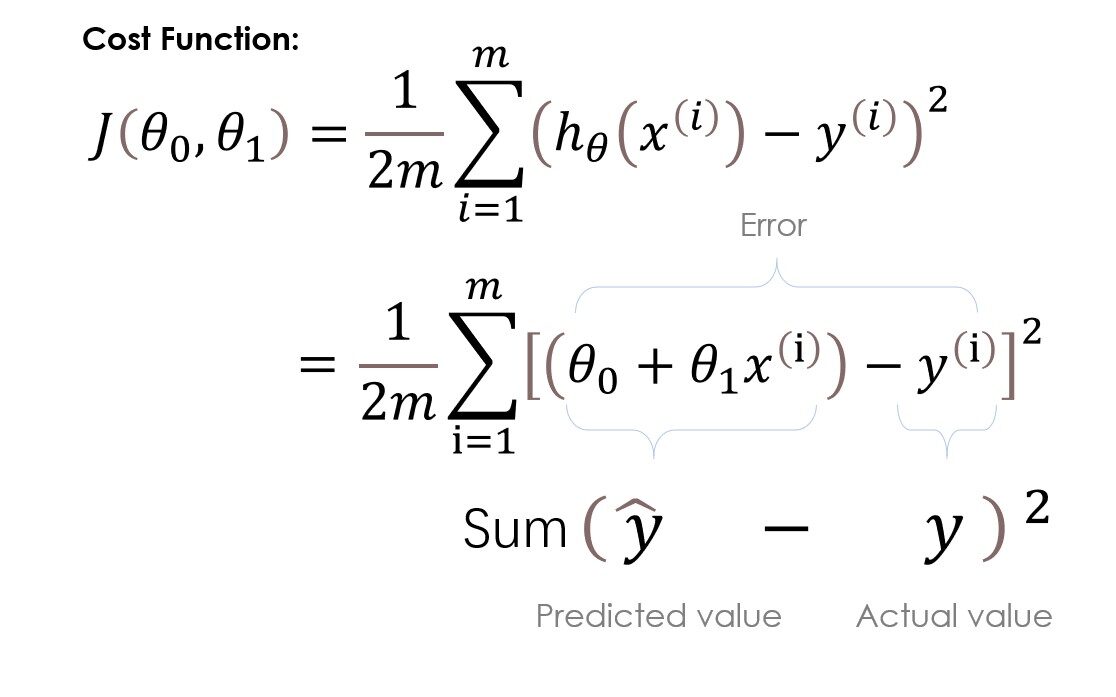
Hier, in der Kostenfunktion, Wir versuchen, das Quadrat der zu finden Unterschiede zwischen dem vorhergesagten Wert und dem tatsächlichen Wert jedes Trainingsbeispiels und addieren Sie dann alle Unterschiede zusammen oder mit anderen Worten, wir finden die Fehlerquadrat von jedem Trainingsbeispiel und fassen dann alle Fehler zusammen. Die Ausgabe, die wir erhalten, ist einfach der Mittelwert quadrierter Fehler eines bestimmten Parametersatzes. Okay, keine Wörter mehr, machen wir die Rechnung. Um die Berechnung zu vereinfachen, wir verwenden nur einen Parameter theta1 und ein sehr einfacher Datensatz.
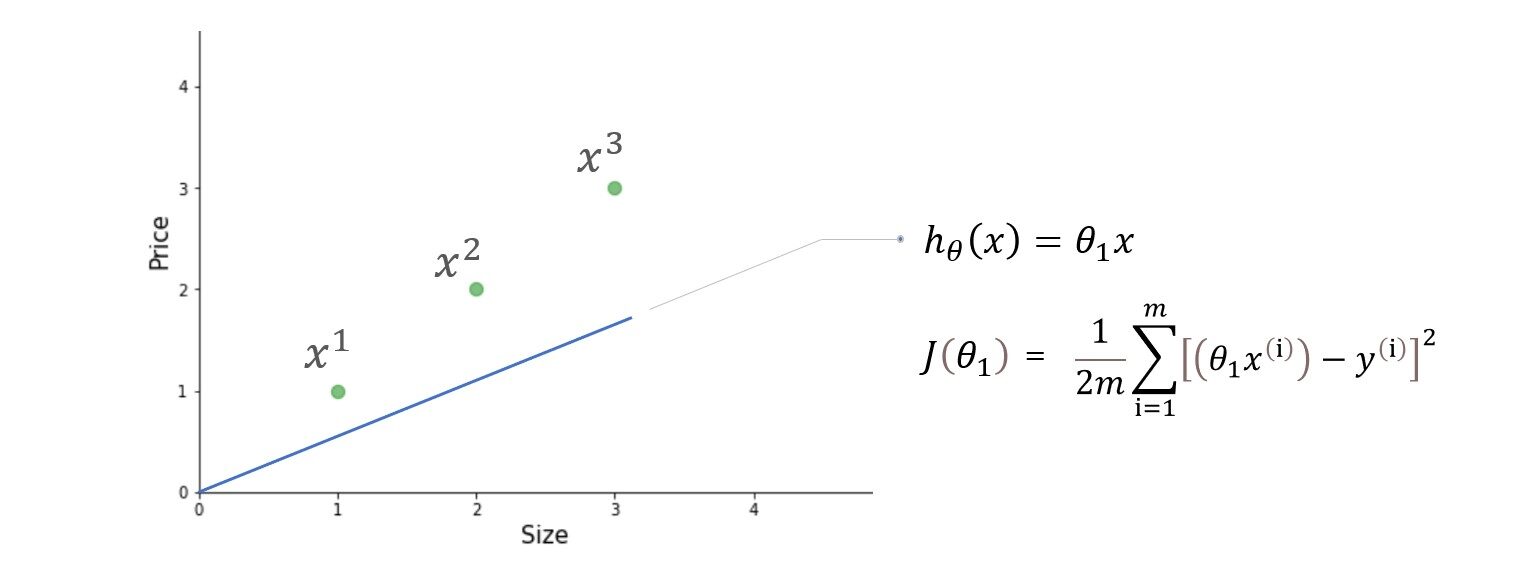
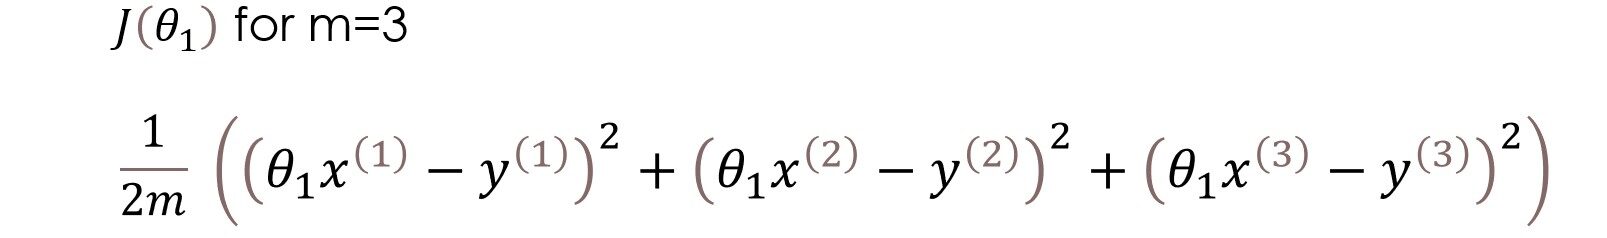
Wir haben drei Trainingsbeispiele (X1 = 1, y1 = 1), (X2 = 2, y2 = 2) Ja (X3 = 3, y3 = 3). die Abbildung links ist die Hypothesenfunktion und die Abbildung rechts ist die Kostenfunktion, die für verschiedene Werte des Parameters grafisch dargestellt ist.
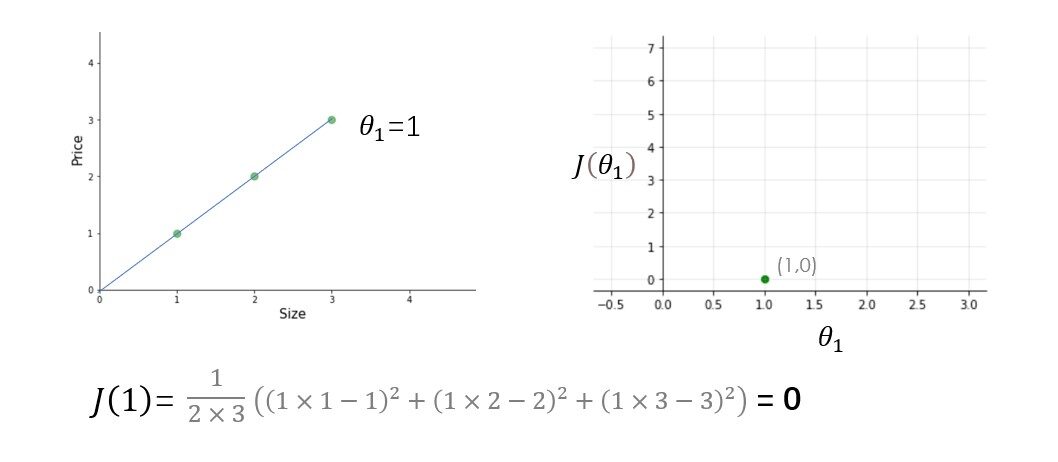
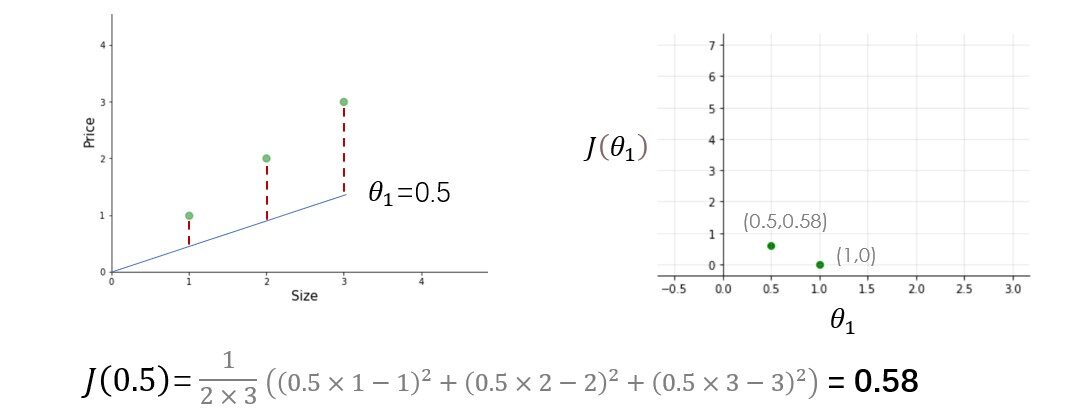
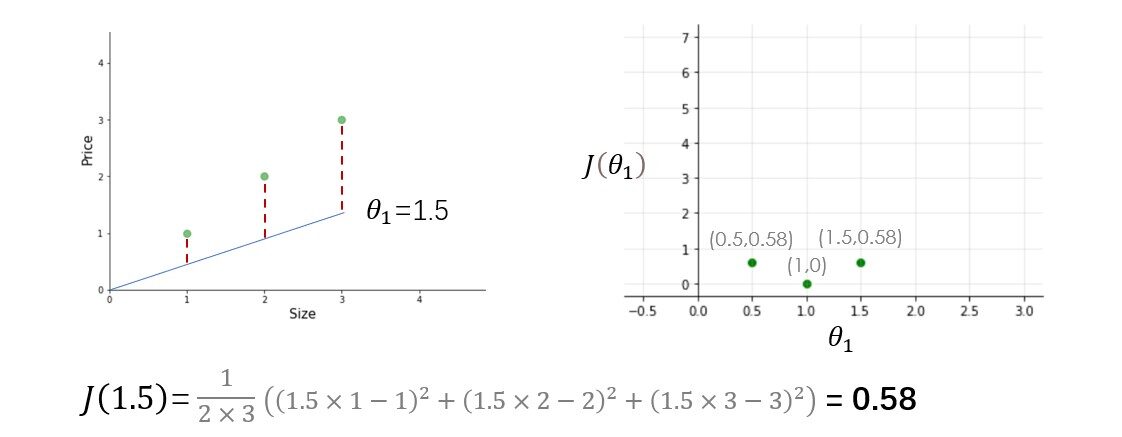
Probieren Sie andere Werte von theta1 selbst aus und berechnen Sie die Kosten für jeden Wert von theta1. Sobald ich all diese Punkte zeichne, die Kostenfunktion sieht wie eine schüsselförmige Kurve aus, wie in der Abbildung unten gezeigt.
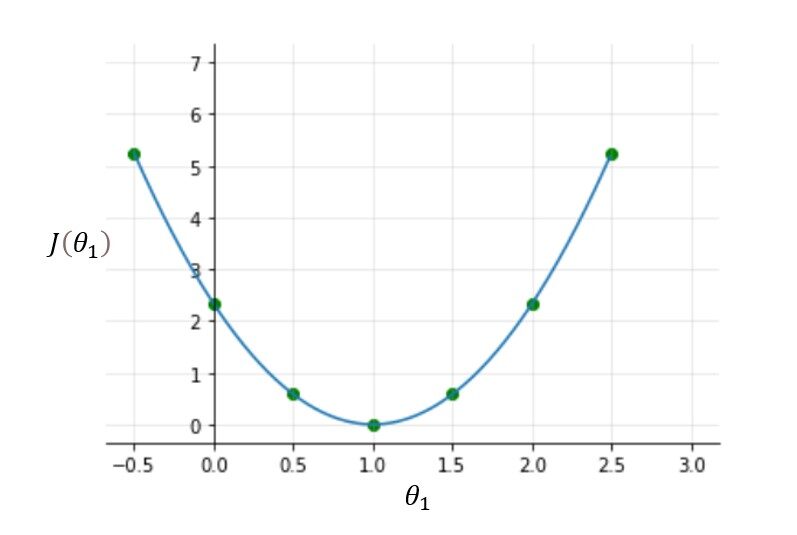
Aus der Abbildung und der Berechnung, es ist klar, dass die Kostenfunktion bei theta1 = . minimal ist 1 oder am unteren Rand der schüsselförmigen Kurve. Der Zweck all dieser harten Arbeit besteht nicht darin, den Mindestwert der Kostenfunktion zu berechnen, Wir haben einen besseren Weg, dies zu tun, stattdessen, wir versuchen das zu verstehen Beziehung Zwischen Parameter, Hypothesenfunktion, Ja Kostenfunktion. Stellen Sie sicher, dass Sie alle diese Konzepte verstanden haben, bevor Sie fortfahren..
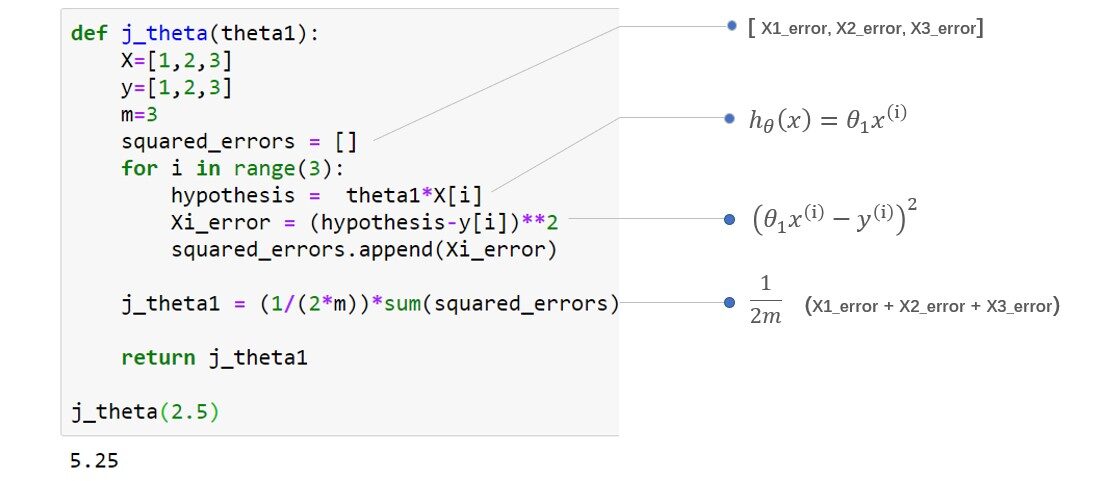
Kodierungskostenfunktion:
Gradientenabstieg:
Warum brauchen wir einen Gradientenabstieg?
- Demnächst um die Kostenfunktion zu minimieren, Aber wie? Wir werden sehen
Die Kostenfunktion funktioniert nur, wenn Sie die Parameterwerte kennen. Im obigen Beispielbeispiel, Wir wählen den Wert der Parameter jedes Mal manuell aus, aber während der algorithmischen Berechnung, sobald die Parameterwerte zufällig initialisiert werden, Es ist der Abstieg des Gradienten, der entscheiden muss, welche Parameter. Wert, der in der nächsten Iteration gewählt werden soll, um den Fehler zu minimieren, Es ist der Abstieg des Gradienten, der entscheidet, wie stark die Werte der Parameter erhöht oder verringert werden.
Analogie: Wie funktioniert Gradient Descent?
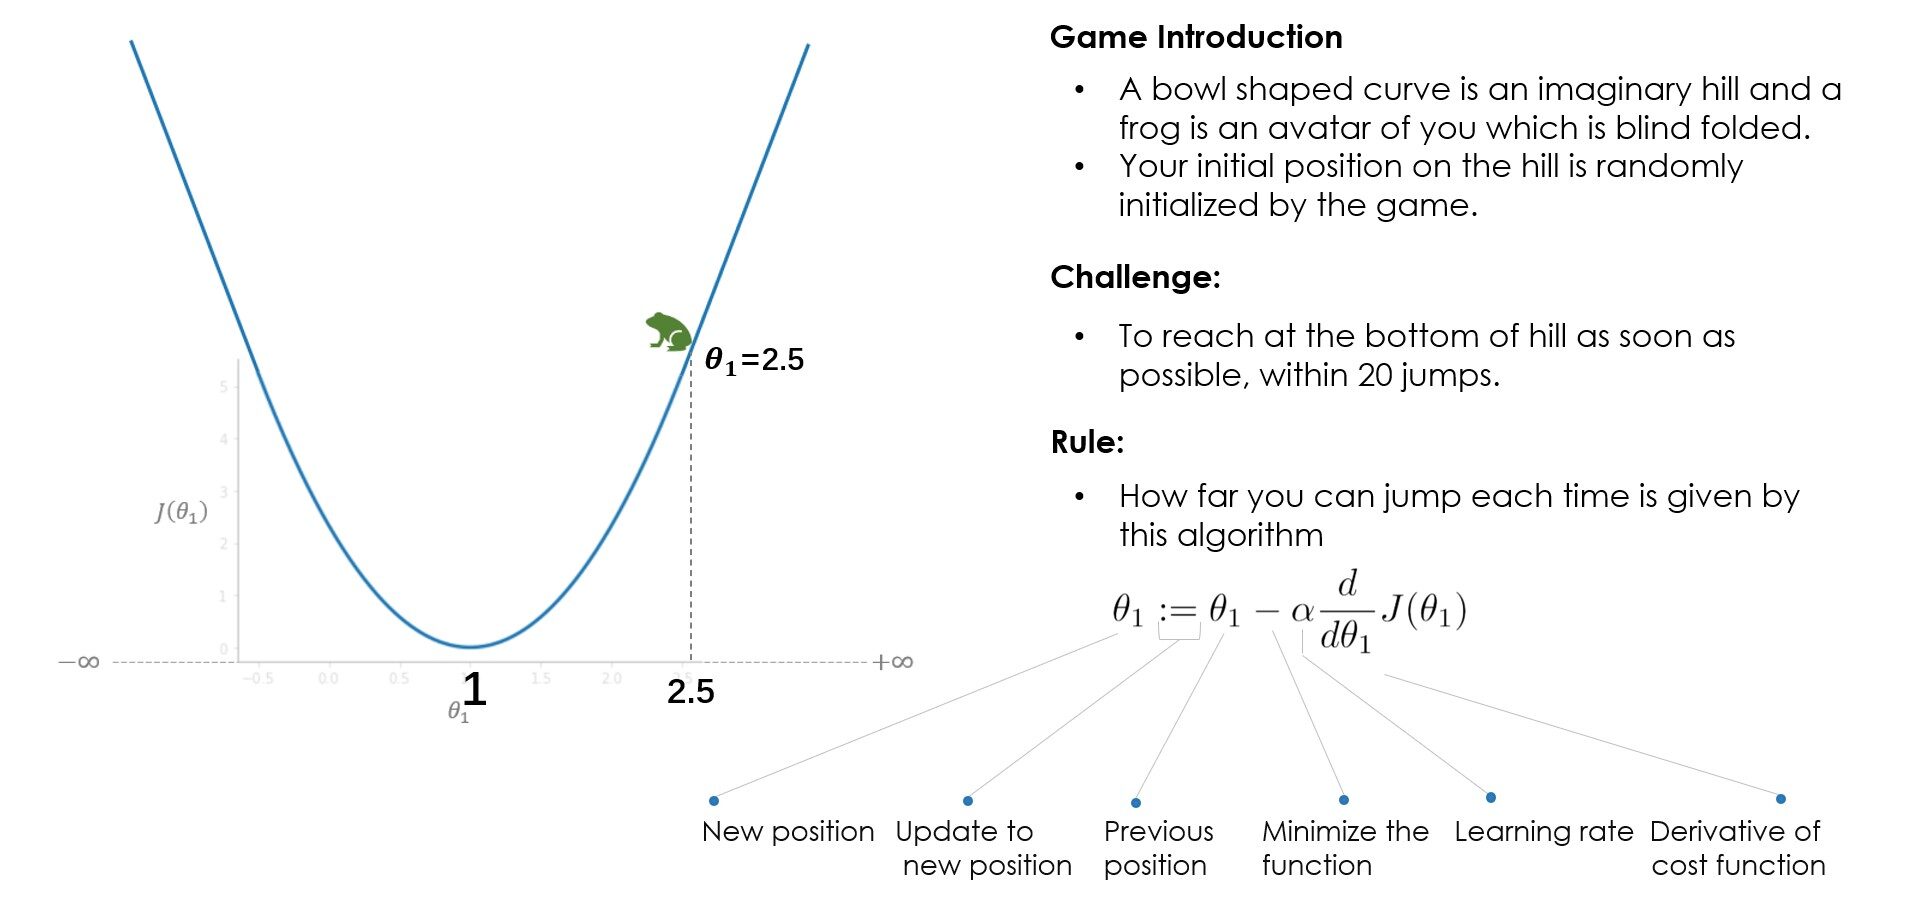
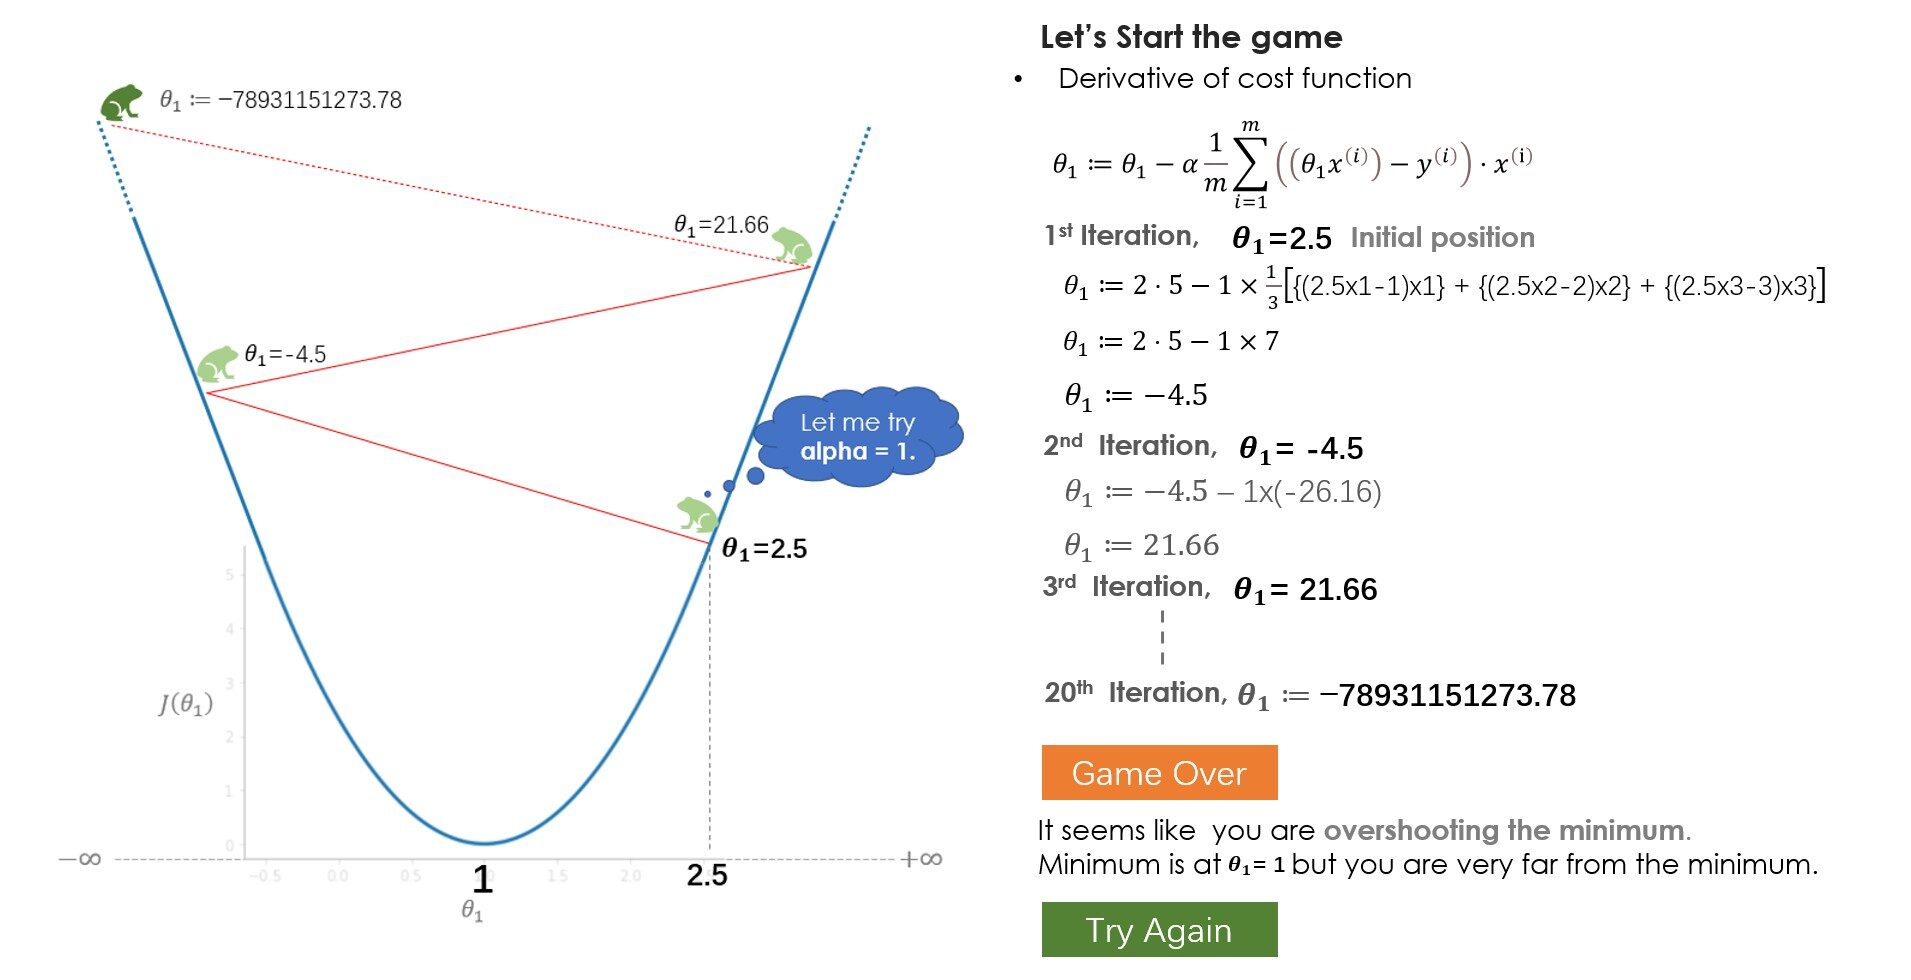
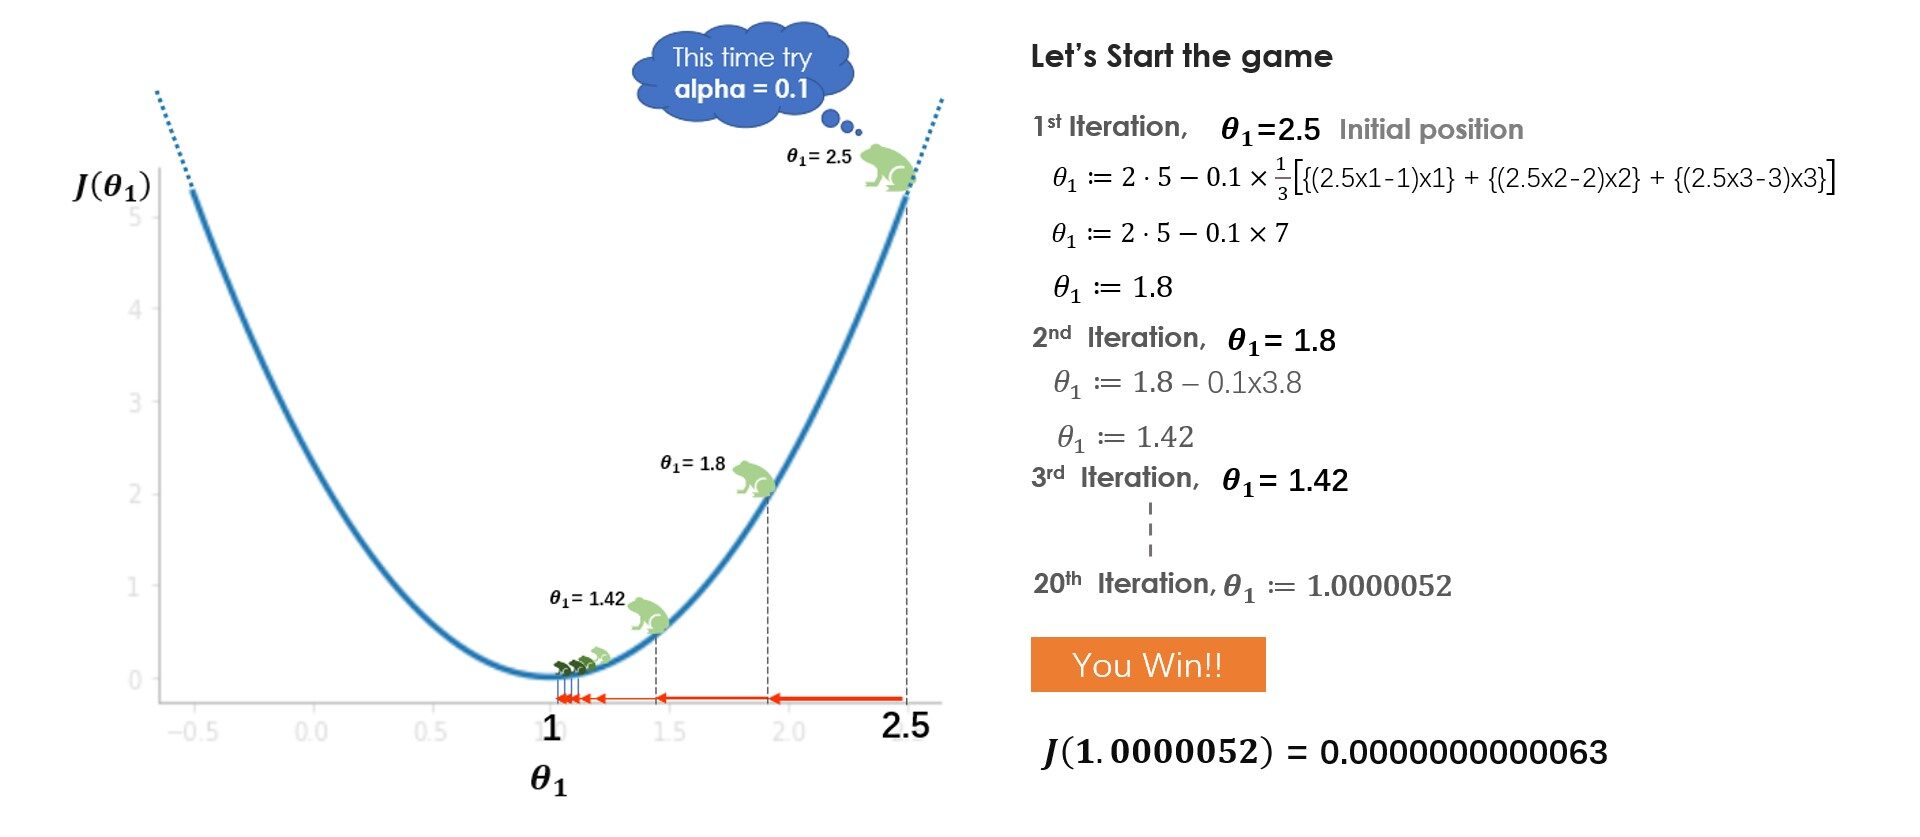
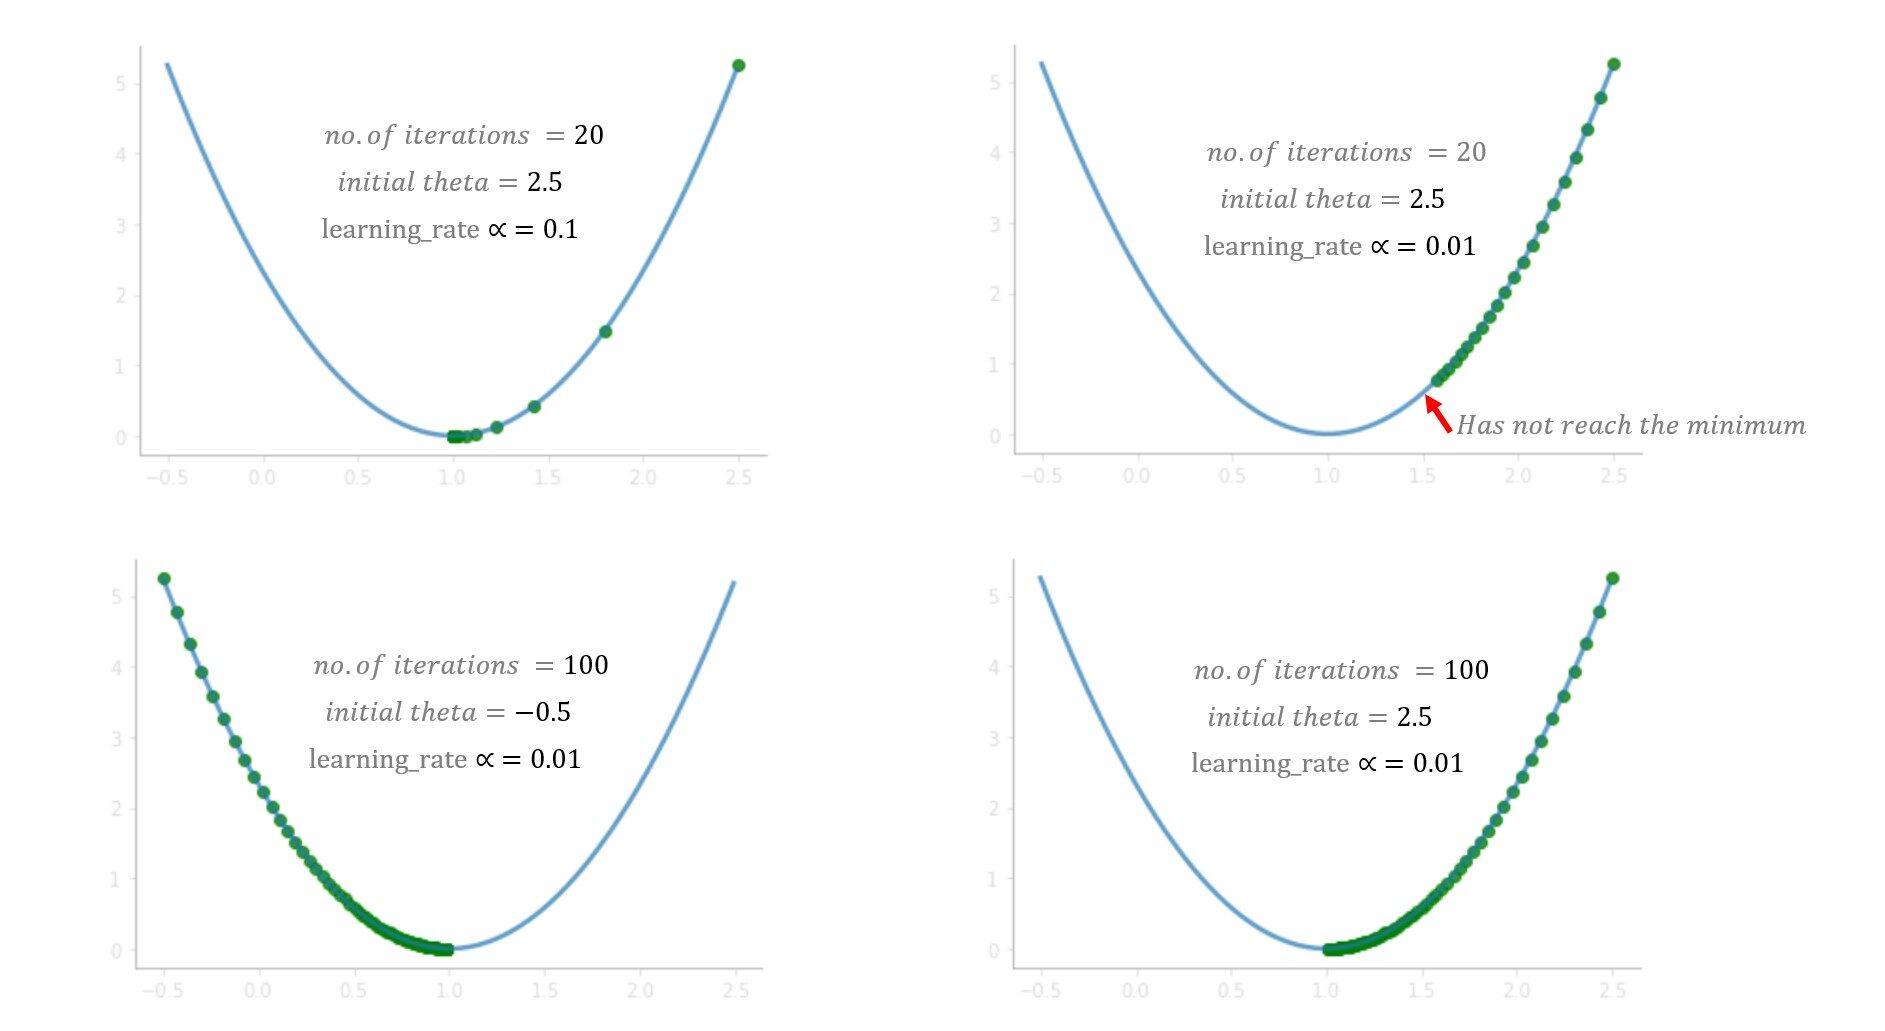
Was hast du aus dem Spiel gelernt? Am Anfang, Sie versuchen eine Lernrate (alfa) = 1 aber du erreichst das Minimum nicht, weil die größten Schritte das Minimum überschreiten. Im nächsten Spiel, du versuchst es mit alpha = 0.1, und dieses Mal bist du ganz sicher auf den Grund gekommen. Was wäre, wenn Sie Alpha versucht hätten = 0.01? Gut, dann, du wirst allmählich nach unten gehen, aber du wirst den Boden nicht erreichen, 20 Sprünge reichen nicht aus, um mit alpha = . nach unten zu kommen 0.01, 100 Sprünge könnten reichen. Beim Lösen eines realen Problems, normalerweise sollte ein Alpha zwischen 0,01–0,1 gut funktionieren, aber es variiert mit der Anzahl der Iterationen, die der Algorithmus benötigt, einige probleme können erfordern 100 oder auch 1000 Iterationen.
Basierend auf diesen Faktoren, Sie können verschiedene Alpha-Werte ausprobieren. Obwohl die Anpassung des Alpha-Werts eine der wichtigen Aufgaben ist, um den Algorithmus zu verstehen, Ich schlage vor, Sie sehen sich andere Teile des Algorithmus sowie die abgeleiteten Teile an, das Minuszeichen, Parameter aktualisieren und die Rollen Ihrer Mitarbeiter verstehen.
Codierung des Gradientenabstiegs
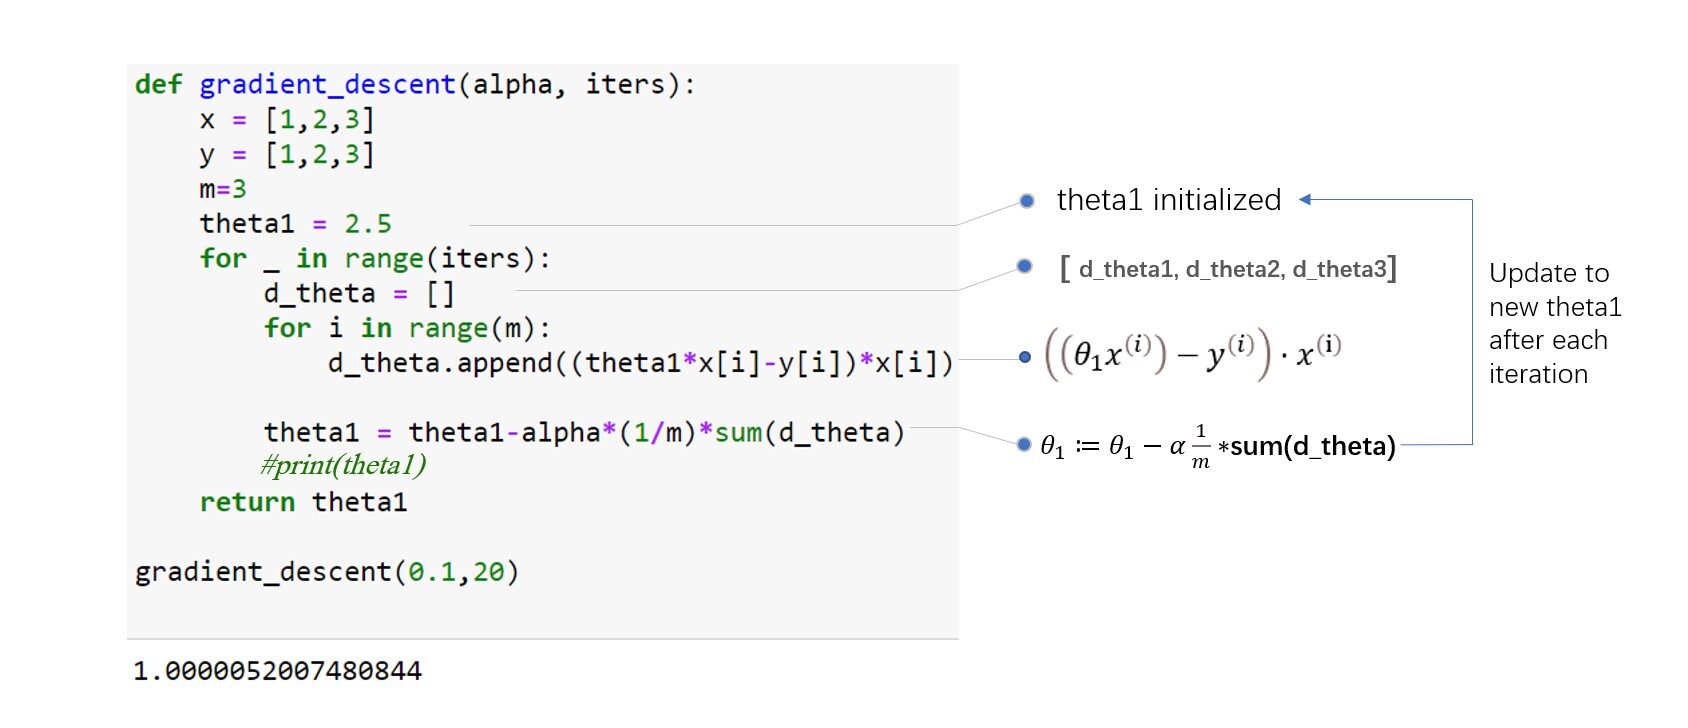
Bis jetzt, wir verwenden nur einen einzigen Parameter, um die Kostenfunktion und die Algorithmen zu berechnen. Wie sieht die Kostenfunktion aus und wie funktioniert der Algorithmus, wenn wir zwei oder mehr Parameter haben? Siehe die Abbildung unten für ein intuitives Verständnis. Stellen Sie sich vor, Sie wären irgendwo oben auf dem Berg und kämpfen mit verbundenen Augen den Fuß des Berges hinunter..
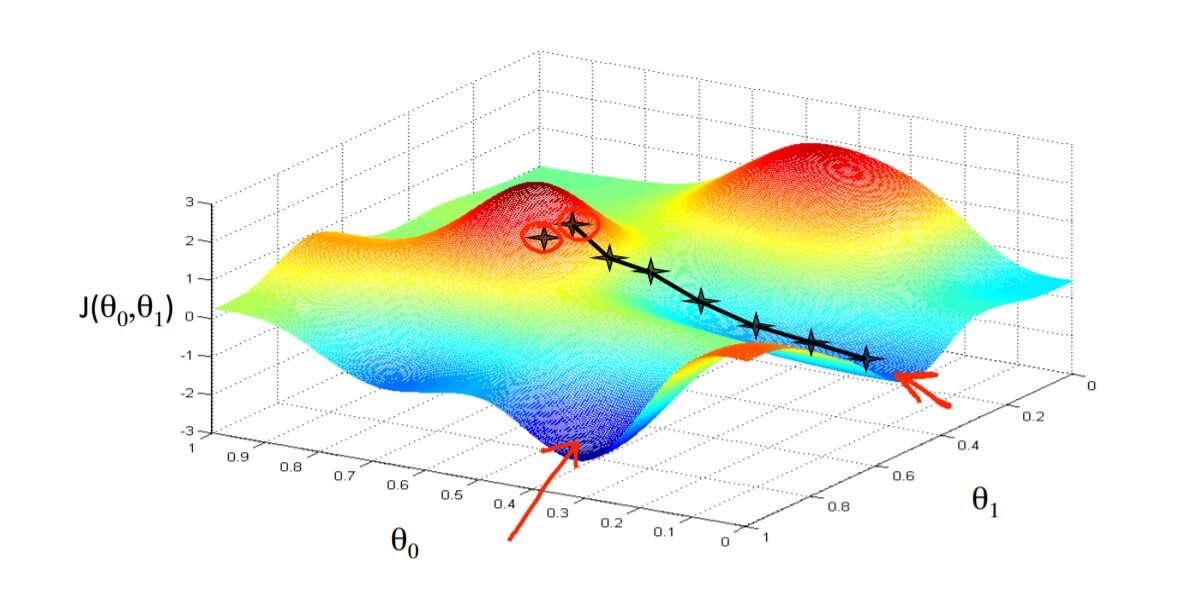
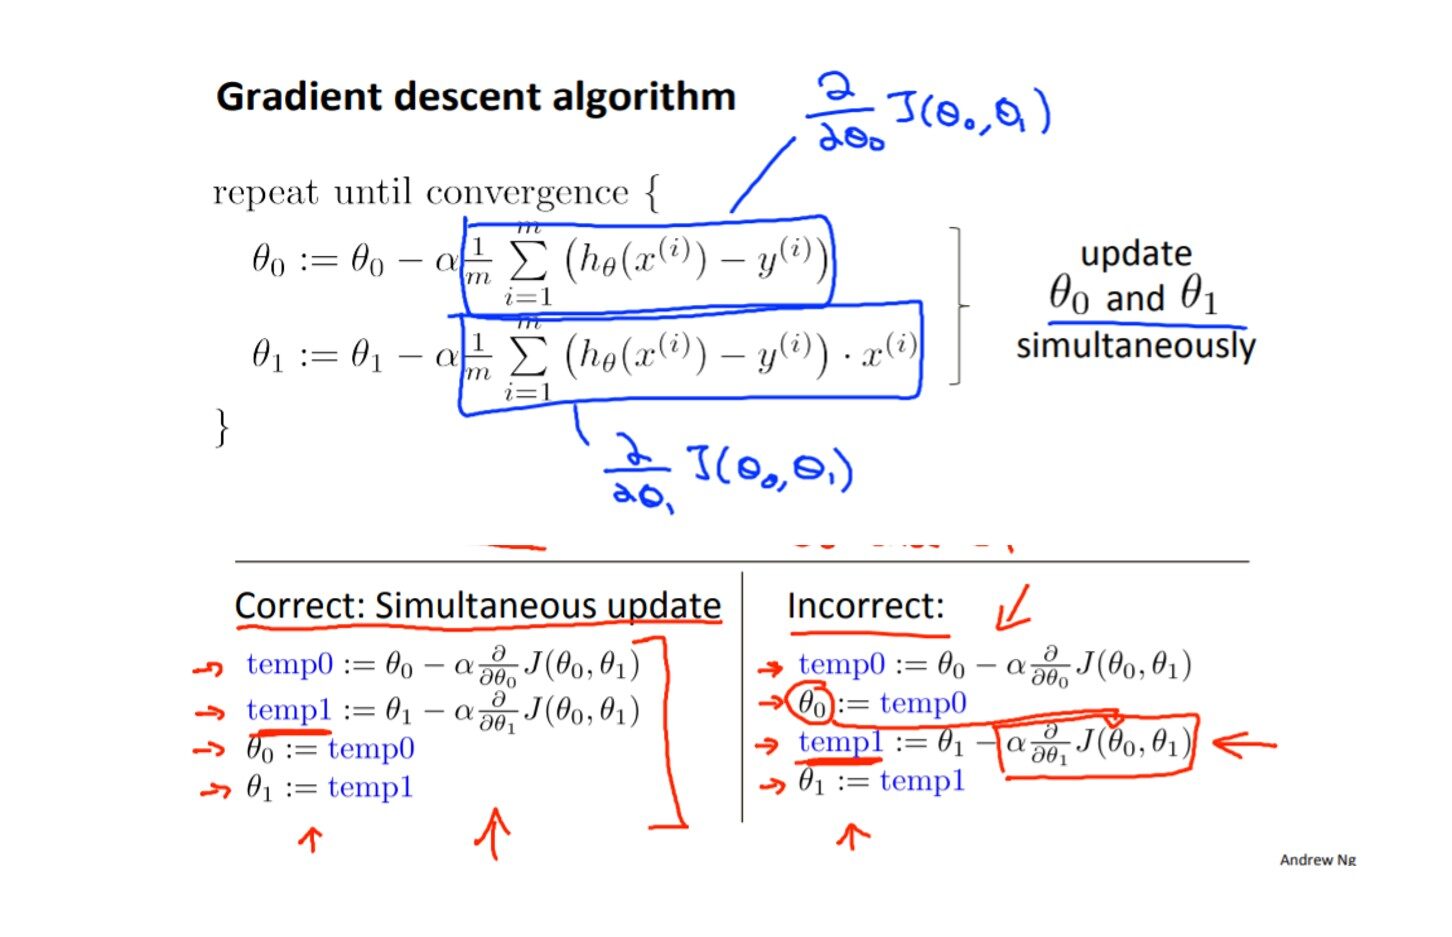
Das Funktionsprinzip des Algorithmus ist für beliebig viele Parameter gleich, es ist nur so, je mehr Parameter, desto mehr die Richtung der Steigung. Im obigen Beispiel der schalenförmigen Kurve, wir brauchen nur die Steigung von theta1 . zu beobachten, aber jetzt muss der Algorithmus in beide Richtungen schauen, um die Kostenfunktion zu minimieren. Lassen Sie uns den Algorithmus codieren und verstehen. Bitte beachten Sie die Abbildung unten als Referenz:
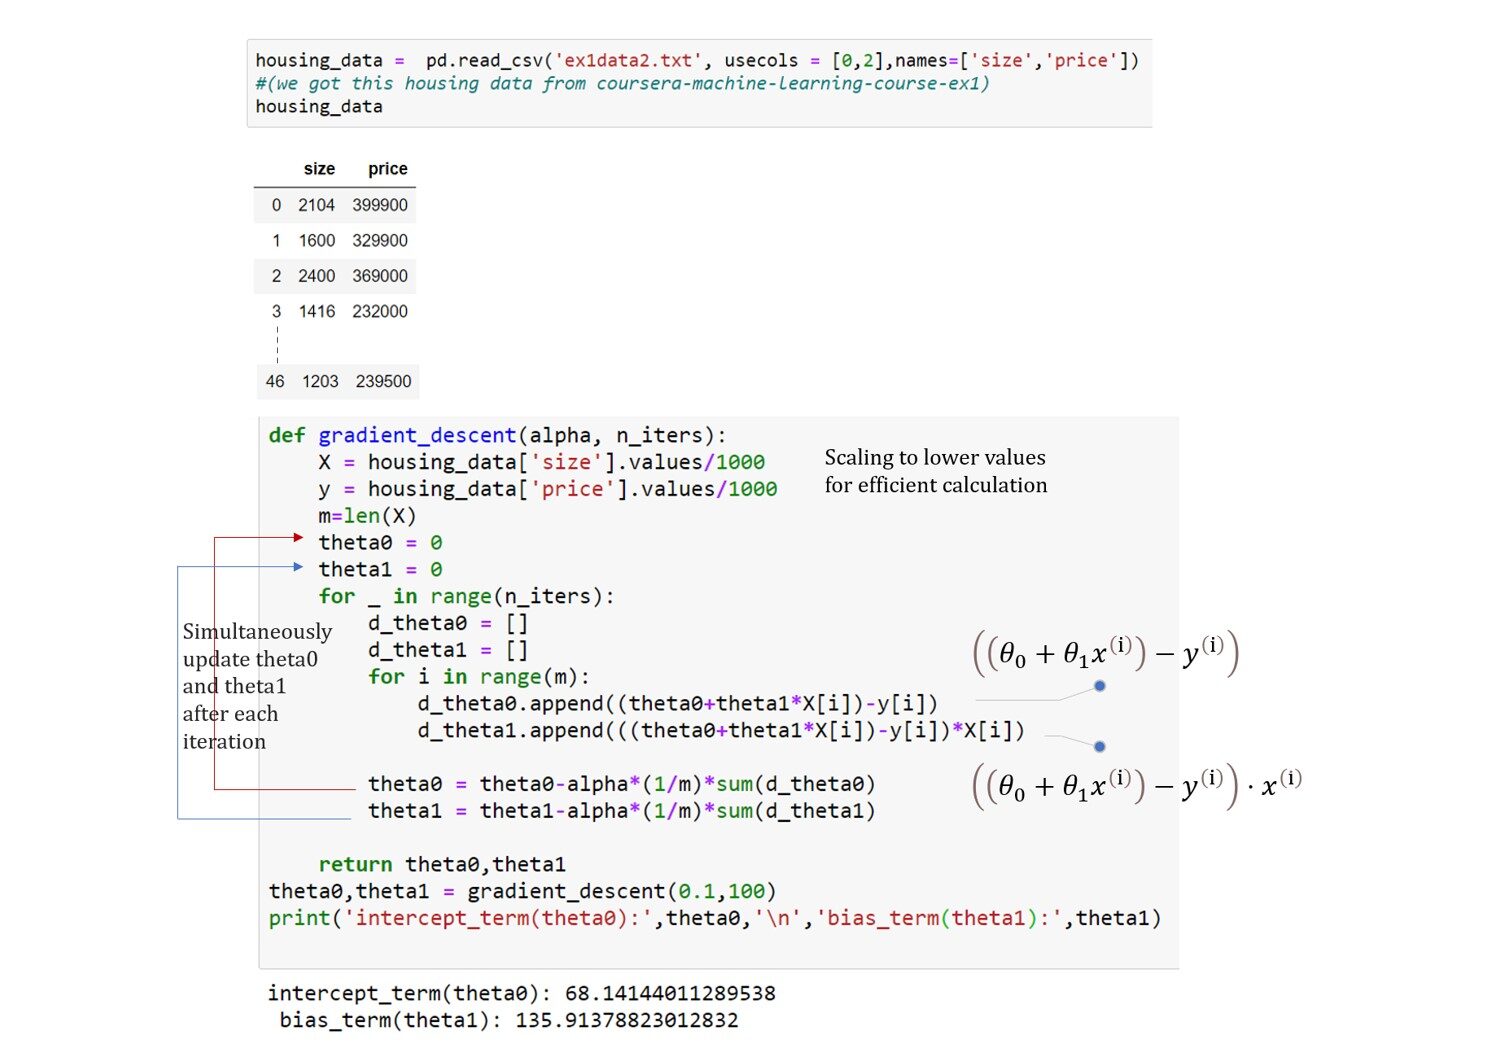
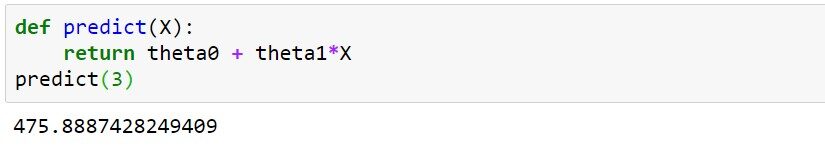
Auf geht's, unser Modell sagt voraus 475,88 * 1000 = $ 475,880 für Hausgröße 3 * 1000 Quadratmeter. Es kommt unserer Vorhersage sehr nahe, die wir am Anfang mit unserer Intuition gemacht haben.
Fazit
Als Anfänger, Es kann etwas schwierig sein, alle Konzepte der linearen Regression in einer so kurzen Lesezeit zu verstehen. Ich würde nicht sagen, dass Sie aus diesem Artikel alles über lineare Regression wissen. Der Zweck dieses Artikels ist es, die Algorithmen so einfach wie möglich verständlich zu machen. Folgen Sie dem untenstehenden Ressourcenlink für ein besseres Verständnis. Ich hoffe es hat dir Spaß gemacht den Artikel zu lesen. Danke fürs Lesen.
Meint:
Code-Link
https://github.com/ravi235/LinearRegression
Gradientenabstiegsmathematik
https://www.youtube.com/watch?v=jc2IthslyzM&ab_channel=TheCodingTrain
Lineare Regression Andrew Ng
https://www.youtube.com/watch?v=kHwlB_j7Hkc&t=8s&ab_channel=ArtificialIntelligence-AllinOne





