
Dieser Artikel durchlief eine Reihe von Änderungen!!
Ich habe anfangs über ein anderes Thema geschrieben (relacionado con la AnalyseAnalytics bezieht sich auf den Prozess des Sammelns, Messen und analysieren Sie Daten, um wertvolle Erkenntnisse zu gewinnen, die die Entscheidungsfindung erleichtern. In verschiedenen Bereichen, wie Business, Gesundheit und Sport, Analysen können Muster und Trends erkennen, Prozesse optimieren und Ergebnisse verbessern. Der Einsatz fortschrittlicher Werkzeuge und statistischer Techniken ist unerlässlich, um Daten in anwendbares und strategisches Wissen umzuwandeln....). Ich war fast fertig mit dem Schreiben. Ich hatte ungefähr investiert 2 Stunden und einen durchschnittlichen Artikel geschrieben. Hätte ich es live gemacht, ich hätte es gut gemacht! Aber etwas in mir hat mich daran gehindert, es zum Leben zu erwecken. Ich war mit dem Ergebnis einfach nicht zufrieden. Der Artikel vermittelt nicht, wie ich mich fühle 2015 und wie nützlich DataPeaker für Ihr Analytics-Lernen in diesem Jahr sein könnte.
Dann, Ich habe diesen Artikel in den Papierkorb gelegt und überlegt, welches Thema gerecht wird. Das ist bei mir gelandet: lass mich tolle Artikel und Leitfäden über meine größten Lernerfahrungen schreiben 2014: Scikit-learn- oder sklearn-Bibliothek in Python. Dies war mein größter Lerneffekt, denn jetzt ist es das Werkzeug, das ich für jedes Machine-Learning-Projekt verwende, an dem ich arbeite.
Diese Artikel zu erstellen wäre nicht nur für Blog-Leser enorm hilfreich, es würde mich auch herausfordern, über etwas zu schreiben, für das ich noch relativ neu bin. Das gleiche würde ich auch gerne von dir hören: Was war dein größtes Lernen in 2014 und Sie möchten es mit den Lesern dieses Blogs teilen?
Was ist scikit-learn oder sklearn?
Scikit-learn ist wahrscheinlich die nützlichste Bibliothek für maschinelles Lernen in Python. Die sklearn-Bibliothek enthält viele effiziente Tools für maschinelles Lernen und statistische Modellierung, die eine Klassifizierung beinhalten, Rückschritt, Gruppierung und Dimensionsreduktion.
Beachten Sie, dass sklearn verwendet wird, um Modelle für maschinelles Lernen zu erstellen. Es sollte nicht zum Lesen der Daten verwendet werden, manipulieren und zusammenfassen. Dafür gibt es bessere Bibliotheken (zum Beispiel, NumPy, Pandas, etc.)
Komponenten von scikit-learn:
Scikit-learn ist mit vielen Funktionen ausgestattet. Hier sind einige von ihnen, um Ihnen zu helfen, die Verbreitung zu verstehen:
- Algoritmos de überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in...: Denken Sie an einen überwachten maschinellen Lernalgorithmus, von dem Sie gehört haben, und es besteht eine gute Chance, dass er ein Teil von scikit-learn ist. Aus verallgemeinerten linearen Modellen (zum Beispiel, lineare Regression), Support-Vektor-Maschinen (SVM), Entscheidungsbäume und Bayes'sche Methoden, alle sind Teil der scikit-learn-Toolbox. Die Verbreitung von maschinellen Lernalgorithmen ist einer der Hauptgründe für die hohe Nutzung von scikit-learn. Ich habe angefangen, scikit zu verwenden, um überwachte Lernprobleme zu lösen, und würde es auch Leuten empfehlen, die neu bei scikit sind / maschinelles Lernen.
- Kreuzvalidierung: Es gibt mehrere Methoden, um die Genauigkeit von überwachten Modellen an unsichtbaren Daten mit sklearn zu überprüfen.
- Unüberwachte Lernalgorithmen: Nochmal, Es gibt eine Vielzahl von Machine-Learning-Algorithmen im Angebot, aus dem Pool, Faktorenanalyse, Hauptkomponentenanalyse zu unüberwachten neuronalen Netzen.
- Mehrere Spielzeugdatensätze: Dies war nützlich beim Lernen von scikit-learn. Ich hatte SAS mit verschiedenen akademischen Datensätzen gelernt (zum Beispiel, der IRIS-Datensatz, der Boston-Hauspreisdatensatz). Sie zur Hand zu haben, während man eine neue Bibliothek lernt, hat sehr geholfen..
- Merkmalsextraktion: Scikit-lernen, um Funktionen aus Bildern und Texten zu extrahieren (zum Beispiel, Sack voller Worte)
Gemeinschaft / Organisationen, die scikit-learn verwenden:
Einer der Hauptgründe für den Einsatz von Open-Source-Tools ist die großartige Community, die es hat. Das gleiche gilt auch für sklearn. Es gibt ungefähr 35 Bisherige scikit-learn-Mitwirkende, am bemerkenswertesten ist Andreas Müller (PS Andy Spickzettel für maschinelles Lernen ist eine der besten Visualisierungen, um das Spektrum der maschinellen Lernalgorithmen zu verstehen).
Es gibt mehrere Organisationen wie Evernote, Inria und AWeber gezeigt in scikit Learn-Startseite als Benutzer. Aber ich denke wirklich, dass der eigentliche Nutzen viel mehr ist.
Neben diesen Gemeinschaften, es gibt mehrere Treffen auf der ganzen Welt. Es gab auch ein Kaggle-Wissenswettbewerb, die vor kurzem endete, aber es könnte immer noch einer der besten Orte sein, um mit der Bibliothek zu spielen.
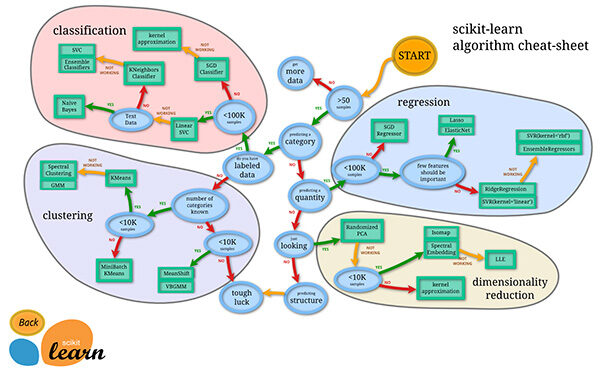
Spickzettel für maschinelles Lernen: consulte la imagen original para obtener una mejor AuflösungDas "Auflösung" bezieht sich auf die Fähigkeit, feste Entscheidungen zu treffen und gesetzte Ziele zu erreichen. Im persönlichen und beruflichen Kontext, Dabei geht es darum, klare Ziele zu definieren und einen Aktionsplan zu entwickeln, um diese zu erreichen. Entschlossenheit ist entscheidend für persönliches Wachstum und Erfolg in verschiedenen Lebensbereichen, denn es ermöglicht Ihnen, Hindernisse zu überwinden und sich auf das zu konzentrieren, was wirklich wichtig ist....
Schnelles Beispiel:
Jetzt, da Sie das Ökosystem auf hohem Niveau verstehen, Lassen Sie mich die Verwendung von sklearn an einem Beispiel veranschaulichen. Die Idee ist einfach, die Einfachheit der Verwendung von sklearn . zu veranschaulichen. In einem der folgenden Artikel werden wir uns verschiedene Algorithmen und die besten Möglichkeiten ansehen, sie zu verwenden..
Wir werden eine logistische Regression auf dem IRIS-Datensatz erstellen:
Paso 1: Importieren Sie die entsprechenden Bibliotheken und lesen Sie den Datensatz aus
numpy als np importieren
Matplotlib als plt importieren
aus sklearn-Importdatensätzen
von sklearn-Importmetriken
de sklearn.linear_model import LogisticRegression
Wir haben alle Bibliotheken importiert. Dann, wir lesen den Datensatz:
dataset = datasets.load_iris ()
Paso 2: Verstehen Sie den Datensatz, indem Sie sich Verteilungen und Diagramme ansehen
Ich überspringe diese Schritte vorerst. Sie können diesen Artikel lesen, wenn Sie explorative Analyse lernen möchten.
Paso 3: Erstellen Sie ein logistisches Regressionsmodell auf dem Datensatz und treffen Sie Vorhersagen
model.fit (Datensatzein "Datensatz" oder Datensatz ist eine strukturierte Sammlung von Informationen, die für statistische Analysen verwendet werden können, Maschinelles Lernen oder Forschung. Datensätze können numerische Variablen enthalten, kategorisch oder textuell, und ihre Qualität ist entscheidend für zuverlässige Ergebnisse. Sein Einsatz erstreckt sich auf verschiedene Disziplinen, wie z.B. Medizin, Wirtschafts- und Sozialwissenschaften, Erleichterung einer fundierten Entscheidungsfindung und der Entwicklung von Vorhersagemodellen.....Daten, dataset.target)
erwartet = dataset.target
vorhergesagt = model.predict (dataset.data)
Paso 4: Drucken Sie die Verwirrungsmatrix
drucken (metrics.classification_report (erwartet, vorhergesagt))
drucken (metrics.confusion_matrix (erwartet, vorhergesagt))
Abschließende Anmerkungen:
Dies war ein Überblick über eine der leistungsstärksten und vielseitigsten Bibliotheken für maschinelles Lernen von Python. Es war auch das größte Lernen, das ich je gemacht habe 2014. Was war dein größtes Lernen in 2014? Teile es mit der Gruppe über die Kommentare unten.
Sind Sie begeistert, Scikit-learn zu lernen und zu verwenden?? Wenn ja, Bleiben Sie dran für die restlichen Artikel dieser Serie.
Eine kurze Erinnerung: wenn Sie nicht ausgecheckt haben Analytische Vidhya-Diskussion aber trotzdem, du solltest es jetzt tun. Benutzer treten schnell bei, Also nimm einen beliebigen Benutzernamen, bevor ihn jemand anderes abholt.





