
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
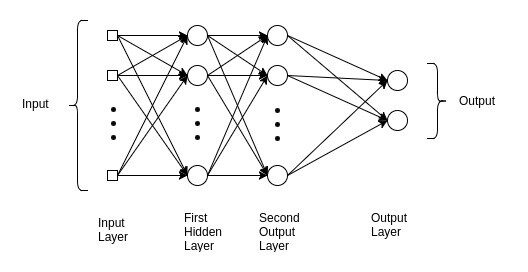
Das Verständnis dieses Netzwerks hilft uns, Informationen über die zugrunde liegenden Gründe in fortgeschrittenen Deep-Learning-Modellen zu erhalten. Das Mehrschichtperzeptron wird häufig bei einfachen Regressionsproblemen verwendet. Aber trotzdem, MLPs sind nicht ideal für die Verarbeitung von Mustern mit sequenziellen und multidimensionalen Daten.
🙄 Ein Mehrschichtperzeptron bemüht sich, Muster in sequenziellen Daten zu erkennen, deswegen, erfordert eine „große“ Menge von ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... um multidimensionale Daten zu verarbeiten.
MLP, CNNs und RNNs können nicht alles …
Ein Großteil ihres Erfolgs beruht darauf, ihr Ziel zu erkennen und einige Parameter gut auszuwählen, Was Verlustfunktion, Optimierer, Ja Regularisierer.
Wir haben auch Daten, die nicht aus der Trainingsumgebung stammen. Die Aufgabe des Regularisierers ist es sicherzustellen, dass das trainierte Modell auf neue Daten generalisiert.
MNIST-Datensatz
Angenommen, unser Ziel ist es, ein Netzwerk zu erstellen, das Zahlen basierend auf handgeschriebenen Ziffern identifiziert. Zum Beispiel, wenn die Eingabe des Netzwerks ein Bild einer Zahl ist 8, muss auch die entsprechende Vorhersage sein 8.
🤷🏻♂️ Este es un trabajo básico de clasificación con redes neuronales.
Antes de analizar el modelo MLP, es esencial comprender el conjunto de datos del MNIST. Se utiliza para explicar y validar muchas teorías de tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... porque las 70.000 imágenes que contiene son pequeñas pero suficientemente ricas en información;
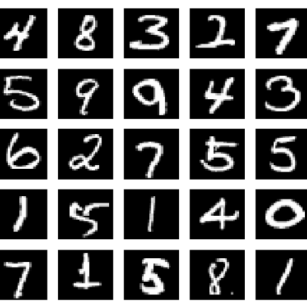
MNIST es una colección de dígitos que van del 0 al 9. Tiene un conjunto de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... von 60.000 imágenes y 10.000 pruebas clasificadas en categorías.
Usar el conjunto de datos MNIST en TensorFlow es simple.
importieren numpy wie z.B
von tensorflow.keras.datasets importieren mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()
das mnist.load_data () El método es conveniente, ya que no es necesario cargar las 70.000 imágenes y sus etiquetas.
Antes de entrar en el clasificador de Perceptrón Multicapa, es fundamental tener en cuenta que, si bien los datos del MNIST constan de tensores bidimensionales, se deben remodelar, según el tipo de EingabeschichtDas "Eingabeschicht" bezieht sich auf die Anfangsebene in einem Datenanalyseprozess oder in neuronalen Netzwerkarchitekturen. Seine Hauptfunktion besteht darin, Rohinformationen zu empfangen und zu verarbeiten, bevor sie von nachfolgenden Schichten transformiert werden. Im Kontext des maschinellen Lernens, Die richtige Konfiguration der Eingabeschicht ist entscheidend, um die Effektivität des Modells zu gewährleisten und seine Leistung bei bestimmten Aufgaben zu optimieren.....
Se cambia la forma de una imagen en escala de grises de 3 × 3 para las capas de entrada MLP, CNN y RNN:
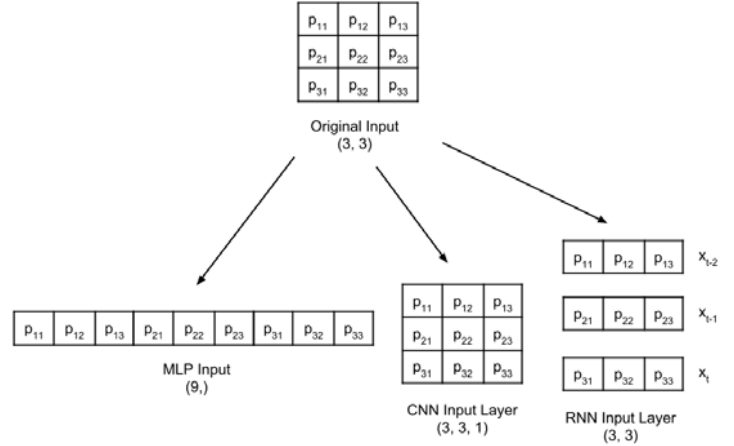
Las etiquetas tienen forma de dígitos, des 0 al 9.
num_labels = len(np.unique(y_train))
drucken("total de labels:T{}".Format(num_labels))
drucken("Etiketten:ttt{0}".Format(np.unique(y_train)))
⚠️ Esta representación no es adecuada para la capa de pronóstico que genera probabilidad por clase. El formato más adecuado es one-hot, un vector de 10 dimensiones como todos los valores 0, excepto el IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... de clase. Zum Beispiel, si la etiqueta es 4, el vector equivalente es [0,0,0,0, 1, 0,0,0,0,0].
De Deep Learning, los datos se almacenan en un TensorTensoren sind mathematische Strukturen, die Konzepte wie Skalare und Vektoren verallgemeinern. Sie werden in verschiedenen Disziplinen eingesetzt, einschließlich Physik, Ingenieurwesen und maschinelles Lernen, um mehrdimensionale Daten darzustellen. Ein Tensor kann als mehrdimensionale Matrix visualisiert werden, , die es ermöglicht, komplexe Beziehungen zwischen verschiedenen Variablen zu modellieren. Ihre Vielseitigkeit und Fähigkeit, große Informationsmengen zu verarbeiten, machen sie zu grundlegenden Werkzeugen in der Datenanalyse und -verarbeitung..... El término tensor se aplica a un tensor escalar (tensor 0D), vector (tensor 1D), Hauptquartier (tensor bidimensional) Ja tensor multidimensionalLos tensores multidimensionales son estructuras matemáticas que generalizan la noción de escalares, vectores y matrices a dimensiones superiores. Se utilizan ampliamente en campos como la física, la ingeniería y el aprendizaje automático, permitiendo representar y manipular datos complejos de manera eficiente. Su capacidad para almacenar información en múltiples dimensiones facilita el análisis y la modelización de fenómenos reales, contribuyendo a avances en diversas disciplinas científicas y tecnológicas.....
#converter em one-hot
from tensorflow.keras.utils import to_categorical
y_train = to_categorical(y_train)
y_test = to_kategorial(y_test)
Nuestro modelo es un MLP, por lo que sus entradas deben ser un tensor 1D. als solche, x_train y x_test deben transformarse en [60,000, 2828] Ja [10,000, 2828],
In Summe, el tamaño de -1 significa permitir que la biblioteca calcule la dimensión correcta. En el caso de x_train, es ist 60.000.
image_size = x_train.shape[1]
input_size = image_size * image_size

print("x_train:T{}".Format(x_train.shape))
drucken("x_test:tt{}n".Format(x_test.shape))

x_train = np.reshape(x_train, [-1, input_size])
x_train = x_train.astype('float32') / 255

x_test = np.reshape(x_test, [-1, input_size])
x_test = x_test.astype('float32') / 255

drucken("x_train:T{}".Format(x_train.shape))
drucken("x_test:tt{}".Format(x_test.shape))
OUTPUT:
x_train:	(60000, 28, 28)
x_test:		(10000, 28, 28)

x_train:	(60000, 784)
x_test:		(10000, 784)
Modell bauen
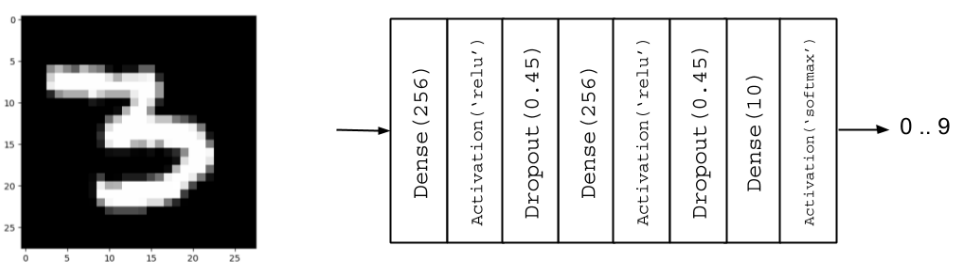
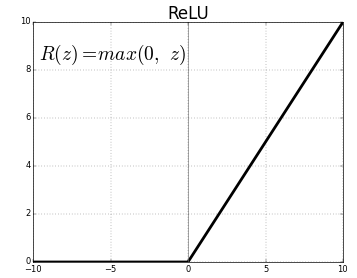
from tensorflow.keras.models import Sequential
from tensorflow.keras.layers import Dense, Aktivierung, Aussteigen

# Parameters
batch_size = 128 # Es ist die Stichprobengröße der Eingaben, die in jeder Trainingsphase verarbeitet werden sollen.
hidden_units = 256
Ausfall = 0.45

# Nossa  MLP com ReLU e Dropout
model = Sequential()

model.add(Dicht(hidden_units, input_dim=input_size))
model.add(Aktivierung('relu'))
model.add(Aussteigen(aussteigen))

model.add(Dicht(hidden_units))
model.add(Aktivierung('relu'))
model.add(Aussteigen(aussteigen))

model.add(Dicht(num_labels))
Regulierung
Una red neuronal tiende a memorizar sus datos de entrenamiento, especialmente si contiene capacidad más que suficiente. In diesem Fall, la red falla catastróficamente cuando se somete a los datos de prueba.
Este es el caso clásico en el que la red no logra generalizar (ÜberanpassungÜberanpassung, oder Überanpassung, Es handelt sich um ein Phänomen des maschinellen Lernens, bei dem ein Modell zu eng mit den Trainingsdaten übereinstimmt, Erfassung von irrelevantem Rauschen und Mustern. Dies führt zu einer schlechten Leistung bei unsichtbaren Daten, da das Modell an Generalisierungskapazität verliert. Um Überanpassung zu verringern, Techniken wie die Regularisierung können verwendet werden, Kreuzvalidierung und Reduzierung der Modellkomplexität.... / UnteranpassungEl underfitting es un problema común en el aprendizaje automático que ocurre cuando un modelo es demasiado simple para capturar la complejidad de los datos. Esto se traduce en un rendimiento deficiente tanto en el conjunto de entrenamiento como en el de prueba. Las causas del underfitting pueden incluir un modelo inadecuado, características irrelevantes o insuficientes datos. Um es zu lösen, Se puede optar por modelos más complejos o mejorar la calidad...). Para evitar esta tendencia, el modelo utiliza una capa reguladora. Verlassen.
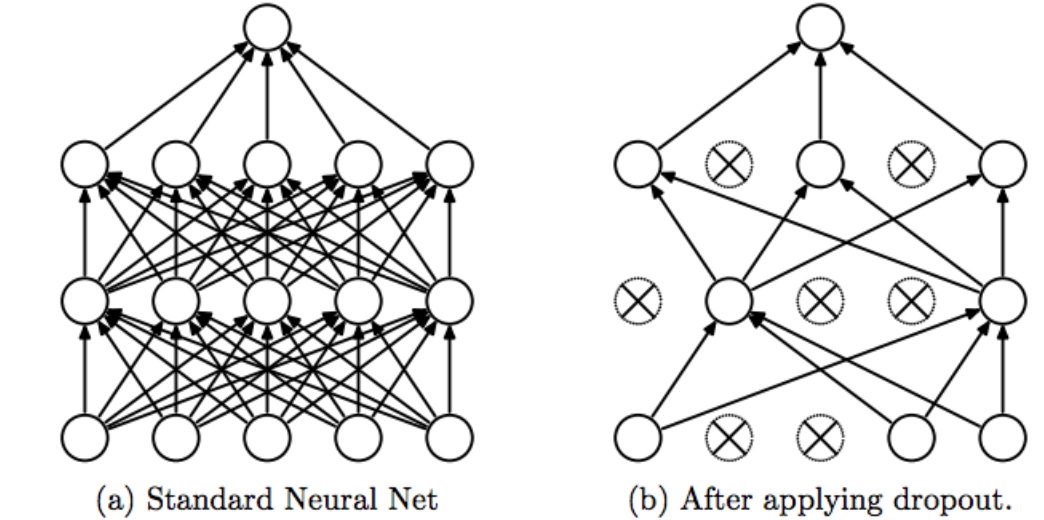
La idea de Dropout es simple. Dada una tasa de descarte (en nuestro modelo, establecemos = 0,45), la capa elimina aleatoriamente esta fracción de unidades.
Zum Beispiel, si la primera capa tiene 256 Einheiten, después de que se aplica el abandono (0.45), Solo (1 – 0.45) * 255 = 140 Unidades participarán en la siguiente capa
La deserción hace que las redes neuronales sean más robustas para los datos de entrada imprevistos, porque la red está entrenada para predecir correctamente, incluso si algunas unidades están ausentes.
⚠️ El abandono solo participa en „abspielen“ 🤷🏻 ♂️ durante el entrenamiento.
Aktivierung
Das Ausgabe-LayerDas "Ausgabe-Layer" ist ein Konzept, das im Bereich der Informationstechnologie und des Systemdesigns verwendet wird. Es bezieht sich auf die letzte Schicht eines Softwaremodells oder einer Architektur, die für die Präsentation der Ergebnisse für den Endbenutzer verantwortlich ist. Diese Schicht ist entscheidend für die Benutzererfahrung, Da es eine direkte Interaktion mit dem System und die Visualisierung der verarbeiteten Daten ermöglicht.... verfügt über 10 Einheiten, seguidas de una función de activación softmax. Das 10 unidades corresponden a las 10 posibles etiquetas, clases o categorías.
La activación de softmax se puede expresar matemáticamente, de acuerdo con la siguiente ecuación:
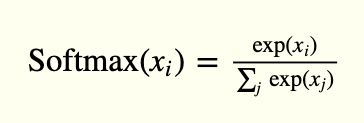
model.add(Aktivierung('softmax'))
Modell.Zusammenfassung()
OUTPUT:
Modell: "sequenziell"
________________________________________________________________________________
Schicht (Typ)                 Parameter der Ausgabeform #
=================================================================
dense (Dicht)                (Keiner, 256)               200960
_________________________________________________________________
activation (Aktivierung)      (Keiner, 256)               0
_________________________________________________________________
dropout (Aussteigen)            (Keiner, 256)               0
_________________________________________________________________
dense_1 (Dicht)              (Keiner, 256)               65792
_________________________________________________________________
activation_1 (Aktivierung)    (Keiner, 256)               0
________________________________________________________________________________
dropout_1 (Aussteigen)          (Keiner, 256)               0
________________________________________________________________________________
dicht_2 (Dicht)              (Keiner, 10)                2570
_________________________________________________________________
activation_2 (Aktivierung)    (Keiner, 10)                0
================================================ ===============
Gesamtparameter: 269,322
Trainierbare Parameter: 269,322
Nicht trainierbare Parameter: 0
_________________________________________________________________
Visualización de modelos
Verbesserung
El propósito de la Optimización es minimizar la función de pérdida. La idea es que si la pérdida se reduce a un nivel aceptable, el modelo aprendió indirectamente la función que asigna las entradas a las salidas. Las Métricas de rendimiento se utilizan para determinar si su modelo ha aprendido.
model.compile(Verlust="kategoriale_Kreuzentropie", Optimierer="Adam", Metriken=[Genauigkeit])
-
- Categorical_crossentropy, Se utiliza para One-Hot
- La precisión es una buena métrica para las tareas de clasificación.
- Adam es un Optimierungsalgorithmus machtEin Optimierungsalgorithmus ist eine Reihe von Regeln und Verfahren, die darauf ausgelegt sind, die beste Lösung für ein bestimmtes Problem zu finden, indem eine Zielfunktion maximiert oder minimiert wird. Diese Algorithmen sind in verschiedenen Bereichen grundlegend, wie zum Beispiel Ingenieurwesen, Wirtschaft und Künstliche Intelligenz, wo Effizienz verbessert und Kosten gesenkt werden sollen. Es gibt verschiedene Ansätze, einschließlich genetischer Algorithmen, Lineare Programmierung und kombinatorische Optimierungsmethoden.... das als Ersatz für das klassische Abstiegverfahren verwendet werden kann SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... stochastisch
📌 Angesichts unseres Trainingssatzes, die Wahl des Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und..., Optimierers und des Regulators, können wir mit dem Training unseres Modells beginnen.
model.fit(x_train, y_train, Epochen=20, batch_size=batch_size)
OUTPUT:
Epoche 1/20
469/469 [==============================] - 1s 3ms/Schritt - Verlust: 0.4230 - Richtigkeit: 0.8690
....
Epoche 20/20
469/469 [==============================] - 2s 4ms/Schritt - Verlust: 0.0515 - Richtigkeit: 0.9835
Auswertung
In diesem Punkt, unser MNIST-Ziffernklassifikationsmodell ist fertig. Die Leistungsbewertung wird der nächste Schritt sein, um festzustellen, ob das trainierte Modell eine suboptimale Lösung liefert
_, acc = model.evaluate(x_test,
                        y_test,
                        batch_size=batch_size,
                        ausführlich=0)
drucken("nGenauigkeit: %.1f%%n" % (100.0 * acc))
OUTPUT:
Genauigkeit: 98.4%
wird fortgesetzt…





