
Quelle: https://www.serokell.io
Im Bild oben, Sie können sehen, dass E-Mails als Spam eingestuft werden oder nicht. Dann, ist ein Beispiel für die Klassifizierung (binäre Klassifikation).
1. Logistische Regression
2. Bayes ingenuo
3. K-Nächste Nachbarn
5. Entscheidungsbaum
Wir werden alle Algorithmen mit einem kleinen Code sehen, der im Iris-Datensatz angewendet wird, der für Klassifizierungsaufgaben verwendet wird. Der Datensatz hat 150 Instanzen (Reihen), 4 Merkmale (Säulen) und enthält keinen Nullwert. Es gibt 3 Klassen im Iris-Datensatz:
– Seidige Iris
– Iris Versicolor
– Iris Virginica
Es ist ein sehr grundlegender, aber wichtiger Klassifikationsalgorithmus im maschinellen Lernen, der eine oder mehrere unabhängige Variablen verwendet, um ein Ergebnis zu ermitteln. La regresión logística intenta hallar la vinculación que mejor se ajuste entre la VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... dependiente y un conjunto de variables independientes. Die am besten passende Linie in diesem Algorithmus sieht aus wie die S-Form, wie in der gezeigten Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.....
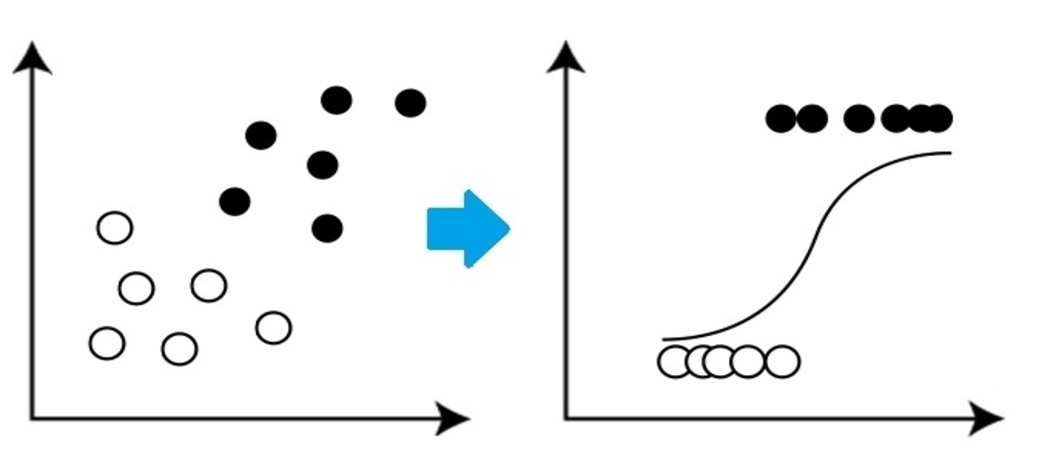
Quelle: https://www.equiskill.com
Vorteile:
- Es ist ein sehr einfacher und effizienter Algorithmus.
- Geringe Varianz.
- Bietet Wahrscheinlichkeit Beobachtungsergebnis.
Nachteile:
- Schlechtes Fahren ein großer Anzahl kategorialer Merkmale.
- Angenommen, die Daten sind frei von fehlenden Werten und die Prädiktoren sind unabhängig voneinander.
Beispiel:
aus sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
x, y = load_iris()
LR_classifier = LogisticRegression(random_state=0)
LR_classifier.fit(x, Ja)
LR_classifier.predict(x[:3, :])
Produktion:
Array([0, 0, 0])
Es hat vorhergesagt 0 Klasse für alle 3 Tests zur Vorhersage der Funktion.
2. Bayes ingenuo
Naive Bayes se basa en Teorema de bayes was eine Annahme der Unabhängigkeit zwischen Prädiktoren ergibt. Dieser Klassifikator geht davon aus, dass das Vorhandensein eines bestimmten Merkmals in einer Klasse nicht mit dem Vorhandensein einer anderen zusammenhängt
charakteristisch / Variable.
Es gibt drei Typen von Naive Bayes-Klassifikatoren: Multinomial Naive Bayes, Bernoulli Naive Bayes, Gaussian Naive Bayes.
Vorteile:
- Dieser Algorithmus arbeitet sehr schnell.
- Es kann auch verwendet werden, um Vorhersageprobleme mit mehreren Klassen zu lösen., da es bei ihnen ganz nützlich ist.
- Este clasificador funciona mejor que otros modelos con menos datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... si se mantiene el supuesto de independencia de las características.
Nachteile:
- Geht davon aus
dass alle Funktionen unabhängig sind. Obwohl es großartig klingen mag in
Theorie, Aber im wirklichen Leben, niemand kann eine Reihe unabhängiger Merkmale finden.
Beispiel:
aus sklearn.datasets import load_iris
aus sklearn.model_selection import train_test_split
von sklearn.naive_bayes importieren GaussianNB
x, y = load_iris(return_X_y=Wahr)
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0,25, random_state=142)
Naive_Bayes = GaussianNB()
Naive_Bayes.fit(X_Zug, y_train)
vorhersage_results = Naive_Bayes.predict(X_test)
drucken(vorhersage_results)
Produktion:
Array([0, 1, 1, 2, 1, 1, 0, 0, 2, 1, 1, 1, 2, 0, 1, 0, 2, 1, 1, 2, 2, 1,0, 1, 2, 1, 2, 2, 0, 1, 2,
     1, 2, 1, 2, 2, 1, 2])
Dies sind die Klassen, die von unserem naiven Bayes-Modell für X_test-Daten vorhergesagt werden.
3. Nächster Nachbar-Algorithmus K
Sie müssen von einem beliebten Sprichwort gehört haben:
„Gleich und gleich gesellt sich gern.“
KNN arbeitet nach dem gleichen Prinzip. Klassifizieren Sie die neuen Datenpunkte basierend auf der Klasse der meisten Datenpunkte zwischen benachbarten K, wobei K die Anzahl der zu berücksichtigenden Nachbarn ist. KNN fängt die Idee der Ähnlichkeit ein (manchmal Distanz genannt,
Nähe oder Nähe) mit einigen grundlegenden mathematischen Distanzformeln wie der euklidischen Distanz, Entfernung von Manhattan, etc.
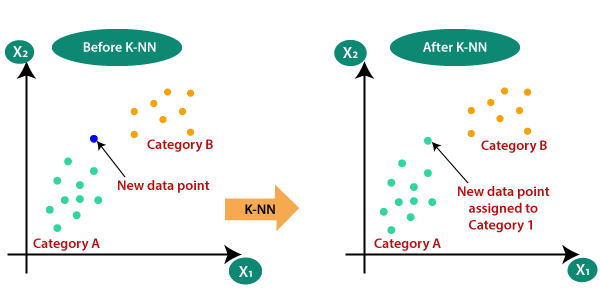
Quelle: https://www.javatpoint.com
Wählen Sie den richtigen Wert für K
So wählen Sie das geeignete K für die Daten aus, die Sie trainieren möchten, Führen Sie den KNN-Algorithmus mehrmals mit verschiedenen K-Werten aus und wählen Sie den K-Wert, der die Fehlermenge in den unsichtbaren Daten reduziert.
Vorteile:
- KNN ist einfach und leicht zu implementieren.
- Keine Notwendigkeit, ein Modell zu erstellen, Ajustar varios ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... o hacer suposiciones adicionales como algunos de los otros algoritmos de clasificación.
- Kann zur Klassifizierung verwendet werden, Regression und Suche. Dann, es ist flexibel.
- Der Algorithmus wird mit zunehmender Anzahl von Beispielen deutlich langsamer und / oder Prädiktoren / unabhängige Variablen.
von sklearn.neighbors importieren KNeighborsClassifier
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0,25, random_state=142)
knn = KNeighborsClassifier(n_nachbarn=3)
knn.fit(X_Zug, y_train)
vorhersage_results = knn.vorhersage(X_test[:5,:)
drucken(vorhersage_results)
Produktion:
Array([0, 1, 1, 2, 1])
Wir haben unsere Ergebnisse vorhergesagt für 5 Beispielreihen. Daher haben wir 5 ergibt ein Array.
4. SVM
SVM steht für Support Vector Machine. Dies ist ein überwachter maschineller Lernalgorithmus, der sehr häufig für Klassifikations- und Regressionsherausforderungen verwendet wird. Trotz dieses, hauptsächlich bei Klassifikationsproblemen verwendet. Das Grundkonzept der Support Vector Machine und ihre Funktionsweise lässt sich anhand dieses einfachen Beispiels besser verstehen. Dann, stell dir vor du hast zwei etiketten: grün und Blau, und unsere Daten haben zwei Eigenschaften: x Ja Ja. Wir wollen einen Klassifikator, der, ein paar gegeben (x, Ja) Koordinaten, gibt aus, wenn es so ist verde Ö Blau. Zeichnen Sie die beschrifteten Trainingsdaten auf einem Flugzeug und versuchen Sie dann, ein Flugzeug zu finden (die Hyperebene der Dimensionen nimmt zu) die die Datenpunkte beider Farben sehr klar trennt.
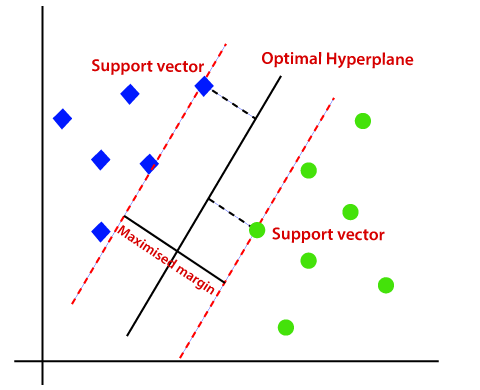
Quelle: https://www.javatpoint.com
Dies ist jedoch bei linearen Daten der Fall. Aber, Was ist, wenn die Daten nicht linear sind?, dann benutze den Kernel-Trick? Dann, damit umgehen, aumentamos la Abmessungen"Dimension" Es handelt sich um einen Begriff, der in verschiedenen Disziplinen verwendet wird, wie z.B. Physik, Mathematik und Philosophie. Er bezieht sich auf das Ausmaß, in dem ein Objekt oder Phänomen analysiert oder beschrieben werden kann. In der Physik, zum Beispiel, Es ist die Rede von räumlichen und zeitlichen Dimensionen, während es sich in der Mathematik auf die Anzahl der Koordinaten beziehen kann, die notwendig sind, um einen Raum darzustellen. Es zu verstehen, ist grundlegend für das Studium und..., Dies bringt Daten in den Weltraum und jetzt werden die Daten linear in zwei Gruppen trennbar.
Vorteile:
- SVM funciona relativamente bien cuando existe un claro RandMargin ist ein Begriff, der in einer Vielzahl von Zusammenhängen verwendet wird, wie z.B. Buchhaltung, Wirtschaft und Druck. In der Buchhaltung, bezieht sich auf die Differenz zwischen Umsatz und Kosten, die es ermöglicht, die Rentabilität eines Unternehmens zu bewerten. Im Bereich Publishing, Der Rand ist der Leerraum um den Text auf einer Seite, Das macht es gut lesbar und sorgt für eine ästhetische Darstellung. Die korrekte Verwaltung ist unerlässlich.. de separación entre clases.
- SVM ist in großen Räumen effektiver.
Nachteile:
- SVM ist nicht für große Datensätze geeignet.
- SVM funktioniert nicht sehr gut, wenn der Datensatz mehr Rauschen aufweist, Mit anderen Worten, wenn sich Zielklassen überschneiden. Dann, muss gehandhabt werden.
Beispiel:
von sklearn import svm
svm_clf = svm.SVC()
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0,25, random_state=142)
svm_clf.fit(X_Zug, y_train)
vorhersage_results = svm_clf.predict(X_test[:7,:])
drucken(vorhersage_results)
Produktion:
Array([0, 1, 1, 2, 1, 1, 0])
5.Entscheidungsbaum
Der Entscheidungsbaum ist einer der am weitesten verbreiteten Algorithmen für maschinelles Lernen. Sie werden für Klassifikations- und Regressionsprobleme verwendet. Entscheidungsbäume imitieren das Denken auf menschlicher Ebene, so ist es sehr einfach, die Daten zu verstehen und gute Intuitionen und Interpretationen zu machen. In Wirklichkeit, lassen Sie die Logik der Daten erkennen, um sie zu interpretieren. Entscheidungsbäume sind nicht wie Black-Box-Algorithmen wie SVM, Neuronale Netze, etc.
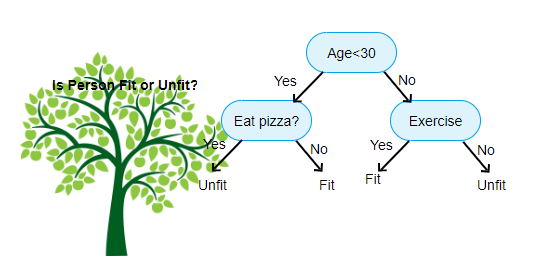
Quelle: https://www.aitimejournal.com
Als Beispiel, wenn wir eine Person als geeignet oder ungeeignet einstufen, der Entscheidungsbaum sieht auf dem Bild ein bisschen so aus.
Dann, Zusammenfassend, un árbol de decisión es un árbol donde cada KnotenNodo ist eine digitale Plattform, die die Verbindung zwischen Fachleuten und Unternehmen auf der Suche nach Talenten erleichtert. Durch ein intuitives System, Ermöglicht Benutzern das Erstellen von Profilen, Erfahrungen austauschen und Zugang zu Stellenangeboten erhalten. Der Fokus auf Zusammenarbeit und Networking macht Nodo zu einem wertvollen Werkzeug für diejenigen, die ihr berufliches Netzwerk erweitern und Projekte finden möchten, die mit ihren Fähigkeiten und Zielen übereinstimmen.... representa un
charakteristisch / Attribut, jeder Zweig steht für eine Entscheidung, ein Lineal und jedes Blatt stellt ein Ergebnis dar. Dieses Ergebnis kann von kategorialem oder kontinuierlichem Wert sein. Kategorisch bei Klassifikation und kontinuierlich bei Regressionsanwendungen.
Vorteile:
- Im Vergleich zu anderen Algorithmen, Entscheidungsbäume erfordern weniger Aufwand für die Datenaufbereitung während der gesamten Vorverarbeitung.
- Tampoco requieren la StandardisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... de datos ni el escalado.
- Das im Entscheidungsbaum entwickelte Modell ist sehr intuitiv und sowohl für technische Teams als auch für Stakeholder leicht zu erklären..
Nachteile:
- Wenn auch nur eine kleine Änderung an den Daten vorgenommen wird, Dies kann zu einer großen Änderung in der Entscheidungsbaumstruktur führen, die zu Instabilität führt.
- Manchmal, Berechnung kann im Vergleich zu anderen Algorithmen viel komplexer sein.
- Entscheidungsbäume brauchen normalerweise länger, um das Modell zu trainieren.
Beispiel:
aus dem sklearn-Importbaum
dtc = tree.DecisionTreeClassifier()
X_Zug, X_test, y_train, y_test = train_test_split(x, Ja, test_size=0,25, random_state=142)
dtc.fit(X_Zug, y_train)
vorhersage_results = dtc.predict(X_test[:7,:])
drucken(vorhersage_results)
Produktion:
Array([0, 1, 1, 2, 1, 1, 0])
Abschließende Anmerkungen
Dies sind die 5 beliebtesten Ranking-Algorithmen, es gibt noch viel mehr und auch fortgeschrittene Algorithmen. Entdecken Sie sie weiter. Lass uns verbinden LinkedIn
Danke fürs Lesen, wenn du hier bist 🙂
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





