
Einführung
Wenn Sie jemals an Data-Science-Wettbewerben teilgenommen haben, Sie sollten sich der entscheidenden Rolle bewusst sein, die Ensemble-Modellierung spielt. In Wirklichkeit, Die Ensemble-Modellierung soll eine der überzeugendsten Möglichkeiten bieten, hochpräzise Vorhersagemodelle zu erstellen. Die Verfügbarkeit von einsacken und verstärken Algorithmen verschönern diese Methode weiter, um ein erstaunliches Maß an Präzision zu erreichen.
Deswegen, wenn Sie das nächste Mal ein Vorhersagemodell erstellen, Erwägen Sie die Verwendung dieses Algorithmus. Für diesen Vorschlag würde ich mir auf jeden Fall auf die Schulter klopfen.. Ja, wenn Sie diese Methode bereits beherrschen, genial. Ich würde gerne Ihre Expertise zur Ensemble-Modellierung im Kommentarbereich unten hören..
Andernfalls, Ich teile einige der am häufigsten gestellten Fragen zur Ensemble-Modellierung. Wenn Sie zu irgendeinem Zeitpunkt das Wissen von jemandem über das Set überprüfen möchten, Vielleicht wagst du es, diese Fragen zu stellen und dein Wissen zu überprüfen. Zur selben Zeit, das sind einige der einfachsten fragen, also kannst du es nicht wagen, falsch zu liegen.
Was sind die häufigsten Fragen (mit Ensemblemodellen verbunden)?
Nach der Analyse mehrerer Data-Science-Foren, Ich habe die identifiziert 5 Häufige Fragen im Zusammenhang mit der Ensemble-Modellierung. Diese Fragen sind für Data Scientists, die neu in der Ensemble-Modellierung sind, sehr relevant.. Hier sind die Fragen:
- Was ist ein Set-Modell??
- Was sind Absacken?, Verstärkung und Stapelung?
- Können wir mehrere Modelle desselben ML-Algorithmus zusammenstellen??
- Wie können wir die Gewichte verschiedener Modelle identifizieren??
- Was sind die Vorteile des Ensemblemodells?
Lassen Sie uns jede Frage im Detail analysieren.
1. Was ist ein Set-Modell??
Versuchen wir es zu verstehen, indem wir eine qualifizierende Herausforderung lösen.
Ärger: Regeln zum Sortieren von Spam-E-Mails festlegen
Lösung: Wir können mehrere Regeln für die Klassifizierung von Spam-E-Mails generieren, lass uns einige von ihnen sehen:
- Unerwünschte E-Mail
- Haben eine Gesamtausdehnung von weniger als 20 Wörter.
- Habe nur Bild (Werbebilder)
- Haben Sie bestimmte Keywords wie „Geld verdienen und wachsen“ Ja „reduziere dein Fett“
- Weitere Wörter in der E-Mail geschrieben
- Kein Spam
- DataPeaker-Domain-E-Mail
- E-Mail von Familienmitgliedern oder jemandem im E-Mail-Adressbuch
Über, Ich habe einige allgemeine Regeln zum Filtern von Spam-E-Mails aufgelistet. Glaubst du, dass alle diese Regeln einzeln die richtige Klasse vorhersagen können??
Die meisten von uns würden nein sagen, Und das ist wahr! Die Kombination dieser Regeln liefert eine solide Vorhersage im Vergleich zu den Vorhersagen einzelner Regeln.. Dies ist das Prinzip der Ensemblemodellierung. El modelo de conjunto combina varios modelos ‚individuales‘ (mehrere) zusammen und bietet überlegene Vorhersagekraft.
Wenn du das mit dem wirklichen Leben in Verbindung bringen willst, eine Gruppe von Menschen trifft wahrscheinlich bessere Entscheidungen als Einzelpersonen, besonders wenn Gruppenmitglieder aus mehreren Hintergründen kommen. Das gleiche gilt für maschinelles Lernen. Einfach, un conjunto es una técnica de überwachtes LernenÜberwachtes Lernen ist ein Ansatz des maschinellen Lernens, bei dem ein Modell mit einem Satz von beschrifteten Daten trainiert wird. Jede Eingabe im Dataset ist mit einer bekannten Ausgabe verknüpft, So kann das Modell lernen, Ergebnisse für neue Eingaben vorherzusagen. Diese Methode wird häufig in Anwendungen wie der Bildklassifizierung eingesetzt., Spracherkennung und Trendvorhersage, und unterstreicht seine Bedeutung in... para combinar múltiples Studenten / schwache Modelle produzieren starker Lehrling. Das Montagemodell funktioniert am besten, wenn wir Modelle mit geringer Korrelation montieren.
Ein gutes Beispiel dafür, wie Ensemble-Methoden häufig verwendet werden, um datenwissenschaftliche Probleme zu lösen, ist das zufälliger Wald Algorithmus (das hat mehrere CART-Modelle). Es funktioniert besser als das individuelle CART-Modell, wenn ein neues Objekt kategorisiert wird, bei dem jeder Baum gibt „Stimmen“ für diese Klasse und der Wald wählt die Klassifizierung mit den meisten Stimmen (über alle Bäume im Wald). Im Falle einer Regression, nimmt den Durchschnitt der Ausgaben von verschiedenen Bäumen.
Du kannst diesem Beitrag auch folgen „Legen Sie die Lerngrundlagen in einfachem Englisch erklärt fest“ um mehr über Ensemblemodellierung zu erfahren.
2. Was sind Absacken?, Verstärkung und Stapelung?
Lassen Sie uns jeden dieser Begriffe einzeln betrachten und versuchen, die Unterschiede zwischen diesen Begriffen zu verstehen.:
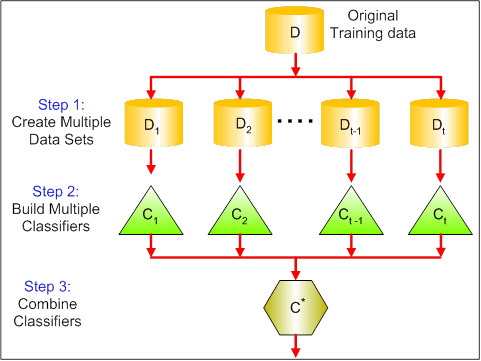
Harpillera (Bootstrap-Aggregation) ist eine festgelegte Methode. Zuerst, creamos muestras aleatorias del conjunto de datos de AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... (Teilmengen des Trainingsdatensatzes). Nach, wir konstruieren für jede Probe einen Klassifikator. Zusammenfassend, die Ergebnisse dieser Mehrfachklassifikatoren werden durch Durchschnitts- oder Mehrheitsabstimmungen kombiniert. Absacken hilft, Abweichungsfehler zu reduzieren.
Impuls bietet sequentielles Lernen von Prädiktoren. Der erste Prädiktor wird über den gesamten Datensatz gelernt, während Folgendes im Trainingsset basierend auf der Leistung des vorherigen gelernt wird.. Dass Beginnen Sie damit, den ursprünglichen Datensatz zu klassifizieren und jeder Beobachtung das gleiche Gewicht zu geben. Wenn Klassen mit dem ersten Schüler falsch vorhergesagt werden, dann wird die fehlende klassifizierte Beobachtung stärker gewichtet. Ein iteratives Verfahren sein, setzt das Hinzufügen von Klassifikatorlernern fort, bis eine Grenze für die Anzahl der Modelle oder die Genauigkeit erreicht ist. Impulse hat eine bessere Vorhersagegenauigkeit gezeigt als das Absacken, aber es neigt auch dazu, die Trainingsdaten zu überstimmen. 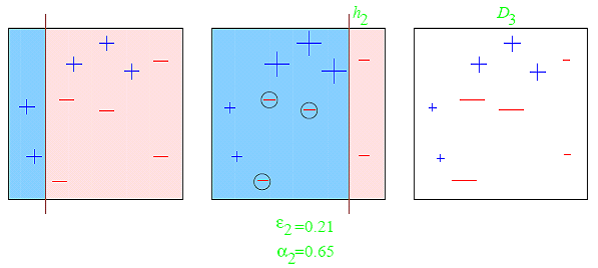
Das gängigste Beispiel für Booster ist AdaBoost und Gradient Boosting. Weitere Informationen zum Boosten von Algorithmen finden Sie auch in diesen Beiträgen..
Aufgestapelt funktioniert in zwei Phasen. Zuerst, Wir verwenden mehrere Basisklassifikatoren, um die Klasse vorherzusagen. Zweitens, ein neuer Schüler wird verwendet, um seine Vorhersagen zu kombinieren, um den Generalisierungsfehler zu reduzieren. 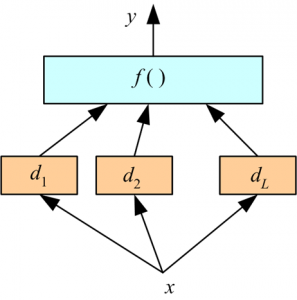
3. Können wir mehrere Modelle desselben ML-Algorithmus zusammenstellen??
Jawohl, wir können mehrere Modelle derselben ML-Algorithmen kombinieren, aber das regelmäßige Kombinieren mehrerer Vorhersagen, die von verschiedenen Algorithmen generiert werden, würde Ihnen bessere Vorhersagen liefern. Es ist auf Diversifikation oder unabhängige Natur im Vergleich zueinander zurückzuführen. Als Beispiel, die Vorhersagen eines Random Forest, ein KNN und ein Naive Bayes können kombiniert werden, um im Vergleich zur Kombination von drei Zufallswaldmodellen robustere endgültige Vorhersagen zu erstellen. Der Schlüssel zu einem starken Ensemble liegt in der Vielfalt der Modelle. Ein Set mit zwei Techniken, die ihrer Natur nach sehr äquivalent sind, wird schlechter abschneiden als ein vielfältigeres Set von Modellen..
Beispiel: Nehmen wir an, wir haben drei Modelle (EIN, Von C). EIN, B und C haben eine Vorhersagegenauigkeit von 85%, 80% Ja 55% beziehungsweise. Es wird jedoch festgestellt, dass A und B hoch korreliert sind, wenn C schlecht mit A und B korreliert ist. Sollen wir A und B kombinieren?? Nein, Wir sollten nicht, weil diese Modelle stark korreliert sind. Deswegen, wir werden diese beiden nicht kombinieren, da dieser Satz nicht dazu beiträgt, Generalisierungsfehler zu reduzieren. Ich kombiniere lieber A und C oder B und C.
4. Wie können wir die Gewichte verschiedener Modelle für das Set identifizieren??
Eine der häufigsten Herausforderungen bei der Ensemble-Modellierung besteht darin, optimale Gewichtungen für Basis-Ensemble-Modelle zu finden. Allgemein, wir nehmen für alle Modelle das gleiche Gewicht an und nehmen den Durchschnitt der Vorhersagen. Aber, Ist dies der beste Weg, sich dieser Herausforderung zu stellen??
Es gibt mehrere Methoden, um das optimale Gewicht zu finden, um alle Grundschüler zu kombinieren. Diese Methoden bieten ein gutes Verständnis dafür, wie Sie das richtige Gewicht finden. Dann, Ich liste einige der Methoden auf:
- Finden Sie die Kollinearität zwischen den Basisschülern und basierend auf dieser Tabelle, Identifizieren Sie dann Basismodelle zum Zusammenbauen. Danach, Sehen Sie sich den Kreuzvalidierungs-Score an (Punkteverhältnis) der identifizierten Basismodelle, um das Gewicht zu finden.
- Finden Sie den Algorithmus, um das optimale Gewicht für Grundschüler zurückzugeben. Puede consultar el post Cómo hallar pesos óptimos de aprendices de conjunto usando una rotes neuronalesNeuronale Netze sind Rechenmodelle, die von der Funktionsweise des menschlichen Gehirns inspiriert sind. Sie nutzen Strukturen, die als künstliche Neuronen bekannt sind, um Daten zu verarbeiten und daraus zu lernen. Diese Netze sind grundlegend im Bereich der künstlichen Intelligenz, Dies ermöglicht erhebliche Fortschritte bei Aufgaben wie der Bilderkennung, Verarbeitung natürlicher Sprache und Vorhersage von Zeitreihen, unter anderen. Ihre Fähigkeit, komplexe Muster zu erlernen, macht sie zu mächtigen Werkzeugen.. para ver el método para hallar el peso óptimo.
- Wir können das gleiche Problem auch mit Methoden wie . lösen:
Sie können auch die Gewinnerantwort der Data Science-Wettbewerbe sehen / Kaggle, um andere Methoden zu verstehen, um diese Herausforderung zu meistern.
5. Was sind die Vorteile des Ensemblemodells?
Es gibt zwei Hauptvorteile von Ensemble-Modellen:
- Beste Vorhersage
- Stabileres Modell
Die Gesamtmeinung verschiedener Modelle ist weniger laut als die anderer Modelle. In der Finanzwelt, Anruf „Diversifikation“: una cartera mixta de muchas acciones será mucho menos VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... que una sola de las acciones. Dies ist auch der Grund, warum Ihre Modelle besser mit Modellsätzen als mit einzelnen Modellen zurechtkommen.. Eine der Vorsichtsmaßnahmen bei Ensemble-Modellen ist, dass sie zu eng sitzen., obwohl das Absacken das weitgehend übernimmt.
Schlussbemerkung
In diesem Beitrag, wir haben die analysiert 5 Häufig gestellte Fragen zu Ensemble-Modellen. Durch die Beantwortung dieser Fragen, wir haben über "Ensemble-Modelle" diskutiert, "Ensemble-Methoden", "Warum sollten wir mehrere Modelle zusammenbauen?”, "Methoden, um das optimale Gewicht für das Set zu ermitteln" und "Vorteile" zu beenden. Ich schlage vor, Sie schauen sich die 5 besten Data-Science-Quizlösungen und sehen Sie ihre gemeinsamen Ansätze für ein besseres Verständnis und viel Praxis. Es wird Ihnen helfen zu verstehen, was funktioniert und was nicht.
War dieser Beitrag hilfreich für dich? Haben Sie noch etwas versucht, um optimale Gewichte zu finden oder den geeigneten Basisschüler zu identifizieren?? Ich freue mich, von Ihnen im Kommentarbereich unten zu hören..





