
Einführung
E-Commerce hat die Art und Weise, wie wir einkaufen, revolutioniert. Dieses Telefon, das Sie seit Monaten für den Kauf gespart haben? Es ist nur eine Suche und ein paar Klicks entfernt. Artikel werden innerhalb von Tagen geliefert (Manchmal sogar am nächsten Tag!).
Für Online-Händler, es gibt keine Einschränkungen in Bezug auf die Bestandsverwaltung oder die Platzverwaltung. Sie können so viele verschiedene Produkte verkaufen, wie sie wollen. Physische Geschäfte können aufgrund des begrenzten verfügbaren Platzes nur eine begrenzte Anzahl von Produkten vorhalten.
Ich erinnere mich, als ich früher Bücher bei meiner örtlichen Buchhandlung bestellt habe, und es dauerte mehr als eine Woche, bis es ankam. Es scheint jetzt eine Geschichte aus alten Zeiten zu sein!
Quelle: http://www.yeebaplay.com.br
Aber Online-Shopping hat seine eigenen Vorbehalte. Eine der größten Herausforderungen ist die Überprüfung der Echtheit eines Produkts. Ist es so gut wie auf der E-Commerce-Site beworben?? Hält das Produkt länger als ein Jahr? Sind die Meinungen anderer Kunden wirklich wahr oder handelt es sich um irreführende Werbung? Dies sind wichtige Fragen, die sich Kunden stellen sollten, bevor sie ihr Geld verschwenden.
Dies ist ein großartiger Ort, um zu experimentieren und Techniken der natürlichen Sprachverarbeitung anzuwenden. (PNL). Dieser Artikel wird Ihnen helfen zu verstehen, wie wichtig es ist, Online-Produktbewertungen mit Hilfe von Topic Modeling zu nutzen.
Sehen Sie sich die folgenden Artikel an, falls Sie eine kurze Auffrischung der Themenmodellierung benötigen:
Inhaltsverzeichnis
- Bedeutung von Online-Bewertungen
- Problemstellung
- Warum ist die Modellierung von Themen für diese Aufgabe?
- Python-Implementierung
- Daten lesen
- Datenvorverarbeitung
- Erstellen eines LDA-Modells
- Themen anzeigen
- Andere Methoden, um Online-Bewertungen zu nutzen
- Was kommt als nächstes?
Bedeutung von Online-Bewertungen
Vor ein paar Tagen, Ich bin in den E-Commerce gesprungen und habe mir online ein Smartphone gekauft. Es war innerhalb meines Budgets und hatte eine anständige Bewertung von 4.5 Über 5.
Leider, Es stellte sich als schlechte Entscheidung heraus, da die Backup-Batterie weit unter dem Durchschnitt war. Ich habe die Produktbewertungen nicht überprüft und mich nur aufgrund der Bewertungen für den Kauf entschieden. Und ich weiß, dass ich nicht der einzige bin, der diesen Fehler gemacht hat!
Bewertungen allein geben kein vollständiges Bild von den Produkten, die wir kaufen möchten, wie ich zu meinem Nachteil festgestellt habe. Deswegen, Als Vorsichtsmaßnahme, Ich empfehle den Leuten immer, die Bewertungen eines Produkts zu lesen, bevor sie sich entscheiden, ob sie es kaufen oder nicht.
Aber dann taucht ein interessantes Problem auf. Was ist, wenn die Anzahl der Bewertungen Hunderte oder Tausende beträgt?? Es ist einfach nicht machbar, all diese Bewertungen durchzugehen, Wahrheit? Und hier triumphiert die Verarbeitung natürlicher Sprache.
Geben Sie die Problemstellung an
Eine Problemstellung ist die Saat, aus der Ihre Analyse erwächst. Deswegen, Es ist wirklich wichtig, eine solide Problemstellung zu haben, klar und gut definiert.

Wie können wir eine große Anzahl von Online-Bewertungen mit Natural Language Processing analysieren? (NLP)? Lass uns dieses Problem definieren.
Online-Produktbewertungen sind eine großartige Informationsquelle für Verbraucher. Aus Sicht des Verkäufers, Online-Bewertungen können verwendet werden, um das Feedback der Verbraucher zu den von ihnen verkauften Produkten oder Dienstleistungen zu bewerten. Aber trotzdem, da diese Online-Rezensionen in Bezug auf Zahlen und Informationen oft überwältigend sind, ein intelligentes System, in der Lage, wichtige Informationen zu finden (Themen) aus diesen Bewertungen, wird sowohl für Verbraucher als auch für Verkäufer eine große Hilfe sein. Dieses System hat zwei Zwecke:
- Ermöglichen Sie es Verbrauchern, wichtige Themen, die von Bewertungen abgedeckt werden, schnell zu extrahieren, ohne sie alle durchgehen zu müssen.
- Helfen Sie Verkäufern / Händler, um Verbraucherfeedback in Form von Themen zu erhalten (aus Verbraucherbewertungen gezogen)
Um diese Aufgabe zu lösen, Wir werden das Konzept der Themenmodellierung verwenden (LDA) in Amazon Automotive Review-Daten. Sie können es hier herunterladen Verknüpfung. Ähnliche Datensätze finden Sie für andere Produktkategorien hier.
Warum sollten Sie die Themenmodellierung für diese Aufgabe verwenden??
Wie der Name schon sagt, Themenmodellierung ist ein Prozess der automatischen Identifizierung von Themen, die in einem Textobjekt vorhanden sind, und der Ableitung versteckter Muster, die von einem Textkorpus gezeigt werden. Theme-Vorlagen sind für mehrere Zwecke sehr nützlich, einschließlich:
- Gruppierung von Dokumenten
- Organisieren Sie große Textdatenblöcke
- Abruf von unstrukturierten Textinformationen
- Merkmalsauswahl
Ein gutes Themenmodell, beim Training in einem Text über die Börse, sollte zu Themen führen wie „Angebot“, „Verhandlung“, „Dividende“, „Austausch“, etc. Das folgende Bild veranschaulicht, wie ein typisches Themenmodell funktioniert:

In unserem Fall, statt Textdokumente, tenemos miles de reseñas de productos en línea para los artículos enumerados en la categoría ‚Automotriz‘. Unser Ziel hier ist es, eine bestimmte Anzahl von Gruppen wichtiger Wörter aus den Bewertungen zu extrahieren.. Diese Wortgruppen sind im Grunde die Themen, die dazu beitragen würden, festzustellen, worüber Verbraucher in Rezensionen wirklich sprechen..

Python-Implementierung
In diesem Abschnitt, wir werden unsere Jupyter-Notizbücher aktivieren (Oder jede andere IDE, die Sie für Python verwenden!). Hier werden wir an der oben definierten Problemstellung arbeiten, um mithilfe des Konzepts des latenten Dirichlet-Mappings nützliche Themen aus unserem Online-Rezensionsdatensatz zu extrahieren. (LDA).
Notiz: Wie ich in der Einleitung erwähnt habe, Ich empfehle dringend, diesen Artikel zu lesen, um zu verstehen, was LDA ist und wie es funktioniert.
Laden wir zuerst alle notwendigen Bibliotheken:
nltk importieren
von nltk importieren FreqDist
nltk.download('Stoppwörter') # lauf das mal
Pandas als pd importieren
pd.set_option("display.max_colwidth", 200)
numpy als np importieren
Importieren
spacig importieren

Gensim importieren
von Gensim Import Corpora

# Bibliotheken zur Visualisierung
pyLDavis importieren
pyLDAvis.gensim importieren
import matplotlib.pyplot als plt
import seaborn als sns
%matplotlib inline
So importieren Sie die Daten, Extrahieren Sie zuerst die Daten in Ihr Arbeitsverzeichnis und verwenden Sie dann die read_json () Pandas-Funktion, um es in einem Pandas-Datenrahmen zu lesen.
df = pd.read_json('Automotive_5.json', Linien=Wahr)
df.kopf()
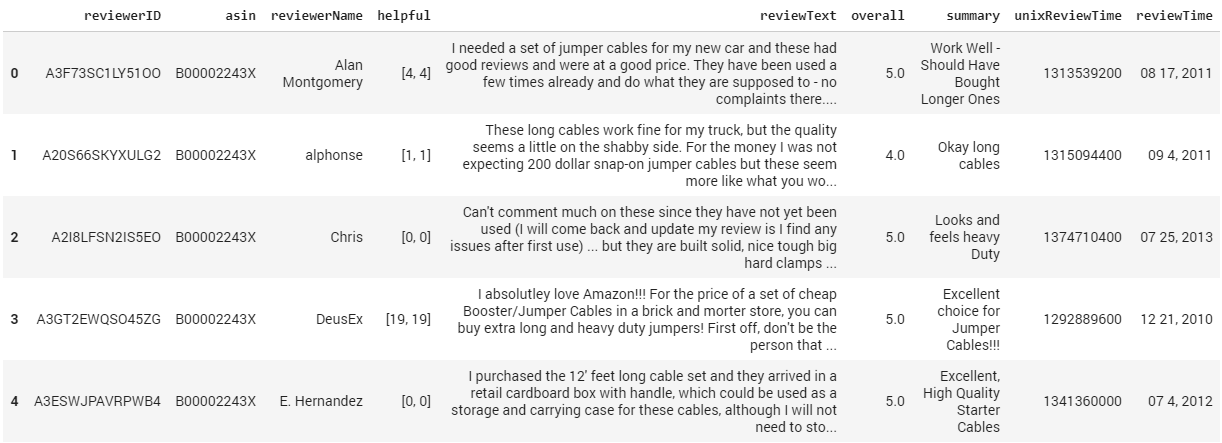
Wie du siehst, die Daten enthalten die folgenden Spalten:
- Gutachter-ID – ID del revisor
- wie in – Produkt ID
- RezensentName – Name des Rezensenten
- hilfreich – Nutzenbewertung überprüfen, zum Beispiel, 2/3
- RezensionText – Rezensionstext
- allgemein – Produktbewertung
- abstrakt – Zusammenfassung
- unixReviewTime – Überprüfungszeit (Unix-Stunde)
- Überprüfungszeit – Überprüfungszeit (ohne Verarbeitung)
Für den Umfang unserer Analyse und dieses Artikels, Wir werden nur die Bewertungsspalte verwenden, nämlich, RezensionText.
Datenvorverarbeitung
Die Vorverarbeitung und Bereinigung von Daten ist ein wichtiger Schritt vor jeder Text-Mining-Aufgabe, in diesem Schritt, Wir werden die Satzzeichen entfernen, die Stoppwörter und wir werden die Überarbeitungen so weit wie möglich normalisieren. Nach jedem Vorverarbeitungsschritt, Es empfiehlt sich, die häufigsten Wörter in den Daten zu überprüfen. Deswegen, definamos una función que trazaría un BalkengrafikDas Balkendiagramm ist eine visuelle Darstellung von Daten, die rechteckige Balken verwendet, um Vergleiche zwischen verschiedenen Kategorien anzuzeigen. Jeder Balken stellt einen Wert dar, und seine Länge ist proportional zu ihm. Diese Art von Diagramm ist nützlich, um Trends zu visualisieren und zu analysieren, Erleichterung der Interpretation quantitativer Informationen. Es ist in verschiedenen Disziplinen weit verbreitet, wie z.B. Statistiken, Marketing und Forschung, Aufgrund seiner Einfachheit und Effektivität.... de n palabras más frecuentes en los datos.
# Funktion zum Plotten der häufigsten Begriffe
def freq_words(x, Begriffe = 30):
  all_words=" ".beitreten([Text für Text in x])
  all_words = all_words.split()

  fdist = FreqDist(alle Worte)
  words_df = pd.DataFrame({'word':aufführen(fdist.keys()), 'count':aufführen(fdist.values())})

  # Auswahl nach oben 20 häufigste Wörter
  d = words_df.nlargest(Spalten="zählen", n = Begriffe)
  plt.figur(Feigengröße=(20,5))
  ax = sns.barplot(Daten=d, x= "Wort", y = "zählen")
  ax.set(ylabel="Zählen")
  plt.zeigen()
Probieren wir diese Funktion aus und finden Sie heraus, welche Wörter in unserem Bewertungsdatensatz am häufigsten vorkommen.
freq_words(df['reviewText'])
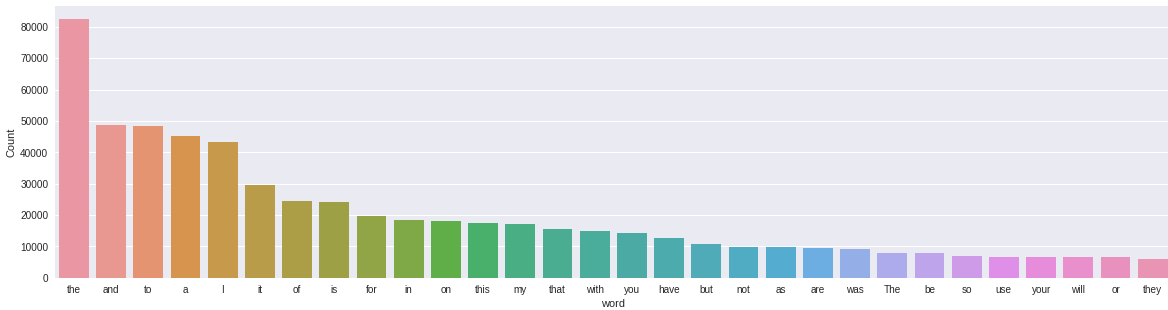
Die häufigsten Wörter sind „das“, „Ja“, „zu“, etc. Diese Worte sind für unsere Aufgabe nicht so wichtig und sie erzählen keine Geschichte.. Wir müssen diese Art von Wörtern loswerden. Davor, lass uns Scores und Zahlen aus unseren Textdaten entfernen.
# Entfernen Sie unerwünschte Zeichen, Zahlen und Symbole
df['reviewText'] = df['reviewText'].str.ersetzen("[^ a-zA-Z #]", " ")
Versuchen wir, die Stoppwörter und kurzen Wörter zu eliminieren (<2 Briefe) der Bewertungen.
aus nltk.corpus importieren Stoppwörter
stop_words = stopwords.words('english')
# Funktion zum Entfernen von Stoppwörtern
def remove_stopwords(Rev):
    rev_new = " ".beitreten([i für i in rev, wenn ich nicht in stop_words])
    return rev_new

# kurze Wörter entfernen (Länge < 3)
df['reviewText'] = df['reviewText'].anwenden(Lambda x: ' '.join([w für w in x.split() wenn len(w)>2]))

# Stoppwörter aus dem Text entfernen
Bewertungen = [remove_stopwords(r.split()) für r in df['reviewText']]

# gesamten Text in Kleinbuchstaben schreiben
Bewertungen = [r.unten() für r in Bewertungen]
Lassen Sie uns die häufigsten Wörter noch einmal verfolgen und sehen, ob die wichtigsten Wörter herausgekommen sind.
freq_words(Bewertungen, 35)
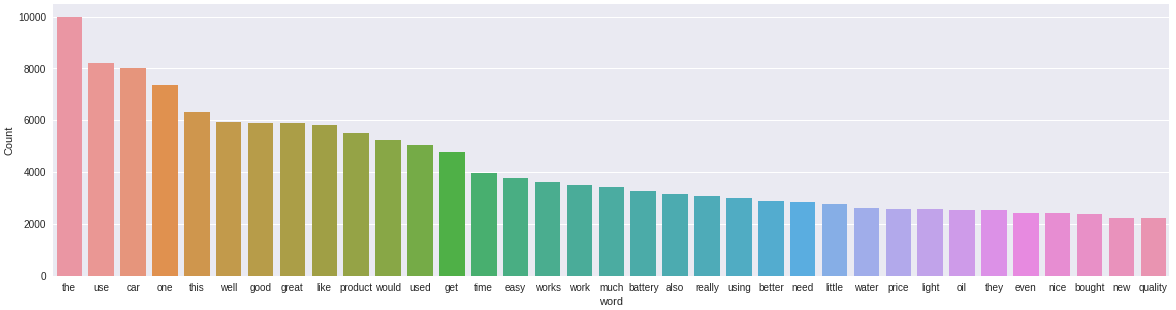
Wir können hier einige Verbesserungen sehen. Begriffe wie „Batterie“, „Preis“, „Produkt“, „Öl“, die für die Kategorie Automotive durchaus relevant sind. Aber trotzdem, todavía tenemos términos neutrales como ‚das‘, ‚Das‘, ‚viel‘, ‚Sie‘ das ist nicht so relevant.
Um das Rauschen weiter aus dem Text zu entfernen, wir können die Lemmatisierung aus der spaCy-Bibliothek verwenden. Reduziere jedes gegebene Wort auf seine Grundform, wodurch mehrere Formen eines Wortes auf ein einziges Wort reduziert werden.
!python -m spacy herunterladen de # einmal laufen
nlp = spacy.load('en', deaktivieren=['parser', 'ner'])

def-Lemmatisierung(Texte, tags=['NOUN', 'ADJ']): # filter noun and adjective
       output = []
       for sent in texts:
             doc = nlp(" ".beitreten(gesendet))
             output.append([token.lemma_ für Token im Dokument, wenn token.pos_ in Tags])
       return output
Lassen Sie uns Bewertungen tokenisieren und dann tokenisierte Bewertungen lemmatisieren.
tokenized_reviews = pd.Series(Bewertungen).anwenden(Lambda x: x.split())
drucken(tokenized_reviews[1])
['these', 'long', 'cables', 'work', 'fine', 'truck', 'qualität', 'seems', 'little', 'shabby',
'side', 'for', 'money', 'expecting', 'dollar', 'snap', 'jumper', 'cables', 'seem', 'like',
'would', 'see', 'chinese', 'knock', 'shop', 'like', 'harbor', 'freight', 'bucks']
reviews_2 = Lemmatisierung(tokenized_reviews)
drucken(Bewertungen_2[1]) # Lemmatisierte Rezension drucken
['long', 'cable', 'fine', 'truck', 'qualität', 'little', 'shabby', 'side', 'money', 'dollar',
'jumper', 'cable', 'chinese', 'shop', 'harbor', 'freight', 'buck']
Wie du siehst, Wir haben nicht nur die Wörter lemmatisiert, aber wir haben auch nur Nomen und Adjektive gefiltert. Lassen Sie uns die Token aus den Slogan-Rezensionen entfernen und die häufigsten Wörter nachverfolgen.
Bewertungen_3 = []
für mich in Reichweite(len(Bewertungen_2)):
    Bewertungen_3.anhängen(' '.join(Bewertungen_2[ich]))

df['reviews'] = Bewertungen_3

freq_words(df['reviews'], 35)
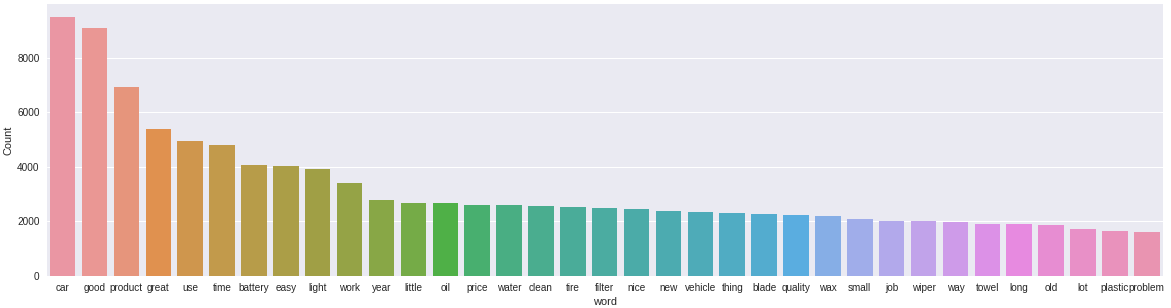
Es scheint, dass jetzt die häufigsten Begriffe in unseren Daten relevant sind. Jetzt können wir loslegen und mit dem Aufbau unseres Themenmodells beginnen.
Erstellen eines LDA-Modells
Wir beginnen mit der Erstellung des Wörterbuchs der Begriffe unseres Korpus, donde a cada término único se le asigna un IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht....
Wörterbuch = corpora.Wörterbuch(Bewertungen_2)
Später, wir werden die Revisionsliste konvertieren (Bewertungen_2) in einer Matrix von Dokumentbegriffen unter Verwendung des oben vorbereiteten Wörterbuchs.
doc_term_matrix = [Wörterbuch.doc2bow(Rev) für Rev in Bewertungen_2]
# Erstellen des Objekts für das LDA-Modell mit der Gensim-Bibliothek
LDA = gensim.models.ldamodel.LdaModel

# LDA-Modell erstellen
lda_model = LDA(Korpus=doc_term_matrix, id2word=Wörterbuch, num_topics=7, random_state=100,
                chunksize=1000, Durchgänge=50)
Der obige Code dauert eine Weile. Beachten Sie, dass ich die Anzahl der Themen als angegeben habe 7 für dieses Modell mit dem Anzahl_Themen Parameter. Sie können eine beliebige Anzahl von Themen mit demselben Parameter angeben.
Wir drucken die Themen, die unser LDA-Modell gelernt hat.
lda_model.print_topics()
[(0, '0.030*"Wagen" + 0.026*"Öl" + 0.020*"Filter" + 0.018*"Motor" + 0.016*"Gerät" + 0.013*"Code"
+ 0.012*"Fahrzeug" + 0.011*"App" + 0.011*"Veränderung" + 0.008*"bosch"'),
(1, '0.017*"einfach" + 0.014*"Installieren" + 0.014*"Tür" + 0.013*"Band" + 0.013*"Jeep" + 0.011*"Vorderseite" +
0.011*"Matte" + 0.010*"Seite" + 0.010*"Scheinwerfer" + 0.008*"fit"'),
(2, '0.054*"Klinge" + 0.045*"Wischer" + 0.019*"Windschutzscheibe" + 0.014*"Regen" + 0.012*"Schnee" +
0.012*"gut" + 0.011*"Jahr" + 0.011*"alt" + 0.011*"Wagen" + 0.009*"Zeit"'),
(3, '0.044*"Wagen" + 0.024*"Handtuch" + 0.020*"Produkt" + 0.018*"sauber" + 0.017*"gut" + 0.016*"Wachs" +
0.014*"Wasser" + 0.013*"benutzen" + 0.011*"Zeit" + 0.011*"waschen"'),
(4, '0.051*"hell" + 0.039*"Batterie" + 0.021*"Birne" + 0.019*"Energie" + 0.018*"Wagen" + 0.014*"hell"
+ 0.013*"Einheit" + 0.011*"Ladegerät" + 0.010*"Telefon" + 0.010*"aufladen"'),
(5, '0.022*"Reifen" + 0.015*"Schlauch" + 0.013*"benutzen" + 0.012*"gut" + 0.010*"einfach" + 0.010*"Druck" +
0.009*"klein" + 0.009*"Anhänger" + 0.008*"nett" + 0.008*"Wasser"'),
(6, '0.048*"Produkt" + 0.038*"gut" + 0.027*"Preis" + 0.020*"groß" + 0.020*"Leder" +
0.019*"Qualität" + 0.010*"Arbeit" + 0.010*"Rezension" + 0.009*"Amazonas" + 0.009*"Wert"')]
Das vierte Thema Thema 3 hat Begriffe wie „Handtuch“, „Aufräumen“, „Cera“, „Wasser“, was darauf hindeutet, dass das Thema eng mit der Autowäsche verbunden ist. Ähnlich, Thema 6 scheint mit dem Gesamtwert des Produkts zu tun zu haben, da es Begriffe wie . hat „Preis“, „Qualität“ Ja „Wert“.
Themen anzeigen
Um unsere Themen in einem zweidimensionalen Raum zu visualisieren, verwenden wir die pyLDavis-Bibliothek. Diese Visualisierung ist interaktiv und zeigt Themen zusammen mit den relevantesten Wörtern an..
# Visualisiere die Themen
pyLDAvis.enable_notebook()
vis = pyLDAvis.gensim.prepare(lda_model, doc_term_matrix, Wörterbuch)
vis

Der vollständige Code ist verfügbar hier.
Andere Methoden, um Online-Bewertungen zu nutzen
Neben Modellierungsthemen, Es gibt viele andere NLP-Methoden, die verwendet werden, um Online-Bewertungen zu analysieren und zu verstehen. Einige davon sind unten aufgeführt:
- Textzusammenfassung: Fassen Sie Rezensionen in einem Absatz oder einigen Aufzählungspunkten zusammen.
- Entitätserkennung: Extrahieren Sie Entitäten aus Bewertungen und identifizieren Sie, welche Produkte am beliebtesten sind (oder unbeliebt) bei den Verbrauchern.
- Identifizieren Sie aufkommende Trends: Nach dem Zeitstempel der Bewertungen, neue und aufkommende Themen oder Entitäten können identifiziert werden. So könnten wir herausfinden, welche Produkte an Popularität gewinnen und welche ihren Einfluss auf den Markt verlieren..
- Stimmungsanalyse: Für Händler, Das Verständnis der Meinung von Bewertungen kann bei der Verbesserung Ihrer Produkte und Dienstleistungen hilfreich sein.
Was kommt als nächstes?
Das Abrufen von Informationen erspart uns die Mühe, Produktbewertungen einzeln zu überprüfen. Es gibt uns eine klare Vorstellung davon, was andere Verbraucher über das Produkt sprechen.
Aber trotzdem, sagt uns nicht, ob die Bewertungen positiv sind, neutral oder negativ. Dies wird zu einer Erweiterung des Informationsabrufproblems, bei dem wir nicht nur die Probleme extrahieren müssen, sondern auch das Gefühl bestimmen. Dies ist eine interessante Aufgabe, die wir im nächsten Artikel behandeln werden..
Abschließende Anmerkungen
Topic Modeling ist eine der beliebtesten NLP-Techniken mit verschiedenen realen Anwendungen, als Dimensionsreduktion, Textzusammenfassung, Empfehlungsmaschine, etc. Der Zweck dieses Artikels war es, die Anwendung von LDA in durch Crowd generiertem Klartext zu demonstrieren. Daten. Ich ermutige Sie, den Code in andere Datensätze zu implementieren und Ihre Ergebnisse zu teilen.
Wenn Sie Vorschläge haben, Fragen oder alles andere, was Sie zur Themenmodellierung teilen möchten, Fühlen Sie sich frei, den Kommentarbereich unten zu verwenden.
Wenn Sie in den Bereich der Verarbeitung natürlicher Sprache einsteigen möchten, dann haben wir a Videokurs für Sie entwickelt, um die Textvorverarbeitung abzudecken, Themenmodellierung, Anerkennung benannter Entitäten, tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... para PNL y muchos más temas.





