
Dieser Beitrag wurde im Rahmen der . veröffentlicht Data Science Blogathon.
Finden Sie KI und ML interessant??
Sind Sie daran interessiert, Ingenieur für maschinelles Lernen zu werden?? Hast du Programmiersprachen wie Python oder R . gelernt?, hat aber Schwierigkeiten vorwärts zu kommen? (Dies geschieht hauptsächlich bei Autodidakten). Finden Sie Wörter wie Statistik einschüchternd?, Wahrscheinlichkeit und Regression? Es ist absolut verständlich, sich so zu fühlen, vor allem, wenn Sie einen nicht technischen Hintergrund haben. Aber dafür gibt es eine Lösung. Und es ist …. anfangen. Erinnern, wenn es nie anfängt, du wirst nie fehler machen und vielleicht nie lernen. Also fang klein an.
Einfache lineare Regression
Wann verwenden wir LR?
Wir werden ein einfaches Modell für maschinelles Lernen mit linearer Regression erstellen. Aber bevor wir zum Coding-Teil übergehen, Schauen wir uns die Grundlagen und die Logik dahinter an. Regression wird im überwachten maschinellen Lernalgorithmus verwendet, welches ist der derzeit am häufigsten verwendete Algorithmus. Die Regressionsanalyse ist eine Methode, bei der wir eine Verbindung herstellen zwischen einer VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... abhängig (Ja) und eine unabhängige Variable (x); was es uns ermöglicht, die Ergebnisse vorherzusagen und zu prognostizieren. Erinnerst du dich an das Lösen von Gleichungen wie y = mx + c deiner Schulzeit? Wenn ja, Herzliche Glückwünsche. Sie kennen bereits die einfache lineare Regression. Wenn dies nicht der Fall ist, gar nicht schwer zu lernen.
Betrachten wir ein beliebtes Beispiel. Die Anzahl der in das Studium investierten Stunden und die in der Prüfung erhaltenen Noten. Unter diesen Umständen, Die erzielten Noten hängen von der Anzahl der Stunden ab, die der Student in das Studium investiert, deshalb, die erhaltenen Noten sind die abhängige Variable y und die Stundenzahl ist die unabhängige Variable x. Ziel ist es, ein Modell zu entwickeln, das uns hilft, die erzielten Noten für eine neu festgelegte Stundenzahl vorherzusagen.. Wir werden es mit der linearen Regression erreichen.
Um dieses Konzept ganz klar zu sagen, Betrachten wir ein anderes Beispiel. In einem Datensatz mit der verbrauchten Kalorienmenge und der Gewichtszunahme, die Gewichtszunahme hängt von den Kalorien ab, die eine Person verbraucht. Deswegen, die Gewichtszunahme ist die abhängige Variable y und die Kalorienzahl ist die unabhängige Variable x.
y = mx + c ist die Gleichung der Regressionsgerade, die am besten zu den Daten passt und, manchmal, außerdem wird es dargestellt als y = b0 + B1x. Hier,
y ist die abhängige Variable, unter diesen Umständen, die erzielten Noten.
x ist die unabhängige Variable, unter diesen Umständen, die Anzahl der Stunden.
mo b1 ist die Steigung der Regressionsgeraden und der Koeffizient der unabhängigen Variablen.
c o b0 ist der Schnittpunkt der Regressionsgeraden.
Die Logik besteht darin, die Steigung zu berechnen (m) und abfangen (C) mit den verfügbaren Daten und dann können wir den Wert von y für jeden Wert von x . berechnen.
Python-Pakete und -Codes erforderlich
Jetzt, So führen Sie eine lineare Regression in Python durch? Wir müssen einige Pakete importieren, nämlich NumPy mit Matrizen arbeiten, Sklearn lineare Regression durchführen, Ja Matplotlib um die Regressionslinie und die Graphen zu zeichnen. Beachten Sie, dass es fast unmöglich ist, jedes Paket und jede Bibliothek in Python zu kennen, speziell für Anfänger. Deswegen, es wird empfohlen, immer nach dem richtigen Paket zu suchen, wenn es für eine Aufgabe benötigt wird. Es ist einfacher, sich daran zu erinnern, Pakete mit praktischer Erfahrung zu verwenden, anstatt nur theoretisch die dazu verfügbaren Dokumentationen zu lesen.
Weiter zum Codierungsteil. Der erste Schritt besteht darin, die erforderlichen Pakete zu importieren.
numpy als np importieren
import matplotlib.pyplot als plt
aus sklearn.linear_model import LinearRegression
In Anbetracht dessen, dass dies Ihr erstes Modell für maschinelles Lernen ist, Wir werden einige Komplikationen beseitigen, indem wir eine sehr kleine Probe nehmen, Anstatt Daten aus einem DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten.... Großartig. Dies wird auch dazu beitragen, das Ergebnis in der Grafik klar zu erkennen und das Konzept effektiv zu würdigen..
xpuntos = np.array ([10, 11, 12, 13, 14, 15]) .Reform (-1,1)
ypoints = np.array ([53, 52, 60, 63, 72, 70])
Beachten Sie, dass wir die xpunkte haben eine Spalte und viele Zeilen. Der Prädiktor (x) muss ein Array von Arrays sein und die Lösung (Ja) kann eine einfache Matrix sein.
Eine Variable Linreg wird als Instanz von . erstellt Lineare Regression. Es kann optionale Parameter annehmen. Sie werden für dieses Beispiel nicht benötigt, Also werden wir sie ignorieren. Wie der Name schon sagt, das .hineinpassen() Die Methode passt sich dem Modell an und wird verwendet, um einige der Modellparameter zu schätzen, Das heißt, es berechnet den optimierten Wert von myc unter Verwendung der gegebenen Daten.
linreg = LinearRegression()
linreg.fit(xpunkte, ypunkte)
.Vorhersagen() Die Methode wird verwendet, um die vorhergesagte Lösung unter Verwendung des Modells zu erhalten und nimmt den Prädiktor xpunkte als Argument.
y_pred = linreg.predict(xpunkte)
Jetzt, drucken y_pred und beachte, dass die Werte ziemlich nah dran sind Punkte. Wenn die vorhergesagten und tatsächlichen Antworten einen Wert nahe haben, bedeutet, dass das Modell genau ist. Im Idealfall, die prognostizierten und tatsächlichen Antwortwerte würden sich überschneiden.
Das Pyplot-Modul aus der Matplotlib-Bibliothek wurde als plt importiert. So können wir die Graphen einfach mit .Dispersion() was braucht xpunkte Ja Punkte als Argumente. Plotten Sie die reale Lösung. Die vorhergesagte Lösung wird aufgetragen mit.Handlung() Funktion. Das Diagramm kann beschriftet werden mit.xlabel Ja .ylabel.
plt.streuung (x Punkte, Punkte und)
plt.plot (x Punkte, y_pred)
plt.xlabel („x Punkte“)
plt.ylabel („Punkte und“)
plt.zeigen ()
plt.zeigen () zeigt alle Objekte von Abbildung"Abbildung" ist ein Begriff, der in verschiedenen Zusammenhängen verwendet wird, Von der Kunst zur Anatomie. Im künstlerischen Bereich, bezieht sich auf die Darstellung menschlicher oder tierischer Formen in Skulpturen und Gemälden. In der Anatomie, bezeichnet die Form und Struktur des Körpers. Was ist mehr, in der Mathematik, "Abbildung" Es hängt mit geometrischen Formen zusammen. Seine Vielseitigkeit macht es zu einem grundlegenden Konzept in mehreren Disziplinen.... Zu diesem Zeitpunkt aktiv.
Attribute .coef_ Ja .abfangen_ gibt die Steigung an, die auch der Koeffizient von x . ist, und der Schnittpunkt von y. Es bedeutet, dass y = c = 8.80, Über, wenn x = 0 und y = 4.22 (1) + 8.80 = 13.02 (Über) wenn x = 1. Beachten Sie, dass in der Ausgabe der Schnitt skalar und der Koeffizient eine Matrix ist.
drucken(linreg.coef_)
drucken(linreg.intercept_)
Wir haben unser Modell gebaut. Versuchen Sie nun, die Lösung vorherzusagen y_neu für einen neuen Prädiktorwert x_neu = 16. Dort! Wir haben ein Modell, das die Lösung für jeden gegebenen Prädiktor vorhersagen kann.
x_new = np.array ([16]) .Reform (-1,1)
y_new = linreg.predict (x_neu)
zu drucken (y_neu)
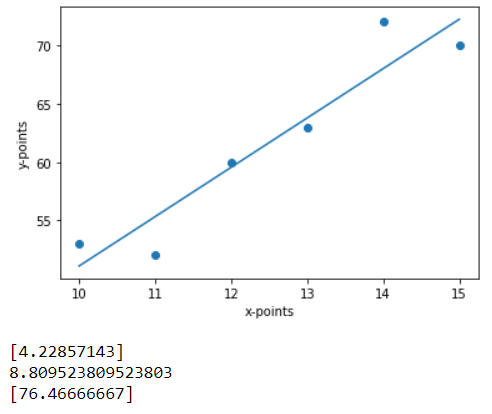
Das Bild oben zeigt, wie das Endergebnis aussehen könnte. Das 3 Ausgaben unter der Grafik sind die Lösung für unsere Drucken() Aussagen. Dann stehen sie an, Kreuzung und y_neu beziehungsweise.
Die Gleichung der Regressionsgeraden lautet y = 4,23x + 8,80. Dann, nach der Gleichung, wenn x = 16,
y = 4,23 * (16) + 8,80 = 76,48. Der kleine Unterschied in der Berechnung liegt an den Dezimalpunkten.
Wir können benutzen .Spielstand() Methode, die x und y als ihre 2 Argumente, um R . zu finden2 oder das Bestimmtheitsmaß. Bester Wert für R2 es ist 1.0 und es kann auch negative Werte annehmen, da das modell schlechter sein kann. Ein näherer Wert von R2 ein 1.0 zeigt die Effizienz unseres Modells an.
linreg.score(xpunkte, ypunkte)
Führen Sie den Code aus und Sie werden sehen, dass der Wert von R2 es ist 0,89, die Modellvorhersage ist also zuverlässig.
Was kommt als nächstes?
Dies ist so einfach wie eine lineare Regression. Es ist nicht der einzige Weg, aber es schien mir der einfachste und einfachste Weg. Hör hier nicht auf. Wenn du dich damit wohl fühlst, Sie können noch einen Schritt weiter gehen und einen größeren Datensatz betrachten. Als Beispiel, eine CSV-Datei. Sie müssen mit arbeiten Pandas und NumPy-Pakete in diesem Fall. Dann, Sie können ein lineares oder multiples logistisches Regressionsmodell testen. Lerne und übe weiter.
Die in diesem Beitrag gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





