
Ziel
- Boosting ist eine gemeinsame Lerntechnik, bei der jedes Modell versucht, die Fehler des vorherigen Modells zu korrigieren.
- Erfahren Sie mehr über den Boosting-Algorithmus SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in... und die Mathematik dahinter.
Einführung
In diesem Artikel, Wir werden einen Algorithmus diskutieren, der in der Impulstechnik funktioniert, der Gradientenerhöhungsalgorithmus. Es ist besser bekannt als Gradient Boosting Machine oder GBM.
Notiz: Wenn Sie mehr daran interessiert sind, Konzepte in einem audiovisuellen Format zu lernen, wir haben diesen vollständigen Artikel im Video unten erklärt. Wenn dies nicht der Fall ist, du kannst weiterlesen.
Die Modelle in Gradient Boosting Machine werden sequentiell gebaut und jedes dieser späteren Modelle versucht, den Fehler des Vorgängermodells zu reduzieren. Aber die Frage ist, wie jedes Modell den Fehler des vorherigen Modells reduziert? Dies geschieht, indem das neue Modell auf Fehlern oder Residuen der vorherigen Vorhersagen erstellt wird.
Dies geschieht, um festzustellen, ob der Fehler Muster enthält, die das vorherige Modell ignoriert. Lass uns das an einem Beispiel verstehen.
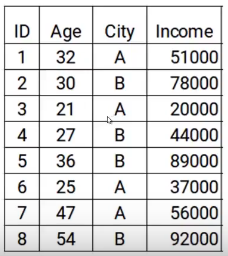
Hier haben wir die Daten mit zwei Merkmalen: Alter und Stadt, und das VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... das Ziel ist das Einkommen. Dann, je nach Stadt und Alter der Person, wir müssen das einkommen vorhersagen. Beachten Sie, dass während des gesamten Prozesses der Erhöhung des Gradienten, wir werden folgendes aktualisieren: das Ziel des Modells, das Residuum des Modells und der Vorhersage.
Schritte zum Erstellen des Modells der Gradientenerweiterungsmaschine
Um das Verständnis der Gradienten-Augmentationsmaschine zu vereinfachen, Wir haben den Prozess in fünf einfache Schritte unterteilt.
Paso 1
Der erste Schritt besteht darin, ein Modell zu erstellen und Vorhersagen zu den gegebenen Daten zu treffen.. Kommen wir zurück zu unseren Daten, für das erste Modell, das Ziel ist der in den Daten angegebene Einkommenswert. Dann, Ich habe das Ziel als ursprüngliche Einkommenswerte festgelegt.
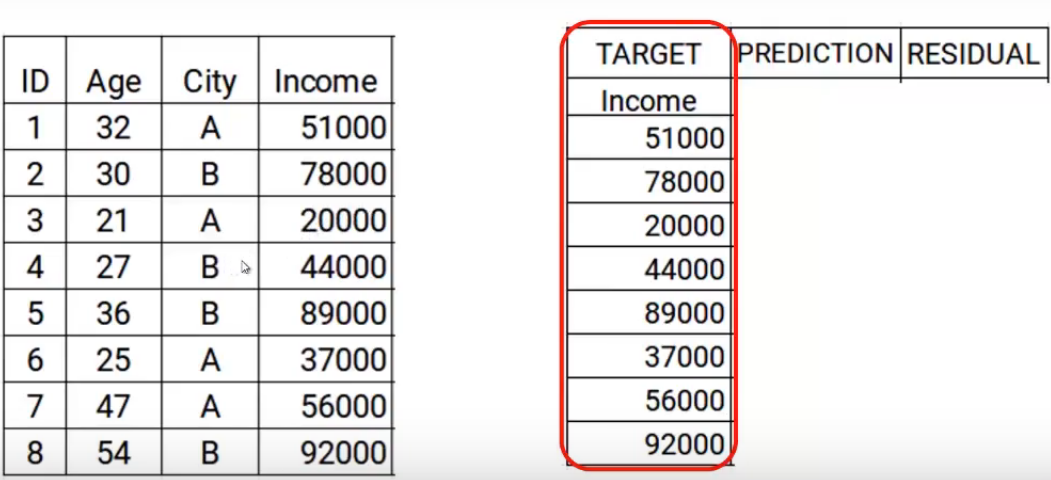
Jetzt bauen wir das Modell anhand der Alters- und Stadtmerkmale mit dem Zieleinkommen auf. Dieses trainierte Modell wird in der Lage sein, eine Reihe von Vorhersagen zu generieren. Welche werden wie folgt angenommen.
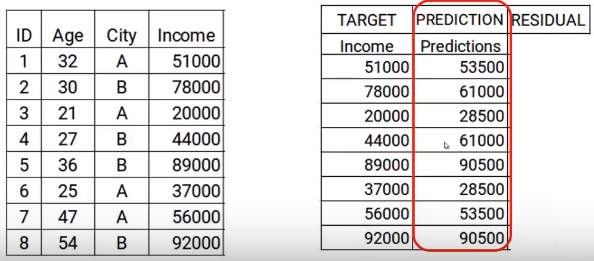
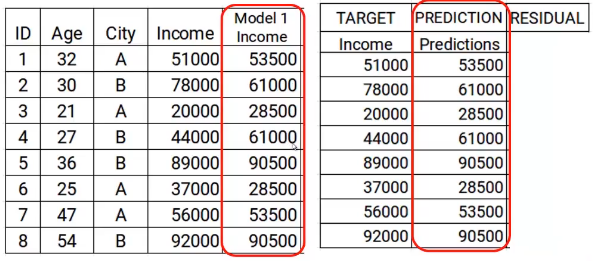
Jetzt werde ich diese Vorhersagen mit meinen Daten speichern. Hier mache ich den ersten Schritt.
Paso 2
Der nächste Schritt besteht darin, diese Vorhersagen zu verwenden, um den Fehler zu erhalten, später als Ziel verwendet werden. Im Moment haben wir die Werte des Realeinkommens und die Vorhersagen des Modells1. Verwenden dieser Spalten, Wir berechnen den Fehler einfach durch Subtrahieren des tatsächlichen Umsatzes und der Umsatzprognosen. A wird unten gezeigt.
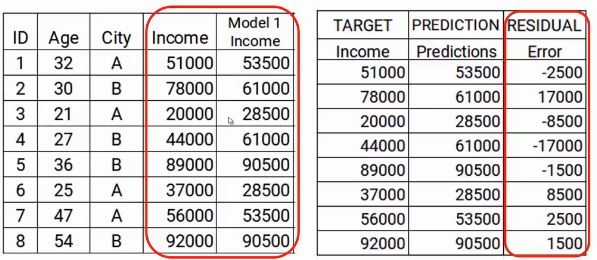
Wie bereits erwähnt, aufeinanderfolgende Modelle konzentrieren sich auf Fehler. Dann, Fehler hier werden unser neues Ziel sein. Das deckt Schritt zwei ab.
Paso 3
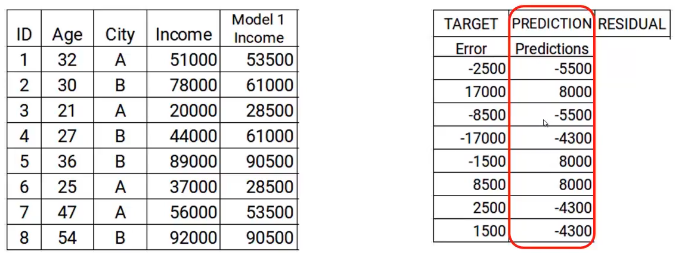
Im nächsten Schritt, Wir werden ein Modell für diese Fehler erstellen und die Vorhersagen treffen. Hier besteht die Idee darin, festzustellen, ob der Fehler versteckte Muster enthält.
Dann, unter Verwendung des Fehlers als Ziel und der ursprünglichen Merkmale Alter und Stadt, wir werden neue Vorhersagen generieren. Beachten Sie, dass die Vorhersagen, in diesem Fall, werden die Fehlerwerte sein, nicht erwartete Umsatzwerte, denn unser Ziel ist der Fehler. Nehmen wir an, das Modell gibt die folgenden Vorhersagen
Paso 4
Jetzt müssen wir die Vorhersagen von model1 . aktualisieren. Wir fügen die Vorhersage aus dem vorherigen Schritt hinzu und fügen sie der Vorhersage von model1 hinzu und nennen sie Model2 Income.
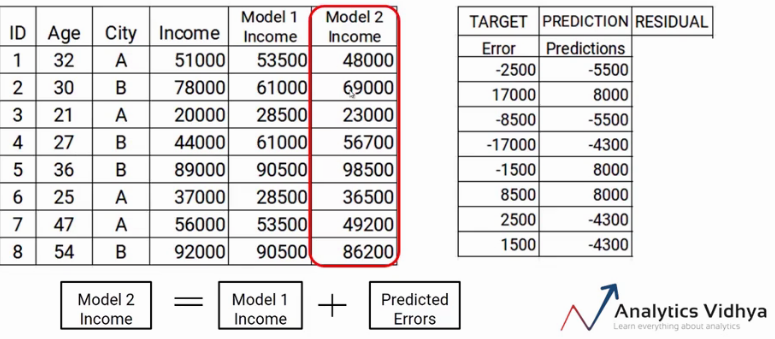
Wie du siehst, meine neuen Vorhersagen sind näher an den wahren Werten meines Einkommens.
Schließlich, wir werden die schritte wiederholen 2 ein 4, was bedeutet, dass wir neue Fehler berechnen und diesen neuen Fehler als Ziel festlegen. Wir werden diesen Vorgang wiederholen, bis der Fehler Null ist oder wir das Stoppkriterium erreicht haben, das sagt die Anzahl der Modelle die wir bauen wollen. Dies ist der schrittweise Prozess zum Erstellen eines Gradientenerhöhungsmodells..
In einer Nussschale, wir bauen unser erstes Modell mit den Merkmalen x und Ziel y, Nennen wir dieses Modell H0, das eine Funktion von x und y ist. Dann bauen wir das nächste Modell auf den Fehlern des letzten Modells und ein drittes Modell auf den Fehlern des vorherigen Modells auf und so weiter. Bis wir n Modelle bauen.
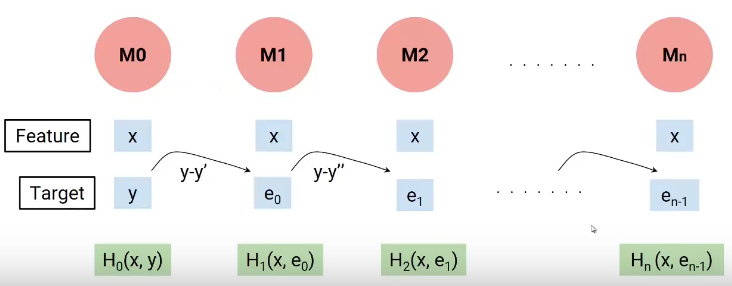
Jedes nachfolgende Modell arbeitet an den Fehlern aller vorherigen Modelle, um zu versuchen, Muster im Fehler zu identifizieren.. effektiv, Ich kann sagen, dass jedes dieser Modelle einzelne Funktionen sind, die die unabhängige Variable x als Merkmal haben und das Ziel ist der Fehler des vorherigen kombinierten Modells.
Dann, um die endgültige Gleichung unseres Modells zu bestimmen, wir bauen unser erstes H0-Modell, was mir einige Vorhersagen gab und einige Fehler erzeugte. Nennen wir dieses kombinierte Ergebnis F0 (x).
Jetzt erstellen wir unser zweites Modell und fügen neue vorhergesagte Fehler zu F0 . hinzu (x), diese neue Funktion ist F1 (x). Ähnlich, wir bauen folgendes Modell und so weiter, bis wir n Modelle haben, wie unten gezeigt.
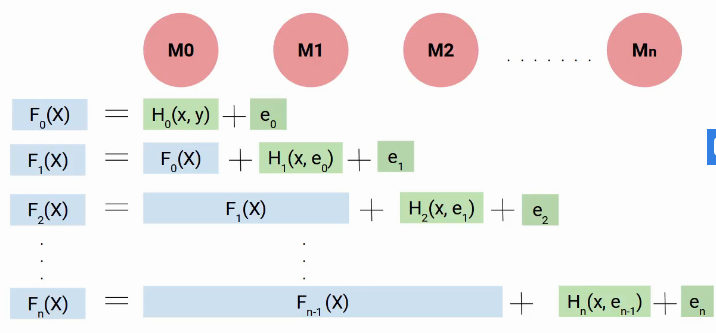
Dann, in jedem Schritt, Wir versuchen die Fehler zu modellieren, was uns hilft, den Gesamtfehler zu reduzieren. Im Idealfall, wir wollen, dass dies ‚In‘ Null sein. Wie du siehst, Jedes Modell hier versucht, die Leistung des Modells zu erhöhen, Daher, Wir verwenden den Begriff Impuls.
Aber warum verwenden wir den Begriff Gradient?, hier ist der trick. Anstatt diese Modelle direkt hinzuzufügen, wir addieren sie mit Gewicht oder Koeffizient, und der richtige Wert dieses Koeffizienten wird unter Verwendung der Gradientenerhöhungstechnik bestimmt.
Deswegen, eine verallgemeinerte Form unserer Gleichung sieht wie folgt aus.
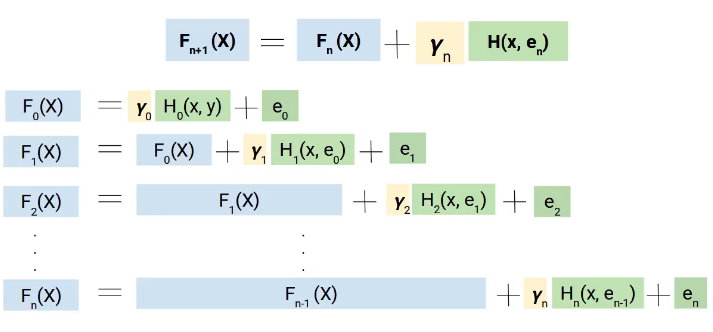
Die Mathematik hinter der Gradient Boosting Machine
Ich hoffe, Sie haben jetzt eine grobe Vorstellung davon, wie die Gradientenerweiterung funktioniert. Von jetzt an, Wir werden uns darauf konzentrieren, wie der Wert von Yn berechnet wird.
Wir verwenden die Gradientenabstiegstechnik, um die Werte dieser Gammakoeffizienten zu erhalten (Ja), so ist, dass wir die Verlust-FunktionDie Verlustfunktion ist ein grundlegendes Werkzeug des maschinellen Lernens, das die Diskrepanz zwischen Modellvorhersagen und tatsächlichen Werten quantifiziert. Ziel ist es, den Trainingsprozess zu steuern, indem dieser Unterschied minimiert wird, Dadurch kann das Modell effektiver lernen. Es gibt verschiedene Arten von Verlustfunktionen, wie z. B. mittlerer quadratischer Fehler und Kreuzentropie, jeder für unterschiedliche Aufgaben geeignet und.... Lassen Sie uns nun in diese Gleichung eintauchen und die Rolle der Verlustfunktion und des Gammas verstehen.
Hier, Die von uns verwendete Verlustfunktion ist (y-y ‚) 2. y ist der tatsächliche Wert und y ‚ist der endgültige vom letzten Modell vorhergesagte Wert. Dann, wir können y ‚durch Fn ersetzen (x) was das tatsächliche Ziel abzüglich der aktualisierten Vorhersagen aller Modelle darstellt, die wir bisher erstellt haben.
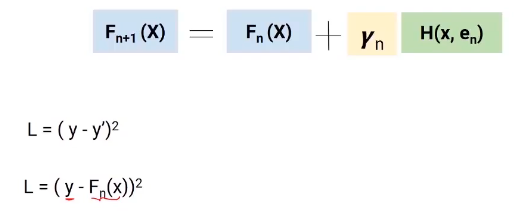
Teildifferenzierung
Ich denke, Sie kennen den Gradientenabstiegsprozess, da wir das gleiche Konzept verwenden werden. Wir differenzieren die Gleichung von L nach Fn (x), Sie erhalten die folgende Gleichung, was auch als Pseudoresiduum bekannt ist. Wie groß ist der negative Gradient der Verlustfunktion.
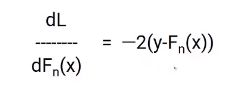
Um dies zu vereinfachen, wir multiplizieren beide seiten mit -1. Das Ergebnis wird in etwa so aussehen.
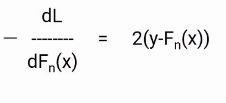
Jetzt, wir wissen, dass der Fehler in unserer Gleichung für Fn + 1 (x) ist der tatsächliche Wert abzüglich der aktualisierten Vorhersagen aller Modelle. Deswegen, wir können das en in unserer endgültigen Gleichung durch diese Pseudo-Residuen ersetzen, wie im Bild unten gezeigt.
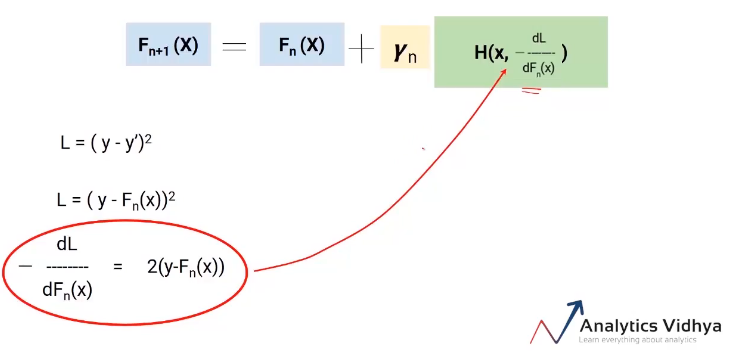
Das ist also unsere letzte Gleichung. Das Beste an diesem Algorithmus ist, dass er Ihnen die Freiheit gibt, die Verlustfunktion zu bestimmen. Einzige Bedingung ist, dass die Verlustfunktion differenzierbar ist. Um das Verständnis zu erleichtern, wir verwenden eine sehr einfache Verlustfunktion (y-y ‚) 2 aber Sie können es in Scharnierverlust oder Logitverlust oder was auch immer ändern.
Ziel ist es, den Totalverlust zu minimieren. Mal sehen, wie hoch der Totalschaden hier wäre, wird der Verlust an Modell n plus der Verlust des aktuellen Modells sein, das wir bauen. Hier ist die Gleichung.
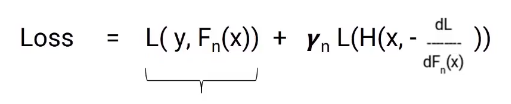
In dieser Gleichung, der erste teil ist fest, aber der zweite Teil ist der Verlust des Modells an dem wir gerade arbeiten. Der Verlust dieses Modells ist immer noch nicht zu ändern, aber wir können den Wert von gamma . ändern. Jetzt müssen wir den Gammawert so wählen, dass der Gesamtverlust minimiert wird und dieser Wert wird durch das Gradientenabstiegsverfahren ausgewählt.
Dann, Die Idee ist, den Gesamtverlust zu reduzieren, indem der optimale Gammawert für jedes von uns gebaute Modell festgelegt wird.
Entscheidungsbaum für Gradientenerweiterung
Ich spreche von einem Sonderfall des Gradientenanstiegs, nämlich, Entscheidungsbaum für Gradientenvergrößerung (GBDT). Hier, jedes Modell wäre ein Baum und der Gammawert wird auf jeder Blattebene festgelegt, nicht auf der allgemeinen Ebene des Modells. Dann, wie im folgenden Bild gezeigt, jedes Blatt hätte einen Gammawert.
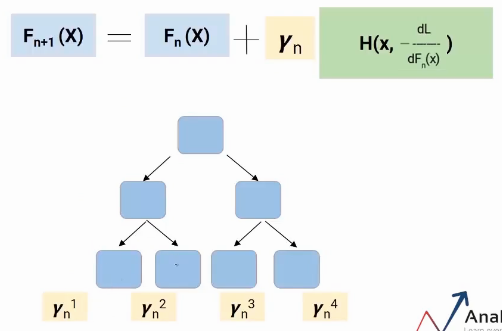
So funktioniert der Gradient Boosting Decision Tree.
Abschließende Anmerkungen
Boosting ist eine Form des gemeinsamen Lernens. Es ist ein sequenzieller Prozess, bei dem jedes Modell versucht, die Fehler des vorherigen Modells zu korrigieren. Dies bedeutet, dass jedes nachfolgende Modell von seinen Vorgängern abhängt.. In diesem Artikel, wir haben den Gradienten-Augmentationsalgorithmus und die Mathematik dahinter gesehen.
Wie wir eine klare Vorstellung vom Algorithmus haben, Versuchen Sie, die Modelle zu bauen und praktische Erfahrungen damit zu sammeln.
Wenn Sie Ihre Data Science-Reise beginnen möchten und alle Themen unter einem Dach haben möchten, deine Suche endet hier. Werfen Sie einen Blick auf den zertifizierten KI- und ML-BlackBelt von DataPeaker Plus Programm
Wenn du irgendeine Frage hast, lass es mich im Kommentarbereich wissen!
Wenn du irgendeine Frage hast, lass es mich in den Kommentaren unten wissen.





