
Open Source bezieht sich auf etwas, das Menschen ändern und teilen können, weil sie für jeden zugänglich sind. Sie können die Arbeit auf neue Weise nutzen, in ein größeres Projekt integrieren oder einen neuen Job nach dem Original finden. Open Source fördert den freien Ideenaustausch innerhalb einer Community, um Innovationen oder kreative und technologische Ideen zu generieren. Deswegen, Entwickler sollten aus folgenden Gründen in Erwägung ziehen, zu Open-Source-Projekten beizutragen::
1. Hilft Ihnen, saubereren Code zu schreiben.
2. Erlangt ein besseres Verständnis der Technologie.
3. Die Mitwirkung an Open-Source-Projekten hilft Ihnen, Aufmerksamkeit zu gewinnen, Popularität und kann auf Ihrer Karriere aufbauen.
4. Das Hinzufügen eines Open-Source-Projekts zu Ihrem Lebenslauf erhöht dessen Gewicht.
5. Programmierfähigkeiten verbessern
6. Verbessern Sie die Software auf Benutzer- und Unternehmensebene.
 Quelle: Google Bilder
Um zu Open-Source-Projekten beizutragen, es gibt einige voraussetzungen:
1. Lerne eine Programmiersprache: da Sie bei Open-Source-Beiträgen Code schreiben müssen, um sich an der Entwicklung zu beteiligen, muss eine Programmiersprache lernen. Das kann beliebig sein. Je nach Bedarf des Projekts ist es leicht, zu einem späteren Zeitpunkt eine weitere Sprache zu lernen.
2. Machen Sie sich mit Versionskontrollsystemen vertraut: Dies sind die Software-Tools, die dabei helfen, alle vorgenommenen Änderungen an einem Ort zu speichern, um sie bei Bedarf zu einem späteren Zeitpunkt abzurufen. Grundsätzlich, Verfolgen Sie jede Änderung, die Sie im Laufe der Zeit am Quellcode vorgenommen haben. Einige beliebte Versionskontrollsysteme sind Git, Mercurial, CVS, etc. Von all diesen, Git ist das beliebteste und am weitesten verbreitete in der Branche.
Jetzt werfen wir einen Blick auf einige der erstaunlichen Open-Source-Projekte, zu denen Sie beitragen können..
Dann legen wir los!
1. Caliban
Quelle: Google Bilder
Dies ist ein Machine-Learning-Projekt des Technologiegiganten Google. Wird verwendet, um Laptops und Forschungsworkflows für maschinelles Lernen in einer isolierten und reproduzierbaren Computerumgebung zu entwickeln. Ein großes Problem lösen. Wenn Entwickler Data Science-Projekte erstellen, Oft ist es schwierig, eine Testumgebung zu erstellen, die Ihr Projekt in einer realen Situation zeigen kann. Nicht alle Extremfälle sind vorhersehbar. Dann, Caliban ist eine mögliche Lösung für dieses Problem. Caliban macht es einfach, jedes Machine-Learning-Modell lokal zu entwickeln, Führen Sie Code auf Ihrem Computer aus und testen Sie dann genau denselben Code in einer Cloud-Umgebung, um ihn auf großen Computern auszuführen. Deswegen, Dockerisierte Untersuchungsworkflows werden vereinfacht, sowohl lokal als auch in der Cloud.
Github-Link: https://github.com/google/caliban
2. Cornia
Quelle: Google Bilder
Kornia ist eine Computer Vision Bibliothek für PyTorch. Wird verwendet, um einige allgemeine Computer Vision-Probleme zu lösen. Kornia basiert auf PyTorch und setzt auf dessen Effizienz und CPU-Power, um komplexe Funktionen berechnen zu können. Kornia ist ein Bibliothekspaket zum Trainieren von neuronalen Netzmodellen und zum Durchführen von Bildtransformationen, Bildfilterung, Kantenerkennung, epipolare Geometrie, Tiefenschätzung, etc.
Github-Link: https://github.com/kornia/kornia
3. Analyse Zoo
Quelle: Google Bilder
Analytics Zoo ist eine einheitliche Plattform für Datenanalyse und künstliche Intelligenz, die TensorFlow-Programme vereint, Schwer, PyTorch, Funke, Flink und Ray in einer integrierten Pipeline. Dies kann effizient von einem Laptop auf einen großen Laptop skaliert werden ClusterEin Cluster ist eine Gruppe miteinander verbundener Unternehmen und Organisationen, die im selben Sektor oder geografischen Gebiet tätig sind, und die zusammenarbeiten, um ihre Wettbewerbsfähigkeit zu verbessern. Diese Gruppierungen ermöglichen die gemeinsame Nutzung von Ressourcen, Wissen und Technologien, Förderung von Innovation und Wirtschaftswachstum. Cluster können sich über eine Vielzahl von Branchen erstrecken, Von der Technologie bis zur Landwirtschaft, und sind von grundlegender Bedeutung für die regionale Entwicklung und die Schaffung von Arbeitsplätzen.... zur Verarbeitung der Big-Data-Produktion. Dieses Projekt wird betreut von Intel-Analytik.
Analytics Zoo unterstützt eine KI-Lösung auf folgende Weise:
- Hilft Ihnen, KI-Modelle einfach zu prototypieren.
- Skalierung wird effizient verwaltet.
- Hilft beim Hinzufügen von Automatisierungsprozessen zu Ihrem ML-Kanal als Feature-Engineering, Auswahl an Modellen, etc.
Github-Link: https://github.com/intel-analytics/analytics-zoo
4. MLJAR Automatisiertes maschinelles Lernen für Menschen

Quelle: Google Bilder
Mljar ist eine Plattform zum Erstellen von Prototypmodellen und Implementierungsservices. Um das beste Modell zu finden, Mljar sucht nach verschiedenen Algorithmen und nimmt Hyperparameter-Anpassungen vor. Liefert interessante schnelle Ergebnisse, indem alle Berechnungen in der Cloud ausgeführt und schließlich Ensemble-Modelle erstellt werden. Später, erstellt für Sie einen Bericht aus dem AusbildungTraining ist ein systematischer Prozess zur Verbesserung der Fähigkeiten, körperliche Kenntnisse oder Fähigkeiten. Es wird in verschiedenen Bereichen angewendet, wie Sport, Aus- und Weiterbildung. Zu einem effektiven Trainingsprogramm gehört auch die Zielplanung, Regelmäßiges Üben und Bewerten der Fortschritte. Anpassung an individuelle Bedürfnisse und Motivation sind Schlüsselfaktoren, um in jeder Disziplin erfolgreiche und nachhaltige Ergebnisse zu erzielen.... AutoML. Ist das nicht cool?
Mljar trainiert effizient Modelle für die binäre Klassifikation, Mehrklassenklassifizierung, Rückschritt.
Es bietet zwei Arten von Schnittstellen:
- Sie können Modelle für maschinelles Lernen in Ihrem Webbrowser ausführen
- Bietet einen Python-Wrapper über die Mljar-API.
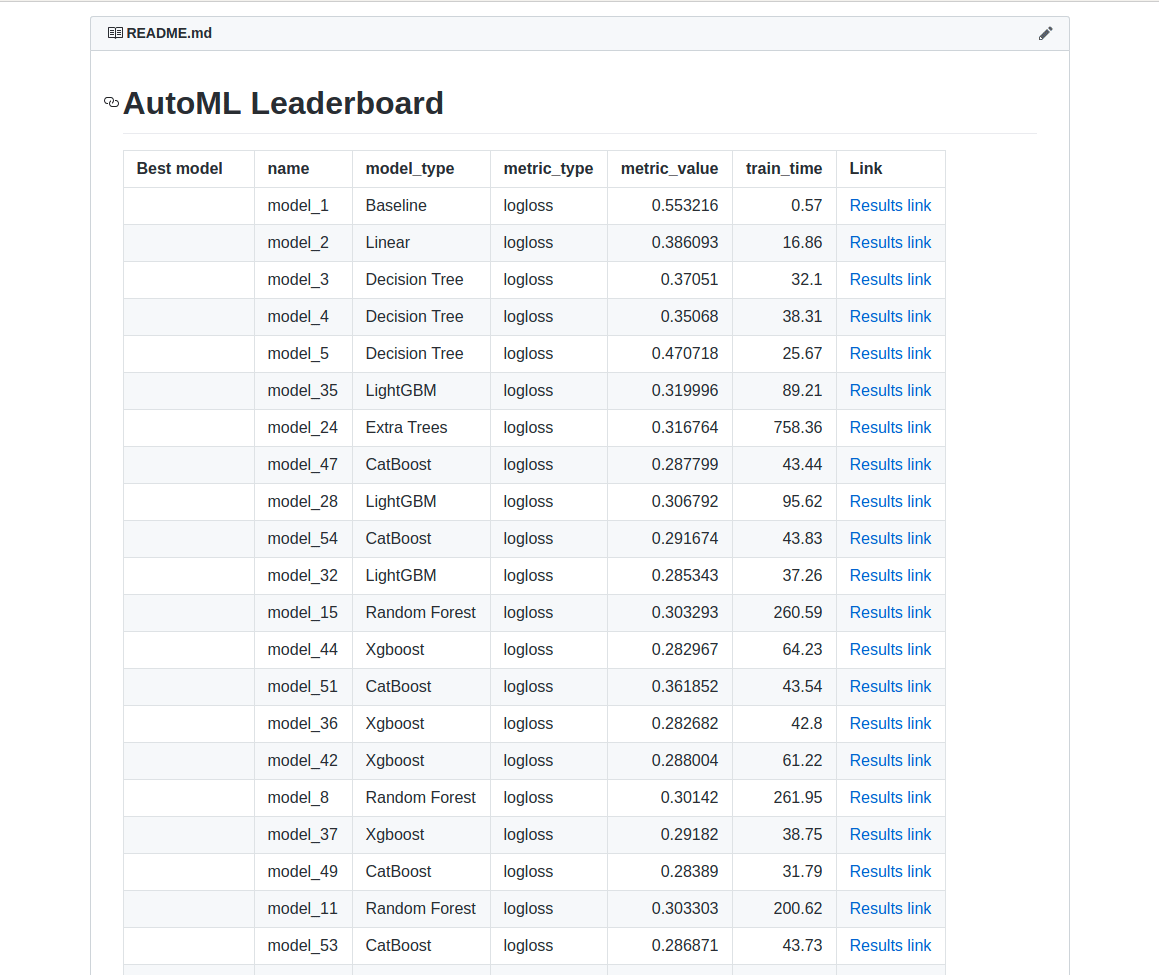
Der von Mljar erhaltene Bericht enthält die Tabelle mit Informationen über die Punktzahl jedes Modells und die Zeit, die zum Trainieren jedes Modells benötigt wird. Der Ertrag wird als Scatterplot und Boxplot angezeigt, macht es einfach, visuell zu überprüfen, welche Algorithmen von allen am besten funktionieren. Schau dir das an:
Quelle: Google Bilder
Dokumentation: https://überwacht.mljar.com/
Quellcode: https://github.com/mljar/mljar-supervised
5.DeepDetect
Quelle: Google Bilder
DeepDetect ist eine API und ein Server für maschinelles Lernen, die in C . geschrieben sind ++. Wenn Sie mit modernsten Machine-Learning-Algorithmen arbeiten und diese in bestehende Anwendungen integrieren möchten, DeepDetect ist für Sie. DeepDetect unterstützt eine Vielzahl von Aufgaben wie die Klassifizierung, SegmentierungDie Segmentierung ist eine wichtige Marketingtechnik, bei der ein breiter Markt in kleinere, homogenere Gruppen unterteilt wird. Diese Praxis ermöglicht es Unternehmen, ihre Strategien und Botschaften an die spezifischen Merkmale jedes Segments anzupassen, So verbessern Sie die Effektivität Ihrer Kampagnen. Das Targeting kann auf demografischen Kriterien basieren, psychografisch, geografisch oder verhaltensbezogen, Erleichterung einer relevanteren und persönlicheren Kommunikation mit der Zielgruppe...., Rückschritt, Objekterkennung, automatische Encoder. Unterstützt die tiefes LernenTiefes Lernen, Eine Teildisziplin der Künstlichen Intelligenz, verlässt sich auf künstliche neuronale Netze, um große Datenmengen zu analysieren und zu verarbeiten. Diese Technik ermöglicht es Maschinen, Muster zu lernen und komplexe Aufgaben auszuführen, wie Spracherkennung und Computer Vision. Seine Fähigkeit, sich kontinuierlich zu verbessern, wenn mehr Daten zur Verfügung gestellt werden, macht es zu einem wichtigen Werkzeug in verschiedenen Branchen, von Gesundheit... Überwachte und unüberwachte Bilder, Zeitfolgen, Text und einige andere Arten von Daten. Aber DeepDetect verlässt sich auf externe Bibliotheken für maschinelles Lernen wie:
- Deep-Learning-Bibliotheken: Tensorflow, Kaffee2, Fackel.
- Bibliothek der Vergrößerung SteigungGradient ist ein Begriff, der in verschiedenen Bereichen verwendet wird, wie Mathematik und Informatik, um eine kontinuierliche Variation von Werten zu beschreiben. In Mathematik, bezieht sich auf die Änderungsrate einer Funktion, während des Studiums im Grafikdesign, Gilt für den Farbübergang. Dieses Konzept ist unerlässlich, um Phänomene wie die Optimierung von Algorithmen und die visuelle Darstellung von Daten zu verstehen, ermöglicht eine bessere Interpretation und Analyse in...: XGBoost.
- Gruppierung mit T-SNE.
Github-Link: https://github.com/jolibrain/deepdetect
6. Dopamin

Quelle: Google Bilder
Dopamin ist ein Open-Source-Projekt des Technologieriesen Google. Es ist in Python geschrieben. Es handelt sich um ein Forschungsframework für das Rapid Prototyping von VerstärkungslernenReinforcement Learning ist eine Technik der künstlichen Intelligenz, die es einem Agenten ermöglicht, durch Interaktion mit einer Umgebung zu lernen, Entscheidungen zu treffen. Durch Feedback in Form von Belohnungen oder Bestrafungen, Der Agent optimiert sein Verhalten, um die kumulierten Belohnungen zu maximieren. Dieser Ansatz wird in einer Vielzahl von Anwendungen eingesetzt, Von Videospielen über Robotik bis hin zu Empfehlungssystemen, Er zeichnet sich durch seine Fähigkeit aus, komplexe Strategien zu erlernen.....
Die Gestaltungsprinzipien von Dopamin sind:
- Einfaches Experiment: Dopamin erleichtert neuen Nutzern die Durchführung von Experimenten.
- Es ist kompakt und zuverlässig.
- Es erleichtert auch die Reproduzierbarkeit der Ergebnisse.
- Es ist flexibel, Daher, macht es neuen Nutzern leicht, neue Forschungsideen auszuprobieren.
Notiz: Schau diese Kollaborative Notizbücher um zu lernen, wie man Dopamin verwendet.
Github-Link: https://github.com/google/dopamine
7. TensorFlow
Quelle: Google Bilder
Tensorflow ist das bekannteste, beliebt und eines der besten Open-Source-Machine-Learning-Projekte auf GitHub. Es ist eine Open-Source-Softwarebibliothek für numerische Berechnungen mit Datenflussdiagrammen. Es hat eine sehr einfach zu verwendende Python-Schnittstelle und keine unerwünschten Schnittstellen in anderen Sprachen, um Computergrafiken zu erstellen und auszuführen.. TensorFlow bietet stabile Python- und C-APIs ++. Tensorflow hat einige erstaunliche Anwendungsfälle wie:
- Bei der Spracherkennung / Klang
- Textbasierte Anwendungen
- Bilderkennung
- Videoerkennung
…und viele mehr!
GitHub-Link: https://github.com/tensorflow/tensorflow
8. VorhersageIO
Quelle: Google Bilder
Es basiert auf einem hochmodernen Open-Source-Stack. Dieser Machine-Learning-Server wurde für Data Scientists entwickelt, um prädiktive Engines für jede Machine-Learning-Aufgabe zu erstellen. Einige seiner erstaunlichen Funktionen sind:
- Hilft beim schnellen Erstellen und Bereitstellen einer Engine als Webservice in anpassbaren Produktionsvorlagen.
- Einmal als Webservice implementiert, Beantworten Sie dynamische Anfragen in Echtzeit.
- Unterstützt Datenverarbeitungs- und Machine-Learning-Bibliotheken wie OpenNLP, Funken MLLib.
- Es vereinfacht auch das Dateninfrastrukturmanagement
GitHub-Link: https://github.com/apache/predictionio
9.Scikit-Lernen
Quelle: Google Bilder
Es ist eine Bibliothek mit kostenlosen Software-Tools für maschinelles Lernen basierend auf Python. Bietet verschiedene Algorithmen zur Klassifizierung, Rückschritt, Clustering-Algorithmen, einschließlich zufälliger Wälder, Steigung erhöhen, DBSCAN. Dies basiert auf SciPy, das vorinstalliert sein muss, damit Sie sci-kit learn verwenden können. Es bietet auch Modelle für:
- Ensemble-Methoden
- Merkmalsextraktion
- Anpassung von ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten....
- Mehrfaches Lernen
- Merkmalsauswahl
- Dimensionsreduktion
Notiz: Um sckit-learn zu lernen, Folgen Sie der Dokumentation: https://scikit-learn.org/stable/
GitHub-Link: https://github.com/scikit-learn
10. Pylearn2
Pylearn2 ist die am weitesten verbreitete Bibliothek für maschinelles Lernen unter allen Python-Entwicklern. Es basiert auf Theano. Sie können mathematische Ausdrücke verwenden, um Ihr Komplement zu schreiben, während Theano nimmt oder optimiert und stabilisiert. Es hat einige erstaunliche Funktionen wie:
- ein „Standard-Trainingsalgorithmus“ das Modell selbst trainieren
-
- Modellschätzungskriterien
-
- Matching-Score
- Kreuzentropie
- Logarithmische Wahrscheinlichkeit
- Datensatzvorverarbeitung
- NormalisierungNormung ist ein grundlegender Prozess in verschiedenen Disziplinen, , die darauf abzielt, einheitliche Standards und Kriterien zur Verbesserung von Qualität und Effizienz festzulegen. In Kontexten wie dem Ingenieurwesen, Bildung und Verwaltung, Standardisierung erleichtert den Vergleich, Interoperabilität und gegenseitiges Verständnis. Bei der Implementierung von Standards, Der Zusammenhalt wird gefördert und die Ressourcen werden optimiert, die zu einer nachhaltigen Entwicklung und zur kontinuierlichen Verbesserung der Prozesse beiträgt.... Kontrast
- ZCA-Aufhellung
- Patch-Entfernung (um Faltungsalgorithmen zu implementieren)
GitHub-Link: https://github.com/lisa-lab/pylearn2
Abschließende Anmerkungen:
Ein Beitrag zu Open Source bringt zu viele Vorteile mit sich. Dann, Dies sind einige gute Open-Source-Projekte, die Sie beitragen können.
Danke fürs Lesen, wenn du hier bist 🙂
Lass uns verbinden LinkedIn.
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





