
Dynamische Tabellen: Das Schweizer Taschenmesser der Datenanalyse
Ich liebe es, wie schnell ich Daten mithilfe von Pivot-Tabellen analysieren kann. Mit einem Mausklick, Ich kann zu den granularen Details einer bestimmten Produktkategorie aufschlüsseln, oder zoomen Sie heraus und verschaffen Sie sich einen Überblick über die verfügbaren Daten.
Pivot-Tabellen bieten mir als Data Scientist viel Flexibilität. Ich werde ehrlich sein: Während der explorativen Datenanalysephase eines Data Science-Projekts verlasse ich mich stark auf sie.
Excel-Benutzer sind mit diesen Pivot-Tabellen bestens vertraut. Sie sind die am häufigsten verwendete Funktion von Excel, Und es ist leicht zu verstehen, warum! Aber wussten Sie, dass Sie diese Pivot-Tabellen mit Pandas in Python erstellen können??

Korrekt! Die wunderbare Pandas-Bibliothek bietet eine Funktion namens pivot_table, die die Werte eines Features in einer übersichtlichen zweidimensionalen Tabelle zusammenfasst.. Wir werden sehen, wie man eine dynamische TabellePivotTable ist ein leistungsstarkes Tool in Tabellenkalkulationsprogrammen, wie Microsoft Excel und Google Sheets. Ermöglicht es Ihnen, zusammenzufassen, Große Datenmengen effizient analysieren und visualisieren. Durch seine intuitive Benutzeroberfläche, Benutzer können Informationen neu anordnen, Anwenden von Filtern und Erstellen von benutzerdefinierten Berichten, Erleichterung einer fundierten Entscheidungsfindung in verschiedenen Kontexten, Von der Wirtschaft bis zur akademischen Forschung.... dieses Typs in Python hier.
Creme, sehr bald werden Sie diese Pivot-Tabellen in Ihren eigenen Projekten verwenden. Bitte beachten Sie, dass dieses Tutorial Grundkenntnisse von Pandas und Python voraussetzt. Wenn Sie neu in diesen Themen sind, Sie können sie in den folgenden kostenlosen Kursen abholen:
Inhaltsverzeichnis
- Erkunden des Titanic-Datasets mit Pandas in Python
- Erstellen Sie eine Pivot-Tabelle mit Pandas
- So gruppieren Sie Daten mit der Option IndexDas "Index" Es ist ein grundlegendes Werkzeug in Büchern und Dokumenten, Dies ermöglicht es Ihnen, die gewünschten Informationen schnell zu finden. Allgemein, Sie wird am Anfang einer Arbeit präsentiert und organisiert die Inhalte hierarchisch, mit Kapiteln und Abschnitten. Die richtige Vorbereitung erleichtert die Navigation und verbessert das Verständnis des Materials, was es zu einer unverzichtbaren Ressource sowohl für Studenten als auch für Fachleute in verschiedenen Bereichen macht.... in der Pivot-Tabelle?
- So führen Sie einen Pivot mit einem Mehrfachindex aus?
- Unterschiedliche Aggregationsfunktion für unterschiedliche Merkmale.
- Fügen Sie spezifische Funktionen hinzu mit ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... von Werten
- Finden Sie die Beziehung zwischen den Merkmalen mit dem Spaltenparameter
- Umgang mit fehlenden Daten
Untersuchen des Titanic-Datasets mit Pandas in Python
Ich bin mir sicher, dass Sie auf Ihrer Reise in die Datenwissenschaft auf den Titanic-Datensatz gestoßen sind. Es ist einer der ersten Datensätze, die wir sammeln, wenn wir bereit sind, ein Projekt zu erkunden.. Ich werde es verwenden, um Ihnen die Wirksamkeit von zu zeigen dynamische Tabelle Funktion.
Wir importieren die entsprechenden Bibliotheken:
Pandas als pd importieren
numpy als np importieren
import matplotlib.pyplot als plt
plt.style.use('ggplot')
Für alle, die vergessen haben, wie der Titanic-Datensatz aussieht, Ich präsentiere Ihnen den Datensatz!
df = pd.read_csv('Laufwerk/Mein Laufwerk/AV/train.csv')
df.kopf()

Ich werde einige Funktionen verlassen, um die Analyse der Daten zu erleichtern und die Fähigkeiten der dynamische Tabelle Funktion:
df.drop(['PassengerId','Ticket','Name'],inplace=Wahr,Achse=1)
Es ist an der Zeit, eine Pivot-Tabelle in Python mit der erstaunlichen Pandas-Bibliothek zu erstellen!! Wir werden in diesem Artikel die verschiedenen Facetten einer Pivot-Tabelle untersuchen und eine erstaunliche und flexible Pivot-Tabelle von Grund auf neu erstellen.
So gruppieren Sie Daten mithilfe des Index in einer Pivot-Tabelle?
- dynamische Tabelle benötigt einen Daten und ein Index Parameter
- Daten ist der Pandas-Datenrahmen, der an die Funktion übergeben wird
- Index ist die Funktion, mit der Sie Ihre Daten gruppieren können. Die Indexfunktion wird als Index in der resultierenden Tabelle angezeigt.
Ich werde die verwenden ‚Sex‘ Spalte wie die Index zur Zeit:
#a single index
table = pd.pivot_table(Daten=df,index=['Sex'])
Tisch

Wir können sofort alle Merkmalswerte für beide Geschlechter vergleichen. Jetzt, lass uns das Ergebnis visualisieren:

Gut, weibliche Passagiere zahlten deutlich mehr für Tickets als männliche.
Weitere Informationen zur Anzeige Ihrer Daten erhalten Sie hier.
So führen Sie einen Pivot mit einem Mehrfachindex aus?
Sie können sogar mehr als eine Funktion als Index verwenden, um Ihre Daten zu gruppieren. Dadurch wird die Granularität der resultierenden Tabelle erhöht und Sie können Ihre Ergebnisse genauer festlegen:
#multiple indexes
table = pd.pivot_table(df,index=['Sex','Pclass'])
Tisch

Durch die Verwendung mehrerer Indizes im Datensatz können wir vereinbaren, dass die Ungleichheit im Ticketpreis für Frau Ja männlich Passagiere war in allen gültig PKlasse auf der Titanic.
Unterschiedliche Aggregationsfunktion für unterschiedliche Merkmale.
Die in der Tabelle angegebenen Werte sind das Ergebnis der Zusammenfassung, die aggfunc gilt für Funktionsdaten. aggfunc ist ein Hinzugefügte FunktionDie Aggregatfunktion ist ein Schlüsselbegriff in der Ökonomie, der die Beziehung zwischen der Gesamtproduktion von Gütern und Dienstleistungen in einer Volkswirtschaft und dem Preisniveau darstellt. Diese Funktion hilft zu verstehen, wie sich das aggregierte Angebot und die Nachfrage als Reaktion auf Änderungen von Faktoren wie der Fiskal- und Geldpolitik verändern. Seine Analyse ist für die Formulierung von Wirtschaftsstrategien und die Vorhersage von Konjunkturzyklen unerlässlich.... das dynamische Tabelle gilt für Ihre gruppierten Daten.
Standard, es ist np.mean (), Sie können aber auch unterschiedliche Zusatzfunktionen für unterschiedliche Funktionen nutzen!! Geben Sie einfach ein Wörterbuch als Eingabe für die aggfunc Parameter mit Funktionsname als Schlüssel und zugehöriger Aggregatfunktion als Wert.
ich werde benützen np.mean () Für ihn ‚Alter‘ charakteristisch und np.sum () Für ihn ‚Sobrevivió‘ charakteristisch:
#different aggregate functions
table = pd.pivot_table(df,index=['Sex','Pclass'],aggfunc={'Alter':np.mean,'Survived':np.sum})
Tisch

Die resultierende Tabelle ist sinnvoller, wenn verschiedene Aggregationsfunktionen für verschiedene Merkmale verwendet werden.
Spezifische Funktionen mit Wertparametern hinzufügen
Aber, Was fügst du hinzu?? Sie können Pandas die Eigenschaften mitteilen, auf die die Aggregatfunktion angewendet werden soll, in dem Wert Parameter.
Wert Der Parameter gibt der Funktion an, welche Funktionen hinzugefügt werden sollen. Es ist ein optionales Feld und wenn Sie diesen Wert nicht angeben, die Funktion fügt alle numerischen Merkmale aus dem Datensatz hinzu:
Tabelle = pd.pivot_table(df,index=['Sex','Pclass'],Werte=['Survived'], aggfunc=np.mean)
Tisch
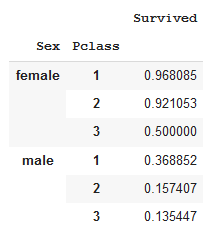
tabelle.plot(kind='bar');
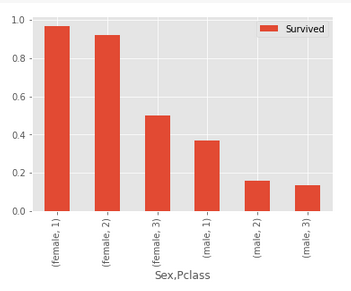
Die Überlebensrate der Passagiere an Bord der Titanic sank mit einer abnehmenden P-Klasse zwischen beiden Geschlechtern. Was ist mehr, die Überlebensrate der männlichen Passagiere war in allen P-Klassen niedriger als die der Frauen.
Finden Sie die Beziehung zwischen den Merkmalen mit dem Spaltenparameter
Die Verwendung mehrerer Funktionen als Indizes ist in Ordnung, Wenn Sie jedoch einige Funktionen als Spalten verwenden, können Sie die Beziehung zwischen ihnen intuitiv verstehen. Was ist mehr, Die resultierende Tabelle kann immer besser angezeigt werden, indem die Säulen Parameter des dynamische Tabelle.
Dies Säulen Der Parameter ist optional und zeigt die Werte horizontal oben in der resultierenden Tabelle an.
Beide Säulen und das Index Parameter sind optional, aber seine effektive Nutzung wird Ihnen helfen, die Beziehung zwischen den Funktionen intuitiv zu verstehen.
#columns
table = pd.pivot_table(df,index=['Sex'],Spalten=['Pclass'],Werte=['Survived'],aggfunc=np.sum)
Tisch
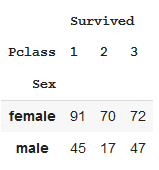
Verwenden von PKlasse als Spalte ist einfacher zu verstehen, als sie als Index zu verwenden:
tabelle.plot(kind='bar');
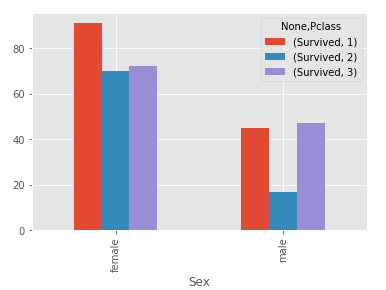
dynamische Tabelle es ermöglicht Ihnen sogar, mit fehlenden Werten durch Parameter umzugehen Tropfen Ja fill_value:
- Tropfen ermöglicht es Ihnen, Nullwerte in geclusterten Tabellen zu entfernen, deren Werte null sind
- fill_value Der Parameter kann verwendet werden, um die NaN-Werte in der geclusterten Tabelle durch die Werte zu ersetzen, die Sie hier angeben.
#Nullwerte anzeigen
Tabelle = pd.pivot_table(df,index=['Sex','Survived','Pclass'],Spalten=['Embarked'],Werte=['Alter'],aggfunc=np.mean)
Tisch

Ich werde die NaN-Werte durch den Mittelwert der ersetzen ‚Alter‘ Säule:
#handling null values
table = pd.pivot_table(df,index=['Sex','Survived','Pclass'],Spalten=['Embarked'],Werte=['Alter'],aggfunc=np.mean,fill_value=np.mean(df['Alter']))
Tisch

In diesem Artikel, wir erforschen die verschiedenen Parameter des Unglaublichen dynamische Tabelle Funktion und wie Sie damit die Merkmale in Ihrem Datensatz einfach in einer einzigen Codezeile zusammenfassen können.
Wenn Sie neu in der Python-Programmierung sind und mehr über das Analysieren von Daten mit Python erfahren möchten, Ich empfehle Ihnen, unsere Python für die Datenwissenschaft Ja Pandas für die Datenanalyse in Python Kurse.





