
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Viele Unternehmen glauben immer noch daran, ein eigenes Framework für Datenpipelines zu erstellen und verwenden keine vorhandenen Tools, obwohl dies ein breites Spektrum an Fähigkeiten erfordert.. Der traditionelle Weg, ETL zu tun, besteht darin, es manuell mit Code zu tun, und es ist kein Ein-Personen-Job. Traditionelles ETL kann als Flaschenhals angesehen werden, aber das heißt nicht, dass es unbezahlbar ist.. Lassen Sie uns das aktuelle Szenario hier verstehen!
ETL in Kürze
Als Datenenthusiasten, wir alle müssen diesen Begriff im täglichen Umgang mit Daten schon öfters kennengelernt haben, Wahrheit? Wie gewöhnlich, Data Engineers erledigen all diese Arbeiten, aber auch Datenanalysten, Data Scientists und Business Intelligence Engineers müssen praktische Erfahrung haben.. Nicht alle Unternehmen werden saubere Daten für die direkte Analyse und Berichterstattung bereitstellen; einige freuen sich auf die Zusammenarbeit mit Dateningenieuren, um skalierbare und effiziente endgültige Datenpipelines zu erstellen.
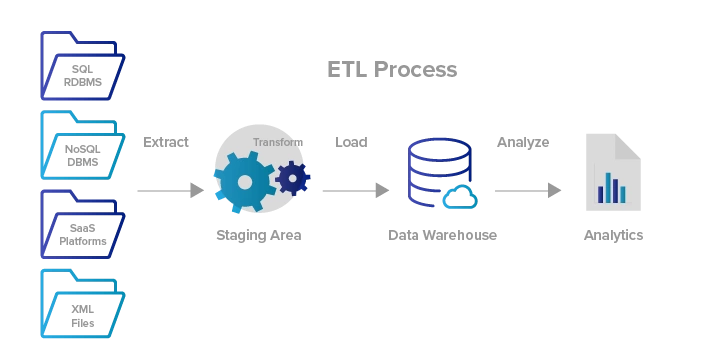
Warum ist es so gehypt?
Große Unternehmen stellen vor allem ETL-Entwickler ein, ETL-Spezialisten, die nur die Datenintegration verwalten und für sie Data Warehousing konzipieren. Der Prozess von 3 Schritte scheint einfach, aber hinter den kulissen, Das Extrahieren von Daten aus verschiedenen Quellen ist mit Hunderten von äußerst umständlichen Dingen zu bewältigen, Vor allem die Daten selbst sind viel größer und unordentlicher geworden.
Dies ist der schwierigste Teil des gesamten Datenflusses und Sie können es sich nicht leisten, wichtige Informationen falsch zu handhaben, bevor Sie mit dem nächsten Schritt fortfahren.. Nach der Umwandlung der sauberen und validierten Daten in die gewünschte Weise, sichere Speicherung im Data Warehouse für Datenmodellierungs- und Analysezwecke. In der Anfangsphase der Produktionsphase sind verschiedene Risiken verbunden und deshalb wird mehr bezahlt. Die Kenntnis der Ein- und Ausgabe von Daten ist die grundlegende Grundlage für jede datenbezogene Funktion und es ist zwingend erforderlich, eine grundlegende Vorstellung davon zu haben, wie man Daten mit verfügbaren Ressourcen intelligent nutzt..
So führen Sie ETL . durch?
Es gibt verschiedene Workflows in der Datenpipeline und sie können in 2 Formen:
- Talend
- Informatik
- Alteryx
- SSIS
- Amazon Redshift
- Viel
- QlikSense
- Felshaken
- R
- SQL
- Java
- Apache-Schwein
ETL ohne Code vs. manuelle ETL
Eine No-Code-ETL-Plattform erfordert wenig bis gar keine Codierung. Die Tools bieten eine einfach zu bedienende GUI mit verschiedenen Funktionalitäten, um eine Datenkarte zu erstellen. Sobald die Datenkarte fertig ist, Teams müssen nur den Prozess ausführen und der Server wird seine Arbeit erledigen. Der Prozess ist für Kunden leicht verständlich und einfach zu warten. Es ist skalierbar und spart viel Zeit und Geld für Unternehmen, die Datensätze in Echtzeit verwalten. Die Logik ist für beliebige Zwecke wiederverwendbar DatenquelleEIN "Datenquelle" bezieht sich auf jeden Ort oder jedes Medium, an dem Informationen erhalten werden können. Diese Quellen können sowohl primär als auch, wie z.B. Erhebungen und Experimente, als sekundär, als Datenbanken, Wissenschaftliche Artikel oder statistische Berichte. Die richtige Wahl einer Datenquelle ist entscheidend, um die Gültigkeit und Zuverlässigkeit von Informationen in Forschung und Analyse zu gewährleisten.... und es gibt benutzerdefinierte Funktionen zur Datenmanipulation. Es gibt nutzungsbasierte ETL-Abonnements und -Dienste, die auf einem Cloud-Server mit Millionen von Daten ausgeführt werden. Deswegen, das Unternehmen sollte das Tool entsprechend dem Anwendungsfall und den Kundenanforderungen mit Bedacht auswählen.
Auch nicht-technische Arbeitgeber müssen geschult werden, um Arbeitsabläufe zu planen, Jobs und Aufgaben, um sich mit dem Tool vertraut zu machen. Es gibt Unternehmen, die codefreie Praktiken fördern, um verschiedene Produkte zu entwickeln..
Laut dem IT-Forschungsunternehmen Forrester, der Markt für Low-Code-Entwicklungsplattformen wird einen Wert von erreichen $ 21,2 Milliarde für 2022, wächst mit einer jährlichen Rate von 40 Prozent. Was ist mehr, das 45 Prozent der Entwickler haben bereits eine Low-Code-Plattform verwendet oder erwarten dies in naher Zukunft „. [1]
Das eigene Auspuffrohr zu codieren ist verlockend aber gleichzeitig schwierig. Viele Unternehmen passen das Schreiben von Python-Skripten an, um zu extrahieren, Transformieren und Hochladen von Daten auch in einer Cloud-Umgebung. Jede Art von Codeanpassung kann durchgeführt werden, wenn etwas in der vorhandenen ETL-Lösung nicht verfügbar ist. Die Codierung unserer eigenen ETL kann in Bezug auf Flexibilität und Leistungsoptimierung von großem Vorteil sein. Wenn ein erfahrener Dateningenieur an Bord ist, der ETL-Prozesse kennt, der ETL-Prozess kann so angepasst werden, dass er so reibungslos wie möglich abläuft. Mühsames Codieren ist in Self-Services nützlich, wo man Daten selbstständig vorverarbeiten kann.
Fragen? Das Ändern des Codes und die Pflege der Skripte kann ein großes Problem sein, wenn ETL für komplexe Schemata nicht gut funktioniert. Die Automatisierung manueller ETL erfordert andere Tools wie Selenium, der Windows-Aufgabenplaner kann Skripte automatisch täglich oder wöchentlich ausführen, um Daten in Excel oder in einer DatenbankEine Datenbank ist ein organisierter Satz von Informationen, mit dem Sie, Effizientes Verwalten und Abrufen von Daten. Einsatz in verschiedenen Anwendungen, Von Unternehmenssystemen bis hin zu Online-Plattformen, Datenbanken können relational oder nicht-relational sein. Das richtige Design ist entscheidend für die Optimierung der Leistung und die Gewährleistung der Informationsintegrität, und erleichtert so eine fundierte Entscheidungsfindung in verschiedenen Kontexten..... Deswegen, sind für eine bestimmte Gruppe von Benutzern und Datenvorgängen konzipiert.
Lieben Sie es, mit schmutzigen Daten zu spielen und sie zu bereinigen??
Wenn Sie mit Daten experimentieren möchten, prüfen Sie manuell auf alle Fehler und normalisieren Sie die Daten, Daher ist die Implementierung mehrerer Python- und R-Pakete eine gute Möglichkeit, dies zu tun. Sogar das Schreiben von SQL-Abfragen kann interessant und herausfordernd sein, um Informationen aus unordentlichen Daten zu extrahieren. Dies kann Ihnen dabei helfen, ein tiefes Verständnis der Logik hinter der Datenverwaltung von Grund auf zu erlangen, anstatt zuerst mit einem Tool zu beginnen..
Endeffekt: Alles hängt von verschiedenen Faktoren ab ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... wie der Größe der Daten, Speicher und Budget, um die optimale Lösung für geschäftliche Probleme zu wählen. Was ist mehr, Die Wahl des ETL-Ansatzes variiert je nach technischem und nicht-technischem Know-how eines Unternehmens.
Abschließende Gedanken
Dies ist ein ziemlich umstrittenes Thema und beide haben ihre Vor- und Nachteile.. ETL-Tools sind nicht tot, aber sie werden nicht von allen bevorzugt. Man könnte jetzt mit unnötigem Overhead durch die Verwendung eines ETL-Tools enden, wo es nicht benötigt wird, die auch Geschäftslogik hostet, die nicht außerhalb des ETL-Tools übertragbar ist.. Aber die Fähigkeiten, die durch das Erstellen von ETL-Pipelines mit Python oder SQL entwickelt wurden, werden für die kommenden Jahre immer zusammenhalten..
Aktuelle ETL-Tools können aus der Mode kommen und die Anpassung an neue kann für manche Menschen schwierig sein. Deswegen, selbst Werkzeuge können bei unsachgemäßer Verwendung zum Ärgernis für ein Unternehmen werden. Unabhängig von manueller oder no-code ETL, der ganze Prozess selbst ist kompliziert, aber auch sehr interessant zu lernen.
Was ist Ihre Lieblings? Lass es mich in den Kommentaren wissen!!
Danke, dass du diesen Artikel gelesen hast.
Referenz
[1] Wie Low-Code-Plattformen die Softwareentwicklung verändern
Über den Autor:
Saloni Somaiya arbeitet als Data Scientist bei einem Startup im Gesundheitswesen in den USA. Master-Abschluss in Wirtschaftsinformatik an der Northeastern University, Boston. Liest gerne Artikel und erforscht neue Technologien. Sie ist bereit, mehr im Bereich Wissenschaft und Datenanalyse beizutragen.
LinkedIn: https://www.linkedin.com/in/saloni-somaiya/
Die in diesem Artikel gezeigten Medien sind nicht Eigentum von DataPeaker und werden nach Ermessen des Autors verwendet.





