
Dieser Artikel wurde im Rahmen der Data Science Blogathon.
Einführung
Inhaltsverzeichnis
-
Was ist lineare Regression??
-
Bedeutung der linearen Regression in der prädiktiven Analyse.
-
Praktische Anwendung der linearen Regression mit R.
-
Anwendung für Blutdruck- und Altersdatensätze.
Was ist eine lineare Regression??
Die einfache lineare Regressionsanalyse ist eine Technik, um den Zusammenhang zwischen zwei Variablen zu finden. Die beiden beteiligten Variablen sind eine VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... Abhängige Variable, die auf Änderungen reagiert, und die unabhängige Variable. Beachten Sie, dass wir nicht die Abhängigkeit der abhängigen Variablen von der unabhängigen Variablen berechnen, nur der Verein.
Zum Beispiel, ein Unternehmen investiert einen bestimmten Geldbetrag in die Vermarktung eines Produkts und hat im Laufe der Jahre auch Verkaufsdaten gesammelt, indem es die Korrelation zwischen Marketingbudget und Verkaufsdaten analysiert hat, wir können den Verkauf im nächsten Jahr vorhersagen, wenn das Unternehmen einen bestimmten Geldbetrag für die Marketingabteilung bereitstellt. Die obige Vorhersageidee klingt magisch, aber es ist reine Statistik. Die lineare Regression besteht im Wesentlichen darin, eine gerade Linie an unseren Datensatz anzupassen, damit wir zukünftige Ereignisse vorhersagen können.
Die am besten geeignete Linie wäre die Form:
Y = B0 + B1X
Wo, Ja – Abhängige Variable
x – Unabhängige Variable
B0 und B1 – Regressionsparameter
Vorhersage des Blutdrucks nach Alter durch Regression in R
Regressionsgeradengleichung in unserem Datensatz.
BP = 98,7147 + 0,9709 Alter
Datensatz importieren
Importieren Sie einen Alters-Blutdruck-Datensatz, bei dem es sich um eine CSV-Datei handelt, mit der Funktion read.csv () in R und speichern Sie diesen Datensatz in einem bp-Datenrahmen.
bp <- lesen.csv ("bp.csv")
Datenrahmen erstellen, um Werte vorherzusagen
Erstellung eines Datenrahmens, der das Alter von . speichert 53 Jahre. Und dieser Datenrahmen wird verwendet, um den Blutdruck bei vorherzusagen 53 Jahre nach der Erstellung eines linearen Regressionsmodells.
P <-  als.Datenrahmen(53)
Kolnamen(P) <- "Alter"
Erstellen eines AusbreitungsdiagrammDas Streudiagramm ist ein grafisches Werkzeug, das in der Statistik verwendet wird, um die Beziehung zwischen zwei Variablen zu visualisieren. Es besteht aus einer Menge von Punkten in einer kartesischen Ebene, wobei jeder Punkt ein Wertepaar darstellt, das den analysierten Variablen entspricht. Diese Art von Diagramm ermöglicht es Ihnen, Muster zu erkennen, Trends und mögliche Korrelationen, Erleichterung der Dateninterpretation und Entscheidungsfindung auf der Grundlage der präsentierten visuellen Informationen.... Verwendung der ggplot2-Bibliothek
Mithilfe der ggplot2-Bibliothek in R, Wir können sehen, dass es einen Zusammenhang zwischen Blutdruck und Alter gibt, Wie wir sehen können, folgt mit zunehmendem Alter ein Anstieg des Blutdrucks.
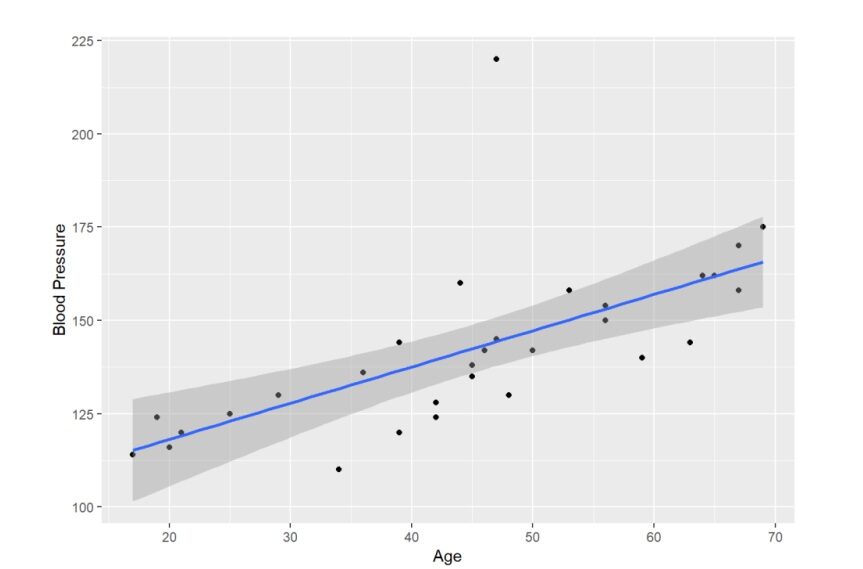
Aus dem Graphen ist ziemlich klar, dass die Verteilung auf dem Graphen so gestreut ist, dass wir eine Gerade durch die Punkte passen können.
Berechnen Sie den Zusammenhang zwischen Alter und Blutdruck
Mit Hilfe der Funktion cor . können wir auch unsere vorherige Analyse verifizieren, dass ein Zusammenhang zwischen Blutdruck und Alter besteht () in R, das verwendet wird, um die Korrelation zwischen zwei Variablen zu berechnen.
kor(bp$BP,bp$Alter)
[1] 0,6575673
Erstellen Sie ein lineares Regressionsmodell
Jetzt, mit Hilfe der lm-Funktion (), Lass uns ein lineares Modell erstellen. Die lm-Funktion () hat zwei Attribute, Zuerst ist eine Formel, die wir verwenden werden „BP ~ Alter“ weil das Alter eine unabhängige Variable ist und der Blutdruck eine abhängige Variable ist und die zweite ist Daten, wobei wir den Namen des Datenrahmens angeben, der Daten enthält, in diesem Fall der bp-Datenrahmen.
Modell <- lm(BP ~ Alter, Daten = bp)
Zusammenfassung unseres linearen Regressionsmodells
Zusammenfassung(Modell)
Produktion:
##
## Anruf:
## lm(Formel = BP ~ Alter, Daten = bp)
##
## Rückstände:
## Min 1Q Median 3Q Max
## -21.724 -6.994 -0.520 2.931 75.654
##
## Koeffizienten:
## Schätzung Std. Fehler t-Wert Pr(>|T|)
## (Abfangen) 98.7147 10.0005 9.871 1.28e-10 ***
## Alter 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Bedeutung. Codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 'Review' 1
##
## Reststandardfehler: 17.31 An 28 Freiheitsgrade
## Mehrere R-Quadrat: 0.4324, Bereinigtes R-Quadrat: 0.4121
## F-Statistik: 21.33 An 1 und 28 DF, p-Wert: 7.867e-05
Interpretation des Modells
## Koeffizienten:
## Schätzung Std. Fehler t-Wert Pr(>|T|)
## (Abfangen) 98.7147 10.0005 9.871 1.28e-10 ***
## Alter 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Bedeutung. Codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 'Review' 1
B0 = 98.7147 (Ja- abfangen)
B1 = 0.9709 (Alterskoeffizient)
BP = 98.7147 + 0.9709 Alter
Es bedeutet, dass eine Änderung des Alters um eine Einheit 0.9709 Einheiten zur Blutdruckänderung.
Standart Fehler Es ist die erwartete Variabilität des Koeffizienten, die die Stichprobenvariabilität erfasst, die Abweichung im Schnittpunkt kann also bis zu betragen 10.0005 und die Altersunterschiede werden 0.2102 nicht mehr als das
Wert T: der t-Wert ist der Koeffizient geteilt durch den Standardfehler, es ist im Grunde, wie groß im Verhältnis zum Fehler geschätzt wird, je größer der Koeffizient in Bezug auf Std. Fehler, je höher der t-Wert ist und der t-Wert wegen seiner Verteilung einen p-Wert hat Der p-Wert gibt an, wie statistisch signifikant die Variable für das Modell für ein Konfidenzniveau von . ist 95% Wir werden diesen Wert mit Alpha vergleichen, der 0.05 , in unserem Fall ist also der p-Wert des Schnitts und das Alter kleiner als alpha (alfa = 0.05), dies impliziert, dass beide für unser Modell statistisch signifikant sind.
## Reststandardfehler: 17.31 In 28 Freiheitsgrade
## Mehrfaches R-Quadrat: 0,4324, R im Quadrat montiert: 0,4121
## F-Statistik: 21,33 In 1 Ja 28 DF, p-Wert: 7,867e-05
Reststandardfehler oder der Standardfehler des Modells ist im Grunde der durchschnittliche Fehler für das Modell, der 17.31 in unserem Fall und bedeutet, dass unser Modell einen durchschnittlichen Fehler von . haben kann 17.31 bei der Vorhersage des Blutdrucks. Je kleiner der Fehler, desto besser wird das Modell bei der Vorhersage sein.
Mehrere R-Quadrat ist der Grund für (1- (Summe des quadratischen Fehlers / Summe des Gesamtquadrats))
R im Quadrat montiert:
Wenn wir Variablen hinzufügen, es spielt keine Rolle, ob es in der Vorhersage signifikant ist oder nicht, der Wert von R zum Quadrat wird steigen, Grund, warum das angepasste R zum Quadrat verwendet wird, denn wenn die aggregierte Variable für die Modellvorhersage nicht signifikant ist, angepasster R-Wert -squared wird reduziert, ist eines der nützlichsten Werkzeuge, um eine Überanpassung des Modells zu vermeiden.
F – Statistiken ist das Verhältnis zwischen dem mittleren Quadrat des Modells und dem mittleren Fehlerquadrat, mit anderen Worten, es ist der Grund, wie gut das Modell funktioniert und was den Fehler macht, und je höher der F-Wert, desto besser funktioniert das Modell im Vergleich zum Fehler.
Einer sind die Freiheitsgrade des Zählers der F-Statistik und 28 ist der Freiheitsgrad der Fehler.
Vorhersage des Blutdruckwertes bei 53 Jahre
BP = 98,7147 + 0,9709 Alter
Die obige Formel wird verwendet, um den Blutdruck im Alter von . zu berechnen 53 Jahre und dies wird mit der Vorhersagefunktion erreicht () Zuerst schreiben wir den Namen des linearen Regressionsmodells und trennen es durch ein Komma, das den Wert des neuen Datensatzes in p seit dem Alter angibt 53 wurde zuvor im Datenrahmen p . gespeichert.
Vorhersagen(Modell, neue Daten = p)
## 1
## 150.1708
Dann, der vorhergesagte Blutdruckwert ist 150,17 zum 53 Jahre.
Wie wir den Blutdruck mit der Assoziation des Alters vorhergesagt haben, jetzt kann es mehr als eine unabhängige Variable geben, die eine Korrelation mit einer abhängigen Variable namens Multiple Regression zeigt.
Multiples lineares Regressionsmodell
Die multilineare Regressionsanalyse ist eine statistische Technik, um die Assoziation mehrerer unabhängiger Variablen in der abhängigen Variablen zu finden.. Zum Beispiel, das einkommen eines unternehmens hängt von mehreren faktoren ab, einschließlich Marktgröße, der Preis, Beförderung, der Preis des Wettbewerbs, etc. Grundsätzlich, Das multiple lineare Regressionsmodell stellt eine lineare Beziehung zwischen einer abhängigen Variablen und mehreren unabhängigen Variablen her.
Die multiple lineare Regressionsgleichung lautet wie folgt:
Y = B0 + B1X1 + B2X2 + .. + BnXk + E
Woher
Ja – Abhängige Variable
x – Unabhängige Variable
B0, B1, B3,. – Mehrere lineare Regressionskoeffizienten
E- Fehler
Ein weiteres Beispiel aus dem Wine-Datensatz und mit Hilfe von AGST, HarvestRain lasst uns den Weinpreis vorhersagen.
Importieren des Datensatzes
Verwenden der Funktion read.csv (), importiere den Datensatz wine.csv und wine_test.csv in den Datenrahmen wine bzw. wine_test.
Wein <- lesen.csv("wein.csv")
wine_test <- lesen.csv("wine_test.csv")
Laden Sie den Datensatz von unten herunter
Finden Sie die Korrelation zwischen verschiedenen Variablen
Verwenden der cor-Funktion () und die Rundfunktion () wir können die Korrelation zwischen allen Variablen im Weindatensatz auf zwei Dezimalstellen runden.
runden(kor(Wein),2)
Produktion:
Jahr Preis WinterRegen AGST ErnteRegenzeit FrankreichPop
## Jahr 1.00 -0.45 0.02 -0.25 0.03 -1.00 0.99
## Preis -0.45 1.00 0.14 0.66 -0.56 0.45 -0.47
## WinterRegen 0.02 0.14 1.00 -0.32 -0.28 -0.02 0.00
## AGST -0.25 0.66 -0.32 1.00 -0.06 0.25 -0.26
## ErnteRegen 0.03 -0.56 -0.28 -0.06 1.00 -0.03 0.04
## Alter -1.00 0.45 -0.02 0.25 -0.03 1.00 -0.99
## FrankreichPop 0.99 -0.47 0.00 -0.26 0.04 -0.99 1.00
Verstreute Grundstücke
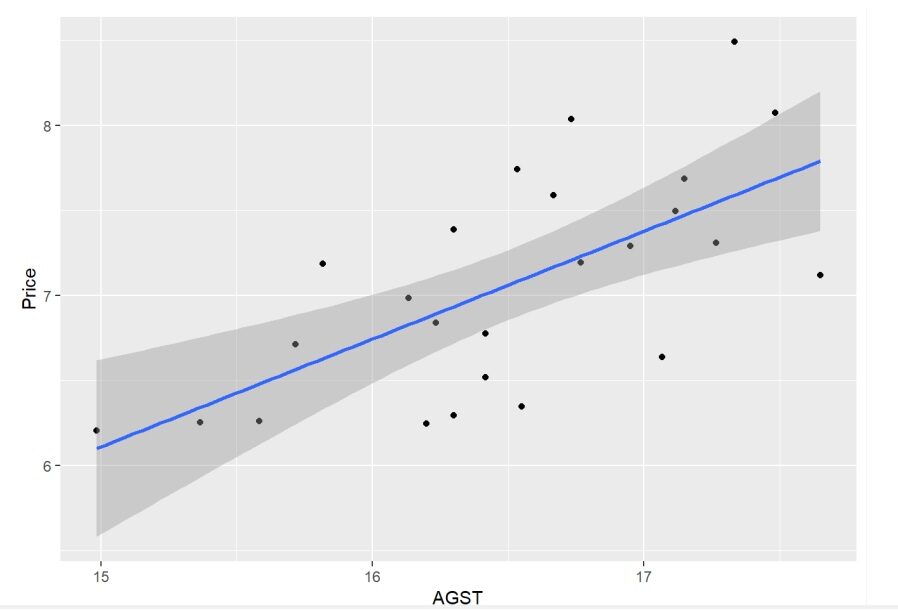
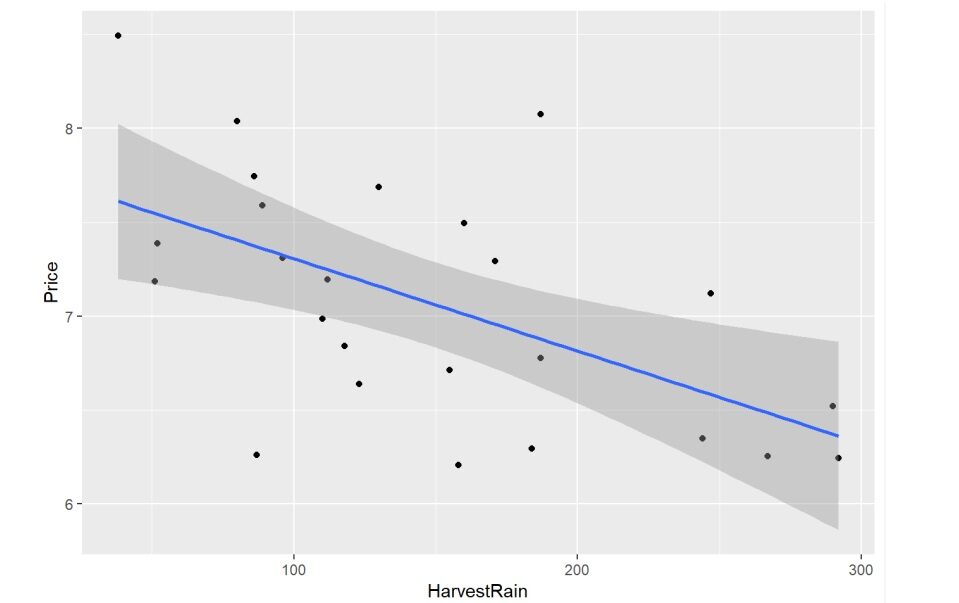
Bei Verwendung der ggplot2-Bibliothek in R, Erstellen Sie ein Streudiagramm, das deutlich zeigt, dass AGST und Weinpreis stark korreliert sind. Auf die gleiche Weise, das StreudiagrammEin Streudiagramm ist eine visuelle Darstellung, die die Beziehung zwischen zwei numerischen Variablen mithilfe von Punkten auf einer kartesischen Ebene zeigt. Jede Achse stellt eine Variable dar, und die Position jedes Punktes gibt seinen Wert in Bezug auf beide an.. Diese Art von Diagramm ist nützlich, um Muster zu erkennen, Korrelationen und Trends in den Daten, Erleichterung der Analyse und Interpretation quantitativer Zusammenhänge.... zwischen HarvestRain und dem Weinpreis zeigt auch seine Korrelation.
ggplot(Wein,aes(x = AGST, y = Preis)) + geom_point() +geom_smooth(Methode = "lm")
ggplot(Wein,aes(x = ErnteRegen, y = Preis)) + geom_point() +geom_smooth(Methode = "lm")
Erstellen Sie ein multilineares Regressionsmodell
Modell1 <- lm(Preis ~ AGST + ErnteRegen,Daten = Wein)
Zusammenfassung(Modell1)
Produktion:
##
## Anruf:
## lm(Formel = Preis ~ AGST + ErnteRegen, Daten = Wein)
##
## Rückstände:
## Min 1Q Median 3Q Max
## -0.88321 -0.19600 0.06178 0.15379 0.59722
##
## Koeffizienten:
## Schätzung Std. Fehler t-Wert Pr(>|T|)
## (Abfangen) -2.20265 1.85443 -1.188 0.247585
## AGST 0.60262 0.11128 5.415 1.94e-05 ***
## ErnteRegen -0.00457 0.00101 -4.525 0.000167 ***
## ---
## Bedeutung. Codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 'Review' 1
##
## Reststandardfehler: 0.3674 An 22 Freiheitsgrade
## Mehrere R-Quadrat: 0.7074, Bereinigtes R-Quadrat: 0.6808
## F-Statistik: 26.59 An 2 und 22 DF, p-Wert: 1.347e-06
Interpretation des Modells
## Koeffizienten:
## Schätzung Std. Fehler t-Wert Pr(>|T|)
## (Abfangen) -2.20265 1.85443 -1.188 0.247585
## AGST 0.60262 0.11128 5.415 1.94e-05 ***
## ErnteRegen -0.00457 0.00101 -4.525 0.000167 ***
## Bedeutung. Codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 'Review' 1
B0 = 98.7147 (Ja- abfangen)
B1 = 0.9709 (Alterskoeffizient)
Preis = -2.20265 + 0.60262 AGST - 0.00457 ErnteRegen
Dies bedeutet, dass eine Änderung einer Einheit in AGST mit sich bringt 0,60262 Einheiten im Preis zu ändern und eine Einheitenänderung in HarvestRain bringt 0,00457 Einheiten im Preis ändern.
Standart Fehler ist die erwartete Variabilität des Koeffizienten, der die Stichprobenvariabilität erfasst, die Abweichung im Schnittpunkt kann also bis zu betragen 1.85443 und die Abweichung in AGST wird 0.11128 und die Variation in HarvestRain ist 0.00101 nicht mehr als das
Wert T: der t-Wert ist der Koeffizient geteilt durch den Standardfehler, es ist im Grunde, wie groß im Verhältnis zum Fehler geschätzt wird, je größer der Koeffizient in Bezug auf Std. Fehler, je höher der t-Wert ist und der t-Wert mit einem p-Wert verbunden ist, da es sich um eine Verteilung handelt. Der p-Wert gibt an, wie statistisch signifikant die Variable für das Modell für ein Konfidenzniveau von . ist 95% Wir werden diesen Wert mit Alpha vergleichen, um zu sein 0.05, also in unserem Fall der p-Wert des Schnitts, AGST und HarvestRain ist kleiner als Alpha (alfa = 0.05), dies impliziert, dass sie alle für unser Modell statistisch signifikant sind.
## Reststandardfehler: 0.3674 In 22 Freiheitsgrade
## Mehrfaches R-Quadrat: 0,7074, R im Quadrat montiert: 0,6808
## F-Statistik: 26.59 In 2 Ja 22 DF, p-Wert: 1.347e-06
Reststandardfehler oder der Standardfehler des Modells ist im Grunde der durchschnittliche Fehler für das Modell, der 0.3674 in unserem Fall und bedeutet, dass unser Modell eine durchschnittliche Differenz von . haben kann 0.3674 bei der Vorhersage des Weinpreises. Je kleiner der Fehler, desto besser wird das Modell bei der Vorhersage sein.
Mehrere R-Quadrat ist der Grund für (1- (Summe des quadratischen Fehlers / Summe des Gesamtquadrats))
R im Quadrat montiert:
Wenn wir Variablen hinzufügen, es spielt keine Rolle, ob es in der Vorhersage signifikant ist oder nicht, der Wert von R zum Quadrat wird steigen, Grund, warum das angepasste R zum Quadrat verwendet wird, denn wenn die aggregierte Variable für die Modellvorhersage nicht signifikant ist, angepasster R-Wert -squared wird reduziert, ist eines der nützlichsten Werkzeuge, um eine Überanpassung des Modells zu vermeiden.
F – Statistiken ist das Verhältnis zwischen dem mittleren Quadrat des Modells und dem mittleren Fehlerquadrat, mit anderen Worten, es ist der Grund, wie gut das Modell funktioniert und was den Fehler macht, und je höher der F-Wert, desto besser funktioniert das Modell im Vergleich zum Fehler.
Zwei sind die Freiheitsgrade des Zählers der F-Statistik und 22 ist der Freiheitsgrad der Fehler.
Vorhersage von Werten für unsere Testsuite
Vorhersage <- Vorhersagen(Modell1, newdata = wine_test)
Vorhersagewerte mit dem Testdatensatz
Weinprobe
## Jahr Preis WinterRegen AGST ErnteRegenzeit FrankreichPop
## 1 1979 6.9541 717 16.1667 122 4 54835.83
## 2 1980 6.4979 578 16.0000 74 3 55110.24
Vorhersage
## 1 2
## 6.982126 7.101033
Fazit
Wie wir sehen können, können wir aus dem verfügbaren Datensatz ein lineares Regressionsmodell erstellen und dieses Modell trainieren, wenn genügend Daten vorhanden sind, wir können neue Ereignisse genau vorhersagen oder, mit anderen Worten, zukünftige Ergebnisse.





