
Eine der häufigsten Fragen, das geht in mehreren Data-Science-Foren es ist:
Was ist der Unterschied zwischen maschinellem Lernen und statistischer Modellierung??
Ich habe das letzte Mal recherchiert 2 Jahre. Allgemein, Ich brauche nicht länger als einen Tag, um eine klare Antwort auf das Thema zu bekommen, das ich recherchiere. Trotz dieses, das war definitiv eine der am schwersten zu knackenden Nüsse. Als ich am Anfang auf diese Frage gestoßen bin, Ich habe kaum eine klare Antwort gefunden, die bestimmen kann, wie sich maschinelles Lernen von statistischer Modellierung unterscheidet. Angesichts der Ähnlichkeit in Bezug auf das Ziel, das beide zu lösen versuchen, der einzige Unterschied liegt in der Menge der beteiligten Daten und der menschlichen Beteiligung, um ein Modell zu erstellen. Hier ist ein interessantes Venn-Diagramm zur Abdeckung von maschinellem Lernen und statistischer Modellierung im Data-Science-Universum (Referenz: SAS-Institut)
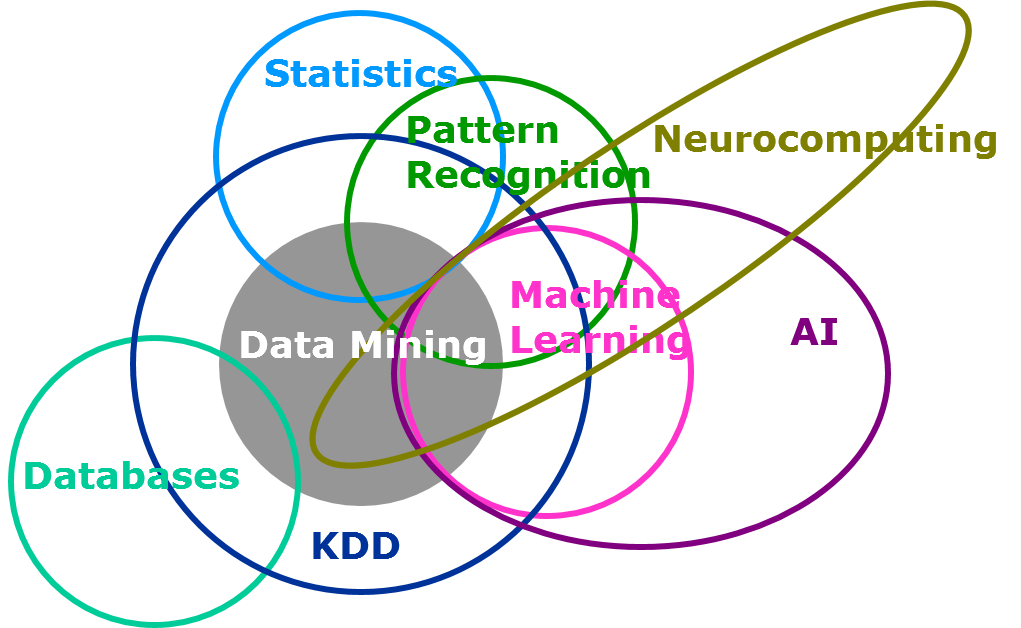
In diesem Beitrag, Ich werde versuchen, den Unterschied zwischen den beiden so gut wie möglich hervorzuheben.. Ich ermutige die erfahrensten Leute in dieser Branche, diesen Beitrag zu ergänzen, um den Unterschied hervorzuheben.
Bevor es losgeht, Lassen Sie uns das Ziel verstehen, das hinter dem steckt, was wir versuchen zu lösen, um eines dieser Tools zu verwenden. Das gemeinsame Ziel bei der Verwendung beider Tools ist Aus Daten lernen. Beide Ansätze zielen darauf ab, die zugrunde liegenden Phänomene durch die Verwendung der im Verfahren generierten Daten zu erfahren..
Jetzt, da klar ist, dass das Ziel hinter beiden Ansätzen dasselbe ist, Lassen Sie uns seine Definition und Unterschiede überprüfen.
vor dem Fortfahren: Grundlagen des maschinellen Lernens für Anfänger
Definition:
Beginnen wir mit einfachen Definitionen:
Maschinelles Lernen ist …
ein Algorithmus, der aus Daten lernen kann, ohne auf regelbasierte Programmierung angewiesen zu sein.
Statistische Modellierung ist …
Formalisierung von Beziehungen zwischen Variablen in Form von mathematischen Gleichungen.
Für Leute wie mich, die Spaß daran haben, Konzepte aus der Praxis zu verstehen, diese Definitionen helfen nicht viel. Dann, Sehen wir uns hier einen Business Case an.
Ein Geschäftsfall
Schauen wir uns nun ein interessantes Beispiel an, das McKinsey öffentlich gemacht hat und die beiden Algorithmen unterscheidet:
Fall : Verstehen Sie das Risiko der Kundenabwanderung über einen bestimmten Zeitraum für ein Telekommunikationsunternehmen.
Verfügbare Daten : Zwei Dirigenten: A und B
Was McKinsey unten zeigt, ist ein absolutes Vergnügen!! Schauen Sie sich einfach die folgende Grafik an, um den Unterschied zwischen einem statistischen Modell und einem Algorithmus für maschinelles Lernen zu verstehen..
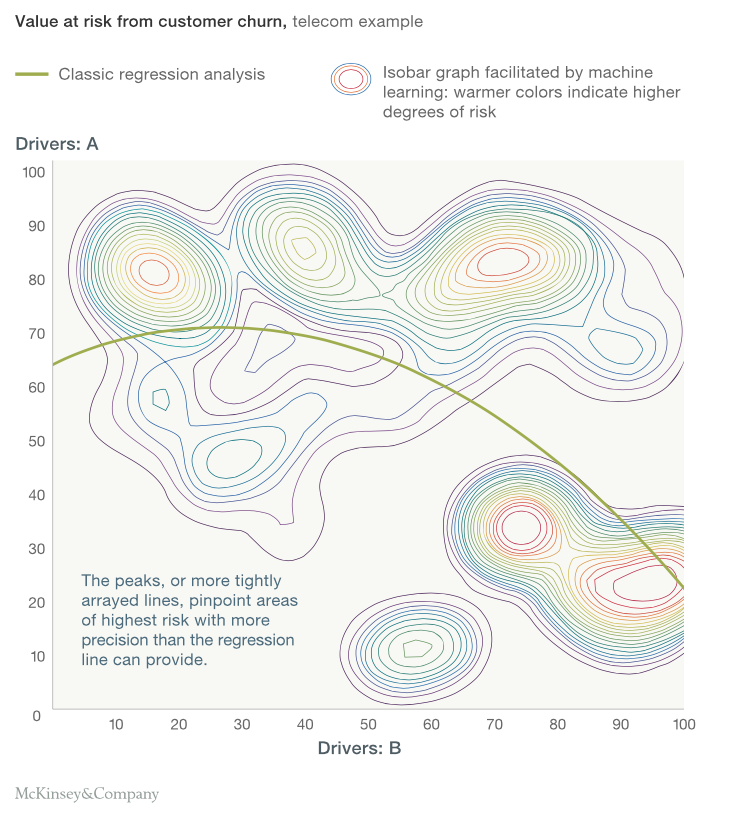
Was haben Sie in der vorherigen Grafik beobachtet?? Beim statistischen Modell geht es darum, eine einfache Formulierung einer Grenze in einem Klassifikationsmodellhindernis zu erhalten. Hier sehen wir einen nichtlinearen Grenzwert, der, Bis zu einem gewissen Grad, trennt gefährdete von Menschen ohne Risiko. Aber wenn wir die vom Machine Learning-Algorithmus erzeugten Konturen sehen, wir sehen, dass die statistische Modellierung für das fragliche Problem nicht mit dem Machine Learning-Algorithmus vergleichbar ist. Konturen des maschinellen Lernens scheinen alle Muster jenseits der Grenzen der Linearität oder sogar der Kontinuität der Grenzen zu erfassen. Das kann maschinelles Lernen für Sie tun.
Wenn das nicht Inspiration genug ist, Algorithmus für maschinelles Lernen wird in Empfehlungsmaschinen von YouTube verwendet / Google, etc., die in einer Sekunde Billionen von Beobachtungen generieren können, um zu einer nahezu perfekten Empfehlung zu gelangen. Auch mit einem Laptop von 16 GB RAM, Arbeiten Sie täglich an Datensätzen mit Millionen von Zeilen mit Hunderten von ParameterDas "Parameter" sind Variablen oder Kriterien, die zur Definition von, ein Phänomen oder System zu messen oder zu bewerten. In verschiedenen Bereichen wie z.B. Statistik, Informatik und naturwissenschaftliche Forschung, Parameter sind entscheidend für die Etablierung von Normen und Standards, die die Datenanalyse und -interpretation leiten. Ihre richtige Auswahl und Handhabung sind entscheidend, um genaue und relevante Ergebnisse in jeder Studie oder jedem Projekt zu erhalten.... und baute ein komplettes Modell in nur 30 Protokoll. Ein statistisches Modell, Außerdem, Sie brauchen einen Supercomputer, um eine Million Beobachtungen mit tausend Parametern durchzuführen.
Unterschiede zwischen maschinellem Lernen und statistischer Modellierung:
Angesichts des Geschmacks des Unterschieds in der Produktion dieser beiden Ansätze, Lass uns den Unterschied zwischen den beiden Paradigmen verstehen, obwohl beide fast gleichwertige Arbeit leisten:
- Schulen, aus denen sie kommen
- Wann sind sie entstanden?
- Annahmen, in denen sie arbeiten
- Art der Daten, die sie verarbeiten
- Feature- und Objektnomenklaturen
- Verwendete Techniken
- Vorhersagekraft und menschliche Anstrengungen, um sie in die Praxis umzusetzen
Alle zuvor erwähnten Unterschiede trennen die beiden bis zu einem gewissen Grad., aber es gibt keine harte Grenze zwischen maschinellem Lernen und statistischer Modellierung.
Sie gehören verschiedenen Schulen an
Maschinelles Lernen ist …
ein Teilgebiet der Informatik und der künstlichen Intelligenz, das für den Aufbau von Systemen verantwortlich ist, die aus Daten lernen können, statt explizit programmierter Anweisungen.
Statistische Modellierung ist …
ein Teilgebiet der Mathematik, das dafür verantwortlich ist, Beziehungen zwischen Variablen zu finden, um ein Ergebnis vorherzusagen
Sie sind zu unterschiedlichen Zeiten entstanden
Statistische Modellierung gibt es schon seit Jahrhunderten. Trotz dieses, maschinelles Lernen ist eine sehr junge Entwicklung. Es entstand im Jahrzehnt des 1990 als ständige Fortschritte in der Digitalisierung und billige Rechenleistung es Data Scientists erlaubten, keine fertigen Modelle mehr zu bauen und, jedoch, Computer trainieren, um es zu tun. Das unüberschaubare Volumen und die Komplexität der großen Datenmengen, in denen die Welt schwimmt, haben das Potenzial und den Bedarf an maschinellem Lernen erhöht..
Umfang der getroffenen Annahmen
Statistische Modellierung arbeitet mit einer Reihe von Annahmen. Als Beispiel, eine lineare Regression geht davon aus:
- Lineare Verknüpfung zwischen VariableIn Statistik und Mathematik, ein "Variable" ist ein Symbol, das einen Wert darstellt, der sich ändern oder variieren kann. Es gibt verschiedene Arten von Variablen, und qualitativ, die nicht-numerische Eigenschaften beschreiben, und quantitative, numerische Größen darstellen. Variablen sind grundlegend in Experimenten und Studien, da sie die Analyse von Beziehungen und Mustern zwischen verschiedenen Elementen ermöglichen, das Verständnis komplexer Phänomene zu erleichtern.... unabhängig und unabhängig
- Homocedasticidad
- Mittlerer Fehler bei Null für jeden abhängigen Wert
- Unabhängigkeit von Beobachtungen
- Der Fehler muss für jeden Wert der abhängigen Variablen gleichmäßig verteilt werden.
Äquivalent, logistische Regressionen kommen mit ihren eigenen Annahmen. Auch ein nichtlineares Modell muss eine stetige Seigerungsgrenze erfüllen. Algorithmen des maschinellen Lernens übernehmen einige dieser Dinge, aber im Allgemeinen sind sie von den meisten dieser Annahmen erspart. Der größte Vorteil der Verwendung eines maschinellen Lernalgorithmus besteht darin, dass keine Grenzkontinuität möglich ist, wie in der obigen Fallstudie gezeigt.. Zur selben Zeit, wir müssen die Verteilung der abhängigen oder unabhängigen Variablen in einem maschinellen Lernalgorithmus nicht angeben.
Arten von Daten, mit denen sie umgehen
Machine-Learning-Algorithmen sind weitreichende Werkzeuge. Online-Lerntools sagen Daten im laufenden Betrieb voraus. Diese Tools sind in der Lage, aus Milliarden von Beobachtungen nacheinander zu lernen. Sie machen Vorhersagen und lernen gleichzeitig. Auch andere Algorithmen wie Random Forest und Gradient Boosting sind bei Big Data außergewöhnlich schnell.. Maschinelles Lernen funktioniert hervorragend mit breiten (große Anzahl von Attributen) und tief (viele Beobachtungen). Trotz dieses, Statistische Modelle werden im Allgemeinen für kleinere Daten mit weniger Attributen angewendet oder enden mit einer Überanpassung.
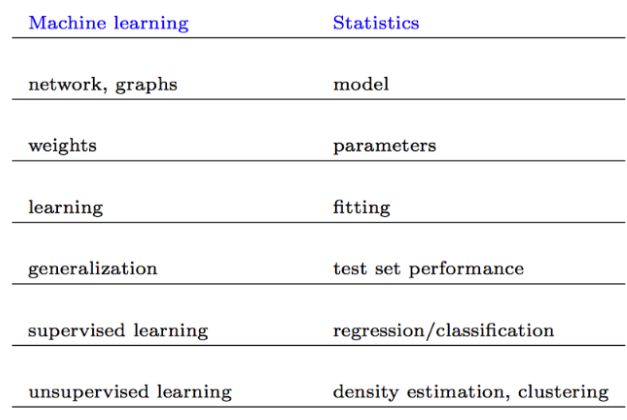
Namenskonvention
Hier sind Namen, die sich auf fast die gleichen Dinge beziehen:
Formulierung
Auch wenn das Endziel für maschinelles Lernen und statistische Modellierung dasselbe ist, die Formulierung von zwei ist deutlich unterschiedlich.
In einem statistischen Modell, wir versuchen einfach die Funktion f in . zu schätzen
Abhängige Variable ( Ja ) = f(Unabhängige Variable) + Fehlerfunktion
Machine Learning entfernt die deterministische Funktion „F“ der Gleichung. Es wird einfach
Ausgabe(Ja) ----- > Eingang (x)
Es wird versucht, Beutel mit X in n Dimensionen zu finden (wobei n die Anzahl der Attribute ist), wobei das Auftreten von Y signifikant anders ist.
Vorhersagekraft und menschliche Anstrengung
Die Natur nimmt nichts an, bevor sie ein Ereignis erzwingt.
Dann, die geringsten Annahmen in einem Vorhersagemodell, desto größer die Vorhersagekraft. Maschinelles Lernen, wie der Name schon sagt, erfordert minimalen menschlichen Aufwand. Maschinelles Lernen funktioniert in Iterationen, in denen der Computer versucht, versteckte Muster in den Daten zu entdecken. Denn die Maschine erledigt diese Arbeit mit vollständigen Daten und ist unabhängig von allen Annahmen, Die Vorhersagekraft dieser Modelle ist im Allgemeinen sehr stark. Das statistische Modell ist intensiv in Mathematik und basiert auf der Schätzung von Koeffizienten. Der Modellierer muss die Bindung zwischen Variablen verstehen, bevor Sie sie eingeben.
Abschließende Anmerkungen
Trotz dieses, Es mag den Anschein haben, dass maschinelles Lernen und statistische Modellierung zwei verschiedene Zweige der prädiktiven Modellierung sind, sie sind fast gleich. Der Unterschied zwischen diesen beiden hat sich in den letzten zehn Jahren deutlich verringert. Beide Branchen haben viel voneinander gelernt und werden in Zukunft enger zusammenrücken. Ich hoffe, ich habe Sie genug motiviert, sich in jedem dieser beiden Bereiche Kenntnisse anzueignen und dann zu vergleichen, wie sie sich ergänzen..
Wenn Sie an maschinellen Lernalgorithmen interessiert sind, wir haben was du brauchst. Wir sind dabei, einen Lernpfad für maschinelles Lernen aufzubauen, der in Kürze veröffentlicht wird..
Teilen Sie uns mit, was Ihrer Meinung nach der Unterschied zwischen maschinellem Lernen und statistischer Modellierung ist. Haben Sie Fallstudien, die die Unterschiede zwischen den beiden aufzeigen??





