
introduction
Si vous avez déjà participé à des concours de science des données, vous devez être conscient du rôle essentiel que joue la modélisation d'ensemble. En réalité, On dit que la modélisation d'ensemble offre l'un des moyens les plus convaincants de créer des modèles prédictifs très précis. La disponibilité de ensachage et renfort Les algorithmes embellissent davantage cette méthode pour produire un niveau de précision étonnant.
Pour cela, la prochaine fois que vous créez un modèle prédictif, envisager d'utiliser cet algorithme. Je me féliciterais certainement de cette suggestion.. Oui, si vous maîtrisez déjà cette méthode, génial. J'aimerais entendre votre expertise sur la modélisation d'ensemble dans la section des commentaires ci-dessous..
Autrement, Je partage certaines des questions les plus fréquemment posées sur la modélisation d'ensemble. Si à tout moment vous souhaitez examiner les connaissances de quelqu'un sur l'ensemble, vous pouvez oser poser ces questions et vérifier vos connaissances. En même temps, ce sont quelques-unes des questions les plus faciles, donc tu ne peux pas oser te tromper.
Quelles sont les questions courantes (associés aux modèles d'ensemble)?
Après avoir analysé plusieurs forums de science des données, j'ai identifié le 5 Questions courantes associées à la modélisation d'ensemble. Ces questions sont très pertinentes pour les data scientists novices en modélisation d'ensemble.. Voici les questions:
- Qu'est-ce qu'un modèle d'ensemble?
- Qu'est-ce que l'ensachage, renforcement et empilage?
- Peut-on assembler plusieurs modèles du même algorithme ML?
- Comment pouvons-nous identifier les poids des différents modèles?
- Quels sont les avantages du modèle d'ensemble?
Analysons chaque question en détail.
1. Qu'est-ce qu'un modèle d'ensemble?
Essayons de le comprendre en résolvant un défi de qualification.
Problème: définir des règles pour trier les e-mails de spam
Solution: Nous pouvons générer plusieurs règles pour la classification des e-mails de spam, voyons certains d'entre eux:
- E-mails indésirables
- Avoir une extension totale inférieure à 20 mots.
- Avoir seulement l'image (images promotionnelles)
- Avoir des mots-clés spécifiques comme « gagner de l'argent et grandir » Oui « réduire votre graisse »
- Plus de mots épelés dans l'e-mail
- Pas de spam
- Adresse e-mail du domaine DataPeaker
- E-mail des membres de la famille ou de toute personne figurant dans le carnet d'adresses e-mail
Dessus, J'ai énuméré quelques règles communes pour filtrer les e-mails de spam. Pensez-vous que toutes ces règles individuellement peuvent prédire la bonne classe?
La plupart d'entre nous diraient non, Et c'est vrai! La combinaison de ces règles fournira une prédiction solide par rapport à la prévision faite par les règles individuelles.. C'est le principe de la modélisation d'ensemble. Le modèle d'ensemble combine plusieurs modèles ‘individuels’ (plusieurs) ensemble et offre une puissance prédictive supérieure.
Si vous voulez faire le lien avec la vraie vie, un groupe de personnes est susceptible de prendre de meilleures décisions par rapport aux individus, surtout lorsque les membres du groupe viennent de plusieurs horizons. Idem pour l'apprentissage automatique. Simplement, un ensemble est une technique de enseignement superviséL’apprentissage supervisé est une approche d’apprentissage automatique dans laquelle un modèle est formé à l’aide d’un ensemble de données étiquetées. Chaque entrée du jeu de données est associée à une sortie connue, permettre au modèle d’apprendre à prédire les résultats pour de nouvelles entrées. Cette méthode est largement utilisée dans des applications telles que la classification d’images, Reconnaissance vocale et prédiction de tendances, soulignant son importance dans... pour combiner plusieurs étudiants / modèles faibles produire un apprenti fort. Le modèle d'assemblage fonctionne mieux lorsque nous assemblons des modèles avec une faible corrélation.
Un bon exemple de la façon dont les méthodes d'ensemble sont couramment utilisées pour résoudre des problèmes de science des données est le forêt aléatoire algorithme (qui a plusieurs modèles CART). Cela fonctionne mieux par rapport au modèle CART individuel lors de la catégorisation d'un nouvel objet où chaque arbre donne « voix » pour cette classe et la forêt choisit la classification qui a le plus de votes (sur tous les arbres de la forêt). En cas de régression, prend la moyenne des sorties de différents arbres.
Vous pouvez également suivre ce post « Définir les bases de l'apprentissage expliquées en anglais simple » pour en savoir plus sur la modélisation d'ensemble.
2. Qu'est-ce que l'ensachage, renforcement et empilage?
Examinons chacun d'eux individuellement et essayons de comprendre les différences entre ces termes.:
Harpillera (Agrégation Bootstrap) est une méthode définie. Premier, nous créons des échantillons aléatoires de l'ensemble de données de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... (sous-ensembles de l'ensemble de données d'apprentissage). Après, nous construisons un classificateur pour chaque échantillon. En résumé, les résultats de ces classificateurs multiples sont combinés par vote moyen ou majoritaire. L'ensachage permet de réduire l'erreur de variance.
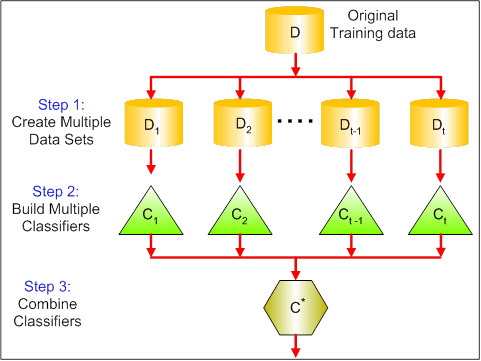
Impulsion fournit un apprentissage séquentiel des prédicteurs. Le premier prédicteur est appris sur l'ensemble de l'ensemble de données, tandis que ce qui suit est appris dans l'ensemble d'entraînement basé sur les performances du précédent.. Ce commencer par classer l'ensemble de données d'origine et donner le même poids à chaque observation. Si les classes sont mal prédites en utilisant le premier élève, alors l'observation classée manquante reçoit un poids plus important. Être une procédure itérative, continue d'ajouter des apprenants classificateurs jusqu'à ce qu'une limite sur le nombre de modèles ou la précision soit atteinte. Impulse a montré une meilleure précision prédictive que l'ensachage, mais il a également tendance à suradapter les données d'entraînement. 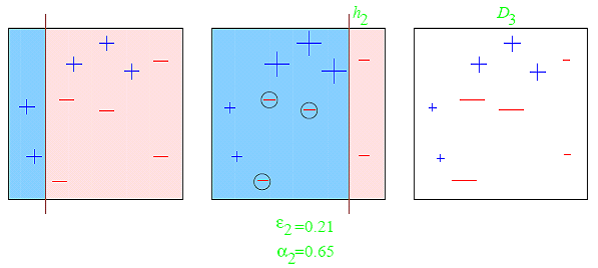
L'exemple le plus courant de booster est AdaBoost et Gradient Boosting. Vous pouvez également consulter ces articles pour plus d'informations sur la façon d'améliorer les algorithmes.
Empilés fonctionne en deux phases. Premier, nous utilisons plusieurs classificateurs de base pour prédire la classe. En second lieu, un nouvel étudiant est utilisé pour combiner leurs prédictions afin de réduire l'erreur de généralisation. 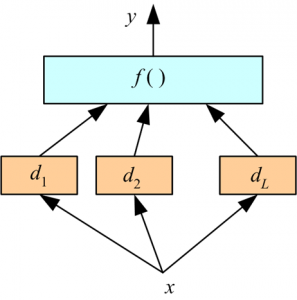
3. Pouvons-nous assembler plusieurs modèles du même algorithme ML?
Oui, nous pouvons combiner plusieurs modèles des mêmes algorithmes ML, mais combiner régulièrement plusieurs prédictions générées par différents algorithmes vous donnerait de meilleures prédictions. Elle est due à la diversification ou à la nature indépendante les unes par rapport aux autres. Par exemple, les prédictions d'une forêt aléatoire, un KNN et un Naive Bayes peuvent être combinés pour créer un ensemble final de prédictions plus robuste par rapport à la combinaison de trois modèles de forêts aléatoires. La clé pour créer un ensemble puissant est la diversité des modèles. Un ensemble avec deux techniques qui sont de nature très équivalente sera moins performant qu'un ensemble plus diversifié de modèles..
Exemple: Disons que nous avons trois modèles (UNE, Par C). UNE, B et C ont une précision de prédiction de la 85%, 80% Oui 55% respectivement. Mais A et B sont fortement corrélés lorsque C est faiblement corrélé avec A et B. Doit-on combiner A et B? Non, nous ne devrions pas, car ces modèles sont fortement corrélés. Pour cela, nous ne combinerons pas ces deux, puisque cet ensemble n'aidera pas à réduire les erreurs de généralisation. Je préfère combiner A et C ou B et C.
4. Comment pouvons-nous identifier les poids des différents modèles pour l'ensemble?
L'un des défis les plus courants avec la modélisation d'ensemble est de trouver des poids optimaux pour les modèles d'ensemble de base. En général, nous supposons le même poids pour tous les modèles et prenons la moyenne des prédictions. Mais, Est-ce la meilleure façon de relever ce défi?
Il existe plusieurs méthodes pour trouver le poids optimal pour combiner tous les élèves de base. Ces méthodes permettent de bien comprendre comment trouver le poids correct. Ensuite, Je liste quelques méthodes:
- Trouver la colinéarité entre les élèves de base et en se basant sur ce tableau, puis identifier les modèles de base à assembler. Après cela, regardez le score de validation croisée (rapport de pointage) des modèles de base identifiés pour trouver le poids.
- Trouver l'algorithme pour retourner le poids optimal pour les étudiants de base. Vous pouvez consulter l'article Comment trouver les poids optimaux pour les apprenants d'ensemble en utilisant un neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. pour voir la méthode afin de trouver le poids optimal.
- Nous pouvons également résoudre le même problème en utilisant des méthodes telles que:
Vous pouvez également voir la réponse gagnante des concours de science des données / Kaggle pour comprendre d'autres méthodes pour relever ce défi.
5. Quels sont les avantages du modèle d'ensemble?
Les modèles Ensemble présentent deux avantages principaux:
- Meilleure prédiction
- Modèle plus stable
L'opinion agrégée des différents modèles est moins bruyante que celle des autres modèles. En finance, appel « Diversification »: un portefeuille diversifié de nombreuses actions sera beaucoup moins variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... risqué qu'une seule des actions. C'est aussi pourquoi vos modèles seront meilleurs avec des ensembles de modèles plutôt qu'avec des modèles individuels.. L'une des précautions avec les modèles d'ensemble est qu'ils sont trop serrés., même si l'ensachage s'en occupe en grande partie.
Note finale
Dans ce billet, nous avons analysé le 5 Foire aux questions sur les modèles Ensemble. En répondant à ces questions, nous avons discuté des "Modèles d'Ensemble", « Méthodes d'ensemble », "Pourquoi devrions-nous assembler plusieurs modèles?", "Méthodes pour identifier le poids optimal pour l'ensemble" et pour finir "Avantages". Je vous suggère de regarder le 5 meilleures solutions de quiz sur la science des données et voir leurs approches communes pour une meilleure compréhension et beaucoup de pratique. Cela vous aidera à comprendre ce qui fonctionne et ce qui ne fonctionne pas.
Ce message vous a-t-il été utile? Avez-vous essayé autre chose pour trouver les poids optimaux ou identifier l'élève de base approprié ?? Je serai heureux de vous entendre dans la section des commentaires ci-dessous..





