
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
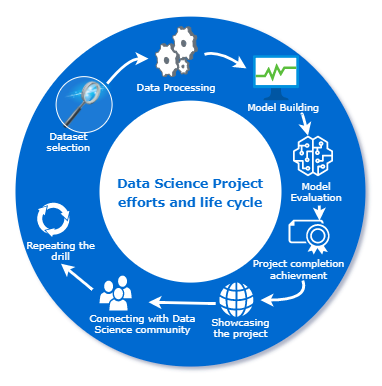
Étapes pour votre premier projet de science des données
Dans cet article, Examinons quelques conseils que vous pouvez utiliser pour démarrer vos projets personnels de science des données..
1. Choisissez un ensemble de données
Si vous entreprenez le projet de science des données pour la première fois, choisissez un ensemble de données qui vous intéresse. Peut être lié au sport, films ou musique, tout ce qui vous intéresse. Les sites Web les plus courants pour obtenir les données sont:
Pour ceux qui ont déjà réalisé un ou deux projets, de bout en bout tout seul, en suivant les directives ci-dessus, peut cibler l'analyse d'un ensemble de données complexes d'un domaine particulier tel que la vente au détail, finance ou santé pour se faire une idée des projets en temps réel.
Pour commencer, avait sélectionné un ensemble de données d'assurance maladie pour pratiquer l'analyse prédictive. J'ai extrait l'ensemble de données du site Web de Kaggle
! pip install -q kaggle
#à partir des fichiers d'importation google.colab
#fichiers.télécharger()
! mkdir ~/.kaggle
! cp kaggle.json ~/.kaggle/
! chmod 600 ~/.kaggle/kaggle.json
#! téléchargement des ensembles de données kaggle -d mirichoi0218/insurance
#! unzip assurance.zip -d assurance-maladie
! téléchargement des ensembles de données kaggle -d mirichoi0218/insurance
! unzip assurance.zip -d assurance-maladie
2. Choisissez un IDE
Sélectionnez un IDE avec lequel vous êtes le plus à l'aise. Si vous utilisez Python comme langage, Voici quelques exemples
- – C'est un IDE conçu pour écrire des codes Python. Fournit diverses fonctions productives telles que les soins de routine, complétion de code intelligent, vérification d'erreurs et correction de code. Facilite la maintenance du projet en fournissant une intégration avec les fonctions de contrôle de version, prend en charge le développement Web et la science des données.
- Cahier Jupyter – Il s'agit d'une application Web open source qui vous permet de créer et de partager des documents contenant du code en direct, équations et visualisation. Aide à rationaliser le travail et à faciliter les collaborations
- Google Colab – Permet aux utilisateurs d'écrire et d'exécuter du code Python. Il est très approprié pour les projets de science des données et d'apprentissage automatique, car il offre des ressources de calcul gratuitement. Vous pouvez exécuter ici facilement des algorithmes d'apprentissage machine lourds sans avoir à vous soucier de l'infrastructure ou des coûts.
- Fichier texte simple avec extension .py: bien que les options ci-dessus soient disponibles et faciles à utiliser, si vous vous sentez plus à l'aise avec le bloc-notes pour écrire votre code, vous pouvez l'utiliser et enregistrer votre fichier avec l'extension .py. Ensuite, vous pouvez exécuter la même chose en utilisant une ligne de commande avec une syntaxe telle que "python <> .py. Cela exécutera votre programme, mais pour les emplois en science des données, ce n'est peut-être pas la meilleure option, puisque vous ne pouvez pas voir la sortie du code ou les visualisations à la volée.
J'ai choisi Google Colab comme environnement de travail.
3. Lister clairement les activités
Faites une liste des activités que vous souhaitez faire dans l'ensemble de données afin d'avoir un chemin clair avant de commencer. Les activités courantes que nous réalisons dans les projets de science des données sont l'ingestion de données, nettoyage des données, transformation de données, l'analyse exploratoire des données, construction de modèles, évaluation du modèle et mise en œuvre du modèle. Voici un résumé de toutes ces étapes.
- Ingestion de données – C'est un processus de lecture des données dans une trame de données.
###Le package Panda facilite la lecture d'un fichier dans une trame de données

#Importation des bibliothèques
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
de matplotlib.cbook importer boxplot_stats
importer statsmodels.api en tant que sm
de sklearn.model_selection importer train_test_split,GrilleRechercheCV, cross_val_score, cross_val_predict
de statsmodels.stats.outliers_influence importer variance_inflation_factor
depuis sklearn.tree importer DecisionTreeRegressor
de l'ensemble d'importation sklearn
importer numpy en tant que np
importer des cornichons

#Lecture et synthèse des données
health_ins_df = pd.read_csv("assurance-maladie/insurance.csv")
health_ins_df.columns
health_ins_df.shape
health_ins_df.describe()
- Nettoyage des données – C'est le processus d'identification et d'élimination des anomalies dans l'ensemble de données.
- Transformation de données – Cela implique de changer le type de données des colonnes, créer des colonnes dérivées ou supprimer des données en double, pour n'en nommer que quelques-uns.
- L'analyse exploratoire des données – Effectuez une analyse univariée et multivariée sur des ensembles de données pour y trouver des informations et des modèles cachés.
Je me suis consacré au nettoyage des données et à l'analyse exploratoire des données de variables numériques et catégorielles à des jours différents pour me concentrer sur les détails..
#Visualisation de la colonne d'âge avec un histogramme
figure,axes=plt.subplots(1,2,taille de la figue=(10,5))
sns.histplot( health_ins_df['age'] , couleur="bleu ciel",hache=axes[0])
sns.histplot( health_ins_df['bmi'] , couleur="olive",hache=axes[1])
plt.show()
#Visualisation de la colonne d'âge avec une boîte à moustaches
figure,axes=plt.subplots(1,2,taille de la figue=(10,5))
sns.boxplot(x = 'age', données = health_ins_df, hache=axes[0])
sns.boxplot(x = 'bmi', données = health_ins_df, hache=axes[1])
plt.show()
#Recherche des valeurs aberrantes dans la colonne bmi
outlier_list = boxplot_stats(health_ins_df.bmi).pop(0)['fliers'].lister()
imprimer(liste_aberrante)
#Trouver le nombre de lignes contenant des valeurs aberrantes
outlier_bmi_rows = health_ins_df[health_ins_df.bmi.isin(liste_aberrante)].forme[0]
imprimer("Nombre de lignes contenant des valeurs aberrantes dans l'IMC : ", outlier_bmi_rows)
#Pourcentage de lignes qui sont des valeurs aberrantes
percent_bmi_outlier = (outlier_bmi_rows/health_ins_df.shape[0])*100
imprimer("Pourcentage de valeurs aberrantes dans les colonnes de l'IMC : ", percent_bmi_outlier)
#Conversion de l'âge en tranches d'âge
imprimer("Valeur minimale pour l'âge : ", health_ins_df['age'].min(),"nValeur maximale pour l'âge : ", health_ins_df['age'].max())
#Âge entre 18 à 40 les années tomberont sous les jeunes
#Âge entre 41 à 58 les années tomberont sous le milieu de l'âge
#Âge ci-dessus 58 les années tomberont sous la vieillesse
health_ins_df.loc[(health_ins_df['age'] >=18) & (health_ins_df['age'] <= 40), 'age_group'] = 'young'
health_ins_df.loc[(health_ins_df['age'] >= 41) & (health_ins_df['age'] <= 58), 'age_group'] = 'mid-age'
health_ins_df.loc[health_ins_df['age'] > 58, 'age_group'] = 'old'

fig,axes=plt.subplots(1,5,taille de la figue=(20,8))
sns.countplot(x = 'sex', données = health_ins_df_clean, palette="magma",hache=axes[0])
sns.countplot(x = 'children', données = health_ins_df_clean, palette="magma",hache=axes[1])
sns.countplot(x = 'smoker', données = health_ins_df_clean, palette="magma",hache=axes[2])
sns.countplot(x = 'region', données = health_ins_df_clean, palette="magma",hache=axes[3])
sns.countplot(x = 'age_group', données = health_ins_df_clean, palette="magma",hache=axes[4])
heatmap = sns.heatmap(health_ins_df_clean.corr(), vmin=-1, vmax=1, annot=Vrai)
sns.relplot(x="imc", y ="des charges",teinte ="sexe", style = "sexe", data=health_ins_df_clean);
sns.boxplot(x="fumeur", y ="des charges", data=health_ins_df_clean)
- Construction du modèle – Essayez et testez tous les modèles possibles dans l'ensemble de données avant de choisir le bon en fonction des limites de l'entreprise / technique. Au cours de cette phase, vous pouvez également essayer des techniques d'ensachage ou de renforcement.
J'ai d'abord développé un modèle de base, avant de tester des modèles avancés sur l'ensemble de données
#Pré-traitement des données
#Conversion de valeurs catégorielles en mannequins à l'aide de la technique d'encodage one-hot
health_ins_df_processed = pd.get_dummies(health_ins_df_clean, colonnes=['sexe','enfants','fumeur','région','age_group'], préfixe=['sexe','enfants','fumeur','région','age_group'])
health_ins_df_processed.drop(['age'],axe = 1, en place = vrai)
#Construction d'un modèle de régression linéaire
X = health_ins_df_processed.loc[:, health_ins_df_processed.columns != 'charges']
y = health_ins_df_processed['charges']
X_train, X_test, y_train, y_test = train_test_split(X, Oui, taille_test=0.33)
X = sm.add_constant(X) # ajouter une constante
modèle = sm.OLS(Oui, X).ajuster()
prédictions = model.predict(X)
print_model = model.summary()
imprimer(print_model)
#Modèle final après élimination de la variable la moins significative et le vif élevé
X = health_ins_df_processed[['bmi','children_0', 'smoker_yes',  'region_southeast', 'region_southwest', 'age_group_old', 'age_group_young']]
y = health_ins_df_processed['charges']
X_train, X_test, y_train, y_test = train_test_split(X, Oui, taille_test=0.33)
X = sm.add_constant(X) # ajouter une constante
modèle = sm.OLS(Oui, X).ajuster()
prédictions = model.predict(X)
print_model = model.summary()
imprimer(print_model)
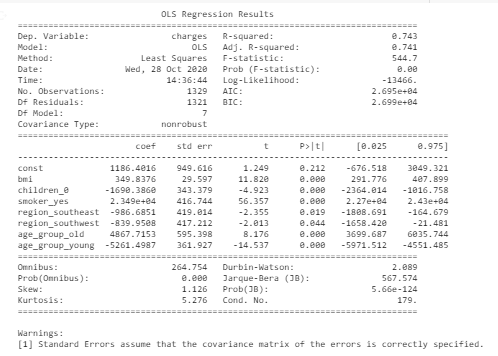
- Évaluation du modèle – Dans cette phase, nous testons si notre modèle est assez bon pour obtenir un résultat attendu. Nous mesurons la précision, spécificité, sensibilité ou R-carré ajusté selon le modèle que nous avons utilisé
Il s'agit de la métrique d'évaluation finale du modèle de base qui montre une 74% précision et 7 variables significatives (valeur p <valeur de signification)
4. Terminez les tâches une par une
À ce point, vous devriez avoir une idée des activités à faire dans votre projet. Vous pouvez les prendre un par un. Pas nécessairement, vous devez tout terminer en une journée. Cela peut prendre jusqu'à 1 jour de temps pour décider sur quel jeu de données vous voulez travailler et dans quel environnement vous êtes à l'aise.
Peut consacrer la journée 2 comprendre les données et effectuer des activités de nettoyage des données. De la même manière, vous pouvez viser à réaliser votre projet dans un délai de 7-8 jours.
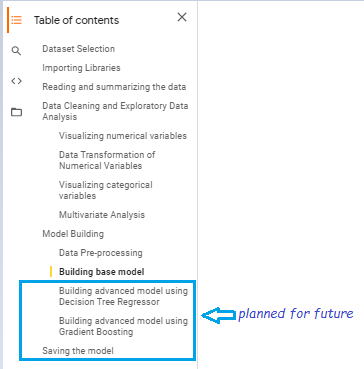
J'ai réalisé ce projet en l'espace de 4 jours. J'ai prévu de tester des modèles plus avancés pour augmenter les performances prédictives
5. Préparer un résumé
Je préparerai un bref résumé une fois ce projet terminé.
6. Partagez-le sur des plateformes open source
Choisissez une plate-forme open source sur laquelle vous souhaitez publier le brief ou les codes du projet afin de gagner en visibilité dans la communauté de la science des données et de vous connecter avec d'autres passionnés. GitHub est plus couramment utilisé de nos jours. Il existe peu de sites comme Kaggle, Google Colab offrant des noyaux en ligne afin que vous puissiez écrire du code et l'exécuter sans avoir à vous soucier de l'infrastructure. Vous pouvez également profiter de ces plateformes.
Le code source est disponible dans mon GitHub compte
Les avantages d'assumer les projets par étapes
1. Il n'y a aucune pression pour terminer le projet en une journée.
2. Vous pouvez vous concentrer uniquement sur une tâche spécifique par jour et la terminer efficacement.
3. Il vous gardera collé aux tâches jusqu'à la fin
4. Le résumé du projet peut être référencé à l'avenir lors de la préparation des entretiens ou de la réalisation de types de projets similaires..
5. Vous pouvez profiter de ce projet pour vous connecter avec d'autres passionnés de science des données et partager des idées créatives..
J'ai appris que nous devons suivre une approche disciplinée de l'apprentissage et investir notre temps dans des projets. On en apprend tous plus, faire les choses de manière pratique. En dernier recours, c'est le travail acharné et la persévérance qui vous mèneront sur le chemin que vous avez toujours rêvé de tracer.





