
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Dans l'article d'aujourd'hui, Je parlerai du développement d'un réseau de neurones convolutifs qui utilise l'API fonctionnelle TensorFlow. Dispensera la capacité fonctionnelle de l'API, nous permettant de produire une architecture de modèle hybride qui dépasse la capacité d'un modèle séquentiel primaire.
À propos de: TensorFlow
TensorFlow est une bibliothèque populaire, quelque chose que vous entendez probablement perpétuellement dans la société du Deep Learning et de l'Intelligence Artificielle. Existen numerosos paquetes y proyectos de código abierto para el l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé....
- TensorFlow, une bibliothèque d'intelligence artificielle open source qui gère les organigrammes de données, est la bibliothèque d'apprentissage en profondeur la plus courante. Il est utilisé pour générer des réseaux de neurones à grande échelle avec d'innombrables couches.
- TensorFlow est utilisé pour des situations d'apprentissage en profondeur ou d'apprentissage automatique comme la classification, la perception, la perception, Découverte, Prévisions et production.
Ensuite, quand on interprète un problème de classification, aplicamos un modelo de convolucional neuronal rougeRéseaux de neurones convolutifs (CNN) sont un type d’architecture de réseau neuronal conçu spécialement pour le traitement de données avec une structure en grille, comme images. Ils utilisent des couches de convolution pour extraire des caractéristiques hiérarchiques, Ce qui les rend particulièrement efficaces dans les tâches de reconnaissance et de classification des formes. Grâce à sa capacité à apprendre à partir de grands volumes de données, Les CNN ont révolutionné des domaines tels que la vision par ordinateur... Même comme ça, la plupart des développeurs étaient familiers avec la modélisation de modèle séquentiel. Les couches sont accompagnées une à une.
- L'API séquentielle vous permet de concevoir des modèles couche par couche pour les problèmes les plus importants.
- La difficulté est limitée car elle ne vous permet pas de produire des modèles partageant des couches ou ayant des entrées ou des sorties ajoutées.
- À cause de, nous pouvons pratiquer l'API fonctionnelle Tensorflows en tant que modèle de sortie multiple.
API fonctionnelle (tf.Dur)
L'API fonctionnelle dans tf.Dur est un moyen alternatif de construire des modèles plus flexibles, y compris la formulation d'un modèle plus complexe.
- Par exemple, lors de la mise en œuvre d'un exemple négligeablement plus compliqué avec l'apprentissage automatique, vous pouvez rarement être confronté à l'état où vous demandez des modèles supplémentaires pour les mêmes données.
- Ensuite, nous aurions besoin de produire deux sorties. L'option la plus gérable serait de construire deux modèles distincts basés sur les données correspondantes pour faire des prédictions..
- Ce serait lisse, mais si, dans le scénario actuel, nous devions avoir 50 résultats? Cela pourrait être un problème de garder tous ces modèles séparés.
- Alternativement, il est plus fructueux de construire un modèle unique avec de meilleurs résultats.
En méthode API ouverte, les modèles sont déterminés en formant des couches et en les corrélant directement les uns aux autres dans des ensembles, puis un modèle est établi qui définit les couches pour fonctionner comme entrée et sortie.
Ce qui est différent dans l'API séquentielle?
L'API séquentielle vous permet de générer des modèles couche par couche pour la plupart des requêtes majeures. Il est réglementé car il ne vous permet pas de concevoir des modèles partageant des couches ou ayant des entrées ou des sorties ajoutées.
Comprenons comment créer un objet de modèle d'API séquentiel ci-dessous:
	model = tf.keras.models.Sequential([
	 tf.keras.layers.Aplatir(input_shape=(28, 28)),
	 tf.hard.layers.Dense(128, activation=’relu’),
	 tf.keras.layers.Dropout(0.2),
	 tf.hard.layers.Dense(10, activation='softmax')
	])
- En API fonctionnelle, vous pouvez concevoir des modèles qui produisent beaucoup plus de polyvalence. Sans doute, peut corriger les modèles dans lesquels les couches se rapportent à plus qu'avant et après les couches.
- Peut combiner des calques avec plusieurs autres calques. Comme conséquence, la production de réseaux hétérogènes comme les réseaux siamois et les réseaux résiduels devient réalisable.
Commençons à développer un modèle CNN en pratiquant une API fonctionnelle
Dans ce billet, utilizamos el conjunto de datos MNIST para construir la neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. convolucional para la clasificación de imágenes. La base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... del MNIST comprende 60,000 images de formation et 10,000 images de test obtenues auprès d'employés du US Census Bureau et de lycéens américains.
	# importer des bibliothèques
importer numpy en tant que np
importer tensorflow en tant que tf
de tensorflow.keras.layers importer Dense, Abandonner, Saisir
de tensorflow.keras.layers importer Conv2D, MaxPooling2D, Aplatir
depuis tensorflow.keras.models importer le modèle
de tensorflow.keras.datasets importer mnist
	# charger les données
	(x_train, y_train), (x_test, y_test) = mnist.load_data()
	# convertir une étiquette clairsemée en valeurs catégorielles
num_labels = longueur(np.unique(y_train))
	y_train = to_categorical(y_train)
	y_test = to_categorical(y_test)
	# prétraiter les images d'entrée
taille_image = x_train.shape[1]
	x_train = np.reshape(x_train,[-1, taille de l'image, taille de l'image, 1])
	x_test = np.reshape(x_test,[-1, taille de l'image, taille de l'image, 1])
	x_train = x_train.astype('float32') / 255
	x_test = x_test.astype('float32') / 255
Dans le code ci-dessus,
- Distribuí estos dos grupos como entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... y prueba y distribuí las etiquetas y las entradas.
- Les variables indépendantes (x_train y x_test) contiennent des codes RVB en niveaux de gris de 0 une 255, tandis que les variables dépendantes (y_train e y_test) porter des étiquettes de 0 une 9, qui décrivent quel nombre ils sont vraiment.
- C'est une bonne pratique de normaliser nos données, comme il est constamment requis dans les modèles d'apprentissage en profondeur. Nous pouvons y parvenir en divisant les codes RVB par 255.
Ensuite, inicializamos los paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... para las redes.
	# paramètres pour le réseau
input_shape = (taille de l'image, taille de l'image, 1)
	taille_bat = 128
	taille_noyau = 3
	filtres = 64
	abandon = 0.3
Dans le code ci-dessus,
- input_shape: La variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... representa la necesidad de planificar y diseñar una couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques.... independiente que designe los datos de entrada. La couche d'entrée accepte un argument pour qu'il s'agisse d'un tuple qui décrit les dimensions des données d'entrée.
- La taille du lot: est un hyperparamètre qui détermine le nombre d'échantillons à exécuter avant de mettre à jour les paramètres internes du modèle.
- taille_noyau: concerne les dimensions (la taille x largeur) masque filtrant. Réseaux de neurones convolutifs (CNN) ils sont essentiellement un empilement de couches marqué par les opérations de divers filtres sur l'entrée. Ces filtres sont communément appelés noyaux..
- filtre: est exprimé par un vecteur de poids entre lesquels on convolue l'entrée.
- Laisser: est un processus dans lequel des neurones choisis au hasard sont négligés pendant l'entraînement. Ceci implique que leur participation à l'activation des neurones en aval est temporairement exclue dans le passage frontal..
Définissons un perceptron multicouche simpliste, un réseau de neurones convolutifs:
	# utiliser une API fonctionnelle pour créer des couches cnn
entrées = entrée(forme = entrée_forme)
	y = Conv2D(filtres=filtres,
	 kernel_size=kernel_size,
	 activation='relu')(contributions)
	y = MaxPooling2D()(Oui)
	y = Conv2D(filtres=filtres,
	 kernel_size=kernel_size,
	 activation='relu')(Oui)
	y = MaxPooling2D()(Oui)
	y = Conv2D(filtres=filtres,
	 kernel_size=kernel_size,
	 activation='relu')(Oui)
	# convertir une image en vecteur
y = Aplatir()(Oui)
	# régularisation des abandons
y = Abandon(abandonner)(Oui)
	sorties = Dense(nombre_étiquettes, activation='softmax')(Oui)
	 # construction de modèles en fournissant des entrées/sorties
modèle = modèle(entrées=entrées, sorties=sorties)
Dans le code ci-dessus,
- Nous spécifions un modèle de perceptron multicouche vers une classification binaire.
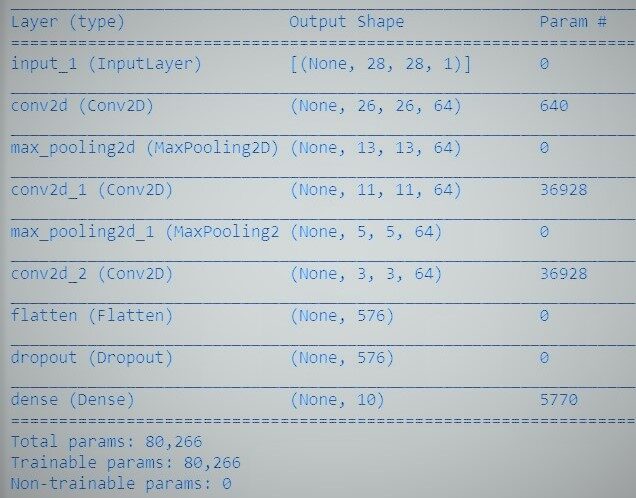
- Le modèle contient une couche d'entrée, 3 calques cachés à côté de 64 neurones et une couche de produit avec 1 Sortir.
- Les fonctions de déclenchement linéaire rectifiées s'appliquent à tous les calques masqués, y se adopta una fonction de réveilLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications.... softmax en la capa de producto para la clasificación binaria.
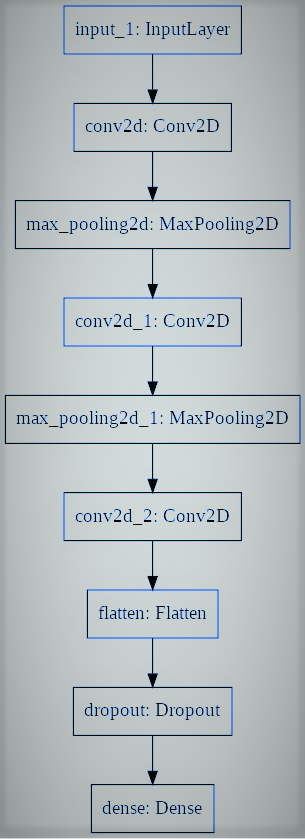
- Et vous pouvez voir que les couches du modèle sont corrélées par paires. Ceci est accompli en stipulant d'où vient l'entrée tout en déterminant chaque nouvelle couche.
- Comme pour toutes les API séquentielles, le modèle est l'information que nous pouvons résumer, régler, évaluer et appliquer pour exécuter les prédictions.
TensorFlow introduit une classe de modèle que vous pouvez pratiquer pour générer un modèle à partir de vos couches développées. Nécessite que vous définissiez uniquement les couches d'entrée et de sortie, cartographier la structure et le graphique du modèle d'architecture de réseau.
Finalement, nous formons le modèle.
	modèle.compile(perte ="catégorique_crossentropie",
	 optimiseur="Adam",
	 métriques=['précision'])
	model.fit(x_train,
	 y_train,
	 validation_data=(x_test, y_test),
	 époques=20,
	 batch_size=bat_size)
	# évaluation de la précision
score = modèle.évaluer(x_test,
	 y_test,
	 batch_size=bat_size,
	 verbeux=0)
	imprimer("nTest de précision: %.1F%%" % (100.0 * But[1]))
Nous avons maintenant développé avec succès un réseau de neurones convolutifs pour distinguer les chiffres manuscrits avec l'API Tensorflow fonctionnelle. Nous avons obtenu une précision supérieure à 99% et nous pouvons enregistrer le modèle et concevoir une application Web de classification des chiffres.
Les références:
- https://www.tensorflow.org/guide/keras/functional
- https://machinelearningmastery.com/keras-functional-api-deep-learning/
Les médias présentés dans cet article sur la reconnaissance de la langue des signes ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





