
introduction
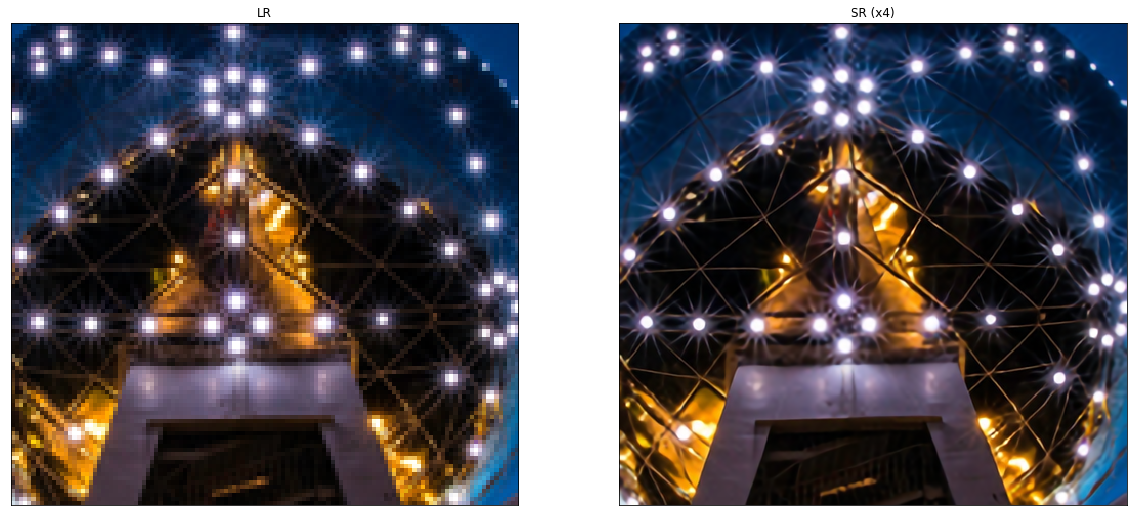
(RS) est le processus de récupération haute résolutionLa "résolution" fait référence à la capacité de prendre des décisions fermes et d’atteindre les objectifs fixés.. Dans des contextes personnels et professionnels, Il s’agit de définir des objectifs clairs et d’élaborer un plan d’action pour les atteindre. La résolution est essentielle à la croissance personnelle et à la réussite dans divers domaines de la vie, car cela vous permet de surmonter les obstacles et de rester concentré sur ce qui compte vraiment.... (HEURE) images de basse résolution (G / D) images. Il s'agit d'une classe importante de techniques de traitement d'images dans la vision par ordinateur et le traitement d'images et bénéficie d'un large éventail d'applications dans le monde réel., comme images médicales, images satellites, vigilance et sécurité, images astronomiques, entre autres.
Con el avance en las técnicas de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... en los últimos años, Les modèles de SR basés sur l'apprentissage en profondeur ont été activement explorés et, souvent, atteindre des performances de pointe dans divers benchmarks SR. Une variété de méthodes d'apprentissage en profondeur ont été appliquées pour résoudre des tâches de RH, allant de la méthode basée sur les réseaux de neurones convolutifs (CNN) aux récentes approches prometteuses de SR basées sur des réseaux génératifs défavorables.
Problème
Le problème de la suppression d'images (RS), en particulier la super-résolution d'une seule image (SISR), a attiré beaucoup d'attention dans la communauté des chercheurs. SISR vise à reconstruire une image haute résolution IRS image unique basse résolution IG / D. Généralement, la relation entre moiG / D et l'image haute résolution d'origine IHEURE peut varier selon la situation. De nombreuses études supposent que jeG / D est une version bicubique réduite de IHEURE, mais d'autres facteurs dégradants comme le flou, la destruction ou le bruit peuvent également être envisagés pour des applications pratiques.
Dans cet article, nous nous concentrerons sur enseignement superviséL’apprentissage supervisé est une approche d’apprentissage automatique dans laquelle un modèle est formé à l’aide d’un ensemble de données étiquetées. Chaque entrée du jeu de données est associée à une sortie connue, permettre au modèle d’apprendre à prédire les résultats pour de nouvelles entrées. Cette méthode est largement utilisée dans des applications telles que la classification d’images, Reconnaissance vocale et prédiction de tendances, soulignant son importance dans... méthodes pour les tâches de super-résolution. Lors de l'utilisation d'images HR comme cible et LR comme entrée, on peut traiter ce problème comme un problème d'apprentissage supervisé.
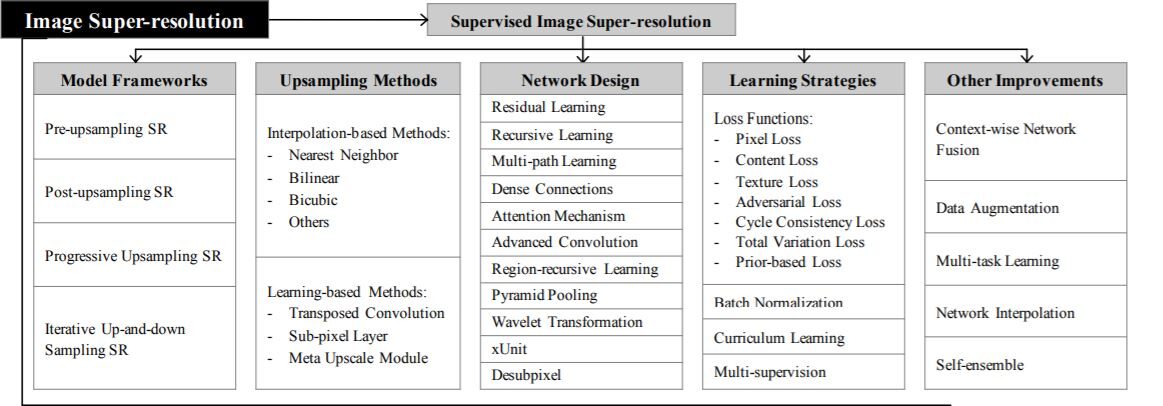
Méthodes d'échantillonnage supérieures
Avant de comprendre le reste de la théorie derrière la super résolution, nous devons comprendre échantillonnage (Augmenter la résolution spatiale des images ou simplement augmenter le nombre de lignes / colonnes de pixels ou les deux dans l'image) et ses différentes méthodes.
1. Méthodes basées sur l'interpolation – Interpolation d'images (mise à l'échelle de l'image) fait référence au redimensionnement des images numériques et est largement utilisé par les applications liées à l'image. Les méthodes traditionnelles incluent l'interpolation du plus proche voisin, interpolation linéaire, binaural, bicubique, etc.
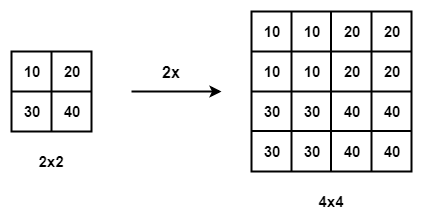
Interpolation du plus proche voisin à l'échelle de 2
- Interpolation du voisin le plus proche – L'interpolation par le plus proche voisin est un algorithme simple et intuitif. Sélectionne la valeur de pixel la plus proche pour chaque position à interpoler indépendamment de tout autre pixel.
- Interpolation bilinéaire – Interpolation bilinéaire (DEVENIR) effectue d'abord une interpolation linéaire sur un axe de l'image puis sur l'autre axe. Comme il en résulte une interpolation quadratique avec un champ récepteur de 2 × 2, montre de bien meilleures performances que l'interpolation du plus proche voisin, maintenir une vitesse relativement rapide.
- Interpolation bicubique – de la même manière, interpolation bicubique (BCI) effectue une interpolation cubique sur chacun des deux axes. Par rapport à BLI, le BCI prend en compte 4 × 4 pixels et donne des résultats plus fluides avec moins d'artefacts mais une vitesse beaucoup plus faible. Référer pour ça pour une discussion détaillée.
Carences – Les méthodes basées sur l'interpolation introduisent souvent des effets secondaires comme la complexité de calcul, amplification du bruit, résultats flous, etc.
2. Échantillonnage ascendant basé sur l'apprentissage – Pour surmonter les lacunes des méthodes basées sur l'interpolation et apprendre le suréchantillonnage de bout en bout, la couche de convolution transposée et la couche de sous-pixel sont saisies dans le champ SR.
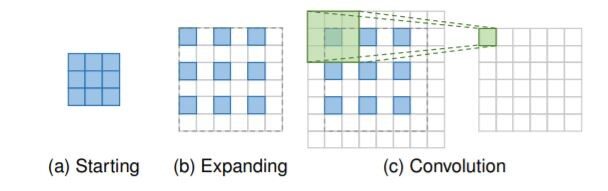
Couche de convolution transposée: les carrés bleus indiquent l'entrée,
et les cases vertes indiquent le noyau et la sortie de convolution.
- Convolution transposée: couche, également appelée couche de déconvolution, essayer d'effectuer une transformation opposée à une convolution normale, c'est-à-dire, prédire l'entrée possible en fonction des cartes de caractéristiques de la taille de la sortie de convolution. Spécifiquement, augmente la résolution de l'image en agrandissant l'image en insérant des zéros et en effectuant une convolution.
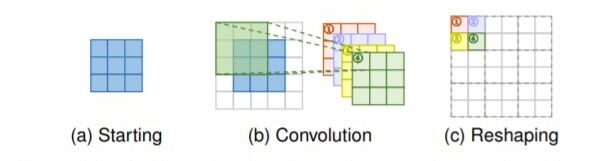
Couche de sous-pixels: les cases bleues indiquent l'entrée et les cases avec d'autres couleurs indiquent différentes opérations de convolution et différentes cartes de caractéristiques de sortie.
- Couche de sous-pixels: La couche de sous-pixels, une autre couche de suréchantillonnage qui peut être apprise de bout en bout, effectue un suréchantillonnage en générant une pluralité de canaux par convolution puis en remodelant les programmes. Au sein de cette couche, une convolution est d'abord appliquée pour produire des sorties avec
s2 canaux horaires, où s est le facteur d'échelle. En supposant que la taille d'entrée est h × l × c, la taille de sortie sera h × l × s2C. Après cela, l'opération de remise en forme est effectuée pour produire des sorties de taille sh × sw × c
Cadres de superrésolution
Puisque la super-résolution d'image est un problème mal posé, comment suréchantillonner (c'est-à-dire, générer une sortie de fréquence cardiaque à partir de l'entrée LR) est le problème clé. Il existe principalement quatre bases de sondage basées sur les principales opérations d'échantillonnage utilisées et leurs emplacements dans le modèle. (voir le tableau ci-dessus).
1. Super résolution de pré-échantillonnage –
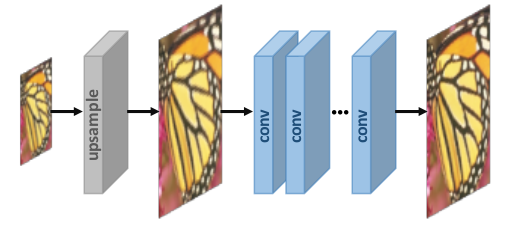
Nous ne faisons pas de mappage direct des images LR aux images HR car cela est considéré comme une tâche difficile. Utiliser des algorithmes de suréchantillonnage traditionnels pour obtenir des images à plus haute résolution, puis les affiner à l'aide de réseaux de neurones profonds est une solution simple. Par exemple, Les images LR sont échantillonnées en images HR épaisses avec la taille souhaitée par interpolation bicubique. Alors, des CNN profonds sont appliqués à ces images pour reconstruire des images de haute qualité.
2. Super résolution post-échantillon:
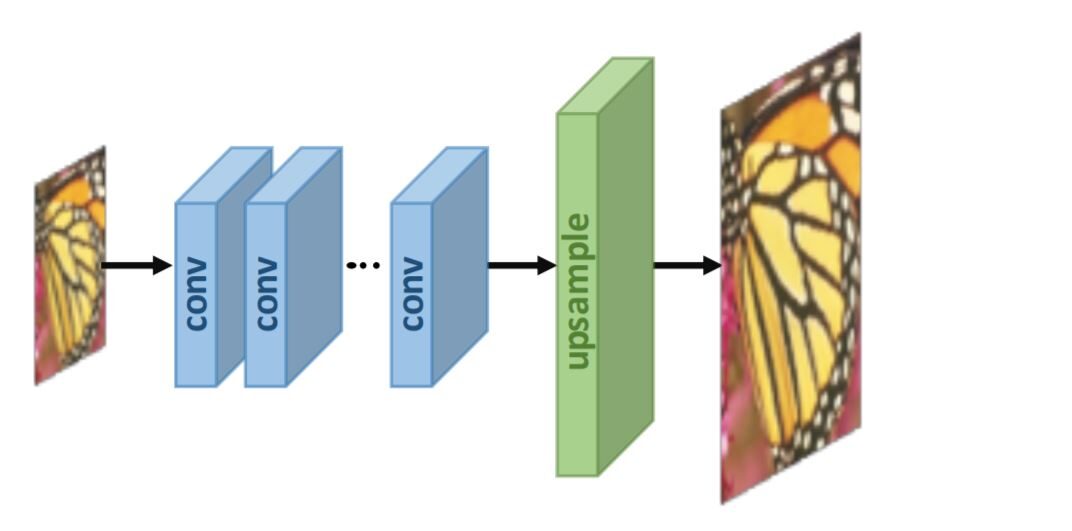
Pour améliorer l'efficacité de calcul et tirer pleinement parti de la technologie d'apprentissage en profondeur pour augmenter automatiquement la résolution, los investigadores proponen realizar la mayoría de los cálculos en un espacio de baja dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et... reemplazando el muestreo predefinido con capas de aprendizaje de extremo a extremo integradas al final de los modelos. Dans le travail pionnier de ce cadre, a savoir, SR post-échantillonnage, Les images d'entrée LR alimentent CNN en profondeur sans augmenter la résolution, et les couches d'échantillonnage supérieures qui peuvent être apprises de bout en bout sont appliquées à la fin du réseau.
Stratégies d'apprentissage
Dans le domaine de la super résolution, les fonctions de perte sont utilisées pour
mesurer l'erreur de reconstruction et guider l'optimisation du modèle. Dans les premiers jours, les chercheurs utilisent généralement Perte L2 par pixel (erreur quadratique moyenne), mais alors il découvre qu'il ne peut pas mesurer le
qualité de reconstruction très précise. Donc, une variété
fonctions de perte (p. ne pas., perte de contenu, les adversairess) sont adoptés pour mieux mesurer la reconstruction
erreur et produire des résultats de meilleure qualité et plus réalistes.
- Perte de Pixelwise L1 – Différence absolue entre les pixels de l'image HR de vérité terrain et celle générée.
- Perte de Pixelwise L2 – Différence quadratique moyenne entre les pixels de l'image HR de vérité terrain et celle générée.
- Perte de contenu – la perte de contenu est signalée comme la distance euclidienne entre les rendus de haut niveau de l'image de sortie et l'image cible. Les fonctions de haut niveau sont obtenues en passant par des CNN préalablement formés tels que VGG et ResNet.
- Perte de l'adversaire – Basé sur le GAN, où nous traitons le modèle SR comme un générateur et définissons un discriminateur supplémentaire pour juger si l'image d'entrée est générée ou non.
- PSNR – Le rapport signal sur bruit de pointe (PSNR) est une métrique objective couramment utilisée pour mesurer la qualité de reconstruction d'une transformation avec perte. PSNR est inversement proportionnel au logarithme de l'erreur quadratique moyenne (MSE) entre l'image réelle du terrain et l'image générée.
En MSE, Je suis un sans bruit métro×Nord image monochrome (vérité fondamentale) et K est l'image générée (approche bruyante). Un PSNR, MAXIMUMje représente la valeur de pixel maximale possible de l'image.
Disposition du réseau
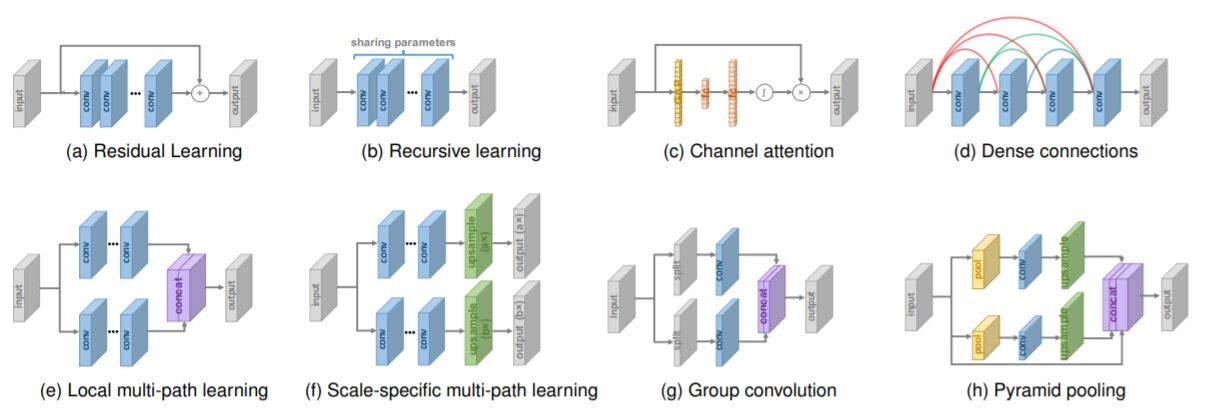
Diverses conceptions de réseau en architecture super-résolution
Assez de bases! Analysons quelques-uns des État de l'art méthodes de superrésolution –
Méthodes de superrésolution
Réseau d'adversaires génératifs de super-résolution (SRGAN) – Utiliser l'idée de GAN pour la tâche de super résolution, c'est-à-dire, le générateur essaiera de produire une image à partir du bruit qui sera jugé par le discriminateur. Ambos seguirán entrenando para que el generador pueda generar imágenes que puedan coincidir con los datos de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... reales.
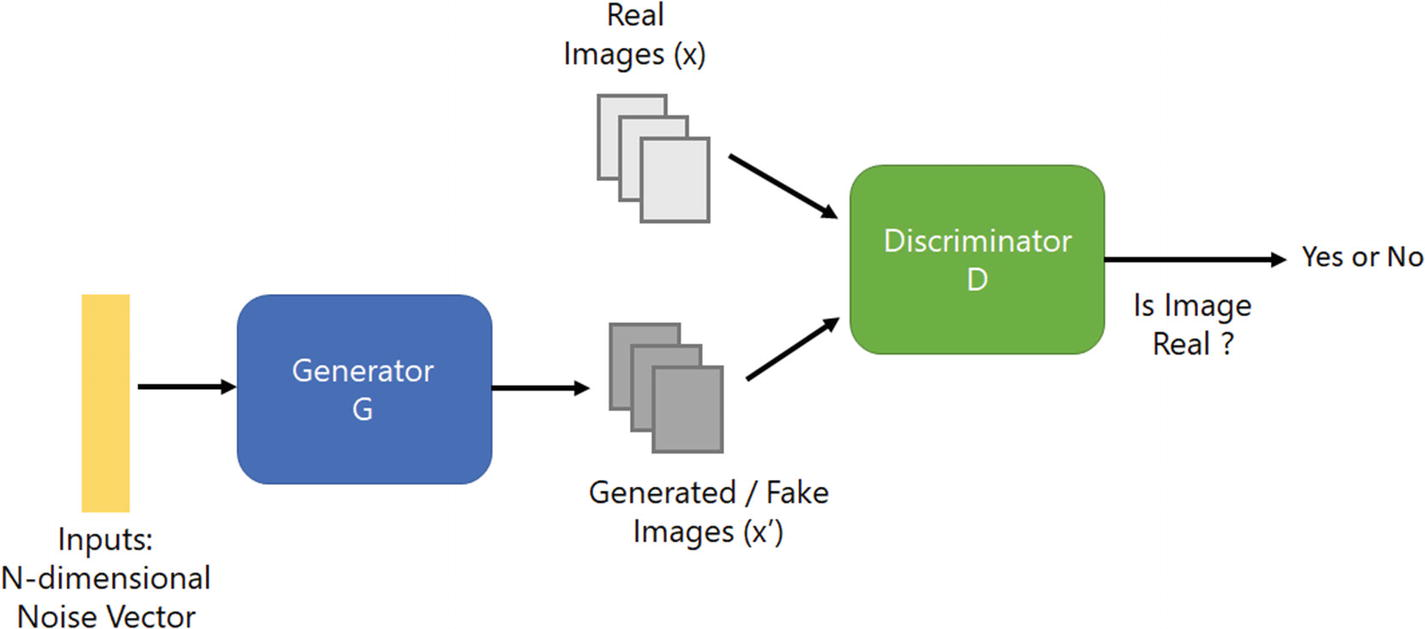
Architecture du réseau d'adversaire génératif
Il existe plusieurs formes de super résolution, Mais il y a un problème: Comment pouvons-nous récupérer des détails de texture plus fins à partir d'une image basse résolution afin que l'image ne soit pas déformée?
Les résultats ont un PSNR élevé; les médias ont des résultats de haute qualité, mais manquent souvent de détails haute fréquence.
Pour y parvenir dans SRGAN, nous utilisons le Fonction de perteLa fonction de perte est un outil fondamental de l’apprentissage automatique qui quantifie l’écart entre les prédictions du modèle et les valeurs réelles. Son but est de guider le processus de formation en minimisant cette différence, permettant ainsi au modèle d’apprendre plus efficacement. Il existe différents types de fonctions de perte, tels que l’erreur quadratique moyenne et l’entropie croisée, chacun adapté à différentes tâches et... perceptiva que comprende la pérdida de contenido y de adversario.
Vérifier la papiers originaux pour des informations détaillées.
Pas –
1. Nous traitons les RH (images haute résolution) pour un échantillonnage réduit des images LR. Nous avons maintenant des images HR et LR pour l'ensemble de données d'entraînement.
2. Nous passons les images LR à travers un générateur qui échantillonne et fournit des images SR.
3. Nous utilisons le discriminateur pour distinguer l'image HR et propager la perte de GAN pour entraîner le discriminateur et le générateur.
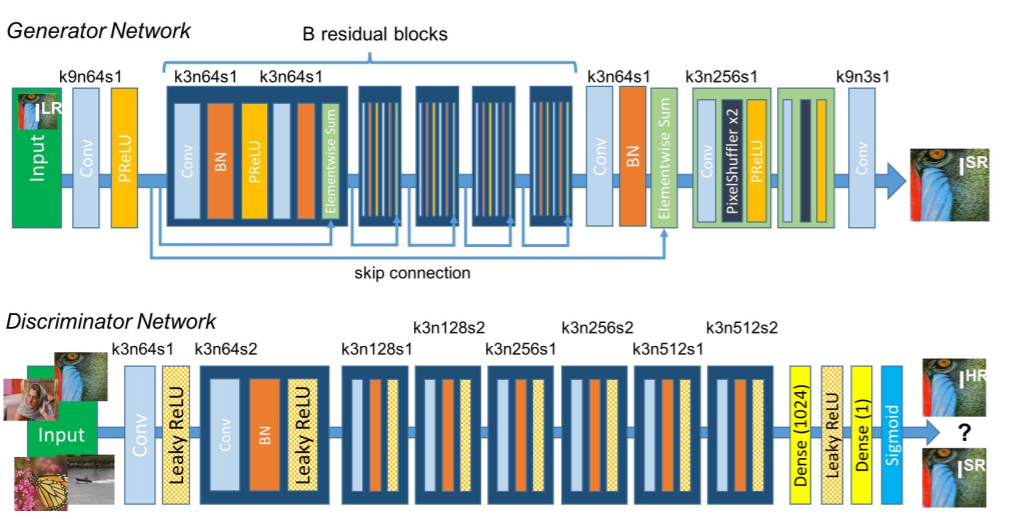
Architecture réseau SRGAN
Principales caractéristiques de la méthode:
- Type de base de sondage après échantillonnage
- Couche sous-pixel pour un échantillonnage plus élevé
- Contient des blocs résiduels
- Utiliser la perte de perception
EDSR, MDSR – Exposition des techniques d'apprentissage résiduel
performances de super-résolution améliorées grâce à des réseaux de neurones à convolution profonde (DCNN). Architecture à échelle unique Réseau de super-résolution profonde amélioré (EDSR) gère une échelle de super-résolution spécifique et Système de super résolution profonde à plusieurs échelles (MDSR) reconstruit plusieurs échelles d'images haute résolution en un seul modèle. Amélioration significative des performances du modèle.
est due à l'optimisation en supprimant les modules inutiles dans
réseaux résiduels conventionnels.
Vérifier la papiers originaux pour des informations détaillées.
Quelques-unes des principales caractéristiques des méthodes:
- Blocs résiduels – SRGAN a appliqué avec succès l'architecture ResNet au problème de super-résolution avec SRResNet, des performances encore améliorées grâce à l'utilisation d'un meilleur cadre ResNet. Dans l'architecture proposée –
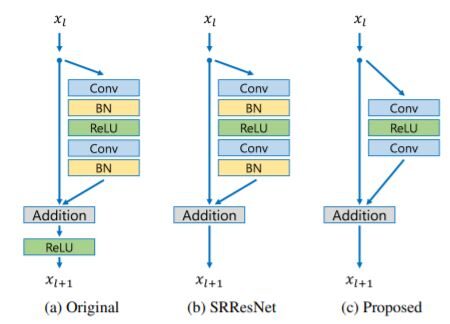
Comparaison des blocs résiduels
- Quitaron las capas de standardisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus.... por lotes de la red como en SRResNets. Étant donné que les couches de normalisation par lots normalisent les caractéristiques, éliminer la flexibilité de la portée du réseau en standardisant les caractéristiques, il vaut mieux les éliminer.
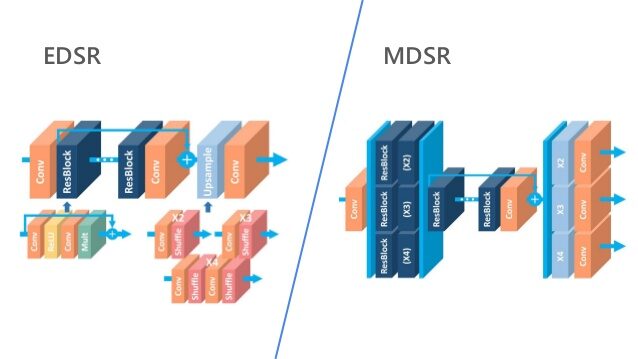
- Un MDSR, propusieron una arquitectura multiescala que comparte la mayoría de los paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... en diferentes escalas. Le modèle multi-échelle proposé utilise beaucoup moins de paramètres que plusieurs modèles à une seule échelle, mais affiche des performances comparables.
Alors maintenant, nous sommes arrivés à la fin du blog!! Pour plus d'informations sur la super résolution, vérifier ces enquêtes sur les emplois.
S'il vous plaît partager vos commentaires sur le blog dans la section des commentaires. Bon apprentissage 🙂
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





