
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
. Un problème de régression se produit lorsque le variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... output est une valeur réelle ou continue.
- Qu'est-ce qu'une régression?
- Types de régression.
- Quelle est la moyenne de la régression linéaire et l'importance de la régression linéaire?
- Importance de la fonction de coût et déclin de la penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... dans une régression linéaire.
- Impact des différentes valeurs sur le taux d'apprentissage.
- Implémenter le cas d'utilisation de la régression linéaire avec du code Python.
Qu'est-ce qu'une régression?
En régression, nous traçons un graphique entre les variables qui correspondent le mieux aux points de données donnés. Le modèle d'apprentissage automatique peut fournir des prédictions sur les données. En palabras libéral, « La régression affiche une ligne ou une courbe qui passe par tous les points de données sur un graphique de prédiction cible de manière à ce que la distance verticale entre les points de données et la ligne de régression soit minimale ». Il est principalement utilisé pour prédire, prédire, modéliser des séries chronologiques et déterminer la relation causale-effet entre les variables.
Types de modèles de régression
- Régression linéaire
- Régression polynomiale
- Régression logistique
Régression linéaire
La régression linéaire est une méthode de régression statistique simple et silencieuse utilisée pour l'analyse prédictive et montre la relation entre les variables continues. La régression linéaire montre la relation linéaire entre la variable indépendante (Axe X) et la variable dépendante (Axe y), par conséquent appelé régression linéaire. S'il y a une seule variable d'entrée (X), ladite régression linéaire est appelée Régression linéaire simple. Et s'il y a plus d'une variable d'entrée, ladite régression linéaire est appelée la régression linéaire multiple. Le modèle de régression linéaire donne une ligne droite en pente qui décrit la relation au sein des variables.
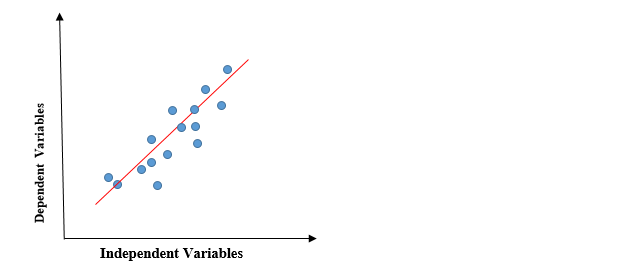
Le graphique précédent présente la relation linéaire entre la variable dépendante et les variables indépendantes. Lorsque la valeur de x (variable indépendante) augmente, la valeur de y (variable dépendante) augmente également. La ligne rouge est connue comme la ligne droite de meilleur ajustement.. Sur la base des points de données donnés, nous essayons de tracer une ligne qui modélise mieux les points.
Pour calculer la régression linéaire de la ligne de meilleur ajustement, une forme traditionnelle d'interception de pente est utilisée.
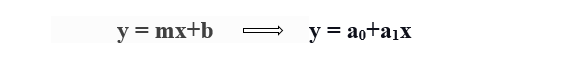
y = Variable dépendante.
x = variable indépendante.
a0 = intersection de la ligne.
a1 = Coefficient de régression linéaire.
Nécessité d'une régression linéaire
Comme mentionné précédemment, la régression linéaire estime la relation entre une variable dépendante et une variable indépendante. Comprenons cela avec un exemple simple:
Disons que nous voulons estimer le salaire d'un employé en fonction de l'année d'expérience. Vous avez les données récentes de l'entreprise, ce qui indique que la relation entre l'expérience et le salaire. Ici, l'année d'expérience est une variable indépendante et le salaire d'un employé est une variable dépendante., puisque le salaire d'un employé dépend de son expérience. Avec ces informations, nous pouvons prédire le salaire futur de l'employé sur la base des informations actuelles et passées.
Une droite de régression peut être une relation linéaire positive ou une relation linéaire négative.
Relation linéaire positive
Si la variable dépendante se développe sur l'axe Y et la variable indépendante progresse sur l'axe X, cette relation est appelée une relation linéaire positive.
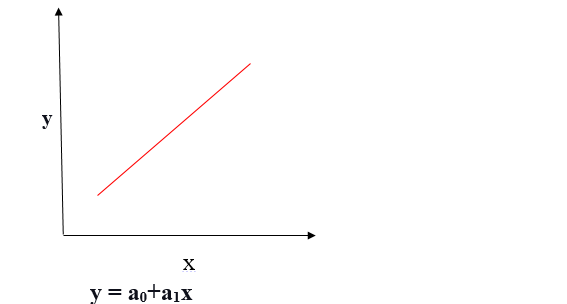
Relation linéaire négative
Si la variable dépendante diminue sur l'axe Y et la variable indépendante augmente sur l'axe X, cette relation est appelée une relation linéaire négative.
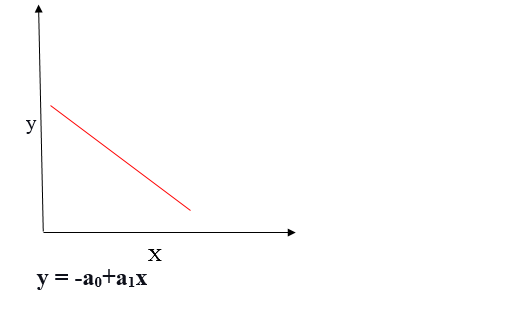
L'objectif de l'algorithme de régression linéaire est d'obtenir les meilleures valeurs pour a0 et a1 pour trouver la droite de meilleur ajustement. La ligne de meilleur ajustement devrait avoir le moins d'erreurs, ce qui signifie que l'erreur entre les valeurs prédites et les valeurs réelles doit être minimisée.
Fonction de coût
La fonction de coût permet de déterminer les meilleures valeurs possibles pour a0 et a1, qui fournit la ligne de meilleur ajustement pour les points de données.
La fonction de coût optimise les coefficients ou les poids de régression et mesure les performances d'un modèle de régression linéaire. La fonction de coût est utilisée pour trouver la précision de la fonction de mappage qui fait correspondre la variable d'entrée à la variable de sortie. Cette fonction de mappage est également appelée la fonction d'hypothèse.
En régression linéaire, Erreur quadratique moyenne (MSE) La fonction de coût est utilisée, qui est la moyenne de l'erreur quadratique qui s'est produite entre les valeurs prédites et les valeurs réelles.
Par simple équation linéaire y = mx + b nous pouvons calculer MSE comme:
Soit y = valeurs réelles, Ouije = valeurs prédites
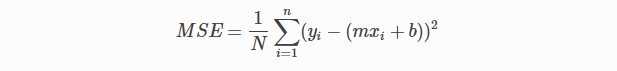
Utilisation de la fonction MSE, nous allons changer les valeurs de a0 et a1 pour que la valeur MSE soit réglée au minimum. ParamètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... du modèle xi, b (une0,une1) peut être manipulé pour minimiser la fonction de coût. Ces paramètres peuvent être déterminés à l'aide de la méthode de descente de gradient de sorte que la valeur de la fonction de coût soit minimale.
Descente graduelle
La descente de gradient est une méthode de mise à jour de a0 et a1 pour minimiser la fonction de coût (MSE). Un modèle de régression utilise la descente de gradient pour mettre à jour les coefficients de la ligne (a0, a1 => xi, b) en réduisant la fonction de coût à l'aide d'une sélection aléatoire de valeurs de coefficient, puis en mettant à jour itérativement les valeurs pour atteindre la fonction de coût minimum.
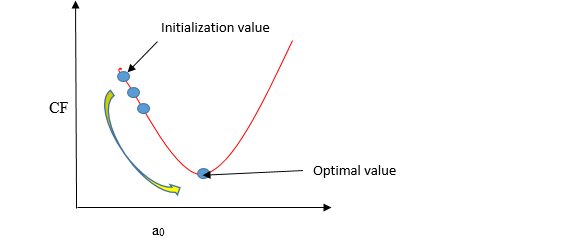
Imaginez un puits en U. Vous êtes au point le plus haut du puits et votre objectif est d'atteindre le fond du puits. Il y a un trésor, et vous ne pouvez faire qu'un nombre discret d'étapes pour aller au fond. Si vous décidez de faire un pas à la fois, tu finiras par atteindre le fond du puits, mais cela prendra plus de temps. Si vous choisissez de faire des pas plus longs à chaque fois, peut arriver plus tôt, mais il est possible qu'il passe au-dessus du fond du puits et non près du fond. Dans l'algorithme de descente de gradient, le nombre de pas que vous faites est le taux d'apprentissage, et cela décide à quelle vitesse l'algorithme converge vers les minima.
Pour mettre à jour un0 et un1, nous prenons des gradients de la fonction de coût. Pour trouver ces dégradés, on prend des dérivées partielles pour un0 et un1.
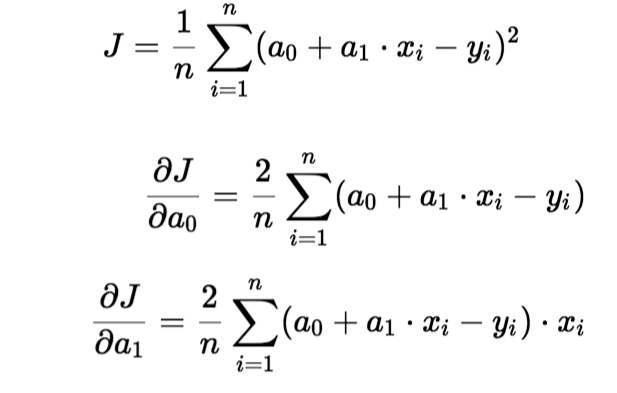
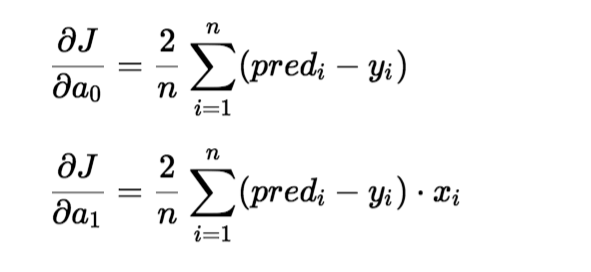
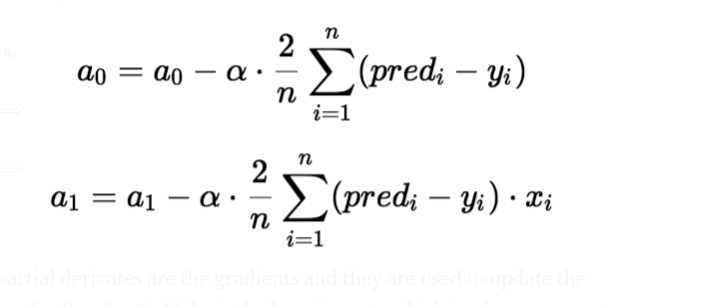
Les dérivées partielles sont les gradients et servent à mettre à jour les valeurs d'un0 et un1. Alpha est le taux d'apprentissage.
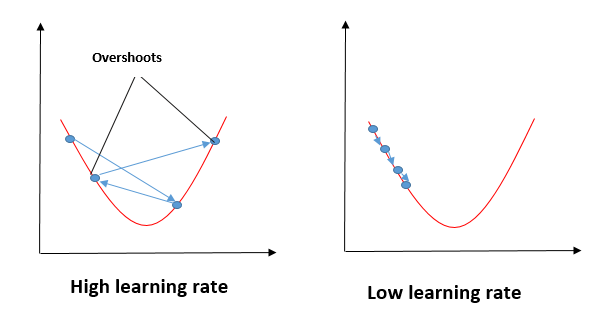
Impact des différentes valeurs sur le taux d'apprentissage
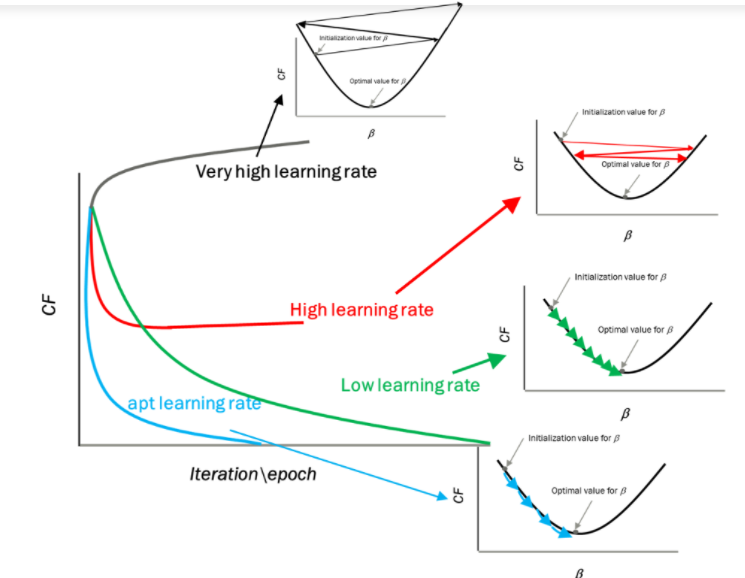
La source: mygrandleaning.com
La ligne bleue représente la valeur optimale du taux d'apprentissage et la valeur de la fonction de coût est minimisée en quelques itérations. La ligne verte représente si le taux d'apprentissage est inférieur à la valeur optimale, alors le nombre d'itérations nécessaires est élevé pour minimiser la fonction de coût. Si le taux d'apprentissage sélectionné est très élevé, la fonction de coût pourrait continuer à augmenter avec les itérations et se saturer à une valeur supérieure à la valeur minimale, celui représenté par une ligne rouge et noire.
Cas d'utilisation
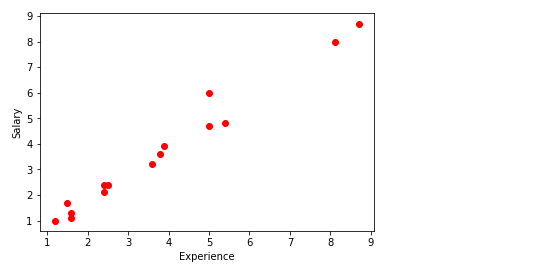
Dans ce, Je vais prendre des nombres aléatoires pour la variable dépendante (un salaire) et une variable indépendante (vivre) et je vais prédire l'impact d'une année d'expérience sur le salaire.
Étapes pour implémenter le modèle de régression linéaire
importer certaines bibliothèques requises
importer matplotlib.pyplot en tant que plt
importer des pandas au format pd
importer numpy en tant que np
Définir le jeu de données
x= np.tableau([2.4,5.0,1.5,3.8,8.7,3.6,1.2,8.1,2.5,5,1.6,1.6,2.4,3.9,5.4])
y = np.tableau([2.1,4.7,1.7,3.6,8.7,3.2,1.0,8.0,2.4,6,1.1,1.3,2.4,3.9,4.8])
n = np.taille(X)
Tracer les points de données
plt.scatter(vivre,un salaire, couleur="rouge")
plt.xlabel("Vivre")
plt.ylabel("Un salaire")
plt.show()
La fonction principale de calcul des valeurs de coefficient.
- Initialiser les paramètres.
- Prédire la valeur d'une variable dépendante étant donné une variable indépendante.
- Calculer l'erreur dans la prédiction pour tous les points de données.
- Calculer la dérivée partielle par rapport à a0 et a1.
- Calculez le coût de chaque nombre et additionnez-les.
- Mettre à jour les valeurs de a0 et a1.
#initialiser les paramètres
a0 = 0                  #intercepter
a1 = 0                  #Pente
lr = 0.0001             #Taux d'apprentissage
itérations = 1000       # Nombre d'itérations
erreur = []              # Tableau d'erreurs pour calculer le coût de chaque itération.
pour itr dans la gamme(itérations):
    error_cost = 0
    coût_a0 = 0
    coût_a1 = 0
    pour moi à portée(longueur(vivre)):
        y_pred = a0+a1*expérience[je]   # prédire la valeur pour un x donné
        error_cost = error_cost +(un salaire[je]-y_pred)**2
        pour j dans la plage(longueur(vivre)):
            partial_wrt_a0 = -2 *(un salaire[j] - (a0 + a1 * expérience[j]))                #dérivée partielle w.r.t a0
            partial_wrt_a1 = (-2*vivre[j])*(un salaire[j]-(a0 + a1 * expérience[j]))   #dérivée partielle w.r.t a1
            coût_a0 = coût_a0 + partial_wrt_a0 #calculer le coût pour chaque numéro et ajouter
            coût_a1 = coût_a1 + partial_wrt_a1 #calculer le coût pour chaque numéro et ajouter
        a0 = a0 - g / D * cost_a0 #mettre à jour a0
        a1 = a1 - g / D * cost_a1 #mettre à jour a1
        imprimer(itr,a0, a1)          #Vérifier l'itération et mettre à jour a0 et a1
    error.append(error_cost)      #Ajouter les données dans le tableau
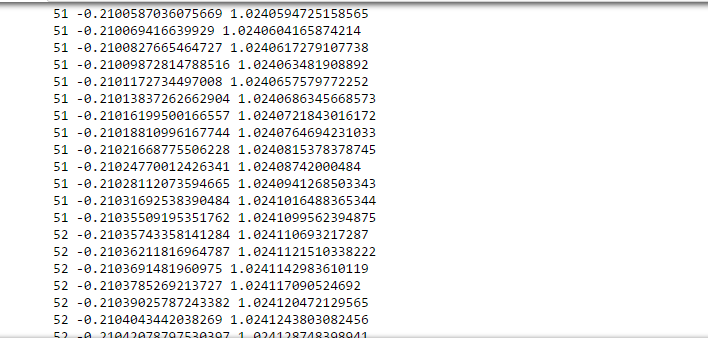
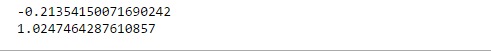
Dans une itération approximative de 50-60, nous avons obtenu la valeur de a0 et a1.
imprimer(a0)
imprimer(a1)
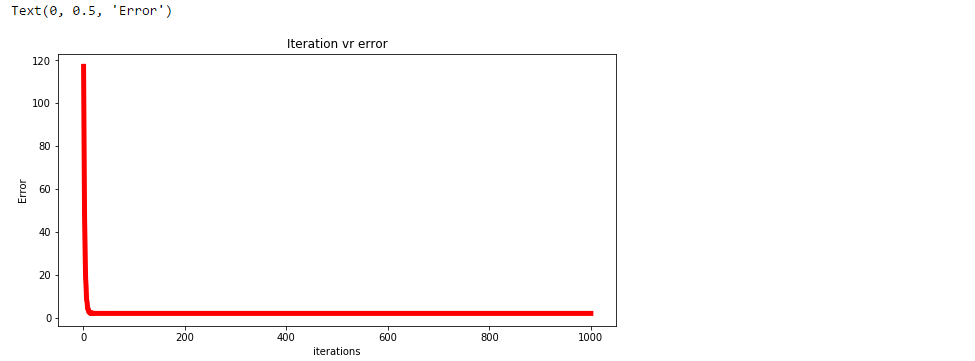
Tracer l'erreur pour chaque itération.
plt.figure(taille de la figue=(10,5))
plt.plot(np.arange(1,longueur(Erreur)+1),Erreur,couleur="rouge",largeur de ligne = 5)
plt.titre("Erreur d'itération vr")
plt.xlabel("itérations")
plt.ylabel("Erreur")
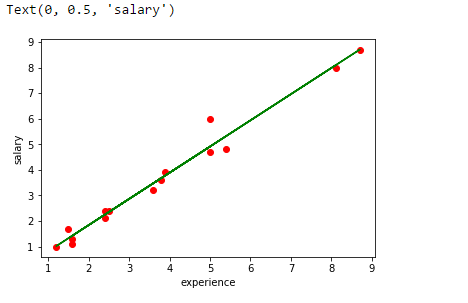
Prédire les valeurs.
pred = a0+a1*expérience
imprimer(pred)

Tracer la droite de régression.
plt.scatter(vivre,un salaire,couleur="rouge")
plt.plot(vivre,pred, couleur="vert")
plt.xlabel("vivre")
plt.ylabel("un salaire")
Analyser les performances du modèle en calculant l'erreur quadratique moyenne.
erreur1 = salaire - pred
se = np.somme(erreur1 ** 2)
mse = se/n
imprimer("l'erreur quadratique moyenne est", mse)

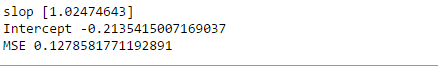
Utilisez la bibliothèque scikit pour confirmer les étapes ci-dessus.
à partir de sklearn.linear_model importer LinearRegression
à partir de sklearn.metrics importer Mean_squared_error
expérience = expérience.remodeler(-1,1)
modèle = Régression Linéaire()
model.fit(vivre,un salaire)
salaire_pred = model.predict(vivre)
Mse = Mean_squared_error(un salaire, salaire_pred)
imprimer('slop', model.coef_)
imprimer("Intercepter", model.intercept_)
imprimer("MSE", Mse)
résumé
En régression, nous traçons un graphique entre les variables qui correspondent le mieux aux points de données donnés. La régression linéaire montre la relation linéaire entre la variable indépendante (Axe X) et la variable dépendante (Axe y).Pour calculer la régression linéaire de la ligne de meilleur ajustement, une forme traditionnelle d'interception de pente est utilisée. Une droite de régression peut être une relation linéaire positive ou une relation linéaire négative.
Le but de l'algorithme de régression linéaire est d'obtenir les meilleures valeurs pour a0 et a1 pour trouver la ligne de meilleur ajustement et la ligne de meilleur ajustement doit avoir la plus petite erreur. En régression linéaire, Erreur quadratique moyenne (MSE) la fonction de coût est utilisée, Quoi aide à déterminer les meilleures valeurs possibles pour a0 et a1, qui fournit la ligne de meilleur ajustement pour les points de données. Utilisation de la fonction MSE, nous allons changer les valeurs de a0 et a1 pour que la valeur MSE soit réglée au minimum. La descente de gradient est une méthode de mise à jour de a0 et a1 pour minimiser la fonction de coût (MSE)
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





