
Les données sont générées en grandes quantités partout. Twitter génère plus de 12 TB de données chaque jour, Facebook génère plus de 25 TB de données chaque jour et Google génère beaucoup plus que ces quantités chaque jour. Étant donné que ces données sont produites tous les jours, nous devons créer des outils pour gérer des données avec un haut
1. Le volume : Actuellement, de grands volumes de données sont stockés pour n'importe quelle industrie. Les modèles conventionnels avec des données aussi volumineuses ne sont pas faisables.
2. La vitesse : Les données arrivent à grande vitesse et nécessitent des algorithmes d'apprentissage plus rapides.
3. Variété : Les différentes sources de données possèdent différentes structures. Toutes ces données contribuent à la prévision. Un bon algorithme peut absorber une telle variété de données.
Un algoritmo predictivo simple como Random Forest en aproximadamente 50 mil puntos de datos y 100 dimensiones tarda 10 minutos en ejecutarse en una máquina de 12 Go de RAM. Los problemas con cientos de millones de observaciones son simplemente imposibles de solucionar con este tipo de máquinas. Pour cela, nos quedan solo dos opciones: utilizar una máquina más fuerte o cambiar la forma en que funciona un algoritmo predictivo. La primera opción no siempre es viable. Dans ce billet, aprenderemos sobre los algoritmos de aprendizaje en línea que están destinados a manejar datos con un volumen y velocidad tan altos con máquinas de rendimiento limitado.
¿En qué se diferencia el aprendizaje en línea de los algoritmos de aprendizaje por lotes?
Si es un principiante en la industria de la analytiqueL’analytique fait référence au processus de collecte, Mesurer et analyser les données pour obtenir des informations précieuses qui facilitent la prise de décision. Dans divers domaines, Comme les affaires, Santé et sport, L’analytique peut identifier des modèles et des tendances, Optimiser les processus et améliorer les résultats. L’utilisation d’outils et de techniques statistiques de pointe est essentielle pour transformer les données en connaissances applicables et stratégiques...., Tout ce dont vous avez probablement entendu parler sera inclus dans la catégorie de l'apprentissage par lots. Essayons de visualiser en quoi le fonctionnement des deux diffère.
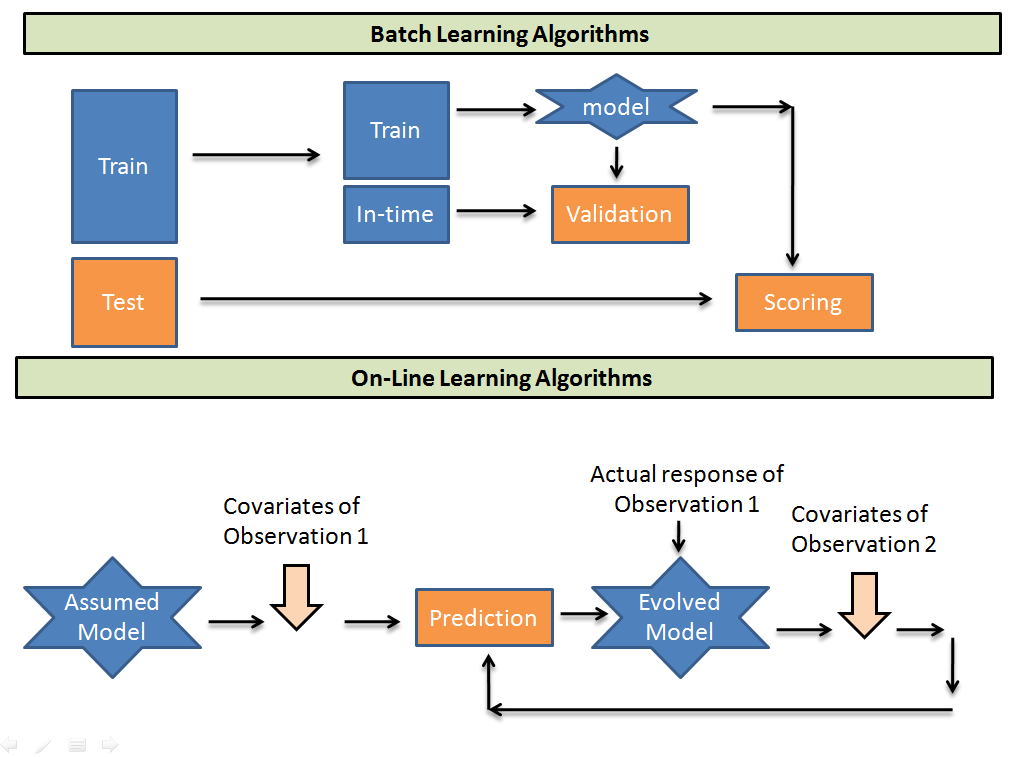
Les algorithmes d'apprentissage par lots prennent des lots de données pour entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... entraîner un modèle. Ensuite, ils prédisent l'échantillon de test en utilisant l'association trouvée. Alors que, Les algorithmes d'apprentissage en ligne prennent un modèle avec une conjecture initiale, puis prennent les observations une par une de la population d'entraînement et recalibrent les poids pour chaque paramètre d'entrée. Voici quelques compromis à considérer lorsque l'on utilise ces deux algorithmes.
- Beaucoup plus rapide sur le plan computationnel et plus efficace en termes d'espace. Dans le modèle en ligne, se le posibilita realizar exactamente una pasada de sus datos, por lo que estos algoritmos generalmente son mucho más rápidos que sus equivalentes de aprendizaje por lotes, puesto que la mayoría de los algoritmos de aprendizaje por lotes son de múltiples pasadas. En même temps, dado que no puede reconsiderar sus ejemplos anteriores, regularmente no los almacena para ingresar más adelante en el procedimiento de aprendizaje, lo que significa que tiende a usar una huella de memoria más pequeña.
- Suele ser más fácil de poner en práctica. Dado que el modelo en línea hace que uno pase por encima de los datos, terminamos procesando un ejemplo al mismo tiempo, secuencialmente, a medida que ingresan desde el flujo. Esto de forma general simplifica el algoritmo, s'il le fait à partir de zéro.
- Plus difficile à maintenir en production. La mise en œuvre d'algorithmes en ligne en production nécessite généralement que des points de données soient constamment transmis à votre algorithme. Si vos données changent et que vos sélecteurs de fonctionnalités ne produisent plus de résultats utiles, ou s'il y a une latence réseau importante entre les serveurs de vos sélecteurs de fonctionnalités, ou si l'un de ces serveurs cesse de fonctionner, ou en fait, toute autre quantité de problèmes, votre apprenant s'accumule et votre sortie devient des données inutiles. S'assurer que tout cela fonctionne correctement peut être un défi.
- Plus difficile à examiner en ligne. Dans l'apprentissage en ligne, nous ne pouvons pas fournir un ensemble de « essais » para la evaluación debido a que no hacemos suposiciones de distribución; si elegimos un conjunto para examinar, estaríamos asumiendo que el conjunto de pruebas es representativo de los datos que estamos operando, y eso es un supuesto distributivo. Étant donné que, en el caso más general, no hay forma de obtener un conjunto representativo que caracterice sus datos, su única opción (encore, en el caso más general) es simplemente observar qué tan bien ha estado funcionando el algoritmo recientemente.
- Comme d'habitude, es más difícil hacerlo « bien ». Como vimos en el último punto, la evaluación en línea del alumno es difícil. Por razones similares, puede resultar muy difícil obtener que el algoritmo se comporte « correctement » automáticamente. Puede ser difícil diagnosticar si su algoritmo o su infraestructura se están comportando mal.
Dans les cas où nous travaillons avec de grandes quantités de données, nous n'avons d'autre choix que d'utiliser des algorithmes d'apprentissage en ligne. La seule autre alternative est de réaliser un apprentissage par lots sur un échantillon plus petit.
Exemple pour comprendre le concept
Nous voulons prédire la probabilité qu'il pleuve aujourd'hui. Nous disposons d'un panneauUn panel est un groupe d’experts qui se réunit pour discuter et analyser un sujet spécifique. Ces forums sont courants lors des conférences, Séminaires et débats publics, où les participants partagent leurs connaissances et leurs points de vue. Les panneaux peuvent aborder une variété de domaines, De la science à la politique, et son objectif est d’encourager l’échange d’idées et la réflexion critique entre les participants.... de 11 personnes qui prédisent la classe: Pluie et pas pluie dans différents paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet..... Nous devons concevoir un algorithme pour prédire la probabilité. Tout d'abord, initialisons quelques notations.
sont des prédicteurs individuels
w (je) c'est le poids donné au i-ème prédicteur
Initialiser w (je) pour i dans [1,11] sont tous 1
Nous prédirons qu'il pleuvra aujourd'hui si,
Somme (w (je) pour toutes les prédictions de pluie)> Somme (w (je) pour toutes les prédictions sans pluie)
Une fois que nous avons la solution réelle de la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... objectif, nous envoyons maintenant un retour d'information sur les poids de tous les paramètres. Dans cette circonstance, nous adopterons un mécanisme de rétroaction très simple. Pour chaque prédiction correcte, nous maintiendrons le même poids du prédicteur. Alors que pour chaque prédiction incorrecte, nous divisons le poids du prédicteur par 1,2 (taux d'apprentissage). Avec le temps, nous espérons que le modèle convergera avec un ensemble correct de paramètres. Nous avons créé une simulation avec 1000 des prédictions faites par chacun des 11 prédicteurs. C'est ainsi que notre courbe de précision est sortie,
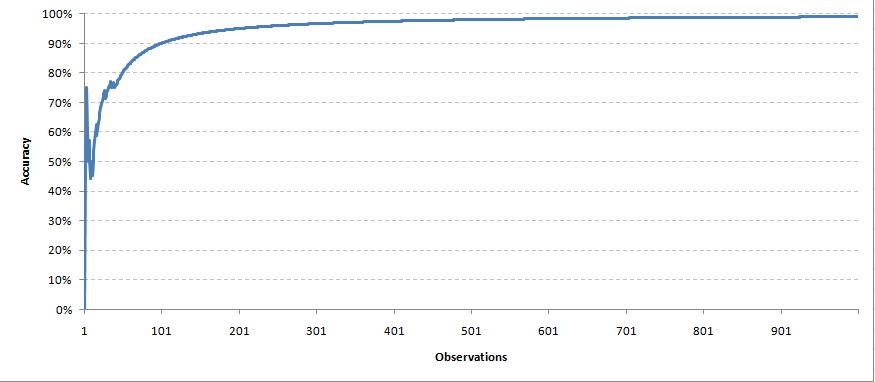
Chaque observation a été prise en même temps pour réajuster les poids. De la même manière, nous ferons des prédictions pour les points de données futurs.
Remarques finales
Les algorithmes d'apprentissage en ligne sont largement utilisés par l'industrie du commerce électronique et des réseaux sociaux. Ce n'est pas seulement rapide, sino que además tiene la capacidad de capturar cualquier nueva tendencia visible con el tiempo. En este momento se encuentran disponibles una gama de sistemas de retroalimentación y algoritmos convergentes que deben seleccionarse según los requerimientos. En algunos de los siguientes posts, además tomaremos algunos ejemplos prácticos de aplicaciones de algoritmos de aprendizaje en línea.
Le message a-t-il été utile? ¿Ha utilizado antes algoritmos de aprendizaje en línea? Comparta con nosotros esas experiencias. Faites-nous part de vos réflexions sur ce post dans la case ci-dessous..





