
introduction
Il devient très difficile de se tenir à jour avec les récents progrès qui se produisent dans le l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé.... Il ne se passe pas un jour sans une nouvelle innovation ou une nouvelle application d'apprentissage en profondeur.. Cependant, La plupart de ces avancées sont cachées dans un grand nombre d'articles de recherche publiés dans des médias tels que ArXiv / Springer.
Pour nous tenir au courant, nous avons créé un petit groupe de lecture pour partager nos apprentissages en interne dans DataPeaker. L'un de ces apprentissages que j'aimerais partager avec la communauté est une étude des architectures avancées qui ont été développées par la communauté des chercheurs.
Cet article contient certains des progrès récents dans l'apprentissage en profondeur ainsi que des codes pour la mise en œuvre dans la bibliothèque keras. J'ai également fourni des liens vers les articles originaux, au cas où vous souhaiteriez les lire ou vous y référer.
Pour garder l'article concis, Je n'ai considéré que les architectures qui ont réussi dans le domaine de la Computer Vision.
Si tu es intéressé, continue de lire!
PD: Cet article suppose une connaissance des réseaux de neurones et une familiarité avec les kéras. Si vous avez besoin de vous rattraper sur ces sujets, Je vous recommande fortement de lire d'abord les articles suivants:
Table des matières
- Qu'entendons-nous par architecture avancée?
- Types de tâches de vision industrielle
- Liste des architectures de deep learning
Qu'entendons-nous par architecture avancée?
Les algorithmes d'apprentissage en profondeur consistent en un ensemble de modèles si diversifié par rapport à un seul algorithme d'apprentissage automatique traditionnel. Cela est dû à la flexibilité offerte par le neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. en créant un modèle complet de bout en bout.
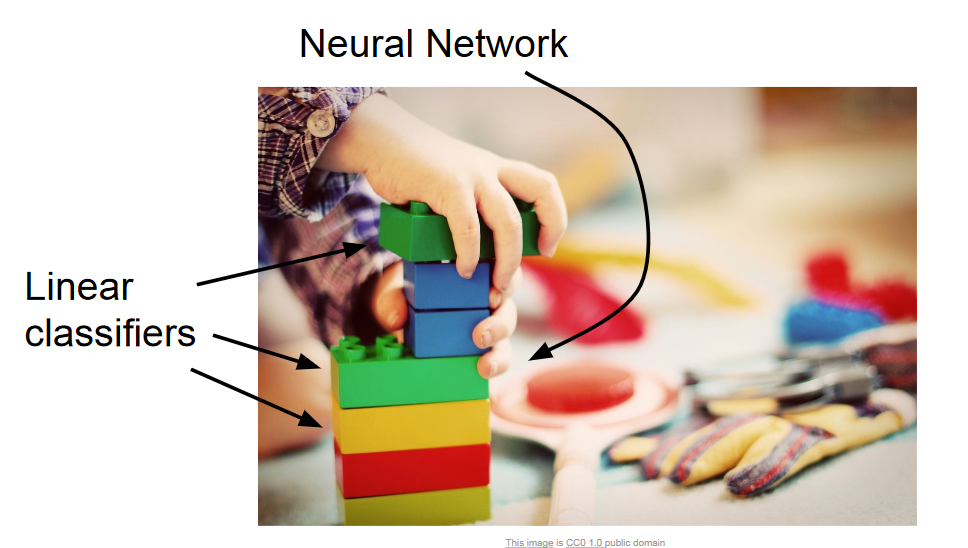
Le réseau de neurones peut parfois être comparé à des blocs lego, où vous pouvez construire presque n'importe quelle structure simple ou complexe que votre imagination vous aide à construire.
Nous pouvons définir une architecture avancée comme une architecture qui a fait ses preuves en tant que modèle à succès.. Cela se voit principalement dans des défis comme ImageNet, où votre tâche est de résoudre un problème, disons la reconnaissance d'images, en utilisant les données fournies. Ceux qui ne savent pas ce qu'est ImageNet, est l'ensemble de données fourni dans le défi ILSVR (Reconnaissance visuelle à grande échelle ImageNet).
Également comme décrit dans les architectures mentionnées ci-dessous, chacun d'eux a une nuance qui les différencie des modèles habituels; leur donner un avantage lorsqu'ils sont utilisés pour résoudre un problème. Ces architectures entrent également dans la catégorie des modèles « Profond », ils sont donc susceptibles de mieux performer que leurs homologues peu profonds.
Types de tâches de vision industrielle
Cet article est principalement axé sur la vision par ordinateur, il est donc naturel de décrire l'horizon des tâches de vision par ordinateur. Vision par ordinateur; comme le nom le suggère, crée simplement des modèles artificiels qui peuvent reproduire les tâches visuelles effectuées par un être humain. Cela signifie essentiellement que ce que nous pouvons voir et ce que nous percevons est un processus qui peut être compris et mis en œuvre dans un système artificiel..
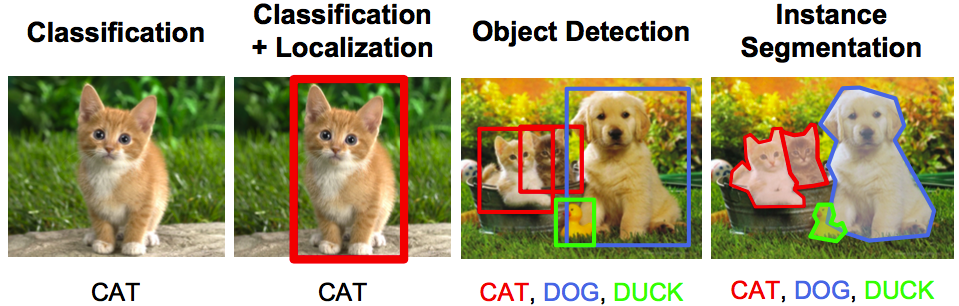
Les principaux types de tâches dans lesquelles la vision par ordinateur peut être classée sont les suivants:
- Reconnaissance / classification d'objets – En reconnaissance d'objets, on vous donne une image brute et votre tâche est d'identifier à quelle classe l'image appartient.
- Classification + Lieu – S'il n'y a qu'un seul objet dans l'image et que votre tâche consiste à trouver l'emplacement de cet objet, un terme plus spécifique pour ce problème est problème de localisation.
- Détection d'objets – Sur la détection d'objets, votre tâche est d'identifier où se trouvent les objets dans l'image. Ces objets peuvent être de la même classe ou d'une classe complètement différente.
- SegmentationLa segmentation est une technique de marketing clé qui consiste à diviser un large marché en groupes plus petits et plus homogènes. Cette pratique permet aux entreprises d’adapter leurs stratégies et leurs messages aux spécificités de chaque segment, améliorant ainsi l’efficacité de vos campagnes. Le ciblage peut se faire sur des critères démographiques, Psychographique, géographique ou comportementale, Faciliter une communication plus pertinente et personnalisée avec le public cible.... d'image – La segmentation d'images est une tâche un peu sophistiquée, où le but est de mapper chaque pixel à sa classe légitime.
Liste des architectures de deep learning
Maintenant que nous avons compris ce qu'est l'architecture avancée et que nous avons exploré les tâches de la vision par ordinateur, listons les architectures les plus importantes et leurs descriptions:
1. AlexNet
AlexNet est la première architecture profonde qui a été introduite par l'un des pionniers de l'apprentissage en profondeur: Geoffrey Hinton et ses collègues. C'est une architecture de réseau simple mais puissante, qui a contribué à ouvrir la voie à une recherche révolutionnaire sur l'apprentissage en profondeur telle qu'elle est actuellement. Voici une représentation de l'architecture proposée par les auteurs.
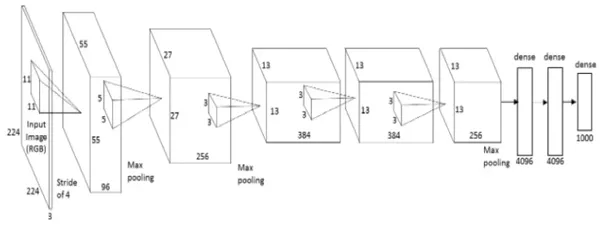
Quand ça tombe en panne, AlexNet ressemble à une architecture simple avec des couches convolutives et regroupées les unes sur les autres, suivi de couches entièrement connectées sur le dessus. C'est une architecture très simple, qui a été conceptualisé dans la décennie de 1980. Ce qui distingue ce modèle, c'est l'échelle à laquelle il accomplit la tâche et l'utilisation du GPU pour le entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines..... Dans la décennie de 1980, le CPU a été utilisé pour former un réseau de neurones. Alors qu'AlexNet accélère la formation 10 fois seulement avec l'utilisation du GPU.
Bien qu'un peu dépassé pour le moment, AlexNet est toujours utilisé comme point de départ pour appliquer des réseaux de neurones profonds à toutes les tâches, vision par ordinateur ou reconnaissance vocale.
2. Réseau VGG
Le réseau VGG a été présenté par des chercheurs du Visual Graphics Group à Oxford (d'où le nom VGG). Ce réseau se caractérise surtout par sa forme pyramidale, où les couches inférieures les plus proches de l'image sont larges, tandis que les couches supérieures sont profondes.
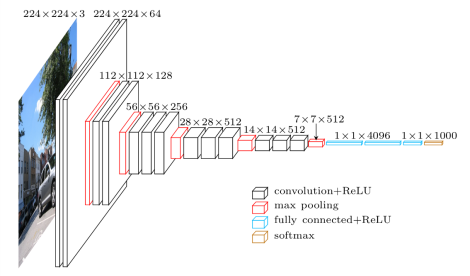
Comme le montre l'image, VGG contient des couches convolutives postérieures suivies de couches groupées. Les couches de regroupement sont responsables de rendre les couches plus étroites. Dans ton article, proposé plusieurs types de réseaux de ce type, avec des changements dans la profondeur de l'architecture.
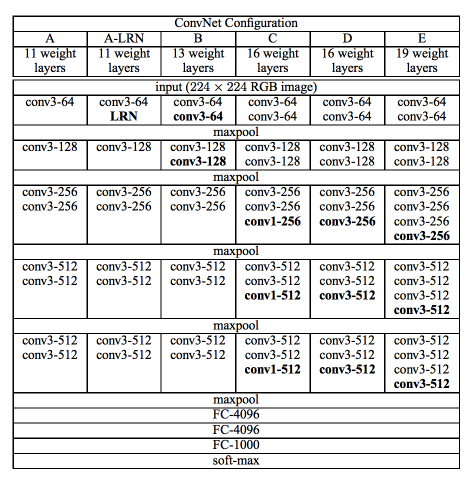
Les avantages de VGG sont:
- C'est une très bonne architecture pour le benchmarking sur une tâche particulière.
- En outre, les réseaux pré-VGG sont disponibles gratuitement sur Internet, il est donc couramment utilisé pour diverses applications.
D'un autre côté, son principal inconvénient est qu'il est très lent à s'entraîner si vous vous entraînez à partir de zéro. Inclus avec un GPU décent, il faudrait plus d'une semaine pour que ça marche.
3. GoogleNet
GoogleNet (o Réseau de création) est une classe d'architecture conçue par les chercheurs de Google. GoogleNet a été le gagnant d'ImageNet 2014, où il s'est avéré être un modèle puissant.
Dans cette architecture, en plus d'approfondir (contient 22 couches par rapport à VGG qui avait 19 couvre), les chercheurs ont également élaboré une nouvelle approche appelée module Inception.
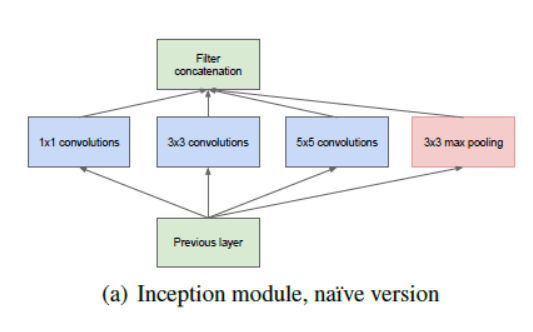
Comme vu ci-dessus, c'est un changement radical par rapport aux architectures séquentielles que nous avons vues plus tôt. En une seule couche, divers types de « extracteurs de caractéristiques ». Cela aide indirectement le réseau à mieux fonctionner, puisque le réseau en formation a de nombreuses options à choisir lors de la résolution de la tâche. Vous pouvez choisir de convoluer l'entrée ou de la grouper directement.
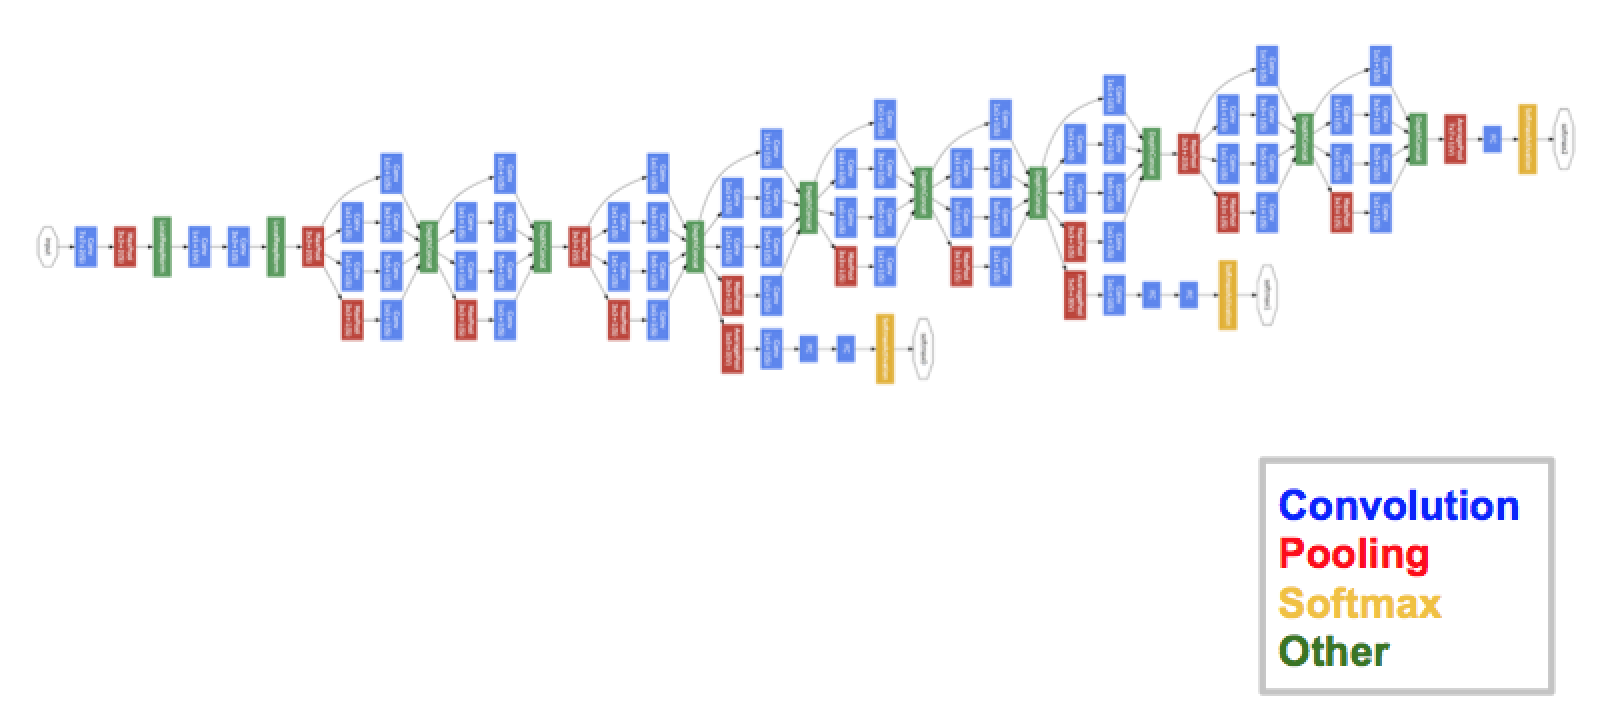
L'architecture finale contient plusieurs de ces modules initiaux empilés les uns sur les autres.. Même la formation est légèrement différente sur GoogleNet, car la majorité des couches supérieures ont leur propre Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées..... Cette nuance permet au modèle de converger plus rapidement, puisqu'il existe une formation conjointe et une formation parallèle pour les couches elles-mêmes.
Les avantages de GoogleNet sont:
- GoogleNet s'entraîne plus vite que VGG.
- La taille d'un réseau Google préalablement formé est comparativement plus petite que celle de VGG. Un modèle VGG peut avoir> 500 Mo, alors que GoogleNet a une taille de seulement 96 Mo
GoogleNet n'a pas d'inconvénient immédiat en soi, mais des modifications supplémentaires de l'architecture sont proposées, qui améliorent le fonctionnement du modèle. L'un de ces changements s'appelle Red Xception, dans lequel la limite de divergence du module de départ est augmentée (4 sur GoogleNet comme nous l'avons vu dans l'image ci-dessus). Maintenant, théoriquement, il peut être infini (C'est pourquoi on l'appelle départ extrême!)
4. ResNet
ResNet est l'une des architectures monstres qui définit vraiment la profondeur d'une architecture d'apprentissage en profondeur.. Réseaux résiduels (ResNet en abrégé) se compose de plusieurs modules résiduels ultérieurs, qui sont le bloc de construction de base de l'architecture ResNet. Une représentation du module résiduel est la suivante
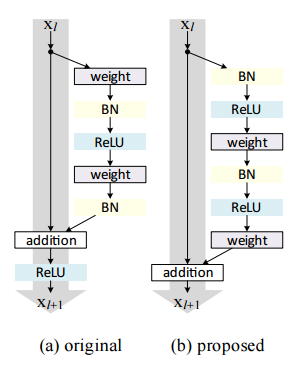
En mots simples, un module résiduel a deux options, vous pouvez effectuer un ensemble de fonctions sur l'entrée ou vous pouvez ignorer complètement cette étape.
Maintenant similaire à GoogleNet, ces modules résiduels sont empilés les uns sur les autres pour former un réseau complet de bout en bout.
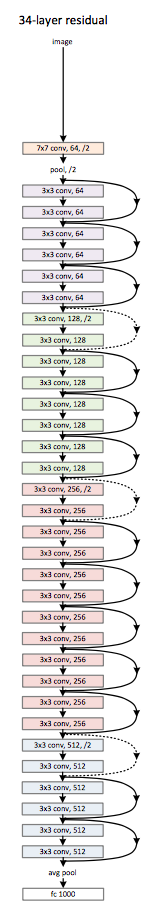
Certaines techniques plus récentes introduites par ResNet incluent:
- Utilisation de SGD standard au lieu d'une technique d'apprentissage adaptative sophistiquée. Ceci est fait en conjonction avec une fonction d'initialisation raisonnable qui maintient la formation intacte..
- Saisie des modifications de prétraitement, où l'entrée est d'abord patchée puis transmise au réseau.
Le principal avantage de ResNet est que des centaines, même des milliers de ces couches résiduelles peuvent être utilisées pour créer un réseau puis former. C'est un peu différent des réseaux séquentiels habituels, là où vous voyez qu'il y a des améliorations de performances réduites à mesure que le nombre de couches augmente.
5. ResNeXt
ResNeXt serait la technique actuelle la plus avancée pour la reconnaissance d'objets. Il est basé sur les concepts de startup et resnet pour générer une architecture nouvelle et améliorée. L'image suivante est un résumé de ce à quoi ressemble un module résiduel du module ResNeXt.
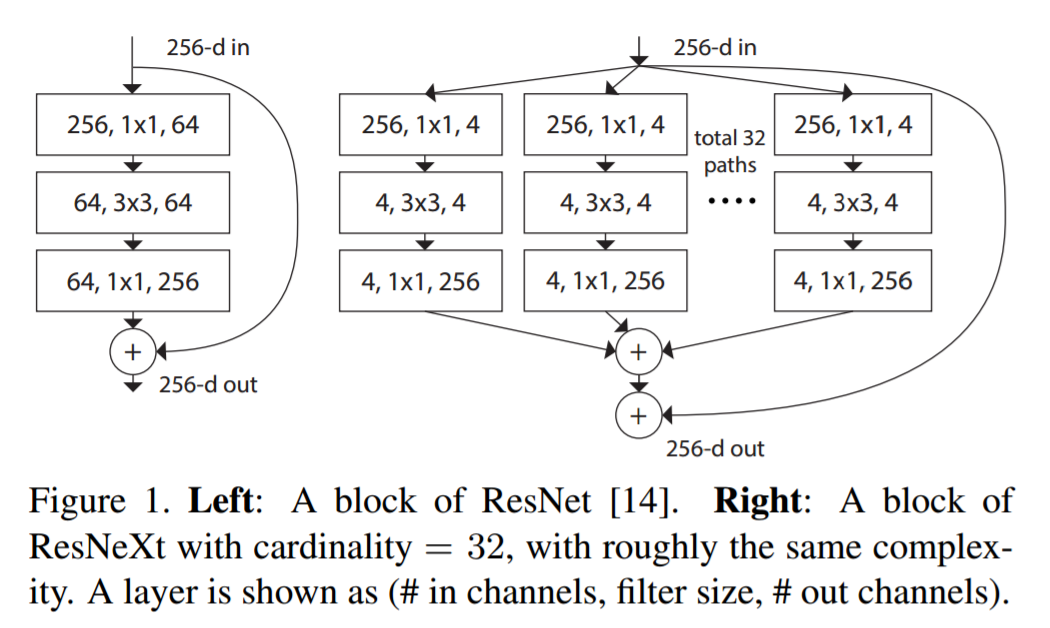
6. RCNN (CNN régional)
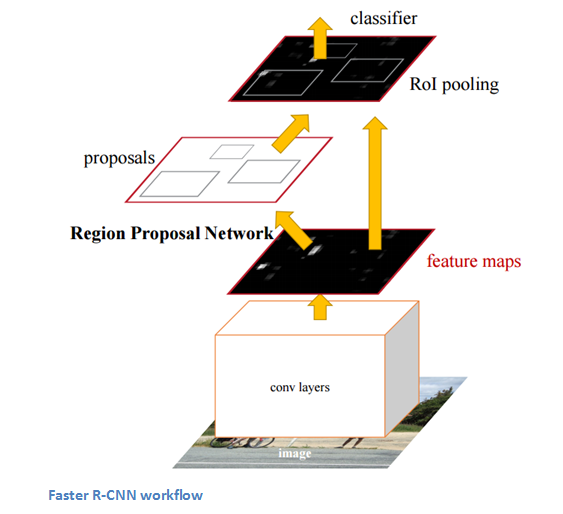
L'architecture CNN basée sur la région est considérée comme la plus influente de toutes les architectures d'apprentissage en profondeur qui ont été appliquées au problème de détection d'objets.. Pour résoudre le problème de détection, ce que RCNN fait, c'est d'essayer de tracer un cadre de délimitation sur tous les objets présents dans l'image, puis de reconnaître quel objet se trouve dans l'image. Cela fonctionne de la manière suivante:
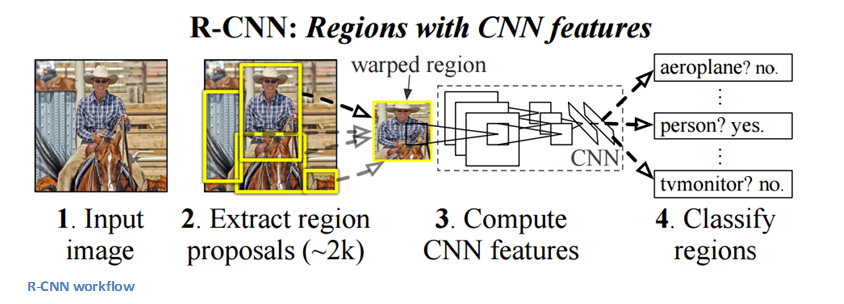
La structure du RCNN est la suivante:
7. YOLO (tu ne regardes qu'une fois)
YOLO est le système de pointe actuel basé sur l'apprentissage profond en temps réel pour résoudre les problèmes de détection d'images. Comme on le voit dans l'image ci-dessous, il divise d'abord l'image en cadres de délimitation définis, puis exécute un algorithme de reconnaissance en parallèle pour tous ces cadres afin d'identifier à quelle classe d'objets ils appartiennent. Après avoir identifié ces classes, continue à fusionner intelligemment ces boîtes pour former une boîte englobante optimale autour des objets.
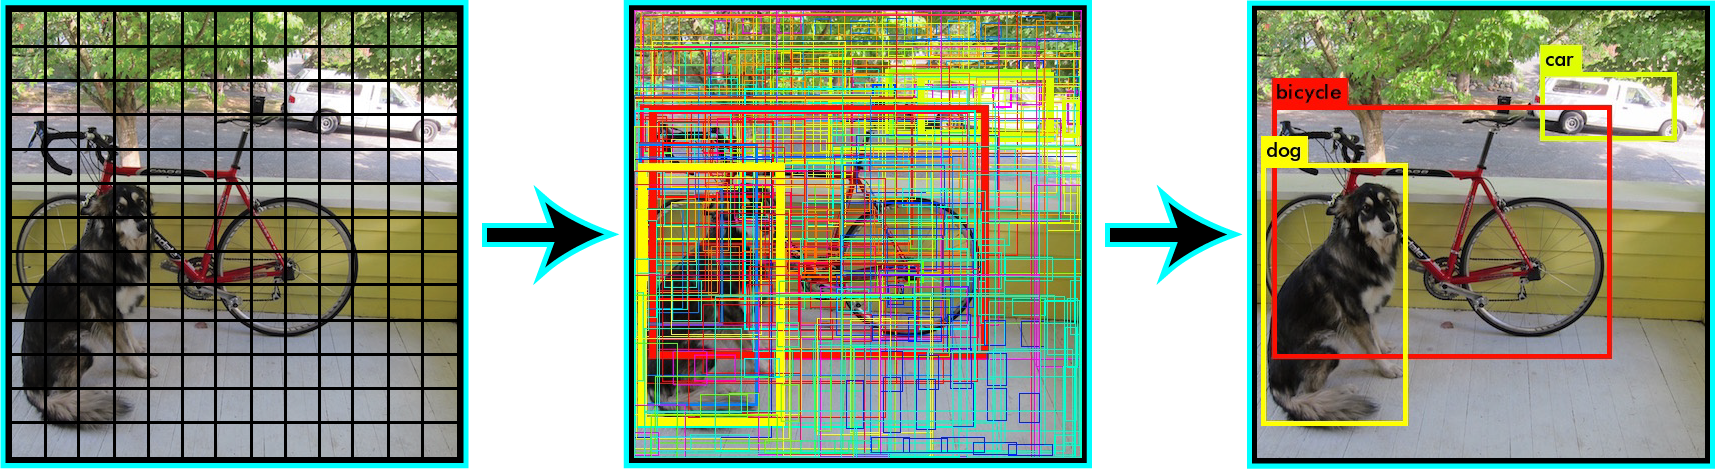
Tout cela se fait en parallèle, donc il peut fonctionner en temps réel; traitement 40 images en une seconde.
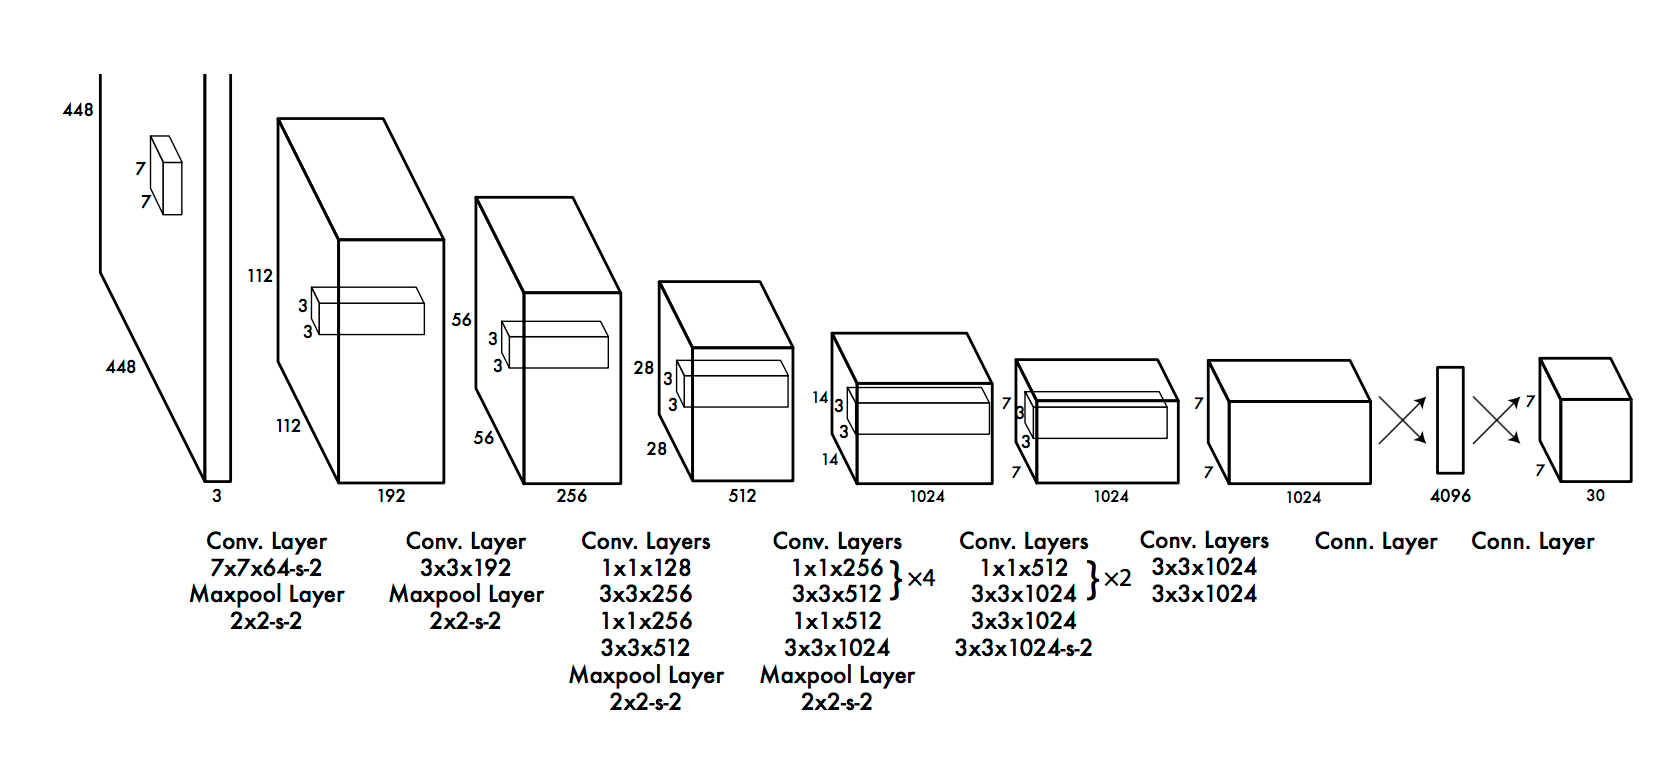
Bien qu'il offre des performances réduites par rapport à son homologue RCNN, il a toujours l'avantage d'être en temps réel pour être utilisable dans les problèmes du quotidien. Voici un rendu de l'architecture YOLO.
8. SqueezeNet
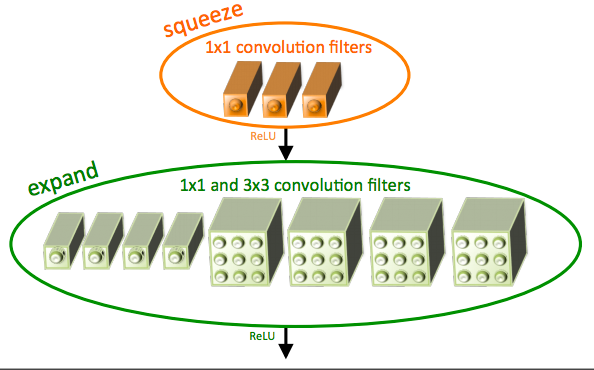
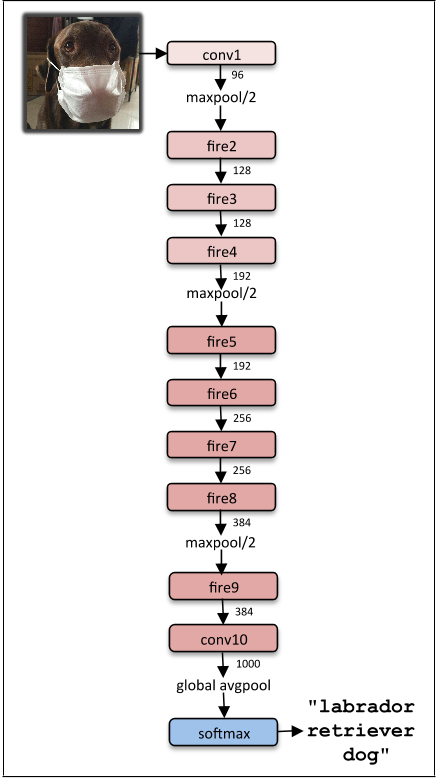
L'architecture squeezeNet est une architecture plus puissante qui est extrêmement utile dans les scénarios à faible bande passante tels que les plates-formes mobiles.. Cette architecture n'occupe que 4,9 Mo d'espace, d'un autre côté, Le départ occupe ~ 100 Mo! Ce changement radical est provoqué par une structure spécialisée appelée module incendie.. L'image ci-dessous est une représentation du module incendie.
L'architecture finale de squeezeNet est la suivante:
9. SegNet
SegNet est une architecture d'apprentissage en profondeur appliquée pour résoudre les problèmes de segmentation d'images. Il se compose d'une séquence de couches de traitement (encodeurs) suivi d'un ensemble correspondant de décodeurs pour une classification de pixels. L'image suivante résume le fonctionnement de SegNet.
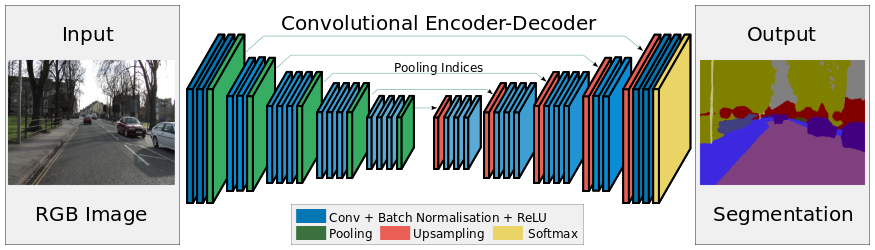
Une caractéristique clé de SegNet est qu'il préserve les détails à haute fréquence dans l'image segmentée, comme les indices de regroupement du réseau de codeurs sont connectés aux indices de regroupement des réseaux de décodeurs. En résumé, le transfert d'informations est direct plutôt qu'alambiqué. SegNet est l'un des meilleurs modèles à utiliser lorsqu'il s'agit de problèmes de segmentation d'images.
10. GAN (Réseau accusatoire génératif)
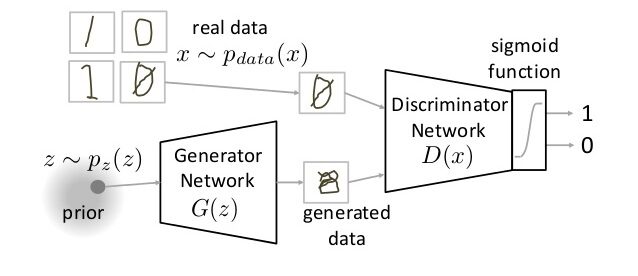
GAN est une classe complètement différente d'architectures de réseaux neuronaux, dans lequel un réseau neuronal est utilisé pour générer une image entièrement nouvelle qui n'est pas présente dans l'ensemble de données d'apprentissage, mais il est suffisamment réaliste pour être dans l'ensemble de données. Par exemple, l'image ci-dessous est une ventilation du GAN. J'ai expliqué le fonctionnement des GAN dans cet article.. A découvrir si vous êtes curieux.
Remarques finales
Dans cet article, J'ai couvert un aperçu des principales architectures d'apprentissage en profondeur que vous devriez connaître. Si vous avez des questions sur les architectures de deep learning, n'hésitez pas à me le partager dans les commentaires.





