
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Dans mon article précédent, Je parle des concepts théoriques sur les valeurs aberrantes et essaie de trouver la réponse à la question: « Quand devons-nous supprimer les valeurs aberrantes et quand devons-nous conserver les valeurs aberrantes? ».
Pour mieux comprendre cet article, tu dois d'abord lire ça Article puis passez à ceci afin que vous ayez une idée claire de l'analyse des valeurs aberrantes dans les projets de science des données.
Dans cet article, Nous essaierons de répondre aux questions suivantes avec les Piton la mise en oeuvre,
?? Comment gérer les valeurs aberrantes?
?? Comment détecter les valeurs aberrantes?
?? Quelles sont les techniques de détection et de suppression des valeurs aberrantes?
Commençons
Comment gérer les valeurs aberrantes?
?? Garnison: Exclure les valeurs aberrantes. de notre analyse. En appliquant cette technique, notre les données deviennent minces lorsqu'il y a plus de valeurs aberrantes présentes dans l'ensemble de données. Son principal avantage est sa le plus rapide la nature.
??Tamponnade: Dans cette technique, Cap notre valeurs aberrantes et faire la limite c'est-à-dire, au-dessus ou au-dessous d'une valeur particulière, toutes les valeurs seront considérées comme des valeurs aberrantes, et le nombre de valeurs aberrantes dans l'ensemble de données donne ce nombre limite.
Par exemple, Si vous travaillez dans la fonction de revenu, les personnes au-dessus d'un certain niveau de revenu peuvent se comporter de la même manière que celles ayant des revenus inférieurs. Dans ce cas, peut limiter la valeur du revenu à un niveau qui le maintient intact et, en conséquence, traiter les valeurs aberrantes.
??Traiter les valeurs aberrantes comme une valeur manquante: Pour en supposant que les valeurs aberrantes sont des observations manquantes, les traiter en conséquence, c'est-à-dire, égal aux valeurs manquantes.
Vous pouvez vérifier l'élément de valeur manquante ici
?? Discrétisation: Dans cette technique, lors de la création des groupes, nous incluons les valeurs aberrantes dans un groupe particulier et les forçons à se comporter de la même manière que celles des autres points de ce groupe. Cette technique est également connue sous le nom de Binning.
Vous pouvez en savoir plus sur la discrétisation ici.
Comment détecter les valeurs aberrantes?
?? Pour les distributions normales: Utiliser des relations de distribution normales empiriques.
– Les points de données ci-dessous média-3 * (sigma) ou au-dessus médias + 3 * (sigma) sont des valeurs aberrantes.
où moyenne et sigma sont les valeur moyenne Oui Écart-type d'une colonne particulière.
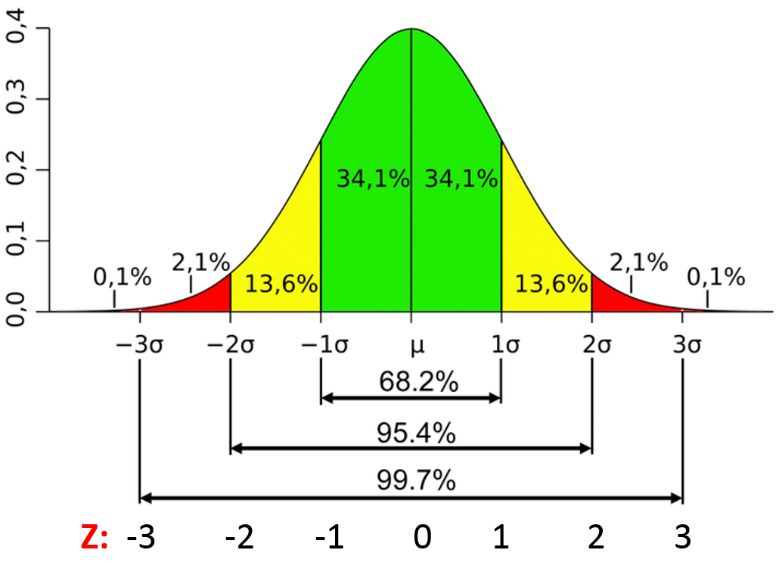
Figure. Caractéristiques d'une distribution normale
Source de l'image: Relier
?? Pour les distributions asymétriques: Utiliser la règle de proximité Inter-Quartile Range (IQR).
– Les points de données ci-dessous T1 – 1.5 IQR ou au-dessus T3 + 1.5 IQR sont des valeurs aberrantes.
où Q1 et Q3 sont les 25 Oui Centile 75 de l'ensemble de données respectivement, et IQR représente l'intervalle interquartile et est donné par Q3 – T1.
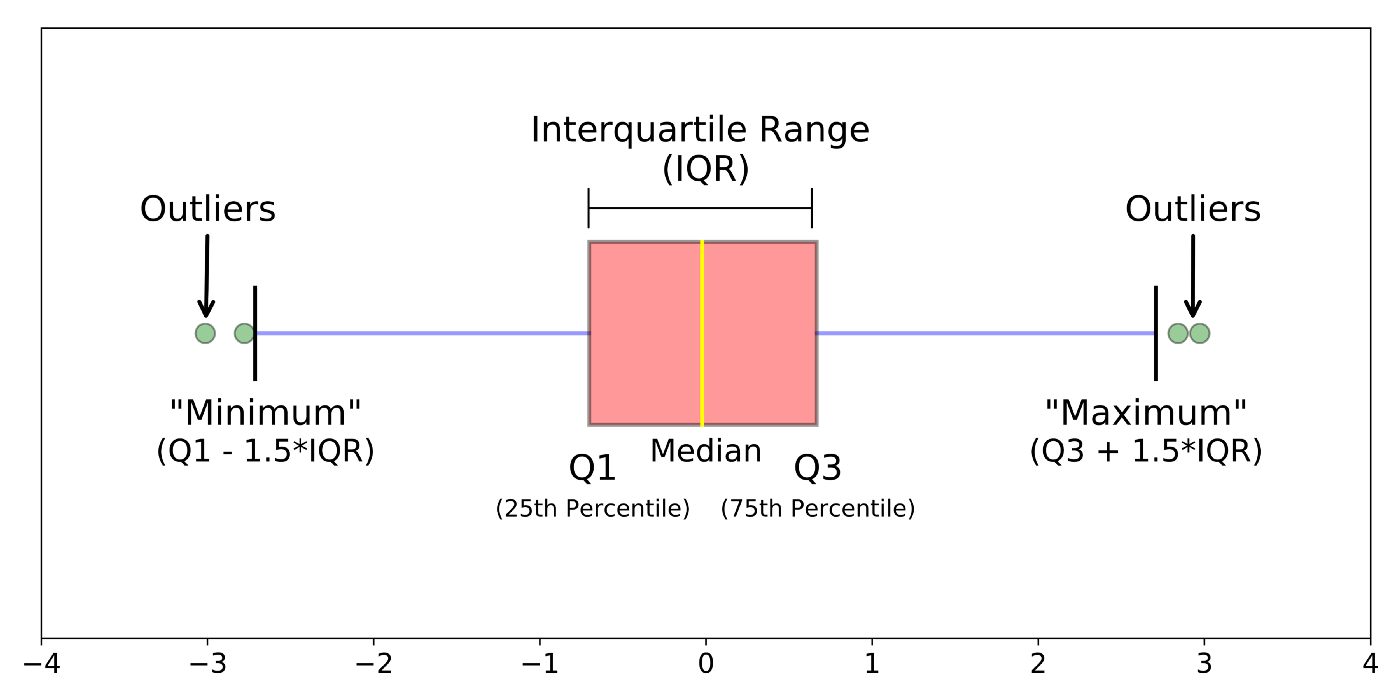
Figure. IQR pour détecter les valeurs aberrantes
Source de l'image: Relier
?? Pour les autres diffusions: Utilisation approche basée sur les centiles.
Par exemple, Points de données éloignés du centile 99% et inférieur au centile 1 sont considérés comme des valeurs aberrantes.
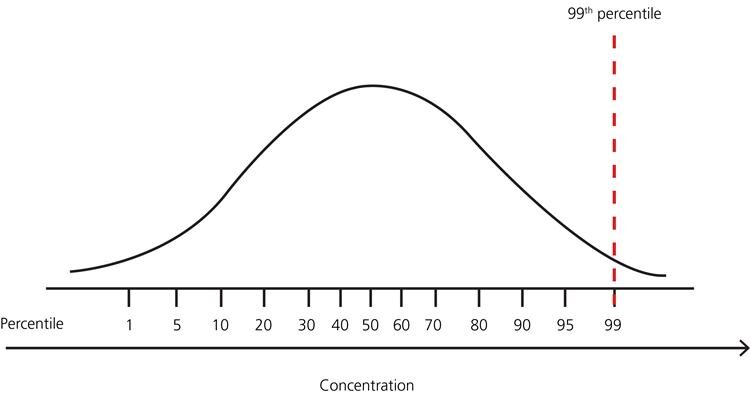
Figure. Représentation centile
Source de l'image: Relier
Techniques de détection et d'élimination des valeurs aberrantes:
?? Traitement du score Z:
Hypothèse– Les caractéristiques sont normalement ou approximativement normalement distribuées.
Paso 1: Importation des dépendances requises
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
Paso 2: lire et charger l'ensemble de données
df = pd.read_csv('placement.csv')
df.échantillon(5)
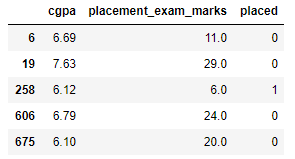
Paso 3: Esquissez les graphiques de distribution des caractéristiques
avertissements d'importation
warnings.filterwarnings('ignore')
plt.figure(taille de la figue=(16,5))
plt.sous-intrigue(1,2,1)
sns.distplot(df['cgpa'])
plt.sous-intrigue(1,2,2)
sns.distplot(df['placement_exam_marks'])
plt.show()
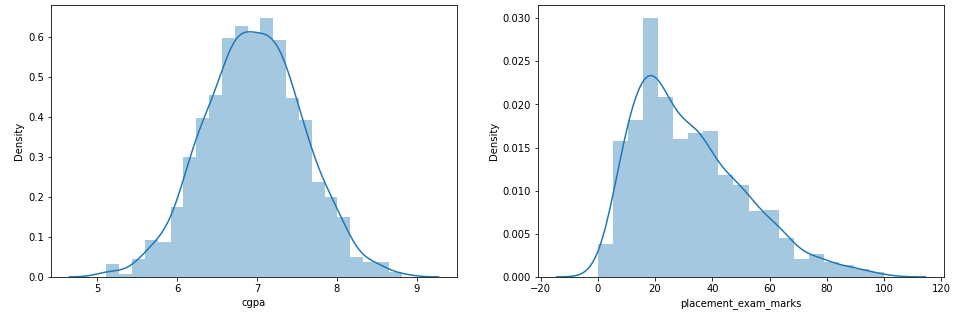
Paso 4: trouver les valeurs limites
imprimer("Le plus élevé autorisé",df['cgpa'].moyenne() + 3*df['cgpa'].std())
imprimer("Le plus bas autorisé",df['cgpa'].moyenne() - 3*df['cgpa'].std())
Production:
Le plus élevé autorisé 8.808933625397177
Le plus bas autorisé 5.113546374602842
Paso 5: trouver des valeurs aberrantes
df[(df['cgpa'] > 8.80) | (df['cgpa'] < 5.11)]
Paso 6: Garniture aberrante
nouveau_df = df[(df['cgpa'] < 8.80) & (df['cgpa'] > 5.11)]
nouveau_df
Paso 7: limitation des valeurs aberrantes
limite_supérieure = df['cgpa'].moyenne() + 3*df['cgpa'].std()
limite_inférieure = df['cgpa'].moyenne() - 3*df['cgpa'].std()
Paso 8: à présent, appliquer le capuchon
df['cgpa'] = np.où(
    df['cgpa']>limite supérieure,
    limite supérieure,
    np.où(
        df['cgpa']<limite inférieure,
        limite inférieure,
        df['cgpa']
    )
)
Paso 9: maintenant voir les statistiques en utilisant la fonction « Décris »
df['cgpa'].décris()
Production:
compter    1000.000000
moyenne        6.961499
std         0.612688
min         5.113546
25%         6.550000
50%         6.960000
75%         7.370000
max         8.808934
Nom: cgpa, dtype: float64
Ceci complète notre technique basée sur le Z-score !!
?? Filtrage basé sur IQR:
Utilisé lorsque notre distribution de données est faussée.
Paso 1: importer les dépendances nécessaires
importer numpy en tant que np
importer des pandas au format pd
importer matplotlib.pyplot en tant que plt
importer seaborn comme sns
Paso 2: lire et charger l'ensemble de données
df = pd.read_csv('placement.csv')
df.head()
Paso 3: Esquissez le graphique de distribution des caractéristiques.
plt.figure(taille de la figue=(16,5))
plt.sous-intrigue(1,2,1)
sns.distplot(df['cgpa'])
plt.sous-intrigue(1,2,2)
sns.distplot(df['placement_exam_marks'])
plt.show()
Paso 4: Former une boîte à moustaches pour la caractéristique asymétrique
sns.boxplot(df['placement_exam_marks'])
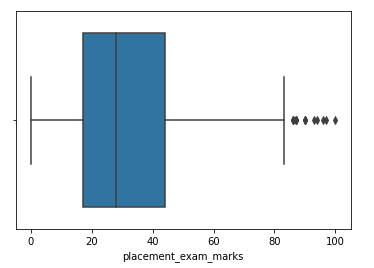
Paso 5: Trouver l'IQR
centile25 = df['placement_exam_marks'].quantile(0.25)
centile75 = df['placement_exam_marks'].quantile(0.75)
Paso 6: Trouver la limite supérieure et inférieure
limite_supérieure = percentile75 + 1.5 * iqr
limite_inférieure = percentile25 - 1.5 * iqr
Paso 7: trouver des valeurs aberrantes
df[df['placement_exam_marks'] > limite supérieure]
df[df['placement_exam_marks'] < limite inférieure]
Paso 8: Découper
nouveau_df = df[df['placement_exam_marks'] < limite supérieure]
new_df.shape
Paso 9: Comparer les tracés après rognage
plt.figure(taille de la figue=(16,8))
plt.sous-intrigue(2,2,1)
sns.distplot(df['placement_exam_marks'])
plt.sous-intrigue(2,2,2)
sns.boxplot(df['placement_exam_marks'])
plt.sous-intrigue(2,2,3)
sns.distplot(nouveau_df['placement_exam_marks'])
plt.sous-intrigue(2,2,4)
sns.boxplot(nouveau_df['placement_exam_marks'])
plt.show()
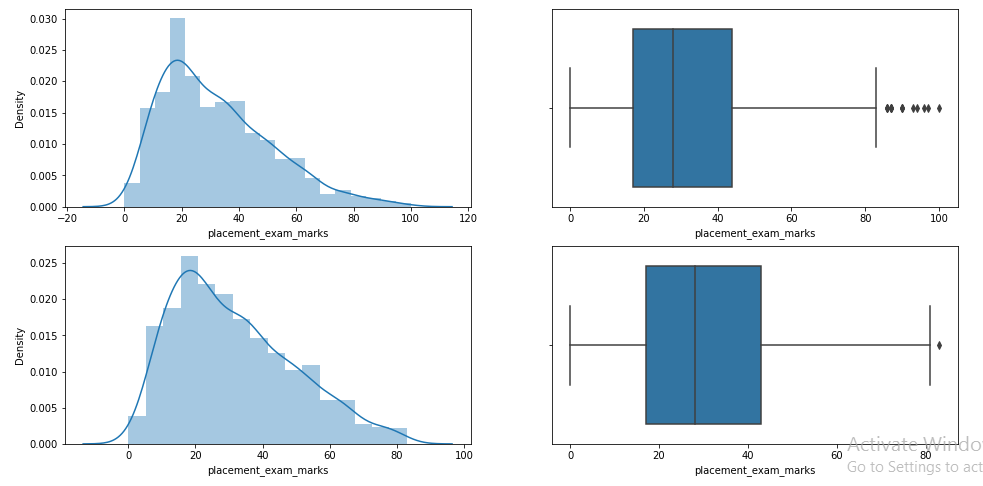
Paso 10: branché
new_df_cap = df.copy()
nouveau_df_cap['placement_exam_marks'] = np.où(
    nouveau_df_cap['placement_exam_marks'] > limite supérieure,
    limite supérieure,
    np.où(
        nouveau_df_cap['placement_exam_marks'] < limite inférieure,
        limite inférieure,
        nouveau_df_cap['placement_exam_marks']
    )
)
Paso 11: Comparer les tracés après la limitation
plt.figure(taille de la figue=(16,8))
plt.sous-intrigue(2,2,1)
sns.distplot(df['placement_exam_marks'])
plt.sous-intrigue(2,2,2)
sns.boxplot(df['placement_exam_marks'])
plt.sous-intrigue(2,2,3)
sns.distplot(nouveau_df_cap['placement_exam_marks'])
plt.sous-intrigue(2,2,4)
sns.boxplot(nouveau_df_cap['placement_exam_marks'])
plt.show()
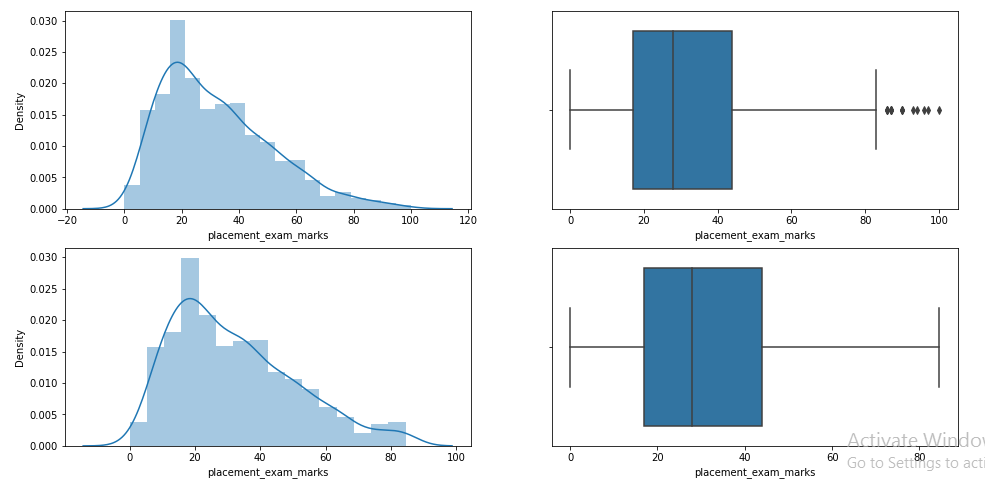
Ceci complète notre technique basée sur l'IQR !!
?? Centile:
– Cette technique fonctionne en définissant une valeur seuil particulière, qui décide en fonction de notre approche du problème.
– Alors que nous supprimons les valeurs aberrantes en limitant, cette méthode particulière est connue sous le nom Winsorización.
– Ici, nous gardons toujours symétrie des deux côtés signifie que si nous enlevons le 1% droit, puis à gauche on diminue aussi un 1%.
Paso 1: importer les dépendances nécessaires
importer numpy en tant que np
importer des pandas au format pd
Paso 2: lire et charger l'ensemble de données
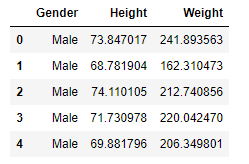
df = pd.read_csv('weight-height.csv')
df.échantillon(5)
Paso 3: Esquissez le graphique de distribution de la caractéristique de « la taille »
sns.distplot(df['Height'])
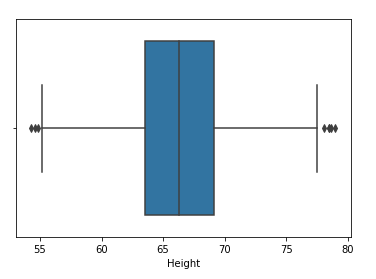
Paso 4: Tracez la boîte à moustaches de la caractéristique de « la taille »
sns.boxplot(df['Height'])
Paso 5: Trouver la limite supérieure et inférieure
limite_supérieure = df['Height'].quantile(0.99)
limite_inférieure = df['Height'].quantile(0.01)
Paso 7: appliquer la garniture
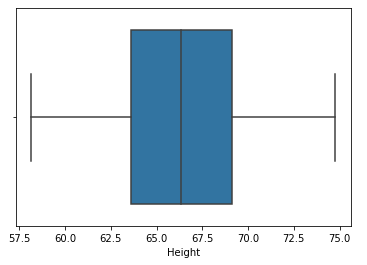
nouveau_df = df[(df['Height'] <= 74.78) & (df['Height'] >= 58.13)]
Paso 8: Comparer la distribution et la boîte à moustaches après découpage
sns.distplot(nouveau_df['Height'])
sns.boxplot(nouveau_df['Height'])
?? Winsorización:
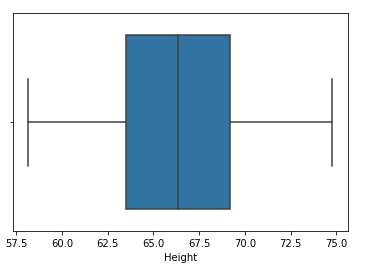
Paso 9: Appliquer la limitation (Winsorización)
df['Height'] = np.où(df['Height'] >= limite_supérieure,
        limite supérieure,
        np.où(df['Height'] <= limite_inférieure,
        limite inférieure,
        df['Height']))
Paso 10: Comparer la distribution et la boîte à moustaches après la contrainte
sns.distplot(df['Height'])
sns.boxplot(df['Height'])
Ceci complète notre technique basée sur les centiles !!
Remarques finales
Merci pour la lecture!
Si vous avez aimé cela et que vous voulez en savoir plus, visitez mes autres articles sur la science des données et l'apprentissage automatique en cliquant sur le Relier
N'hésitez pas à me contacter au Linkedin, Courrier électronique.
Tout ce qui n'est pas mentionné ou voulez-vous partager vos pensées? N'hésitez pas à commenter ci-dessous et je vous répondrai.
A propos de l'auteur
Chirag Goyal
Actuellement, Je poursuis mon Bachelor of Technology (B.Tech) en informatique et ingénierie de Institut indien de technologie Jodhpur (IITJ). Je suis très enthousiasmé par l'apprentissage automatique, les l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... et l’intelligence artificielle.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





