
Vue d'ensemble
- Qlik est largement associé à de puissants tableaux de bord et rapports de business intelligence.
- Saviez-vous que vous pouvez utiliser la puissance de Qlik pour effectuer une modélisation prédictive et créer des modèles?
- Apprenez à faire exactement cela avec ce guide vraiment cool sur la façon de créer un modèle de régression linéaire à l'aide de Qlik Sense.
introduction
« Puis-je utiliser Qlik Sense pour créer une analyse OUI OUI créer un modèle de régression linéaire simple afin que mes utilisateurs professionnels puissent prévoir les revenus futurs en fonction des ventes cibles? »
Une question intrigante! Qlik est largement associé à la création de tableaux de bord et de rapports de business intelligence., pas avec la modélisation prédictive. Si tu avais la même pensée, tu n'es pas seul!
Qlik est comme un vent dans le dos pour tout chef d'entreprise. Rend l'analyse et la présentation des données aux utilisateurs finaux extrêmement faciles et rapides. Sans surprise, Qlik est régulièrement nommé leader dans le Magic Quadrant de Gartner pour les plateformes de Business Intelligence et d'analyse..
Ce que j'aime vraiment chez Qlik, c'est que son modèle associatif offre une découverte de données sous forme libre. Cela aide notre utilisateur final à trouver rapidement les tendances et les valeurs aberrantes pour obtenir des informations précieuses.. Qlik est bien connu pour son modèle associatif et pour la vitesse incroyable avec laquelle il révèle les associations entre les champs au sein d'un modèle de données..
Avec son changement de paradigme d'affichage de toutes les données, y compris les valeurs aberrantes, nos clients et parties prenantes peuvent rapidement trouver des informations pour prendre des décisions commerciales critiques. Les applications Qlik couvrent plusieurs secteurs tels que:
- Dans les soins de santé, une compagnie d'assurance peut vouloir prédire le coût futur des soins aux patients en utilisant les coûts, données démographiques et diagnostics antérieurs.
- Les défauts du produit peuvent être prédits en utilisant l'efficacité du processus basée sur les défauts précédents et la précision de l'équipement dans le secteur de la fabrication.
- En ressources humaines, nous pouvons prédire le coût futur de la masse salariale d'un employé en fonction de son âge et de son expérience.
Pensez aux possibilités, ils sont infinis!
Après avoir lu cet article, saura mettre la casquette d'un data scientist, puisque QlikView et Qlik Sense offrent un grand nombre de fonctions statistiques dont vous pouvez tirer parti pour créer votre premier modèle prédictif à l'aide de la régression linéaire. Nous allons commencer!
Table des matières
- Introduction à la régression linéaire simple
- Implémentation de la régression linéaire dans Qlik
- Comparaison de nos résultats avec un modèle créé avec Python
Introduction à la régression linéaire simple

La source: xkcd.com
Commençons par le concept d'analyse de régression. C'est une forme de modélisation prédictive qui révèle la relation entre une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... indépendante et une dépendante. C'est peut-être la technique la plus courante que les aspirants professionnels de la science des données apprennent en premier..
La régression est utilisée pour évaluer la contribution d'une ou plusieurs variables « provoquant » (variables indépendantes) à une variable « causé » (dépendant). On peut aussi l'utiliser pour prédire la valeur de la variable dépendante à partir des valeurs des variables indépendantes. Quelques exemples populaires incluent la prédiction du prix d'une maison, le salaire d'un employé, etc. (Je suis sûr que votre esprit doit être plein d'idées !!).
Lorsqu'il n'y a qu'une seule variable indépendante et que la relation peut être exprimée sous forme de ligne droite, la procédure est appelée régression linéaire simple.
Une ligne droite peut être définie par l'équation mathématique y = mx + b:
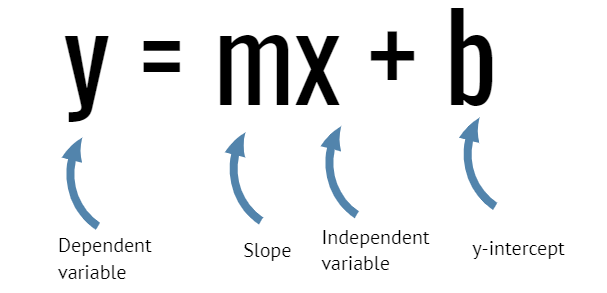
- y est une variable dépendante et est représenté sur l'axe vertical
- x est une variable indépendante et est représenté sur l'axe horizontal
- m est la pente (quantité de variation de y correspondant à l'augmentation d'une unité de x)
- b est l'intersection
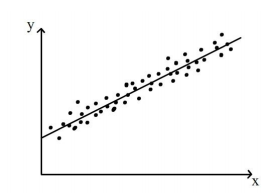 La source: http://www.statstutor.ac.uk
La procédure de régression ajuste la meilleure ligne droite possible à une matrice de points de données. Si une seule ligne ne peut pas être tracée de sorte que tous les points tombent dessus, quelle est « mieux » ligne? Pensez-y avant de lire la réponse.
La meilleure ligne est celle qui minimise la distance de tous les points de données à la ligne.
Le coefficient de corrélation indique la force de la relation entre les variables indépendantes et dépendantes., tandis que le coefficient de détermination (R Carré) explique dans quelle mesure la variance de la variable indépendante explique la variance de la variable dépendante.
Un coefficient de corrélation proche de 1 indique une relation positive entre la variable indépendante et dépendante et un coefficient de détermination plus proche de 1 indique un bon ajustement des données au modèle prédictif.
Armé de cette connaissance, nous pouvons créer notre premier modèle de régression linéaire simple dans Qlik Sense ou QlikView.
Implémentation de la régression linéaire dans Qlik
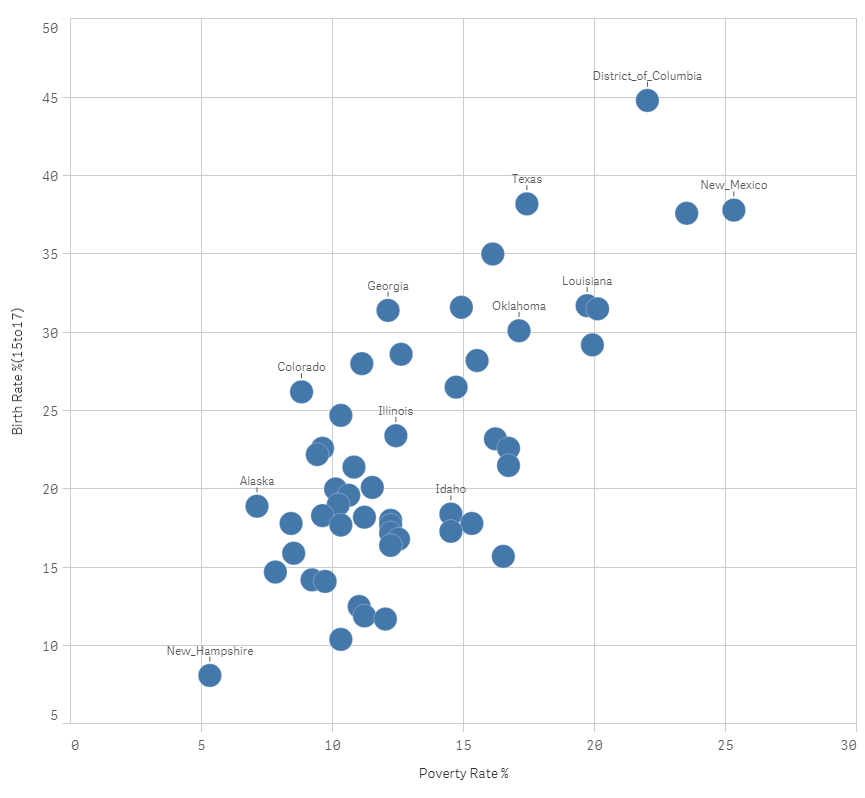
Récemment, j'ai rencontré cet article très intéressant montrant le lien entre la grossesse chez les adolescentes et le taux de pauvreté aux États-Unis. Ces faits méritent réflexion sur les raisons pour lesquelles la grossesse chez les adolescentes conduit à un taux de pauvreté plus élevé:
- Seulement le 38 pourcentage de filles qui ont déjà eu un enfant 18 années obtenir leur diplôme d'études secondaires à 22
- Les deux tiers des mères adolescentes qui quittent le foyer familial vivent dans la pauvreté et une proportion similaire perçoit des prestations publiques au cours de la première année de vie de leur enfant..
- Soixante-dix-huit pour cent des enfants nés de mères adolescentes jamais mariées qui n'ont pas obtenu leur diplôme d'études secondaires vivent en dessous du seuil de pauvreté fédéral.
C'est un problème dont nous devrions tous être conscients et si nous pouvons aider de quelque manière que ce soit, nous devrions au moins essayer. J'ai eu la chance de trouver un ensemble de données à ce sujet à Site de statistiques de l'Université d'État de Pennsylvanie, STAT462.
Ensuite, nous utiliserons cet ensemble de données pour créer un modèle de régression linéaire simple dans Qlik Sense. Allez-y et enregistrez-le sur votre machine. Voici un aperçu de l'ensemble de données:
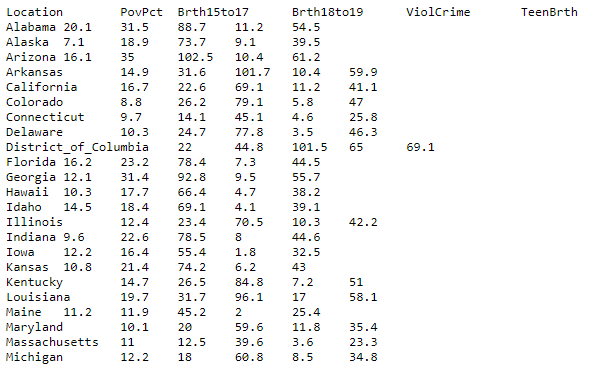
Cet ensemble de données de taille n = 51 est pour le 50 États-Unis et le District de Columbia aux États-Unis.
Ensuite, Jetons un coup d'œil aux étapes et je souhaite que vous les suiviez dans Qlik Sense au fur et à mesure que nous les parcourons.
Paso 1: créer un nuage de points
Paso 2: Calculer le coefficient de corrélation
Créez un graphique de texte et d'images avec l'expression suivante:

Paso 3: Calculer le coefficient de détermination.
Créer un graphique de texte et d'images avec cette expression:
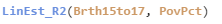
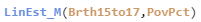
Paso 4: calculer la pente
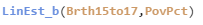
Paso 5: Trouver l'ordonnée à l'origine
Paso 6: créer une variable x avec la valeur initiale = 0
Cette variable va nous permettre de changer la valeur de la variable indépendante, taux de natalité (15 une 17), prédire le taux de pauvreté. Cliquez sur l'option variable dans le coin inférieur gauche de l'éditeur de feuille:
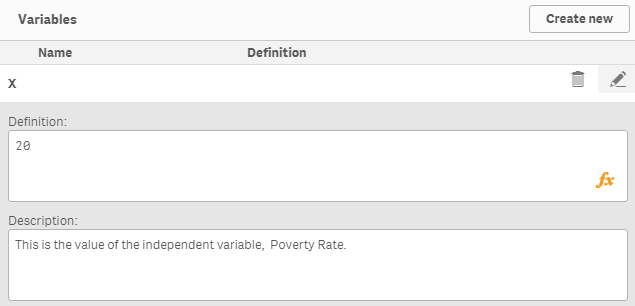
Paso 7: Calculer le taux de natalité attendu pour le groupe des adolescents (15 une 17)
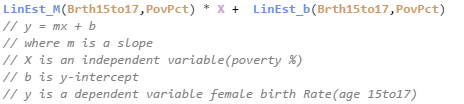
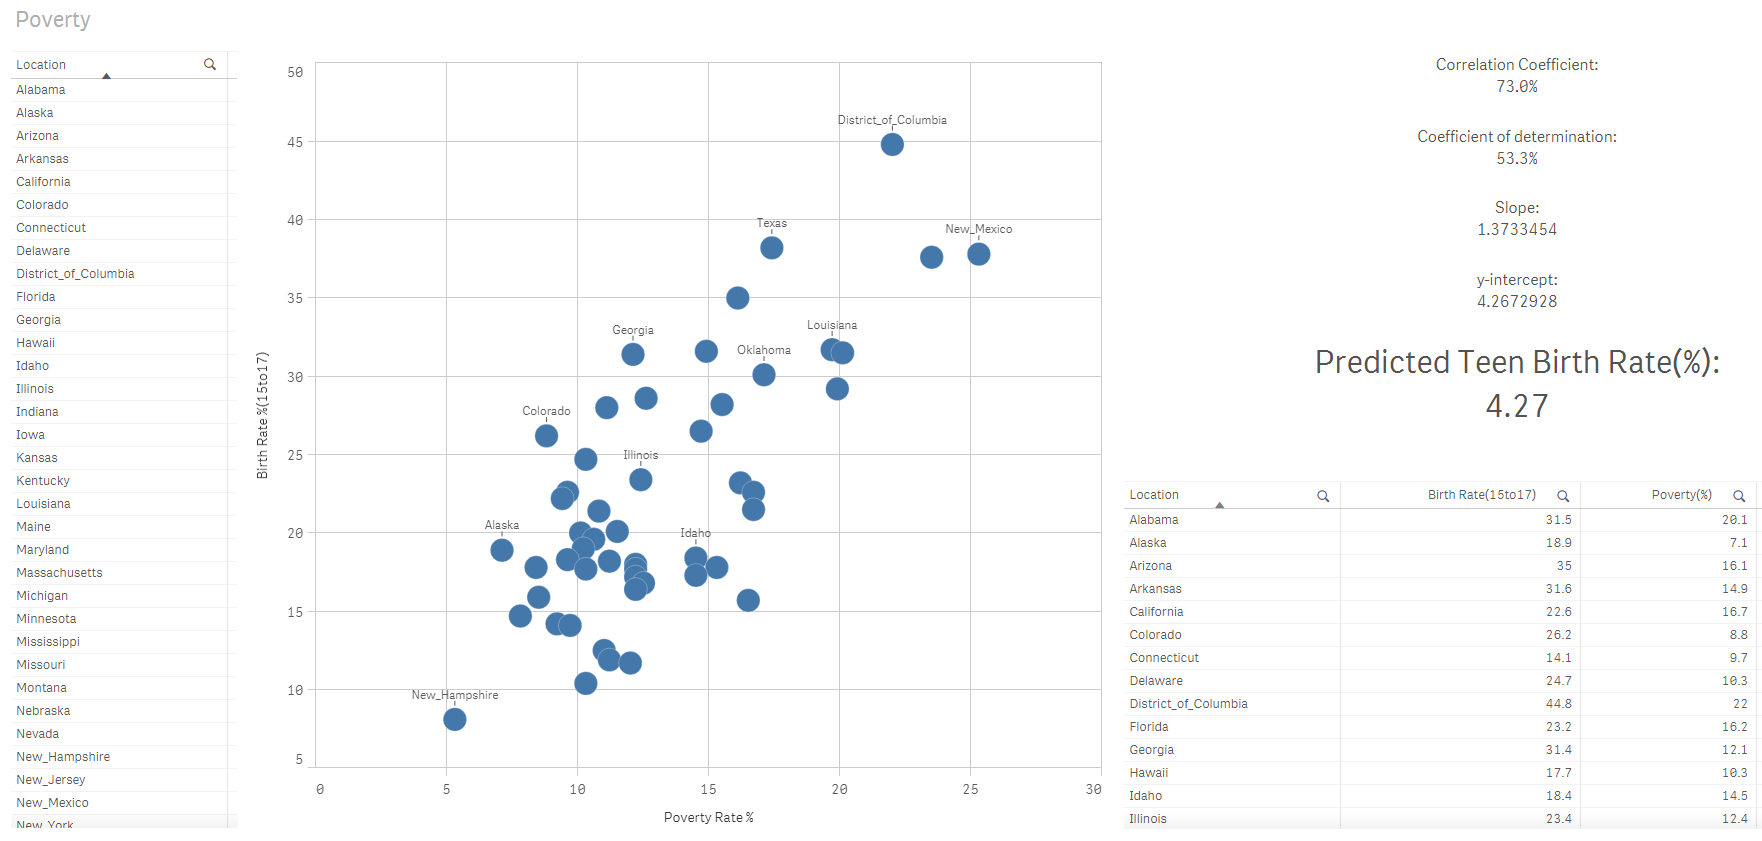
Comme indiqué ici, notre modèle de régression linéaire Qlik Sense correspond à l'équation de la droite ajustée:
Y = 1,373X + 4,267
Avec un taux de pauvreté de 0%, le taux de natalité chez les adolescentes serait 4,27%. Un changement d'une unité dans la valeur de la variable indépendante équivaut à un changement de 1,373 dans la valeur de la variable dépendante.
Quel serait le taux de natalité des adolescentes si le taux de pauvreté était 15%? C'est la réponse:
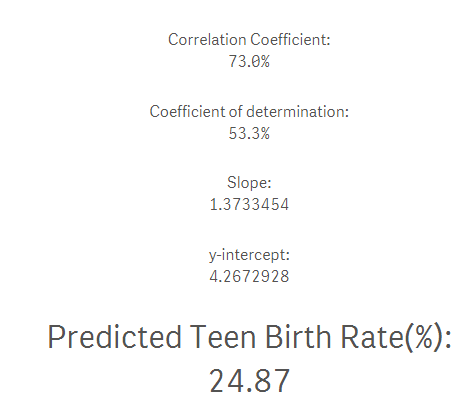
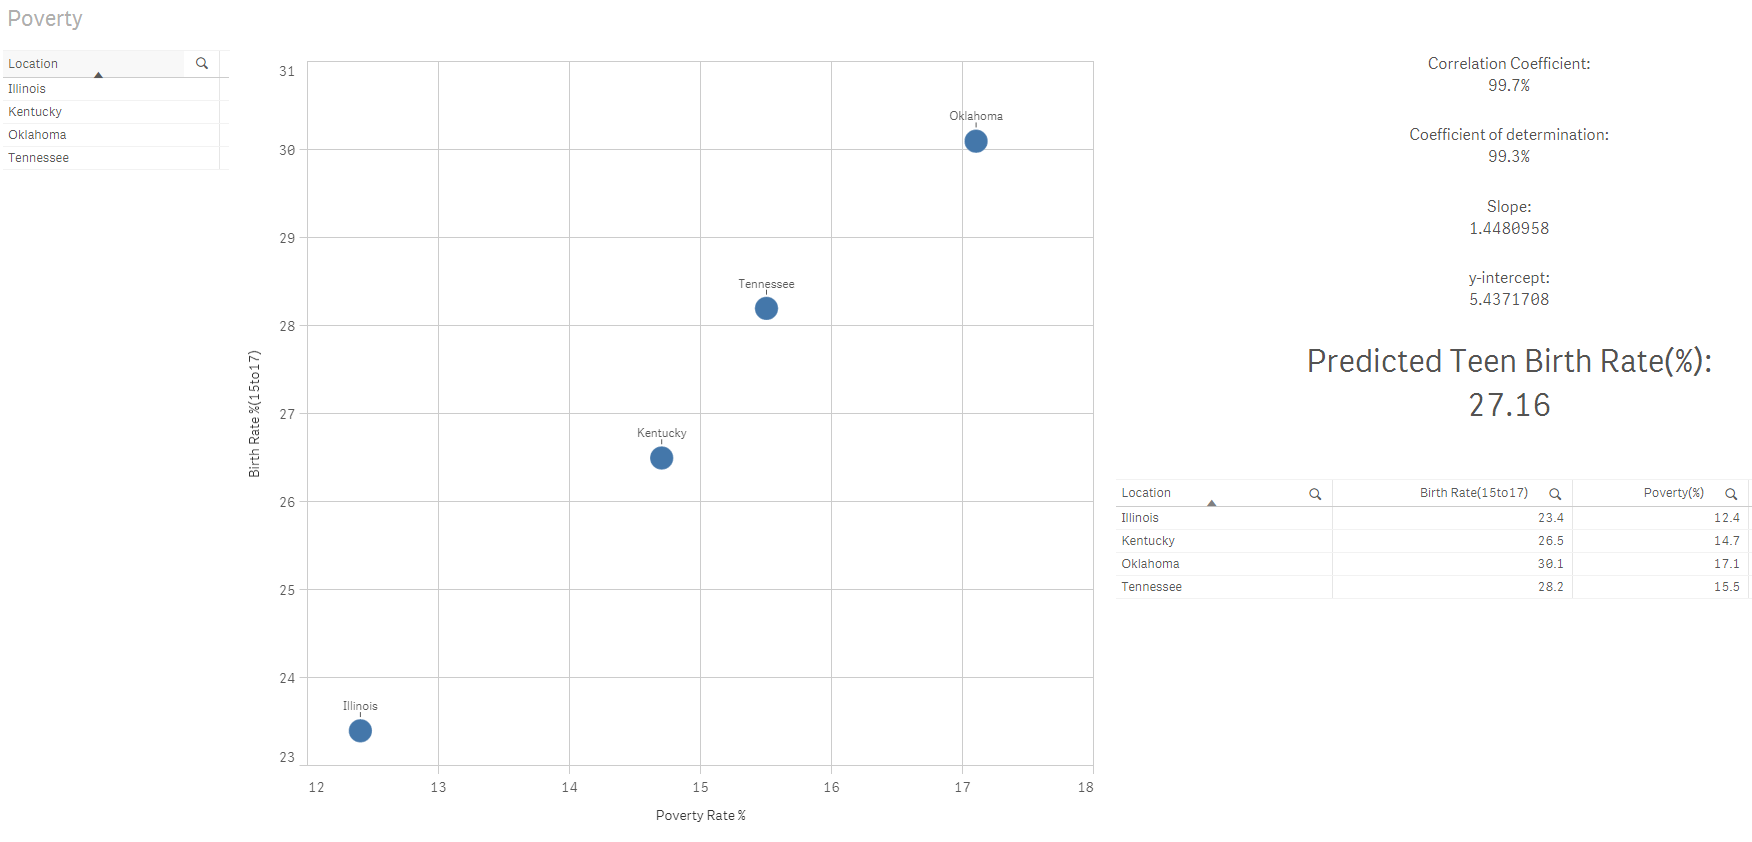
Maintenant, je peux combiner la puissance du moteur associatif pour affiner la liste des états et prédire le taux de natalité pour un groupe d'âge de femmes de 15 une 17 années sur la base de mes sélections en utilisant le taux de pauvreté de la 15%:
Fabuleux! N'aimez-vous pas la puissance de Qlik?
Comparaison de nos résultats avec un modèle créé avec Python
Ensuite, nous allons créer un modèle de régression simple similaire en Python en utilisant les bibliothèques Pandas et scikit-learn. Je souhaite comparer la précision du modèle prédictif que nous créons dans Qlik Sense avec celui que nous créerons en Python.
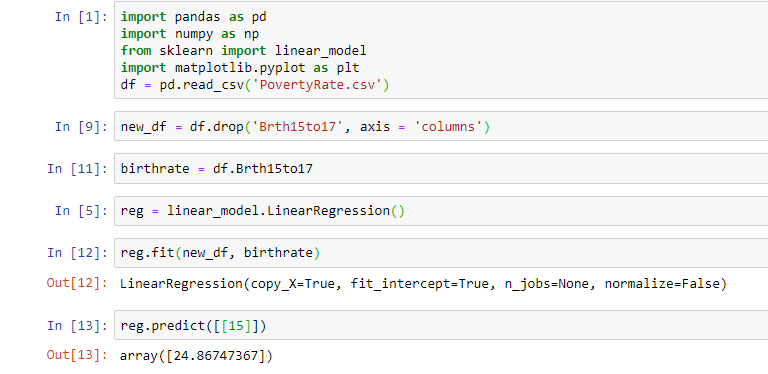
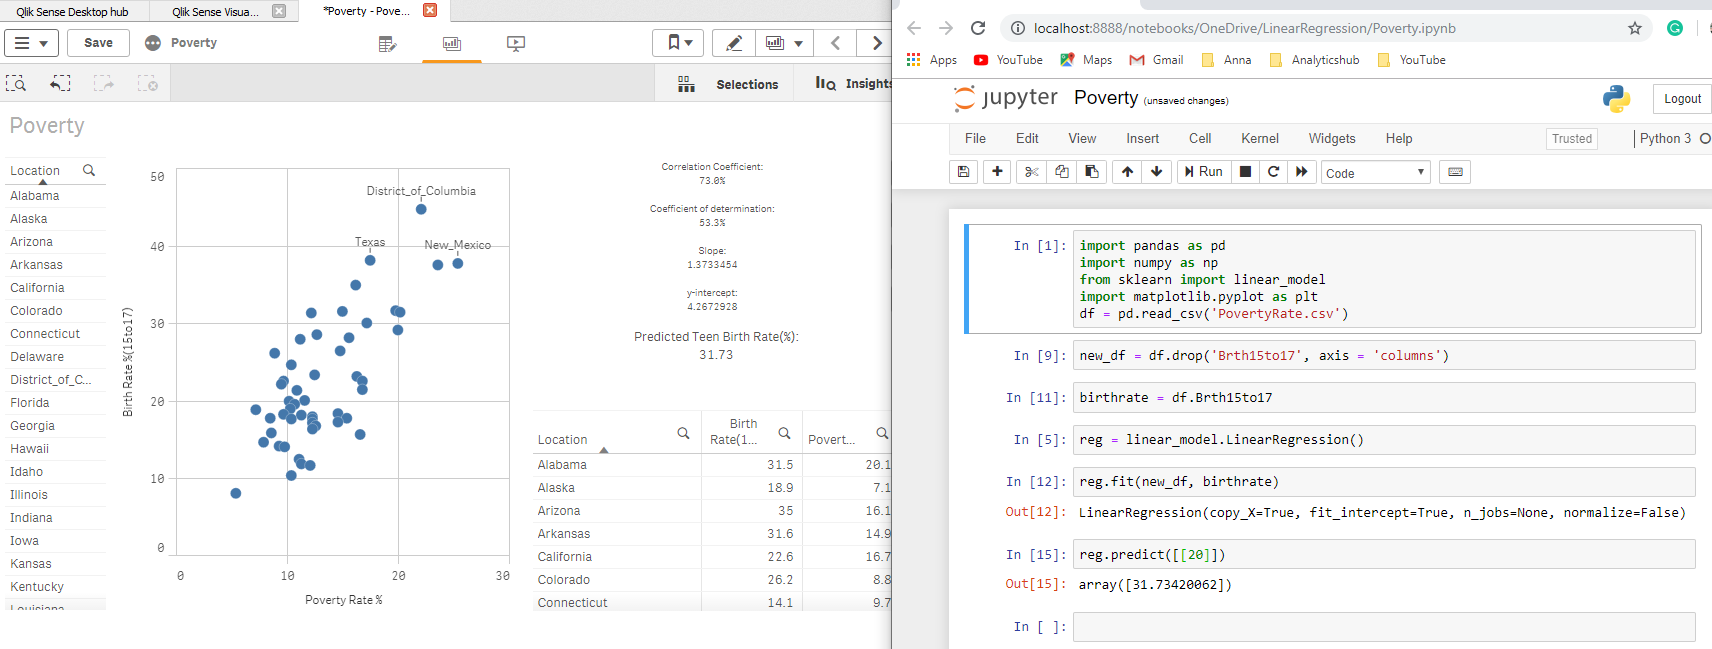
Le résultat de notre modèle de régression Python simple correspond à celui de Qlik Sense. Comparons la valeur prédictive de notre modèle de régression linéaire Qlik Sense avec celui que nous avons créé en Python:
Remarques finales
Nous pouvons créer un modèle de régression simple pour montrer le scénario « Et qu'est-ce qui se passerait si » dans Qlik Sense tant que nous validons d'abord que la relation entre la variable indépendante et la variable dépendante est positive ou négative à l'aide d'une fonction de corrélation intégrée pour voir la relation .
En outre, s'assurer que les données sont adaptées à la modélisation à l'aide du coefficient de détermination (R Carré). Si une valeur est plus proche de 1, alors nos données sont adaptées à une modélisation de régression simple dans Qlik Sense.
Faites-moi part de vos suggestions et commentaires pour cet article dans la section commentaires ci-dessous..
A propos de l'auteur
Shilpan Patel – Co-fondateur, Analyticshub.io Y Qlik Luminaire 2018, 2019
Shilpan est un luminaire Qlik et se passionne pour permettre aux étudiants de développer leur plein potentiel grâce à l'apprentissage et au mentorat tout au long de la vie.. Il croit que la meilleure façon d'apprendre et de maîtriser une compétence est de faire. A plus que 15 années d'expérience en données et en analyse, et a enseigné et encadré des milliers d'étudiants.





