
Cet article a été publié dans le cadre de la Blogathon sur la science des données.
Trouvez-vous l'IA et le ML intéressants ??
Êtes-vous intéressé à devenir un ingénieur en apprentissage automatique?? Avez-vous appris des langages de programmation comme Python ou R, mais a du mal à avancer? (Cela se produit principalement dans le cas des autodidactes). Trouvez-vous des mots comme Statistiques intimidants ?, Probabilité et régression? C'est tout à fait compréhensible de se sentir comme ça, surtout si vous venez d'un milieu non technique. Mais il y a une solution pour ça. Et c'est …. pour commencer. Rappelles toi, si ça ne démarre jamais, vous ne ferez jamais d'erreurs et vous n'apprendrez peut-être jamais. Alors commence petit.
Régression linéaire simple
Quand utilisons-nous LR?
Nous allons créer un modèle d'apprentissage automatique simple en utilisant la régression linéaire. Mais avant de passer à la partie codage, Regardons les bases et la logique derrière cela. La régression est utilisée dans l'algorithme d'apprentissage automatique supervisé, qui est l'algorithme le plus utilisé actuellement. L'analyse de régression est une méthode dans laquelle nous établissons un lien entre une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendant (Oui) et une variable indépendante (X); ce qui nous permet de prédire et de prévoir les résultats. Vous souvenez-vous avoir résolu des équations comme y = mx + c de tes jours d'école? Le cas échéant, Toutes nos félicitations. Vous connaissez déjà la régression linéaire simple. Si ce n'est pas comme ça, pas difficile à apprendre du tout.
Prenons un exemple populaire. Le nombre d'heures investies dans l'étude et les notes obtenues à l'examen. Dans cette circonstance, les notes obtenues dépendent du nombre d'heures que l'étudiant investit dans l'étude, pour cela, les notes obtenues sont la variable dépendante y et le nombre d'heures est la variable indépendante x. L'objectif est de développer un modèle qui nous aide à prédire les notes obtenues pour un nouveau nombre d'heures déterminé.. Nous allons y parvenir en utilisant la régression linéaire.
Pour être très clair sur ce concept, considérons un autre exemple. Dans un ensemble de données avec la quantité de calories consommées et le poids pris, le poids pris dépend des calories consommées par une personne. Pour cela, le poids pris est la variable dépendante y et le nombre de calories est la variable indépendante x.
y = mx + c est l'équation de la droite de régression qui correspond le mieux aux données et, parfois, de plus, il est représenté par y = b0 + b1X. Ici,
y est la variable dépendante, dans cette circonstance, les notes obtenues.
x est la variable indépendante, dans cette circonstance, le nombre d'heures.
foule1 est la pente de la droite de régression et le coefficient de la variable indépendante.
c o b0 est l'intersection de la droite de régression.
La logique est de calculer la pente (m) et intercepter (c) avec les données disponibles et nous pourrons ensuite calculer la valeur de y pour n'importe quelle valeur de x.
Packages et codes Python requis
À présent, Comment effectuer une régression linéaire en python? Nous devons importer des packages, a savoir NumPy travailler avec des matrices, Sklearn effectuer une régression linéaire, Oui Matplotlib pour tracer la droite de régression et les graphiques. Notez qu'il est presque impossible d'avoir connaissance de chaque paquet et bibliothèque en Python, surtout pour les débutants. Pour cela, il est recommandé de continuer à chercher le bon package en cas de besoin pour une tâche. Il est plus facile de se rappeler d'utiliser des packages avec une expérience pratique impliquée, au lieu de simplement lire théoriquement la documentation disponible sur eux.
Passons à la partie codage. La première étape consiste à importer les packages requis.
importer numpy en tant que np
importer matplotlib.pyplot en tant que plt
à partir de sklearn.linear_model importer LinearRegression
Considérant qu'il s'agit de votre premier modèle d'apprentissage automatique, nous éliminerons certaines complications en prélevant un très petit échantillon, au lieu d'utiliser des données d'un base de donnéesUne base de données est un ensemble organisé d’informations qui vous permet de stocker, Gérez et récupérez efficacement les données. Utilisé dans diverses applications, Des systèmes d’entreprise aux plateformes en ligne, Les bases de données peuvent être relationnelles ou non relationnelles. Une bonne conception est essentielle pour optimiser les performances et garantir l’intégrité de l’information, facilitant ainsi la prise de décision éclairée dans différents contextes.... génial. Cela aidera également à voir clairement le résultat dans les graphiques et à apprécier efficacement le concept..
xpuntos = np.array ([10, 11, 12, 13, 14, 15]) .réforme (-1,1)
ypoints = np.tableau ([53, 52, 60, 63, 72, 70])
Notez que nous sommes en train de remodeler le points x avoir une colonne et plusieurs lignes. Le prédicteur (X) doit être un tableau de tableaux et la solution (Oui) peut être une simple matrice.
Une variable Linreg est créé comme une instance de Régression linéaire. Il peut prendre des paramètres qui sont facultatifs. Ils ne sont pas nécessaires pour cet exemple, donc on va les ignorer. Comme le nom le suggère, les .pour se adapter à() La méthode s'adapte au modèle et est utilisée pour estimer certains des paramètres du modèle, ce qui signifie qu'il calcule la valeur optimisée de myc en utilisant les données fournies.
linreg = régression linéaire()
linreg.fit(points x, points y)
.prédire() La méthode est utilisée pour obtenir la solution prédite à l'aide du modèle et prend le prédicteur points x comme argument.
y_pred = linreg.predict(points x)
À présent, imprimer y_pred et remarquez que les valeurs sont assez proches de points. Si les réponses prévues et réelles ont une valeur proche de, signifie que le modèle est précis. Dans un cas idéal, les valeurs de réponse prévues et réelles se chevaucheraient.
Le module pyplot de la bibliothèque Matplotlib a été importé en tant que plt. Ainsi, nous pouvons facilement tracer les graphiques en utilisant .dispersion() qui prend points x Oui points comme arguments. Tracez la vraie solution. La solution prédite est tracée en utilisant.terrain() une fonction. Le graphique peut être étiqueté en utilisant.xlabel Oui .ylabel.
plt.scatter (x points, pointe et)
plt.plot (x points, y_pred)
plt.xlabel (« x points »)
plt.ylabel (« pointe et »)
plt.show ()
plt.show () échantillon tous les objets de chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... actifs à ce moment.
Les attributs .coef_ Oui .intercepter_ donne la pente qui est aussi le coefficient de x, et l'intersection de y. Cela signifie que y = c = 8.80, environ, quand x = 0 et y = 4.22 (1) + 8.80 = 13.02 (environ) quand x = 1. Notez que dans la sortie, l'intersection est scalaire et le coefficient est une matrice.
imprimer(linreg.coef_)
imprimer(linreg.intercept_)
Nous avons construit notre modèle. Essayez maintenant de prédire la solution y_nouveau pour une nouvelle valeur de prédicteur x_nouveau = 16. Là! Nous avons un modèle qui peut prédire la solution pour n'importe quel prédicteur donné.
x_new = np.array ([16]) .réforme (-1,1)
y_new = linreg.predict (x_nouveau)
imprimer (y_nouveau)
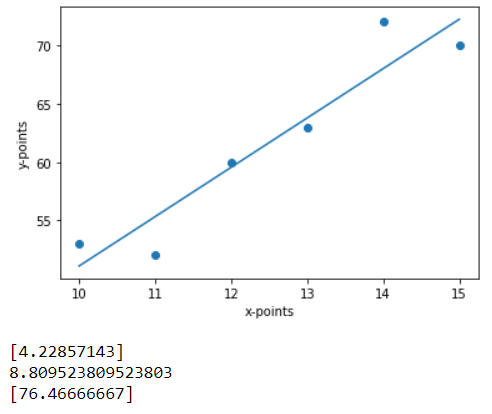
L'image ci-dessus est à quoi pourrait ressembler le résultat final. Le 3 les sorties sous le graphique sont la solution à notre impression() déclarations. Ensuite, ils sont en attente, carrefour et y_nouveau respectivement.
L'équation de la droite de régression est y = 4,23x + 8,80. Ensuite, selon l'équation, quand x = 16,
y = 4,23 * (16) + 8,80 = 76,48. La petite différence dans le calcul est due aux points décimaux.
On peut utiliser .But() méthode qui échantillonne x et y comme leur 2 arguments pour trouver R2 ou le coefficient de détermination. Meilleur rapport qualité/prix pour R2 il est 1.0 et il peut aussi prendre des valeurs négatives, puisque le modèle peut être pire. Une valeur plus proche de R2 une 1.0 indique l'efficacité de notre modèle.
linreg.score(points x, points y)
Exécutez le code et vous verrez que la valeur de R2 il est 0,89, donc la prévision du modèle est fiable.
Suivant?
C'est aussi simple qu'une régression linéaire. Ce n'est pas le seul moyen, mais cela m'a semblé le moyen le plus simple et le plus facile. Ne vous arrêtez pas ici. Quand tu te sens à l'aise avec ça, vous pouvez aller plus loin et envisager un ensemble de données plus important. Par exemple, un fichier CSV. Vous devrez travailler avec Pandas et les packages NumPy dans ce cas. Ensuite, vous pouvez tester un modèle de régression logistique linéaire ou multiple. Continuez à apprendre et à pratiquer.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





