
introduction
Chaque passionné d'apprentissage automatique a un rêve à construire / travailler sur un projet sympa, ce n'est pas comme ça? La simple compréhension de la théorie ne suffit pas, il faut travailler sur des projets, essayez de les mettre en œuvre et d'apprendre d'eux. En outre, travailler dans des domaines spécifiques comme la PNL vous offre de nombreuses opportunités et des énoncés de problèmes à explorer. A travers cet article, Je veux vous présenter un projet incroyable, le modèle de détection de langue utilisant le traitement du langage naturel. Cela vous mènera à travers un exemple réel de ML (application pour dire). Ensuite, n'attendons plus.
À propos de l'ensemble de données
Nous utilisons le Ensemble de données de détection de langue, contenant des détails textuels pour 17 différentes langues.
Les langues sont:
* Anglais
* Portugais
* français
* grec
* néerlandais
* Espagnol
* Japonais
* russe
* danois
* Italiano
* turc
* suédois
* Arabica
* malayalam
* hindi
* Tamil
* Telugu
En utilisant le texte, nous devons créer un modèle qui sera capable de prédire la langue donnée. C'est une solution pour de nombreuses applications de l'intelligence artificielle et des linguistes informatiques.. Ce type de systèmes de prédiction est largement utilisé dans les appareils électroniques tels que les mobiles, ordinateurs portables, etc. pour la traduction automatique et aussi dans les robots. Il permet également de suivre et d'identifier les documents multilingues. Le domaine de la PNL reste un domaine actif pour les chercheurs.
Mise en œuvre
Importer des bibliothèques et des ensembles de données
Alors commençons. En premier lieu, nous importerons toutes les bibliothèques nécessaires.
importer des pandas au format pd
importer numpy en tant que np
importation re
importer seaborn comme sns
importer matplotlib.pyplot en tant que plt
avertissements d'importation
avertissements.simplefilter("ignorer")
Importons maintenant l'ensemble de données de détection de langue
données = pd.read_csv("Détection de langue.csv")
data.head(10)
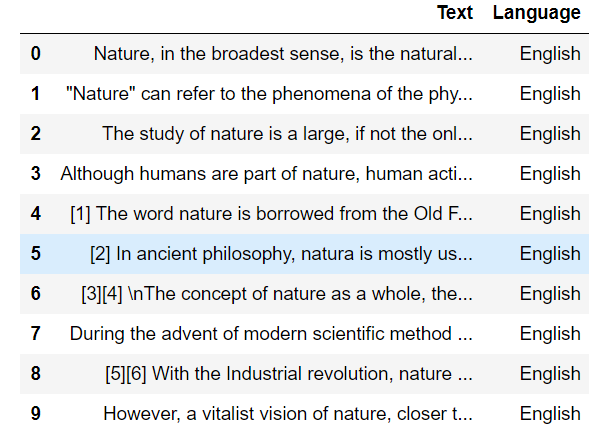
Comme je te l'ai dit avant, cet ensemble de données contient des détails textuels pour 17 différentes langues. Comptons donc le nombre de valeurs pour chaque langue.
Les données["Langue"].value_counts()
Production :
Anglais       1385
français        1014
Espanol        819
Portugais     739
italien        698
russe        692
suédois       676
malayalam      594
néerlandais          546
arabe         536
turc        474
Allemand         470
Tamil          469
danois         428
Kannada        369
grec          365
hindi           63
Nom: Langue, dtype: int64
Séparation des caractéristiques indépendantes et dépendantes
Maintenant, nous pouvons séparer les variables dépendantes et indépendantes, aquí los datos de texto son la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... independiente y el nombre del idioma es la variable dependiente.
X = données["Texte"]
y = données["Langue"]
Encodage des étiquettes
Notre variable de sortie, le nom des langues, est une variable catégorielle. Pour entraîner le modèle, nous devrions avoir à le convertir en une forme numérique, nous faisons donc un codage d'étiquette sur cette variable de sortie. Pour ce processus, nous importons LabelEncoder depuis sklearn.
de sklearn.preprocessing importer LabelEncoder
le = LabelEncoder()
y = le.fit_transform(Oui)
Prétraitement de texte
Il s'agit d'un ensemble de données créé à l'aide du grattage Wikipédia, il contient donc de nombreux symboles indésirables, des chiffres qui affecteront la qualité de notre modèle. Ensuite, nous devrions effectuer des techniques de prétraitement de texte.
# créer une liste pour ajouter le texte prétraité
liste_données = []
# itérer dans tout le texte
pour le texte en X:
       # supprimer les symboles et les chiffres
        texte = re.sub(r'[[email protégé]#$(),m"%^*?:;~`0-9]', ' ', texte)
        texte = re.sub(r'[[]]', ' ', texte)
        # convertir le texte en minuscules
        texte = texte.inférieur()
        # ajout à data_list
        liste_données.append(texte)
Sac de mots
Comme nous le savons tous, pas seulement la fonction de sortie, mais aussi la fonction d'entrée doit être numériquement. Ensuite, nous convertissons le texte sous forme numérique en créant un modèle de sac de mots à l'aide de CountVectorizer.
de sklearn.feature_extraction.text importer CountVectorizer
cv = CountVectorizer()
X = cv.fit_transform(liste_données).faire un tableau()
X.forme # (10337, 39419)
Division des essais de train
Nous prétraitons notre variable d'entrée et de sortie. El siguiente paso es crear el conjunto de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines...., pour entraîner le modèle et l'ensemble de test, pour évaluer l'ensemble de test. Pour ce processus, nous utilisons une division de test de train.
de sklearn.model_selection importer train_test_split
x_train, x_test, y_train, y_test = train_test_split(X, Oui, taille_test = 0.20)
Entraînement et prédiction du modèle
Et nous y sommes presque, la partie création du modèle. Nous utilisons l'algorithme naive_bayes pour la création de notre modèle. Plus tard, nous entraînons le modèle à l'aide de l'ensemble d'apprentissage.
depuis sklearn.naive_bayes importer MultinomialNB
modèle = MultinomialNB()
model.fit(x_train, y_train)
Pour cela, nous avons entraîné notre modèle avec l'ensemble d'entraînement. Maintenant, nous allons prédire la sortie de l'ensemble de test.
y_pred = model.predict(x_test)
Évaluation du modèle
Nous pouvons maintenant évaluer notre modèle
de sklearn.metrics importer precision_score, confusion_matrice, classement_rapport
ac = précision_score(y_test, y_pred)
cm = confusion_matrice(y_test, y_pred)

imprimer("La précision est :",ca)
# La précision est : 0.9772727272727273
La précision du modèle est 0,97, ce qui est très bien et notre modèle fonctionne bien. Ahora tracemos la matriz de confusión usando el carte de chaleurUn "carte de chaleur" est une représentation graphique qui utilise des couleurs pour montrer la densité des données dans une zone spécifique. Couramment utilisé dans l’analyse de données, Etudes marketing et comportementales, Ce type de visualisation vous permet d’identifier rapidement les modèles et les tendances. Par des variations chromatiques, Les cartes thermiques facilitent l’interprétation de grands volumes d’informations, aider à prendre des décisions éclairées.... de seaborn.
plt.figure(taille de la figue=(15,10))
sns.heatmap(cm, annot = vrai)
plt.show()
Le graphique ressemblera à ceci:
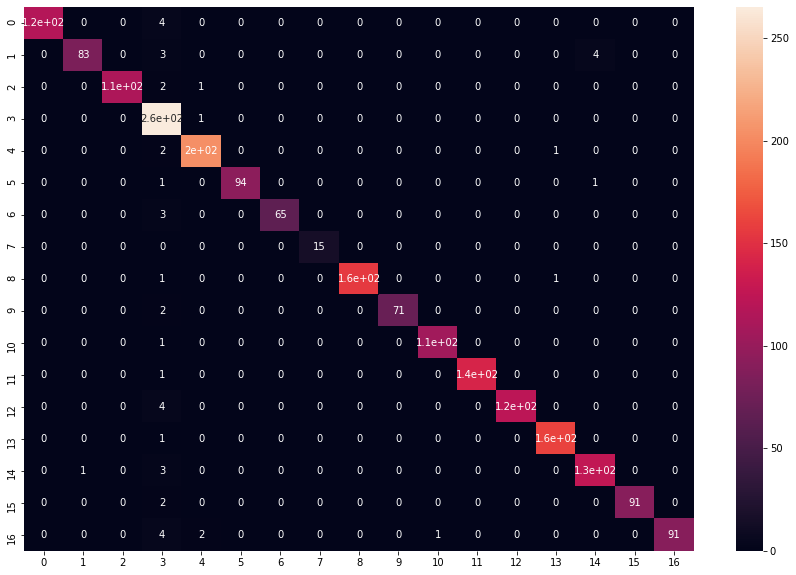
En analysant chaque langue, presque toutes les prédictions sont correctes. Et si !! tu es presque là !!
Prédire avec plus de données
Testons maintenant la prédiction du modèle en utilisant du texte dans différentes langues.
def prédire(texte):
     x = cv.transformer([texte]).faire un tableau() # conversion de texte en modèle de sac de mots (Vecteur)
     lang = model.predict(X) # prédire la langue
     lang = le.inverse_transform(langue) # trouver la langue correspondant à la valeur prédite
     imprimer("La langue est en",langue[0]) # impression de la langue
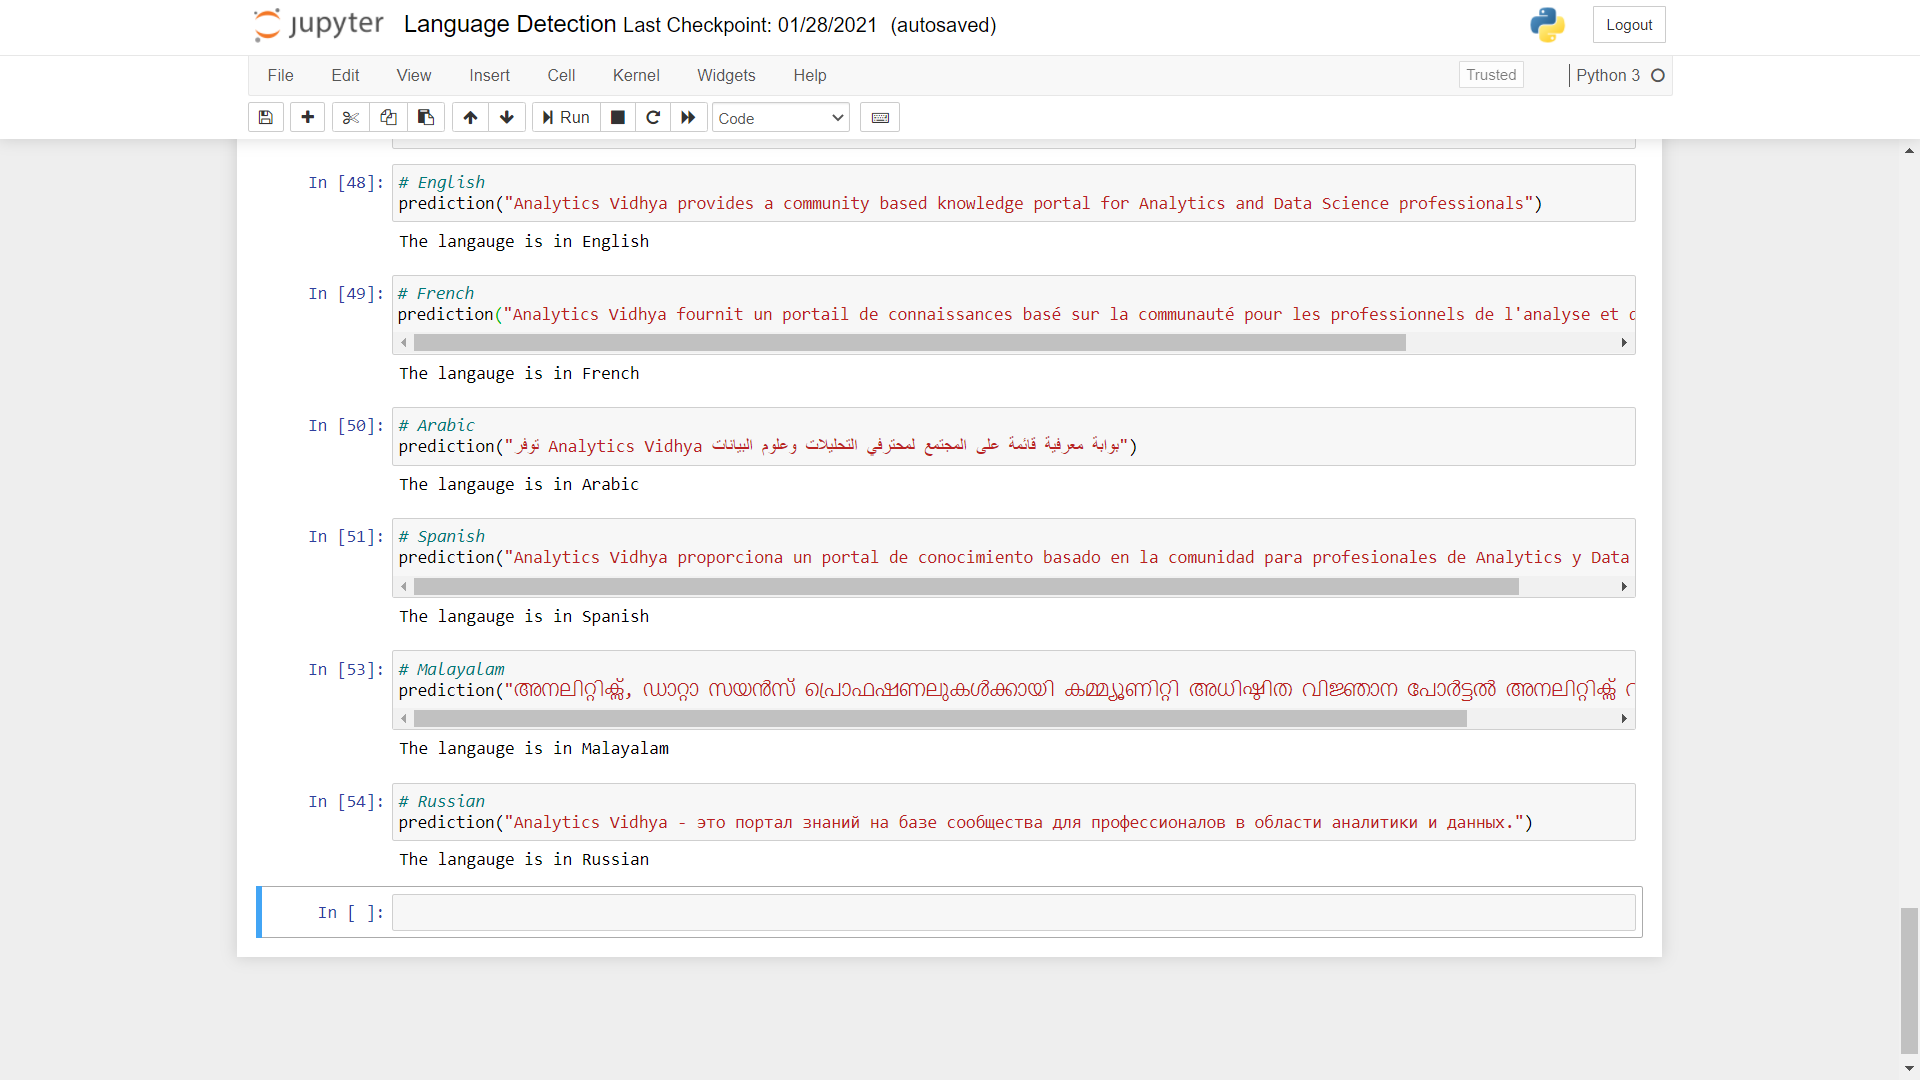
Comme tu peux le voir, les prédictions faites par le modèle sont très précises. Vous pouvez passer le test en utilisant d'autres langues différentes.
Code complet
importer des pandas au format pd
importer numpy en tant que np
importation re
importer seaborn comme sns
importer matplotlib.pyplot en tant que plt
avertissements d'importation
avertissements.simplefilter("ignorer")
# Chargement du jeu de données
données = pd.read_csv("Détection de langue.csv")
# nombre de valeurs pour chaque langue
Les données["Langue"].value_counts()
# séparer les caractéristiques indépendantes et dépendantes
X = données["Texte"]
y = données["Langue"]
# conversion de variables catégorielles en variables numériques
de sklearn.preprocessing importer LabelEncoder
le = LabelEncoder()
y = le.fit_transform(Oui)
# créer une liste pour ajouter le texte prétraité
liste_données = []
# itérer dans tout le texte
pour le texte en X:
    # supprimer les symboles et les chiffres
    texte = re.sub(r'[[email protégé]#$(),m"%^*?:;~`0-9]', ' ', texte)
    texte = re.sub(r'[[]]', ' ', texte)
    # convertir le texte en minuscules
    texte = texte.inférieur()
    # ajout à data_list
    liste_données.append(texte)
# créer un sac de mots à l'aide de countvectorizer
de sklearn.feature_extraction.text importer CountVectorizer
cv = CountVectorizer()
X = cv.fit_transform(liste_données).faire un tableau()
#fractionnement de test de train
de sklearn.model_selection importer train_test_split
x_train, x_test, y_train, y_test = train_test_split(X, Oui, taille_test = 0.20)
#création et prédiction de modèles
depuis sklearn.naive_bayes importer MultinomialNB
modèle = MultinomialNB()
model.fit(x_train, y_train)
# prédiction
y_pred = model.predict(x_test)
# évaluation du modèle
de sklearn.metrics importer precision_score, confusion_matrice
ac = précision_score(y_test, y_pred)
cm = confusion_matrice(y_test, y_pred)
# visualiser la matrice de confusion
plt.figure(taille de la figue=(15,10))
sns.heatmap(cm, annot = vrai)
plt.show()
# fonction de prédiction du langage
def prédire(texte):
    x = cv.transformer([texte]).faire un tableau()
    lang = model.predict(X)
    lang = le.inverse_transform(langue)
    imprimer("La langue est en",langue[0])
# Anglais
prédiction("DataPeaker fournit un portail de connaissances communautaire pour les professionnels de l'analytique et de la science des données")
# français
prédiction("DataPeaker fournit un portail de connaissances basé sur la communauté pour les professionnels de l'analyse et de la science des données")
# arabe
prédiction("DataPeaker fournit un portail de connaissances communautaire pour les professionnels de l'analyse et de la science des données")
# Espanol
prédiction("DataPeaker fournit un portail de connaissances communautaire pour les professionnels de l'analyse et de la science des données.")
# malayalam
prédiction("Analytique, Le portail de connaissances communautaire fournit une technologie d'analyse pour les professionnels de la science des données")
# russe
prédiction("DataPeaker - est un portail de connaissances communautaire pour les professionnels de l'analyse et des données.")
conclusion
C'était un projet intéressant., vérité? J'espère que vous avez eu une intuition sur la façon dont ces projets sont résolus. Cela vous aurait certainement donné un schéma des programmes de PNL de base.. Vous devez analyser les données et les prétraiter en conséquence. Un modèle de sac de mots devient un moyen de représenter vos données textuelles. L'extraction de texte et la vectorisation sont des étapes importantes pour faire de bonnes prédictions en PNL. Naive Bayes s'avère toujours être un meilleur modèle dans de tels problèmes de classification de texte, donc nous obtenons des résultats plus précis.
Vous pouvez également trouver le projet complet du début à la fin pour le modèle de détection de langue ci-dessus dans mon Github
Merci de l'intérêt que vous portez au projet., J'espère que vous continuerez avec des projets plus étonnants et que vous vous familiariserez avec des énoncés de problèmes réels. N'hésitez pas à me contacter sur LinkedIn.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





