
Vue d'ensemble
- introduction
- réduire le temps d'exécution
- base de données
- lecture du jeu de données
- gestion des variables catégorielles
- caractéristique dépendante et indépendante
- entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... de modelos con núcleos de CPU
- Note finale
introduction
« Les 65.536 les processeurs étaient à l'intérieur de la machine de connexion »
~ Philippe Emeagwali
Nous avons tous une formation en informatique, nous utilisons un ordinateur quotidiennement et avons une meilleure compréhension de ce qu'est l'ordinateur. Les ordinateurs ont un cœur comme les humains, ça s'appelle CPU.
Nous connaissons tous le processeur, si ce n'est pas comme ça, les CUP est l'unité centrale de traitement de l'ordinateur, ou s'agit-il d'un circuit électronique qui exécute les différentes instructions qui composent un programme informatique. Le CPU effectue des calculs de base, logique, etc.
Les générations précédentes de processeurs étaient implémentées sous forme de composants discrets et de nombreux petits circuits intégrés sur une ou plusieurs cartes de circuits imprimés. Avec le temps, Les processeurs sont modifiés, Sont mis à jour. Ils sont implémentés dans un circuit intégré, avec un ou plusieurs processeurs sur une seule puce IC. L'ordinateur effectue de nombreuses fonctions ou opérations, donc ça prend beaucoup de temps, pour cela, le scientifique a conçu le processeurs multicœurs, c'était une combinaison de puces de microprocesseur avec plusieurs processeurs.
Les processeurs multicœurs sont très rapides, peut travailler dans un certain temps. En tant que data scientist, nous avons constaté que certaines des bibliothèques python sont très lentes et longues, ralentir l'exécution du programme, se necesita mucho tiempo para la ejecución de nuestros modelos de aprendizaje automático o l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé.... Si vous voulez voir combien de cœurs sont dans votre ordinateur, il suffit d'ouvrir votre PanneauUn panel est un groupe d’experts qui se réunit pour discuter et analyser un sujet spécifique. Ces forums sont courants lors des conférences, Séminaires et débats publics, où les participants partagent leurs connaissances et leurs points de vue. Les panneaux peuvent aborder une variété de domaines, De la science à la politique, et son objectif est d’encourager l’échange d’idées et la réflexion critique entre les participants.... Contrôle et recherche système vous verrez toutes les informations sur votre ordinateur.
Si nous parlons de la bibliothèque python panda qui est utilisée dans l'apprentissage automatique pour la manipulation et l'analyse de données, si nous analysons une petite quantité de données, il ne faudra pas si longtemps pour effectuer les opérations, mais que faire si notre ensemble de données est volumineux? sans le savoir, il faudra beaucoup de temps pour effectuer des calculs sur une grande quantité de données. Ensuite, C'est un gros problème, auxquels tous les data scientists sont confrontés dans leur carrière. Et si on réduisait ce temps? c'est bénéfique pour nous?
nous discuterons ci-dessous:
Réduire le temps d'exécution
Ci-dessus, nous avons une brève discussion sur le processeur, ensuite, Que signifie? Significa que usamos núcleos de la unidad central de procesamiento para entrenar nuestro modelo de aprendizaje automático.Hay uno de los paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... especiales dentro del algoritmo de aprendizaje automático que normalmente lo usamos, mais nous n'avons aucune connaissance à ce sujet ou non. je connais le sens exact de ça, Cela semble incroyable!
Ces cœurs de processeur sont des éléments très importants de la formation de tout modèle d'apprentissage automatique., ceci est également important lorsque vous travaillez avec un apprentissage en profondeur, car ces cœurs CPU seront possibles en programmation parallèle ou en exécution parallèle du programme. Nous ne pouvons pas former des modèles de machine learning à l'aide de GPU, donc, Les processeurs sont plus utiles dans cette condition.
Pour une formation en machine learning plus rapide sur tout projet de machine learning, vous pouvez utiliser ces cœurs de processeur tant que vous disposez d'une grande quantité de données dans l'ensemble de données pour entraîner le modèle d'apprentissage automatique.
À présent, nous voyons comment nous formons le modèle d'apprentissage automatique à l'aide de cœurs de processeur pour améliorer les performances par rapport au modèle d'apprentissage automatique:
Base de données
Pour entraîner cet énoncé de problème particulier, nous devons prendre le Vin_Qualité base de données, le lien de référence pour cet ensemble de données est ici.
Pour mieux comprendre cet ensemble de données, tu peux vérifier ce lien: Cliquez ici
N'oubliez pas si vous devez résoudre ce problème particulier avec les cœurs de processeur, vous devez donc avoir un jeu de données simple avec une grande taille de données.
La raison derrière l'utilisation de cet ensemble de données est qu'il s'agit d'un ensemble de données simple avec une grande taille de données présente dans cet ensemble de données..
Voyons quelle est la taille de ces données:
Lire l'ensemble de données
En premier lieu, nous devons lire l'ensemble de données sur la qualité du vin à l'aide de pandas.
#importer des pandas
df = pd.read_csv('wine_quality.csv')
df.head()

df.forme()

Après avoir exécuté ce code, pouvez-vous voir que nous avons 6497 Lignes Oui 13 Colonnes dans l'ensemble de données sur la qualité du vin.
À présent, nous vérifions les catégories uniques qui sont présentes dans un qualité variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes....,
points_uniques = df['quality'].unique()
points_uniques

Comme on le voit, il y a 6, 5, 7, 8, 4, 3, 9 points de données uniques dans la variable de qualité, où ces points de données sont les mesures de la qualité du vin.
Les variables catégorielles de Haendel
# vars catégoriques
next_df = pd.get_dummies(nouveau_df,drop_first=Vrai)
# afficher la nouvelle trame de données
suivant_df

Caractéristique dépendante et indépendante
Pour appliquer le modèle d'apprentissage automatique, nous devons diviser les caractéristiques dépendantes et indépendantes:
# fonctions indépendantes
x= next_df.drop(['quality','best quality'],axe=1)
# fonction dépendante
y= next_df['best quality']
Entraînement de modèle avec des cœurs de processeur
Venir à l'exécution maintenant, nous le faisons en appliquant quelques étapes:
Paso 1: Utilisation de l'algorithme d'apprentissage automatique RandomForestClassifier.
Paso 2: Utilisation de RepeatedStratifiedKFold pour la validation croisée.
Paso 3: Entraîner le modèle à l'aide du score de validation croisée.
Quand nous initialisons toutes ces choses, le temps sera calculé en fonction de ce score de validation croisée. Avant de vérifier l'heure, nous importons les modules requis:
Importation de modules:
à partir du moment de l'importation
# importation RepeatedStratifiedKFold
à partir de sklearn.model_selection import RepeatedStratifiedKFold
de sklearn.ensemble importer RandomForestClassifier
à partir de sklearn.model_selection importer cross_val_score
# importation RandomForestClassifier
À présent, nous vérifions l'heure en utilisant les différents cœurs du processeur:
Ici, nous utilisons l'algorithme d'apprentissage automatique RandomForestClassifie, lorsque vous vérifiez les paramètres de RandomForestClassifier, vous trouvez qu'il y a un n_emplois paramètre.

n_emplois c'est le paramètre qui vous aidera vraiment à assigner le nombre de cœurs qu'un entraînement système particulier devrait prendre.
Par exemple, si on veut prendre n_emplois = 1 alors prendra 1 noyau CPU, oui prends 2, ça prendra 2 Cœurs de processeur, et ainsi de suite. Lorsque vous souhaitez utiliser tous les cœurs de processeur pour l'entraînement et que vous ne savez pas combien de cœurs se trouvent dans le système, il suffit d'utiliser n_emplois = -1.
1 Cœurs de processeur:
## Cœurs de processeur que nous utilisons n_jobs
aléatoire = RandomForestClassifier(n_estimateurs = 100)
# création d'un objet de RepeatedStratifiedKFold
cv = RépétéStratifiéKFold(n_splits=5, n_répétitions=3, état_aléatoire=4)
# heure de début d'exécution
start_time=heure()
n_scores = cross_val_score(Aléatoire,X,Oui,scoring='accuracy', cv=cv, n_emplois=1)
# heure de fin d'exécution
end_time=heure()
final_time = end_time-start_time
# afficher le temps d'exécution
imprimer('final execution time is : {}'.format(heure_finale))

On voit ici qu'avec 1 noyau sont nécessaires autour 10 secondes pour courir, et c'est un temps énorme.
Nous n'écrivons pas le n_emplois à l'intérieur du RandomForestClassifier à la place, nous l'écrivons dans le cross_val_score car cela nous aide à effectuer une validation croisée à l'aide de RepeatedStratifiedKFold
À présent, nous utilisons ce même code avec un peu de changement pour plus de cœurs:
2 Cœurs de processeur:
## Cœurs de processeur que nous utilisons n_jobs
aléatoire = RandomForestClassifier(n_estimateurs = 100)
# création d'un objet de RepeatedStratifiedKFold
cv = RépétéStratifiéKFold(n_splits=5, n_répétitions=3, état_aléatoire=4)
# heure de début d'exécution
start_time=heure()
n_scores = cross_val_score(Aléatoire,X,Oui,scoring='accuracy', cv=cv, n_emplois=2) # 2 noyaux
# heure de fin d'exécution
end_time=heure()
final_time = end_time-start_time
# afficher le temps d'exécution
imprimer('final execution time is : {}'.format(heure_finale))

Oui, ici vous pouvez voir que quelle est la différence entre 1 noyau et 2 noyaux, le temps d'exécution est très différent de 1 coeur.
3 Cœurs de processeur:
## Cœurs de processeur que nous utilisons n_jobs
aléatoire = RandomForestClassifier(n_estimateurs = 100)
# création d'un objet de RepeatedStratifiedKFold
cv = RépétéStratifiéKFold(n_splits=5, n_répétitions=3, état_aléatoire=4)
# heure de début d'exécution
start_time=heure()
n_scores = cross_val_score(Aléatoire,X,Oui,scoring='accuracy', cv=cv, n_emplois=3)   # 3 noyaux
# heure de fin d'exécution
end_time=heure()
final_time = end_time-start_time
# afficher le temps d'exécution
imprimer('final execution time is : {}'.format(heure_finale))

Prenez tous les noyaux:
## Cœurs de processeur que nous utilisons n_jobs
aléatoire = RandomForestClassifier(n_estimateurs = 100)
# création d'un objet de RepeatedStratifiedKFold
cv = RépétéStratifiéKFold(n_splits=5, n_répétitions=3, état_aléatoire=4)
# heure de début d'exécution
start_time=heure()
n_scores = cross_val_score(Aléatoire,X,Oui,scoring='accuracy', cv=cv, n_emplois= -1) # tous les noyaux
# heure de fin d'exécution
end_time=heure()
final_time = end_time-start_time
# afficher le temps d'exécution
imprimer('final execution time is : {}'.format(heure_finale))

Comparaison de synchronisation de base:
## Cœurs de processeur que nous utilisons n_jobs
pour le noyau dans [1,2,3,4,5,6,7,8,9,10]:
    aléatoire = RandomForestClassifier(n_estimateurs = 100)
    # création d'un objet de RepeatedStratifiedKFold
    cv = RépétéStratifiéKFold(n_splits=5, n_répétitions=3, état_aléatoire=4)
    # heure de début d'exécution
    start_time=heure()
    n_scores = cross_val_score(Aléatoire,X,Oui,scoring='accuracy', cv=cv, n_jobs = noyau)
    # heure de fin d'exécution
    end_time=heure()
    final_time = end_time-start_time
    # afficher le temps d'exécution
    imprimer('final execution time of core {} est : {}'.format(coeur,heure_finale))
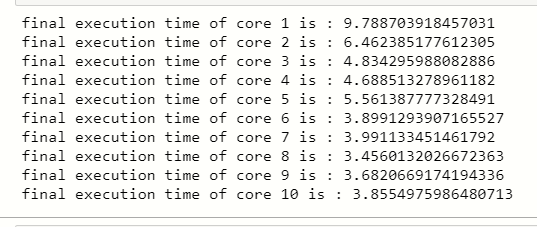
Vous pouvez voir qu'il y a une grande différence lorsque nous utilisons 1 core pour former notre modèle ML et 10 noyaux pour la formation du modèle ML.
Remarques finales
Salut, dans cet article, vous avez appris la formation de modèles ML à l'aide de cœurs de processeur, il est maintenant temps d'implémenter cette technique dans votre modèle d'apprentissage automatique pour réduire le temps d'exécution.
J'espère que cet article vous plaira., Partage-le avec tes amis.
Vous pouvez me joindre sur LinkedIn: www.linkedin.com/in/mayur-badole-189221199
Découvrez mes autres articles: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Merci.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





