
Cibler
- Le boosting est une technique d'apprentissage conjoint dans laquelle chaque modèle essaie de corriger les erreurs du modèle précédent.
- Apprenez l'algorithme de boosting penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... et les mathématiques derrière lui.
introduction
Dans cet article, nous allons discuter d'un algorithme qui fonctionne dans la technique d'impulsion, l'algorithme d'augmentation de gradient. Il est mieux connu sous le nom de Gradient Boosting Machine ou GBM.
Noter: Si vous êtes plus intéressé par l'apprentissage de concepts dans un format audiovisuel, nous avons cet article complet expliqué dans la vidéo ci-dessous. Si ce n'est pas comme ça, tu peux continuer à lire.
Les modèles de Gradient Boosting Machine sont construits de manière séquentielle et chacun de ces modèles ultérieurs essaie de réduire l'erreur du modèle précédent.. Mais la question est de savoir comment chaque modèle réduit l'erreur du modèle précédent? Cela se fait en construisant le nouveau modèle sur les erreurs ou les résidus des prédictions précédentes.
Ceci est fait pour déterminer s'il existe des modèles dans l'erreur que le modèle précédent ignore. Comprenons cela avec un exemple.
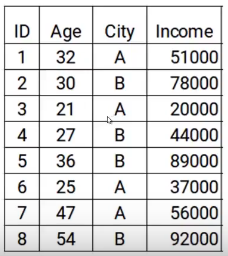
Ici, nous avons les données avec deux caractéristiques: âge et ville, et la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... l'objectif est la prédiction. Ensuite, selon la ville et l'âge de la personne, il faut prévoir les revenus. Notez que tout au long du processus de gradient croissant, nous mettrons à jour ce qui suit: l'objectif du modèle, le résidu du modèle et la prédiction.
Étapes pour construire le modèle de machine d'augmentation de gradient
Pour simplifier la compréhension de la machine d'augmentation de gradient, nous avons divisé le processus en cinq étapes simples.
Paso 1
La première étape consiste à construire un modèle et à faire des prédictions sur les données données.. Revenons à nos données, pour le premier modèle, l'objectif sera la valeur de revenu donnée dans les données. Ensuite, J'ai défini la cible comme valeurs de revenu d'origine.
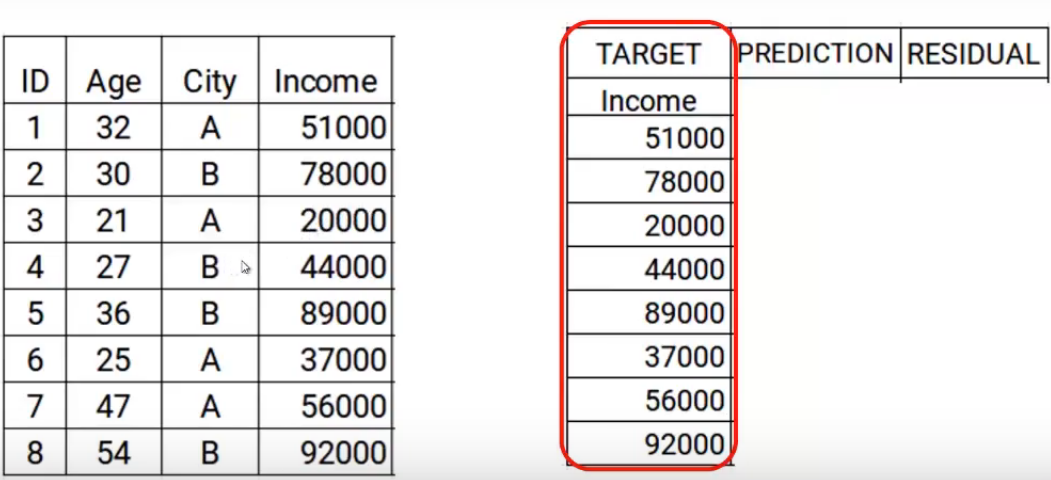
Nous allons maintenant construire le modèle en utilisant les caractéristiques de l'âge et de la ville avec le revenu cible. Ce modèle entraîné sera capable de générer un ensemble de prédictions. Qui sont supposés comme suit.
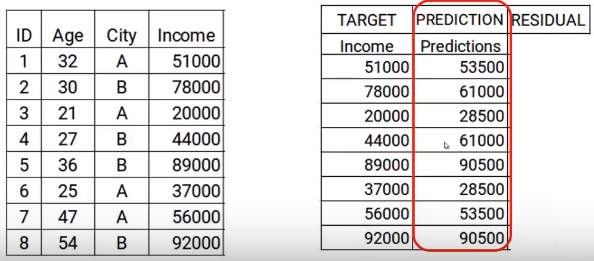
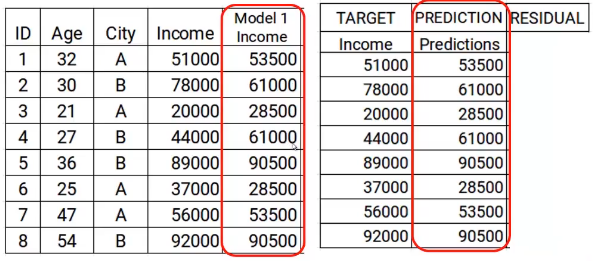
Maintenant, je vais stocker ces prédictions avec mes données. C'est là que je termine la première étape.
Paso 2
L'étape suivante consiste à utiliser ces prédictions pour obtenir l'erreur, à utiliser plus tard comme cible. Pour le moment nous avons les valeurs du revenu réel et les prédictions du modèle1. Utilisation de ces colonnes, nous calculerons l'erreur simplement en soustrayant les revenus réels et les prévisions de revenus. A est montré ci-dessous.
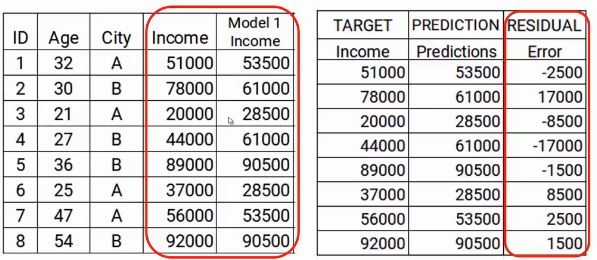
Comme nous l'avons mentionné précédemment, les modèles successifs se concentrent sur l'erreur. Ensuite, les erreurs ici seront notre nouvel objectif. Cela couvre la deuxième étape.
Paso 3
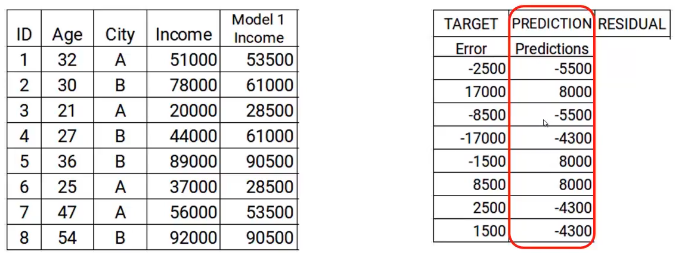
A l'étape suivante, nous allons créer un modèle sur ces erreurs et faire les prédictions. Ici, l'idée est de déterminer s'il y a des motifs cachés dans l'erreur.
Ensuite, en utilisant l'erreur comme cible et les caractéristiques d'origine Age et Ville, nous allons générer de nouvelles prédictions. Notez que les prédictions, dans ce cas, seront les valeurs d'erreur, valeurs de revenus non attendues, puisque notre objectif est l'erreur. Disons que le modèle donne les prédictions suivantes
Paso 4
Maintenant, nous devons mettre à jour les prédictions de model1. Nous allons ajouter la prédiction de l'étape précédente et l'ajouter à la prédiction de model1 et l'appeler Model2 Income.
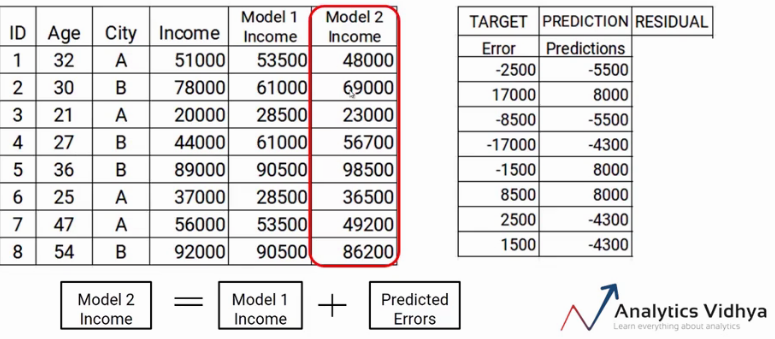
Comme tu peux le voir, mes nouvelles prédictions sont plus proches des vraies valeurs de mes revenus.
Finalement, nous allons répéter les étapes 2 une 4, ce qui signifie que nous allons calculer de nouvelles erreurs et définir cette nouvelle erreur comme cible. Nous répéterons ce processus jusqu'à ce que l'erreur soit nulle ou que nous ayons atteint le critère d'arrêt, qui dit le nombre de modèles que nous voulons construire. C'est le processus étape par étape de la construction d'un modèle d'augmentation de gradient..
En peu de mots, nous construisons notre premier modèle qui a les caractéristiques x et l'objectif y, Appelons ce modèle H0 qui est fonction de x et y. Puis on construit le modèle suivant sur les erreurs du dernier modèle et un troisième modèle sur les erreurs du modèle précédent et ainsi de suite. Jusqu'à ce que nous construisions n modèles.
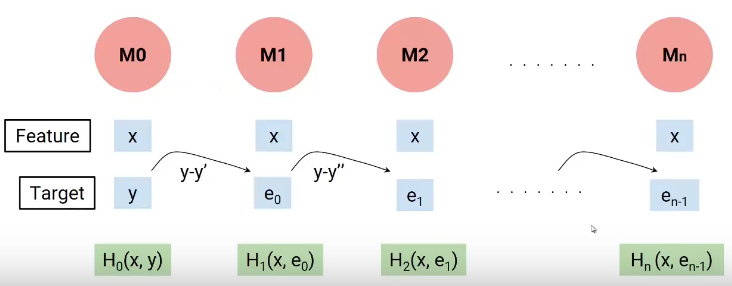
Chaque modèle successif travaille sur les erreurs de tous les modèles précédents pour essayer d'identifier les modèles d'erreur.. effectivement, Je peux dire que chacun de ces modèles sont des fonctions individuelles qui ont la variable indépendante x comme caractéristique et l'objectif est l'erreur du modèle combiné précédent.
Ensuite, pour déterminer l'équation finale de notre modèle, nous construisons notre premier modèle H0, ce qui m'a donné des prédictions et généré des erreurs. Appelons ce résultat combiné F0 (X).
Nous créons maintenant notre deuxième modèle et ajoutons de nouvelles erreurs prédites à F0 (X), cette nouvelle fonction sera F1 (X). de la même manière, nous allons construire le modèle suivant et ainsi de suite, jusqu'à ce que nous ayons n modèles comme indiqué ci-dessous.
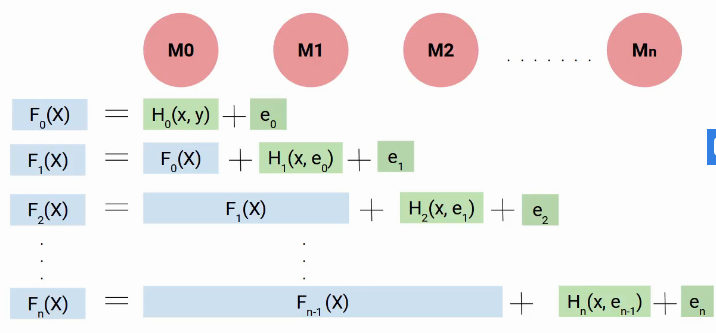
Ensuite, à chaque étape, nous essayons de modéliser les erreurs, ce qui nous aide à réduire l'erreur globale. Idéalement, nous voulons que cela soit ‘dans’ être nul. Comme tu peux le voir, chaque modèle ici essaie d'augmenter les performances du modèle, donc, on utilise le terme impulsion.
Mais pourquoi utilise-t-on le terme gradient, voici l'astuce. Au lieu d'ajouter directement ces modèles, on les ajoute avec poids ou coefficient, et la valeur correcte de ce coefficient est décidée en utilisant la technique d'augmentation de gradient.
Pourtant, une forme plus généralisée de notre équation sera la suivante.
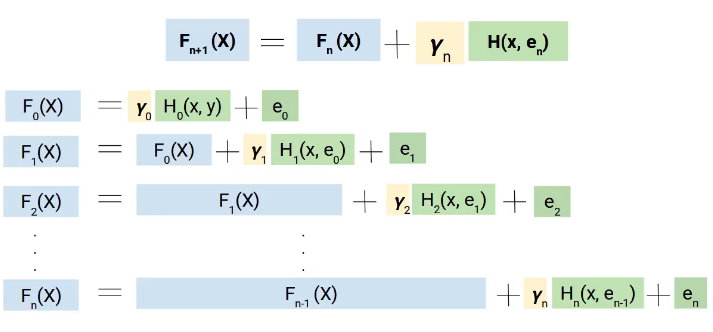
Les mathématiques derrière la Gradient Boosting Machine
J'espère que vous avez maintenant une idée générale du fonctionnement de l'augmentation de gradient. D'ici en avant, nous allons nous concentrer sur la façon dont la valeur de Yn est calculée.
Nous utiliserons la technique de descente de gradient pour obtenir les valeurs de ces coefficients gamma (Oui), de manière à minimiser le Fonction de perteLa fonction de perte est un outil fondamental de l’apprentissage automatique qui quantifie l’écart entre les prédictions du modèle et les valeurs réelles. Son but est de guider le processus de formation en minimisant cette différence, permettant ainsi au modèle d’apprendre plus efficacement. Il existe différents types de fonctions de perte, tels que l’erreur quadratique moyenne et l’entropie croisée, chacun adapté à différentes tâches et.... Plongeons maintenant dans cette équation et comprenons le rôle de la fonction de perte et du gamma.
Ici, la fonction de perte que nous utilisons est (y-y ‘) 2. y est la valeur réelle et y ‘est la valeur finale prédite par le dernier modèle. Ensuite, nous pouvons remplacer y ‘par Fn (X) qui représente la cible réelle moins les prévisions mises à jour de tous les modèles que nous avons construits jusqu'à présent.
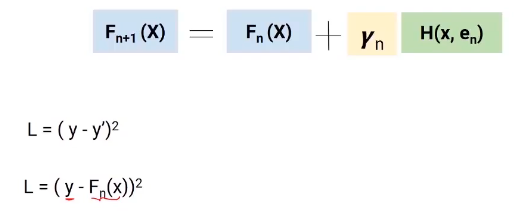
Différenciation partielle
Je pense que vous connaissez le processus de descente de gradient, puisque nous allons utiliser le même concept. On va différencier l'équation de L par rapport à Fn (X), vous obtiendrez l'équation suivante, qui est également connu sous le nom de pseudo résiduel. Quel est le gradient négatif de la fonction de perte.
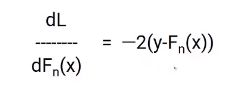
Pour simplifier cela, nous multiplierons les deux côtés par -1. Le résultat sera quelque chose comme ça.
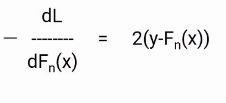
À présent, nous savons que l'erreur dans notre équation pour Fn + 1 (X) est la valeur réelle moins les prévisions mises à jour de tous les modèles. Donc, nous pouvons remplacer le en dans notre équation finale par ces pseudo résidus comme indiqué dans l'image ci-dessous.
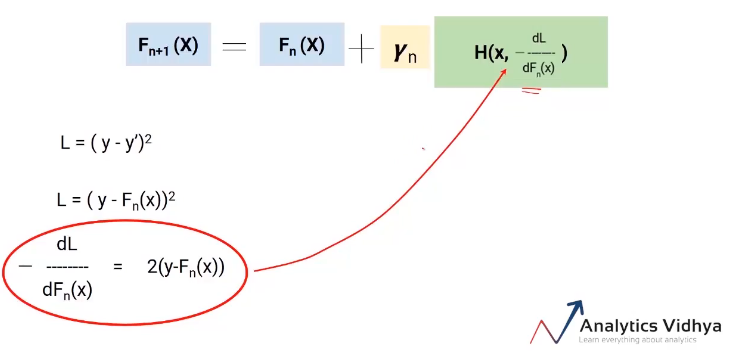
C'est donc notre équation finale. La meilleure partie de cet algorithme est qu'il vous donne la liberté de décider de la fonction de perte. La seule condition est que la fonction de perte soit dérivable. Pour faciliter la compréhension, nous utilisons une fonction de perte très simple (y-y ‘) 2 mais vous pouvez le changer en perte de charnière ou perte de logit ou autre.
L'objectif est de minimiser la perte totale. Voyons quelle serait la perte totale ici, sera la perte du modèle n plus la perte du modèle actuel que nous construisons. Voici l'équation.
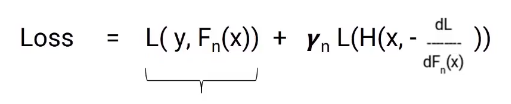
Dans cette équation, la première partie est fixe, mais la deuxième partie est la perte du modèle sur lequel nous travaillons actuellement. La perte de ce modèle ne peut toujours pas être changée, mais on peut changer la valeur de gamma. Maintenant, nous devons sélectionner la valeur gamma pour que la perte totale soit minimisée et cette valeur soit sélectionnée par le processus de descente de gradient.
Ensuite, l'idée est de réduire la perte globale en décidant de la valeur gamma optimale pour chaque modèle que nous construisons.
Arbre de décision d'augmentation de gradient
Je parle d'un cas particulier d'augmentation de gradient, c'est-à-dire, arbre de décision de grossissement de gradient (GBDT). Ici, chaque modèle serait un arbre et la valeur gamma sera décidée à chaque niveau de feuille, pas au niveau général du modèle. Ensuite, comme le montre l'image suivante, chaque feuille aurait une valeur gamma.
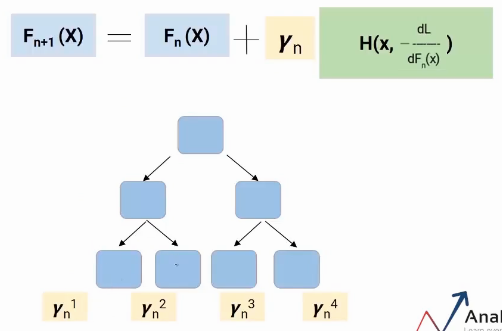
Voici comment fonctionne l'arbre de décision d'amplification de gradient.
Remarques finales
Le boosting est un type d'apprentissage commun. C'est un processus séquentiel où chaque modèle essaie de corriger les erreurs du modèle précédent. Cela signifie que chaque modèle successif dépend de ses prédécesseurs.. Dans cet article, nous avons vu l'algorithme d'augmentation de gradient et les mathématiques qui le sous-tendent.
Comment on a une idée claire de l'algorithme, essayez de construire les modèles et d'acquérir une expérience pratique avec elle.
Si vous cherchez à commencer votre parcours en science des données et que vous voulez tous les sujets sous un même toit, votre recherche s'arrête ici. Jetez un œil à l'IA et au ML BlackBelt certifiés de DataPeaker Plus Programme
Si vous avez des questions, faites le moi savoir dans la section commentaire!
Si vous avez des questions, faites le moi savoir dans les commentaires ci-dessous.





