
Le défi de faire comprendre du texte aux machines
« La langue est un merveilleux moyen de communication »
Toi et moi aurions compris cette phrase en une fraction de seconde. Mais les machines ne peuvent tout simplement pas traiter les données textuelles sous forme brute. Ils ont besoin de nous pour décomposer le texte dans un format numérique que la machine peut facilement lire (l'idée derrière Traitement du langage naturel!).
C'est là que les concepts de Bag-of-Words entrent en jeu. (Arc) y TF-IDF. BoW et TF-IDF sont des techniques qui nous aident à convertir des phrases de texte en vecteurs numériques.
Je parlerai de Bag-of-Words et de TF-IDF dans cet article. Nous utiliserons un exemple intuitif et général pour comprendre chaque concept en détail.
Nouveau dans le traitement du langage naturel (PNL)? Nous avons les cours parfaits pour vous aider à démarrer:
Prenons un exemple pour comprendre le sac de mots (Arc) y TF-IDF
Je vais prendre un exemple populaire pour expliquer Bag-of-Words (Arc) et TF-DF dans cet article.
Nous aimons tous regarder des films (à des degrés divers). En général, je regarde toujours les critiques d'un film avant de m'engager à le voir.. Je sais que beaucoup d'entre vous font de même! Ensuite, je vais utiliser cet exemple ici.
Voici un échantillon de critiques sur un film d'horreur en particulier:
- Révision 1: ce film est très effrayant et long
- Révision 2: ce film n'est pas effrayant et il est lent
- Révision 3: ce film est effrayant et bon
Vous pouvez voir qu'il y a des critiques contrastées sur le film, ainsi que la durée et le rythme du film. Imaginez-vous en train de regarder des milliers d'avis comme ceux-ci. Clairement, il existe de nombreuses informations intéressantes que nous pouvons extraire et développer pour évaluer la performance du film.
Cependant, comme nous l'avons vu précédemment, nous ne pouvons pas simplement donner ces phrases à un modèle d'apprentissage automatique et lui demander de nous dire si un avis était positif ou négatif. Nous devons effectuer certaines étapes de prétraitement de texte.
Bag-of-Words et TF-IDF sont deux exemples de la façon de procéder. Comprenons en détail.
Créer des vecteurs à partir de texte
Pouvez-vous penser à quelques techniques que nous pourrions utiliser pour vectoriser une phrase au début? Les exigences de base seraient:
- Cela ne devrait pas donner lieu à une matrice clairsemée car les matrices clairsemées entraînent un coût de calcul élevé
- Nous devrions pouvoir retenir la plupart des informations linguistiques présentes dans la phrase.
L'incorporation de mots est l'une de ces techniques dans lesquelles nous pouvons représenter du texte à l'aide de vecteurs. Les formes les plus populaires d'incrustations de mots sont:
- Arc, que signifie sac de mots
- TF-IDF, Que signifie le terme Fréquence-Inverser la fréquence du document
À présent, Voyons comment nous pouvons rendre les critiques de films précédentes sous forme d'incrustations et les préparer pour un modèle d'apprentissage automatique.
Modèle de sac de mots (Arc)
El modelo Sac de mots (Arc) est la façon la plus simple de représenter un texte en nombres. Comme le terme lui-même, nous pouvons représenter une phrase comme un vecteur de sac de mots (une chaîne de nombres).
Rappelez-vous les trois types de critiques de films que nous avons vues plus tôt:
- Révision 1: ce film est très effrayant et long
- Révision 2: ce film n'est pas effrayant et il est lent
- Révision 3: ce film est effrayant et bon
Nous allons d'abord construire un vocabulaire à partir de tous les mots uniques des trois révisions précédentes. Le vocabulaire est composé de ces 11 mots: ‘Ce’, ‘film’, ‘il est’, ‘très’, ‘effrayant’, ‘Oui’, ‘long’, ‘non’, ‘lent’, ‘épouvantable’, ‘bon ‘.
Maintenant, nous pouvons prendre chacun de ces mots et marquer leur apparition dans les trois critiques de films précédentes avec 1 Oui 0. Cela nous donnera 3 vecteurs pour 3 Commentaires:
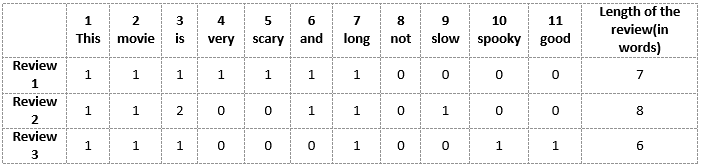
Examiner le vecteur 1: [1 1 1 1 1 1 1 0 0 0 0]
Examiner le vecteur 2: [1 1 2 0 0 1 1 0 1 0 0]
Examiner le vecteur 3: [1 1 1 0 0 0 1 0 0 1 1]
Et c'est l'idée centrale derrière le modèle Bag of Words. (Arc).
Inconvénients de l'utilisation d'un modèle de sac de mots (Arc)
Dans l'exemple ci-dessus, on peut avoir des vecteurs de longueur 11. Cependant, nous commençons à faire face à des problèmes lorsque nous trouvons de nouvelles prières:
- Si les nouvelles phrases contiennent de nouveaux mots, alors la taille de notre vocabulaire augmenterait et, donc, la longueur des vecteurs augmenterait également.
- En outre, les vecteurs contiendraient également de nombreux zéros, ce qui se traduirait par une matrice clairsemée (ce que nous aimerions éviter)
- Nous ne conservons pas d'informations sur la grammaire des phrases ou l'ordre des mots dans le texte.
Terme Fréquence-Fréquence inverse des documents (TF-IDF)
Mettons d'abord une définition formelle autour de TF-IDF. Voici comment Wikipédia le dit:
« La fréquence des termes, la fréquence inverse des documents, est une statistique numérique qui essaie de refléter l'importance d'un mot pour un document dans une collection ou un corpus ».
Fréquence des trimestres (TF)
Commençons par comprendre le terme fréquent (TF). C'est une mesure de la fréquence à laquelle un terme apparaît, t, dans un document, ré:

Ici, au numérateur, n est le nombre de fois où le terme apparaît « t » dans le document « ré ». Donc, chaque document et terme aurait sa propre valeur TF.
Encore une fois, nous utiliserons le même vocabulaire que celui que nous avions construit dans le modèle Bag-of-Words pour montrer comment calculer le TF pour l'examen # 2:
Révision 2: ce film n'est pas effrayant et il est lent
Ici,
- Vocabulaire: ‘Ce’, ‘film’, ‘il est’, ‘très’, ‘terrifiant’, ‘Oui’, ‘long’, ‘non’, ‘lent’, ‘épouvantable’, ‘bon’
- Nombre de mots dans la revue 2 = 8
- TF pour le mot ‘ce’ = (nombre de fois qu'il apparaît ‘ce’ en revue 2) / (nombre de termes dans l'examen 2) = 1/8
Similaire,
- TF (‘film’) = 1/8
- TF (‘il est’) = 2/8 = 1/4
- TF (‘très’) = 0/8 = 0
- TF (‘effrayant’) = 1/8
- TF (‘Oui’) = 1/8
- TF (‘long’) = 0/8 = 0
- TF (‘non’) = 1/8
- TF (‘lent’) = 1/8
- TF (‘épouvantable’) = 0/8 = 0
- TF (‘bon’) = 0/8 = 0
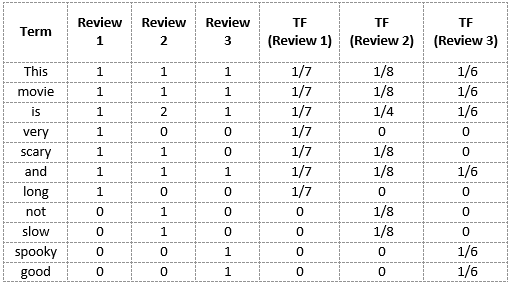
Nous pouvons calculer les fréquences des termes pour tous les termes et toutes les révisions de cette manière:
Inverser la fréquence des documents (Tsahal)
IDF est une mesure de l'importance d'un terme. Nous avons besoin de la valeur IDF car le calcul du TF seul ne suffit pas pour comprendre l'importance des mots:
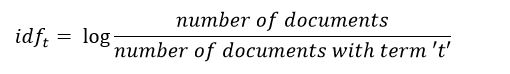
Nous pouvons calculer les valeurs IDF pour tous les mots de la revue 2:
Tsahal (‘ce’) = journal (nombre de documents / nombre de documents contenant le mot ‘ce’) = journal (3/3) = journal (1) = 0
Similaire,
- Tsahal (‘film’,) = journal (3/3) = 0
- Tsahal (‘il est’) = journal (3/3) = 0
- Tsahal (‘non’) = journal (3/1) = journal (3) = 0.48
- Tsahal (‘effrayant’) = journal (3/2) = 0.18
- Tsahal (‘Oui’) = journal (3/3) = 0
- Tsahal (‘lent’) = journal (3/1) = 0.48
Nous pouvons calculer les valeurs IDF pour chaque mot de cette façon. Donc, les valeurs IDF pour l'ensemble du vocabulaire seraient:
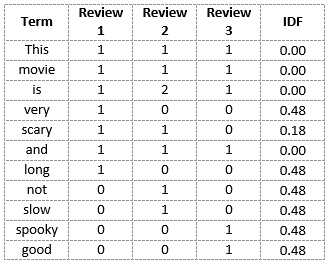
Pourtant, nous voyons que des mots comme "es", "cette", "et", etc., ils sont réduits à 0 et ils ont peu d'importance; tandis que des mots comme "effrayant", "long", "bon", etc. ce sont des mots avec plus d'importance et ont donc une plus grande valeur.
Nous pouvons maintenant calculer le score TF-IDF pour chaque mot du corpus. Les mots avec un score plus élevé sont plus importants et ceux avec un score inférieur sont moins importants:
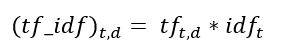
Nous pouvons maintenant calculer le score TF-IDF pour chaque mot de la revue 2:
TF-IDF (‘ce’, Révision 2) = TF (‘ce’, Révision 2) * Tsahal (‘ce’) = 1/8 * 0 = 0
Similaire,
- TF-IDF (‘film’, Révision 2) = 1/8 * 0 = 0
- TF-IDF (‘il est’, Révision 2) = 1/4 * 0 = 0
- TF-IDF (‘non’, Révision 2) = 1/8 * 0.48 = 0.06
- TF-IDF (‘effrayant’, Révision 2) = 1/8 * 0.18 = 0.023
- TF-IDF (‘Oui’, Révision 2) = 1/8 * 0 = 0
- TF-IDF (‘lent’, Révision 2) = 1/8 * 0.48 = 0.06
De la même manière, nous pouvons calculer les scores TF-IDF pour tous les mots par rapport à toutes les critiques:
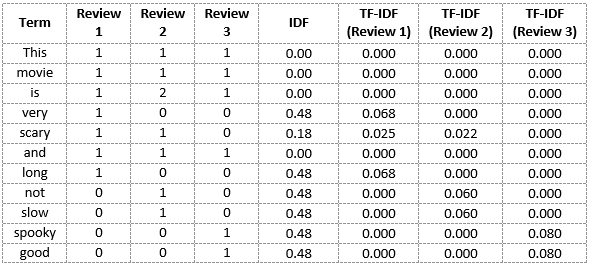
Nous avons maintenant obtenu les scores TF-IDF pour notre vocabulaire. TF-IDF fournit également des valeurs plus élevées pour les mots moins fréquents et est élevé lorsque les valeurs IDF et TF sont élevées, c'est-à-dire, le mot est rare dans tous les documents confondus mais fréquent dans un seul document.
Remarques finales
Permettez-moi de résumer ce que nous avons couvert dans l'article:
- Bag of Words crée simplement un ensemble de vecteurs contenant le nombre d'occurrences de mots dans le document (Commentaires), tandis que le modèle TF-IDF contient également des informations sur les mots les plus importants et les moins importants.
- Les vecteurs de sac de mots sont faciles à interpréter. Cependant, TF-IDF fonctionne généralement mieux dans les modèles d'apprentissage automatique.
Alors que Bag-of-Words et TF-IDF ont tous deux été populaires dans leur propre sens, il y avait encore un écart dans la compréhension du contexte des mots. Détecter la similarité entre les mots ‘épouvantable’ Oui ‘effrayant’, ou traduire nos documents donnés dans une autre langue, nécessite beaucoup plus d'informations dans la doc.
C'est là que les techniques d'intégration de mots comme Word2Vec entrent en jeu., Sac de mots continu (CBOW), Skipgram, etc. Vous pouvez trouver un guide détaillé de ces techniques ici:





