
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
comment réhabiliter les personnes grâce à l'utilisation de données et d'informations pertinentes.
Dans ce projet, prédisons les sentiments des tweets COVID-19. Les données collectées à partir de Tweeter et moi utiliserons l'environnement Python pour mettre en œuvre ce projet.
Approche du probléme
Le défi donné est de construire un modèle de classification pour prédire le sentiment des tweets Covid-19.. Les tweets ont été extraits de Twitter et un marquage manuel a été effectué. Nous recevons des informations telles que l'emplacement, Tuitear fr, Tweet original et Sentimento.
Approche pour analyser divers sentiments
avant de continuer, il est utile de savoir ce que l'on entend par analyse des sentiments. L'analyse des sentiments est le processus d'identification et de catégorisation informatique des opinions exprimées dans un texte, en particulier pour déterminer si l'attitude de l'écrivain envers un sujet particulier est positive, Négatif ou Neutre. (dictionnaire d'Oxford)
Vous trouverez ci-dessous la procédure opératoire standard pour aborder le type de projet d'analyse des sentiments. Nous allons passer par cette procédure pour prédire ce que nous sommes censés prédire !!
-
L'analyse exploratoire des données.
-
Prétraitement des données.
-
Vectorisation.
-
Modèles de classification.
-
Évaluation.
-
conclusion.
Devinons quelques tweets
Je vais lire le tweet et pouvez-vous me dire le sentiment de ce tweet s'il est positif, négatif ou neutre? Donc le premier tweet est « Cela m'étonne toujours de voir combien d'employés du supermarché de #Toronto travaillent sans une sorte de masque. Nous savons tous maintenant que les employés peuvent être asymptomatiques lorsqu'ils transmettent le #coronavirus ". Quelle est votre supposition? Oui, tu as raison. Ceci est un tweet négatif car il contient des mots négatifs comme « Surpris ».
Si vous ne pouvez pas deviner le tweet ci-dessus, ne t'inquiète pas, J'ai un autre tweet pour toi. Devinons ce tweet-« En raison de la situation du Covid-19, nous avons augmenté la demande pour tous les produits alimentaires. Le délai de livraison peut être plus long pour toutes les commandes en ligne, surtout les forfaits congélateur et partage de boeuf. Nous vous remercions de votre patience pendant cette période.". Cette fois, vous avez tout à fait raison de prédire ce tweet comme « Positif ». Des mots comme « Merci », « Plus grande demande » sont de nature optimiste, donc ces mots ont classé le tweet comme positif.
Résumé des données
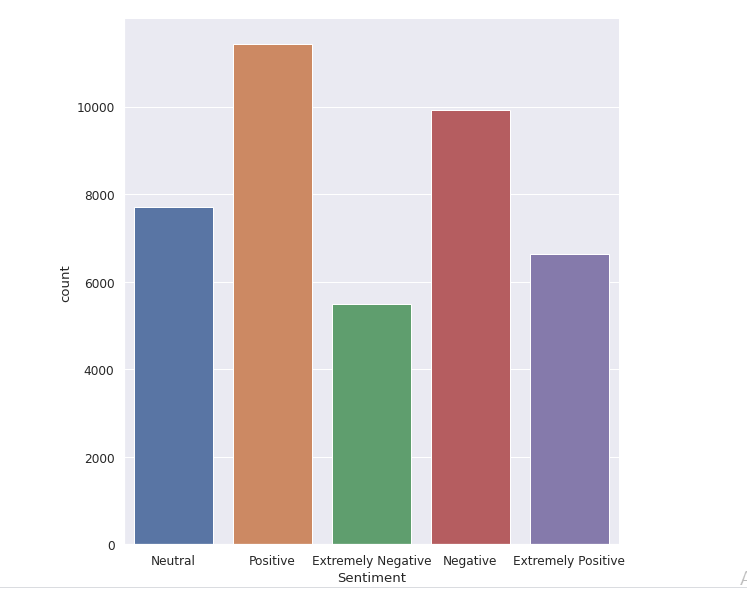
L'ensemble de données d'origine a 6 colonnes et 41157 Lignes. Analyser divers sentiments, nous n'avons besoin que de deux colonnes nommées Original Tweet et Sentiment. Il existe cinq types de sentiments: Extrêmement négatif, négatif, neutre, positif et extrêmement positif comme vous pouvez le voir sur l'image suivante.
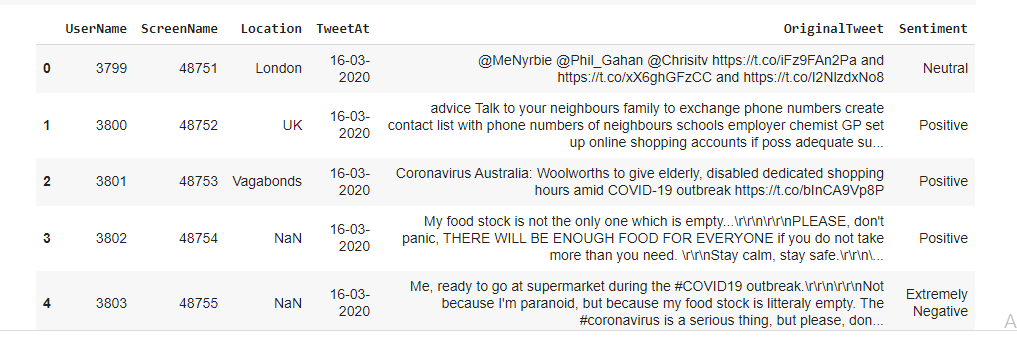
Résumé de l'ensemble de données
Analyse de données exploratoire de base
Des colonnes comme « Nom d'utilisateur » Oui « Nom de l'écran"Ils ne fournissent pas d'informations significatives pour notre analyse. Donc, nous n'utilisons pas ces fonctions pour la construction de modèles. Toutes les données de tweet collectées pour les mois de mars et avril 2020. Le graphique à barres suivant nous montre le nombre de valeurs uniques dans chaque colonne.
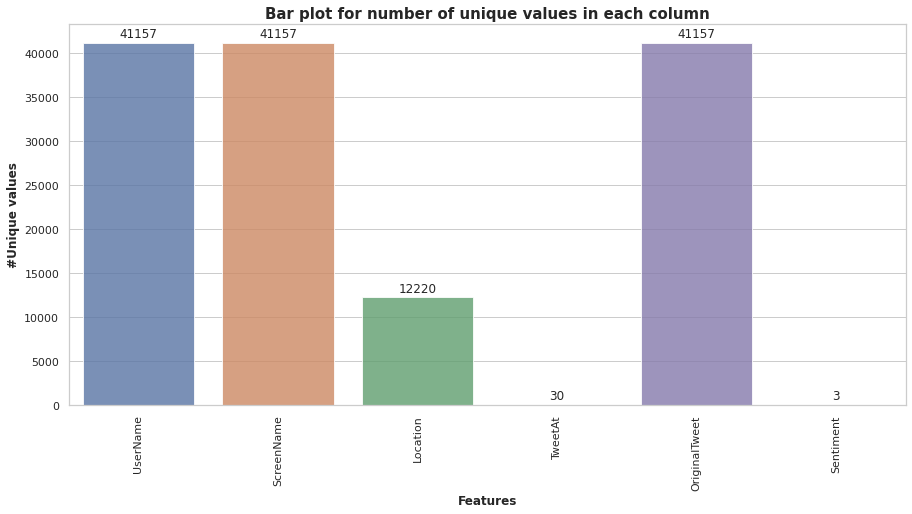
Il y a des valeurs nulles dans la colonne d'emplacement, mais nous n'avons pas besoin de prendre soin d'eux, puisque nous n'utiliserons que deux colonnes, c'est-à-dire, « Sentiment » Oui « Tweet original". La plupart des tweets provenaient du site de Londres (11,7%), como se desprende de la siguiente chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.....
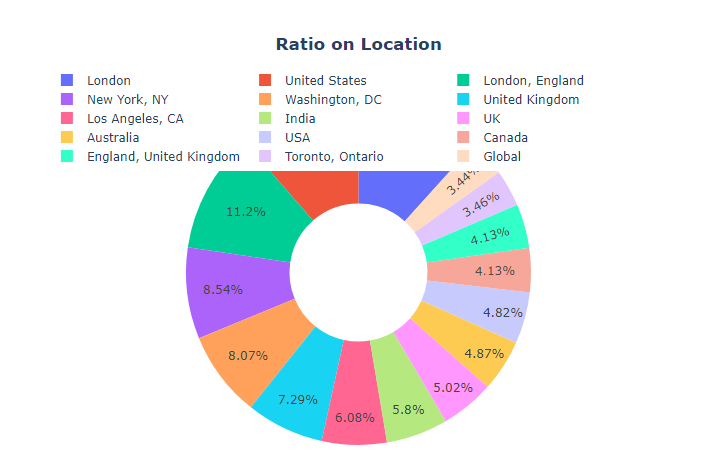
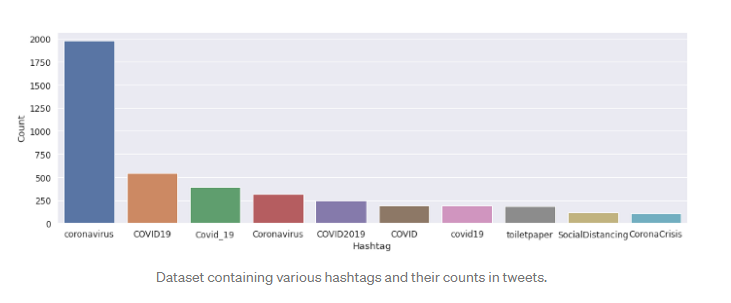
Hay algunas palabras como ‘coronavirus’, ‘tienda de comestibles’, qui ont la fréquence maximale dans notre ensemble de données. Nous pouvons le voir dans le nuage de mots suivant. Il y a plusieurs #hashtags dans la colonne tweet. Mais ils sont presque les mêmes dans tous les sentiments, donc ils ne nous fournissent pas des informations complètes et significatives.
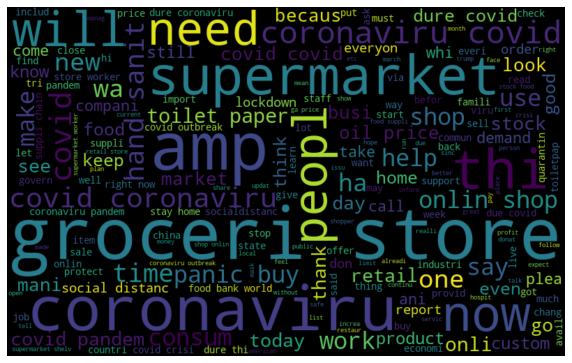
World Cloud affichant les mots qui ont une fréquence maximale dans notre colonne Tweet
Cuando intentamos explorar la columna ‘Sentiment’, nous avons constaté que la plupart des gens ont des sentiments positifs sur divers sujets, ce qui nous montre votre optimisme en période de pandémie. Très peu de gens ont des pensées extrêmement négatives sur Covid-19.
Prétraitement des données
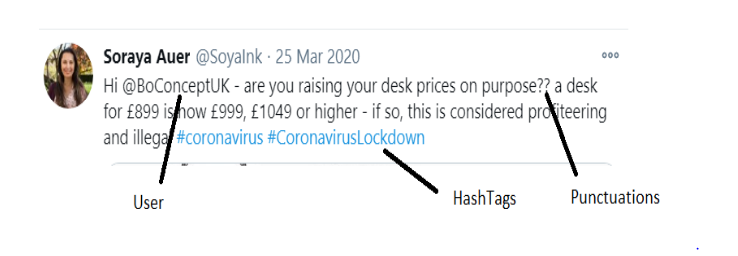
Le prétraitement des données textuelles est une étape essentielle, car il rend le texte brut prêt pour l'extraction. Le but de cette étape est de nettoyer les bruits les moins pertinents pour retrouver le sentiment de tweets comme ponctuation(.,?, "Etc.), caractères spéciaux(@,%, &, $, etc.), nombres(1,2,3, etc.), mangue le tweeter, liens(HTTPS: / HTTP:) et des termes qui n'ont pas beaucoup de poids dans le contexte du texte.
En outre, nous devons supprimer les mots vides des tweets. Les mots vides sont ces mots du langage naturel qui ont très peu de sens., Quoi « il est », « ongle », « les », etc. Pour supprimer les mots vides d'une phrase, vous pouvez diviser le texte en mots, puis supprimer le mot s'il existe dans la liste de mots vides fournie par NLTK.
Alors, nous devons normaliser les tweets en utilisant Stemming ou Lemmatization. « Stemming » est un processus basé sur des règles pour supprimer les suffixes (" ment "," ment "," il est "," ed "," s ", etc.) d'un mot. Par exemple, « jouer », « joueur », « joué », « joue » Oui « jouer » sont les différentes variantes du mot – « jouer ».
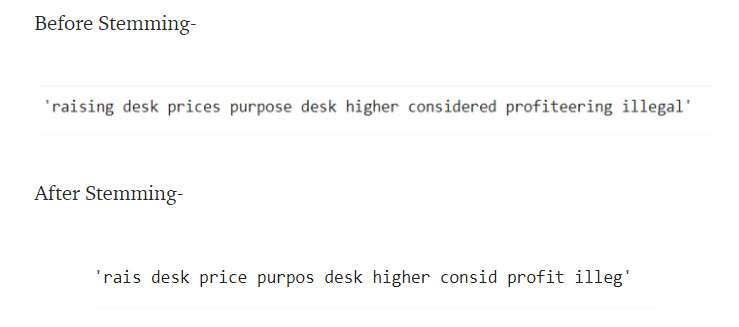
La dérivation ne convertira pas les mots originaux en mots significatifs. Comme tu peux le voir, « pris en considération » est dérivé dans « condition », qui n'a aucun sens et est aussi une faute d'orthographe. Le meilleur moyen est d'utiliser le stemming au lieu du processus de dérivation.
Le radicalisme est une opération plus puissante et prend en compte l'analyse morphologique des mots. Renvoie la devise, qui est la forme de base de toutes ses formes flexionnelles.
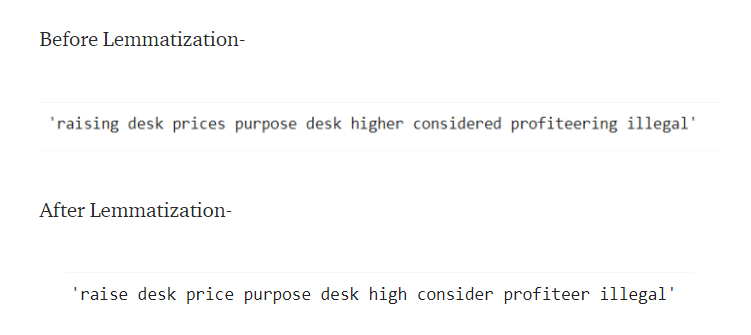
Ici, dans le processus de lemmatisation, nous tournons le mot « relever » à sa forme de base « relever ». También necesitamos convertir todos los tweets a minúsculas antes de realizar el proceso de standardisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus.....
Nous pouvons inclure le processus de tokenisation. En tokenisation, nous convertissons un groupe de phrases en jetons. También se denomina segmentationLa segmentation est une technique de marketing clé qui consiste à diviser un large marché en groupes plus petits et plus homogènes. Cette pratique permet aux entreprises d’adapter leurs stratégies et leurs messages aux spécificités de chaque segment, améliorant ainsi l’efficacité de vos campagnes. Le ciblage peut se faire sur des critères démographiques, Psychographique, géographique ou comportementale, Faciliter une communication plus pertinente et personnalisée avec le public cible.... de texto o análisis léxico. Essentiellement, il s'agit de diviser les données en un petit nombre de mots. La tokenisation en Python peut être effectuée par Python NLTK fonction word_tokenize () de la bibliothèque.
Vectorisation
On peut utiliser un vectoriseur de comptage ou un vectoriseur TF-IDF. Count Vectorizer créera un tableau clairsemé de tous les mots et du nombre de fois où ils sont présents dans un document.
TFIDF, court pour terme fréquence-fréquence inverse du document, est une statistique numérique qui essaie de refléter l'importance d'un mot pour un document dans une collection ou un corpus. La valeur TF - IDF augmente proportionnellement au nombre de fois qu'un mot apparaît dans le document et est compensée par le nombre de documents dans le corpus qui contiennent le mot, ce qui permet d'ajuster le fait que certains mots apparaissent plus fréquemment en général. (wiki)
Modèles de classification des bâtiments
Le problème posé est la classification ordinale multiclasse. Il existe cinq types de sentiments, nous devons donc entraîner nos modèles afin qu'ils puissent nous donner l'étiquette correcte pour l'ensemble de données de test. Je vais construire différents modèles comme Bayes ingénieux, Régression logistique, forêt aléatoire, XGBoost, machines à vecteurs de soutien, CatBoost y descenso de penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... stochastique.
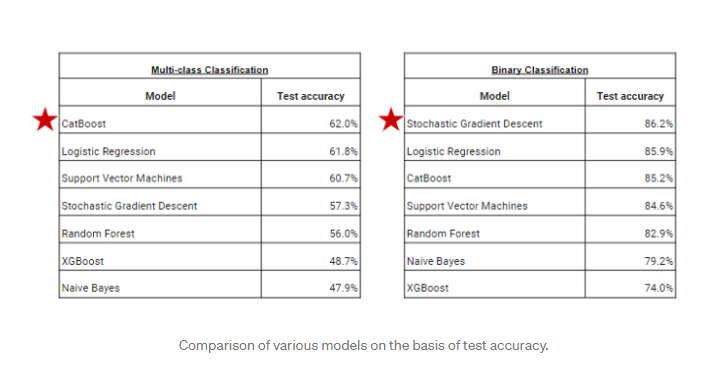
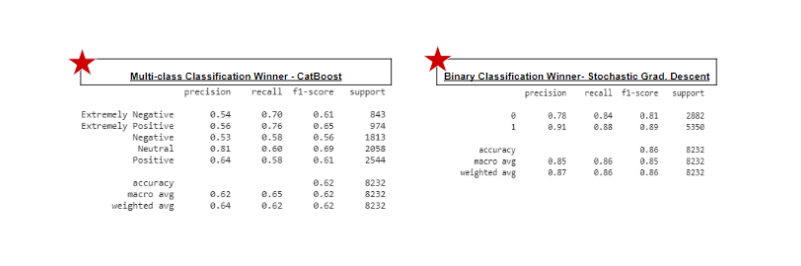
He usado el problema dado de Clasificación multiclase que es una variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dependiente que tiene los valores -Positivo, Extrêmement positif, Neutre, Négatif, Extrêmement négatif. Je convertis également ce problème en une classification binaire, c'est-à-dire, J'ai classé tous les tweets en seulement deux types Positif et Négatif. Vous pouvez également opter pour le classement en trois classes, c'est-à-dire, Positif, Négatif et Neutre pour une plus grande précision. En phase d'évaluation, nous comparerons les résultats de ces algorithmes.
Importance de la fonctionnalité
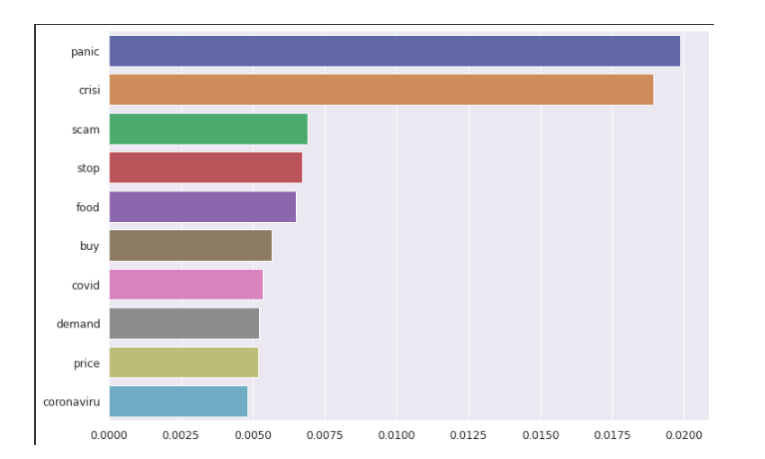
Les importance de la caractéristique (importance variable) décrire quel fonctionnalités est pertinent. Cela peut aider à mieux comprendre le problème résolu et, parfois, conduire à des améliorations du modèle en employant caractéristique sélection. Les trois premiers mots surlignés sont panique, crise et arnaque, comme on peut le voir sur le graphique suivant.
conclusion
De cette manière, nous pouvons explorer davantage à partir de divers tweets et données textuelles. Nos modèles vont essayer de prédire correctement les différents sentiments. J'ai utilisé divers modèles pour entraîner notre ensemble de données, mais certains modèles montrent une plus grande précision tandis que d'autres ne le font pas. Pour la classification multiclasse, le meilleur modèle pour cet ensemble de données serait CatBoost. Pour la classification binaire, le meilleur modèle pour cet ensemble de données serait la descente de gradient stochastique.
(Vous pouvez accéder au code Python de ce projet à partir de ce lien-https://github.com/rajeshmore1/Capstone-Project-2 )
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





