
Déverrouiller un nouveau monde avec l'algorithme de régression de vecteur de support
Soutenir les machines vectorielles (SVM) sont couramment et largement utilisés pour les problèmes de classification en apprentissage automatique. Je me suis souvent appuyé sur cela non seulement dans les projets d'apprentissage automatique, mais aussi quand je veux un résultat rapide dans un hackathon.
Mais SVM pour l'analyse de régression? Cela faisait un moment que je n'avais même pas envisagé cette possibilité !! Et même maintenant, quand je mentionne « Régression vectorielle de support » par rapport aux débutants en apprentissage automatique, J'ai souvent une expression perplexe. je comprends: la plupart des cours et des experts ne mentionnent même pas la prise en charge de la régression vectorielle (SVR) comme algorithme d'apprentissage automatique.
Mais SVR a ses utilités, comme vous le verrez dans ce tutoriel. Tout d'abord, nous allons rapidement comprendre ce qu'est SVM, avant de plonger dans le monde de la régression des vecteurs de support et comment l'implémenter en Python.
Noter: Vous pouvez en savoir plus sur les machines à vecteurs de support et les problèmes de régression au format de cours ici (c'est gratuit!):
C'est ce que nous allons couvrir dans ce tutoriel de régression de vecteur de support:
- Qu'est-ce qu'une machine à vecteur de support (SVM)?
- Soutenir les hyperparamètres d'algorithme de machine vectorielle
- Introduction à la régression des vecteurs de support (SVR)
- Implémentation de la régression des vecteurs de support en Python
Qu'est-ce qu'une machine à vecteur de support (SVM)?
Ensuite, Qu'est-ce que la machine à vecteur de support (SVM)? Nous allons commencer par comprendre SVM en termes simples. Digamos que tenemos un diagrama de dos clases de etiquetas como se muestra en la siguiente chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines....:
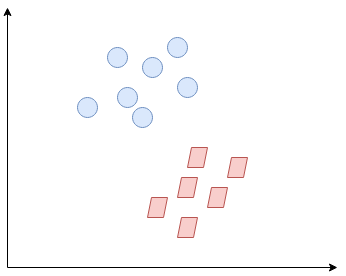
Pouvez-vous décider quelle sera la ligne de séparation? Cela vous est peut-être venu à l'esprit:
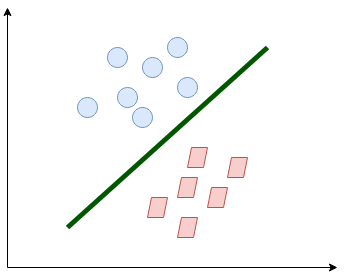
La ligne sépare un peu les classes. C'est ce que SVM fait essentiellement: séparation de classe simple. À présent, Quelles sont les données?
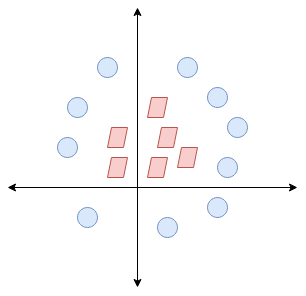
Ici, nous n'avons pas une ligne simple qui sépare ces deux classes. Así que ampliaremos nuestra dimension"Dimension" C’est un terme qui est utilisé dans diverses disciplines, comme la physique, Mathématiques et philosophie. Il s’agit de la mesure dans laquelle un objet ou un phénomène peut être analysé ou décrit. En physique, par exemple, On parle de dimensions spatiales et temporelles, alors qu’en mathématiques, il peut faire référence au nombre de coordonnées nécessaires pour représenter un espace. Sa compréhension est fondamentale pour l’étude et... e introduciremos una nueva dimensión a lo largo del eje z. Maintenant, nous pouvons séparer ces deux classes:
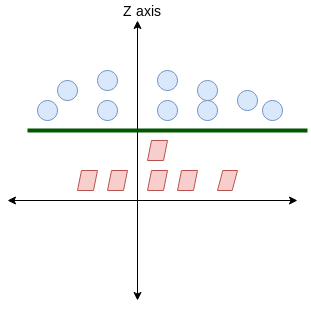
Lorsque nous transformons cette ligne dans le plan d'origine, cartes à la frontière circulaire comme je l'ai montré ici:
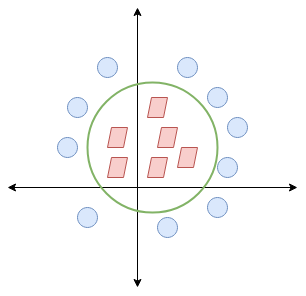
C'est exactement ce que fait SVM !! Essayez de trouver une ligne / hyperplan (dans un espace multidimensionnel) qui sépare ces deux classes. Classer ensuite le nouveau point selon qu'il se trouve du côté positif ou négatif de l'hyperplan selon les classes à prédire.
Soutenir les hyperparamètres d'algorithme de machine vectorielle (SVM)
Hay algunos paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... importantes de SVM que debe conocer antes de continuar:
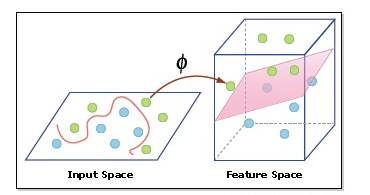
- Coeur: Un noyau nous aide à trouver un hyperplan dans un espace de dimension supérieure sans augmenter le coût de calcul. Comme d'habitude, le coût de calcul augmentera si la dimension des données augmente. Cette augmentation de dimension est nécessaire lorsque nous ne pouvons pas trouver un hyperplan de séparation dans une certaine dimension et que nous devons nous déplacer dans une dimension supérieure:
- Hyperplan: Il s'agit essentiellement d'une ligne de démarcation entre deux classes de données dans SVM. Mais à l'appui de la régression vectorielle, c'est la ligne qui sera utilisée pour prédire la sortie continue
- Limite de décision: Une frontière de décision peut être considérée comme une ligne de démarcation (simplifier) d'un côté les exemples positifs et de l'autre les exemples négatifs. Dans cette même ligne, les exemples peuvent être classés comme positifs ou négatifs. Ce même concept SVM s'appliquera également dans la régression de vecteur de support
Pour comprendre SVM à partir de zéro, je recommande ce tuto: Comprendre l'algorithme de la machine à vecteurs de support (SVM) à partir d'exemples.
Introduction à la régression des vecteurs de support (SVR)
Régression vectorielle de support (SVR) utilise le même principe que SVM, mais pour les problèmes de régression. Prenons quelques minutes pour comprendre l'idée derrière SVR.
L'idée derrière la régression des vecteurs de support
El problema de la regresión es encontrar una función que se aproxime al mapeo de un dominio de entrada a números reales sobre la base de una muestra de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines..... Alors maintenant, approfondissons et comprenons comment fonctionne réellement RVS..
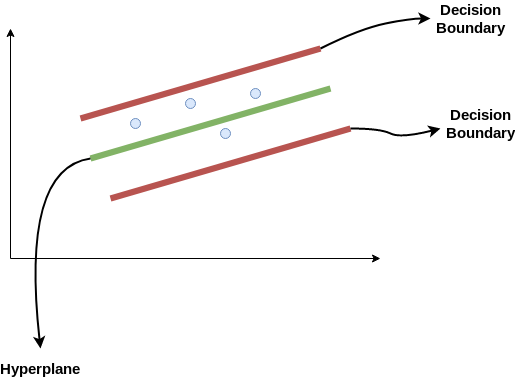
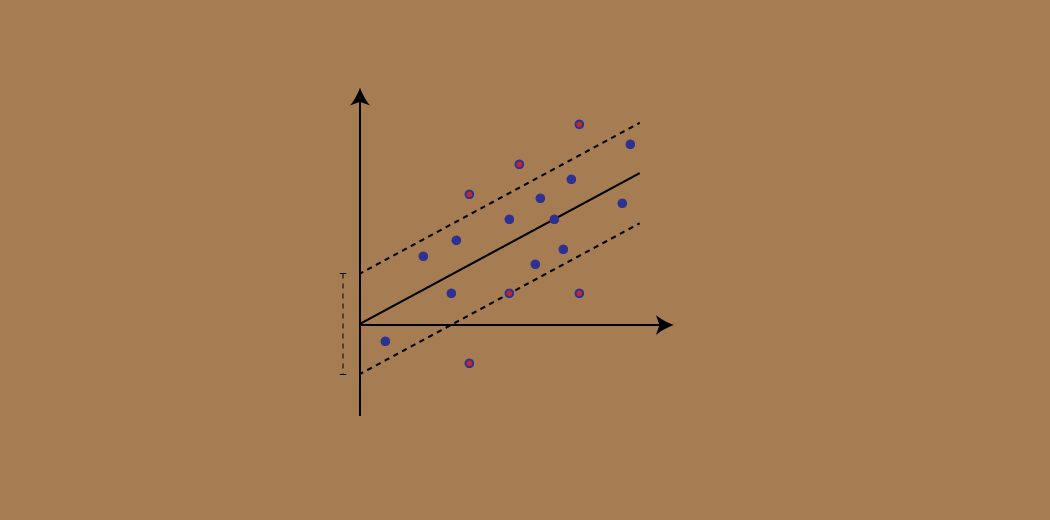
Considérez ces deux lignes rouges comme la limite de décision et la ligne verte comme l'hyperplan. Notre objectif, quand nous avançons avec SVR, il s'agit essentiellement de considérer les points qui se trouvent à l'intérieur de la ligne de limite de décision. Notre meilleure ligne d'ajustement est l'hyperplan qui a un nombre maximum de points.
La première chose que nous comprendrons est quelle est la limite de décision (La ligne de danger rouge!). Considérez que ces lignes sont à n'importe quelle distance, Disons « une », de l'hyperplan. Ensuite, estas son las líneas que dibujamos a la distancia ‘+ une’ Oui ‘-une’ de l'hyperplan. Ce ‘une’ dans le texte, il est essentiellement connu sous le nom d'epsilon.
En supposant que l'équation de l'hyperplan est la suivante:
Y = wx+b (équation de l'hyperplan)
Alors les équations limites de décision deviennent:
wx+b= +a

wx+b= -a
Donc, tout hyperplan qui satisfait notre RVS devrait satisfaire:
-une < Oui- wx+b < +une
Nuestro principal objetivo aquí es decidir un límite de decisión a una distancia ‘une’ de l'hyperplan d'origine, de sorte que les points de données les plus proches de l'hyperplan ou des vecteurs de support se trouvent à l'intérieur de cette ligne frontière.
Donc, nous allons prendre uniquement les points qui sont dans la limite de décision et qui ont le taux d'erreur le plus bas, o están dentro del MargeLa marge est un terme utilisé dans divers contextes, comme la comptabilité, Économie et imprimerie. En comptabilité, fait référence à la différence entre les revenus et les coûts, qui permet d’évaluer la rentabilité d’une entreprise. Dans le domaine de l’édition, La marge est l’espace blanc autour du texte d’une page, qui le rend facile à lire et offre une présentation esthétique. Sa bonne gestion est essentielle.. de Tolerancia. Cela nous donne un modèle mieux adapté..
Prise en charge de la mise en œuvre de la régression vectorielle (SVR) et Python
Il est temps de mettre nos chapeaux de codage !! Dans cette section, nous comprendrons l'utilisation de la régression des vecteurs de support à l'aide d'un ensemble de données. Ici, nous devons prédire le salaire d'un employé étant donné certaines variables indépendantes. Un projet d'analyse RH classique!
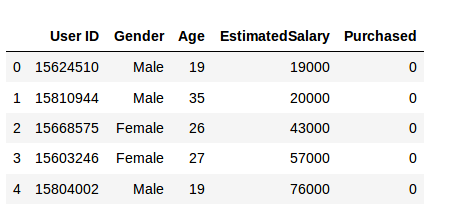
Paso 1: importer les bibliothèques
Paso 2: lire l'ensemble de données
Paso 3: Mise à l'échelle des fonctions
Un ensemble de données du monde réel contient des caractéristiques dont l'ampleur varie, unités et gamme. Sugeriría realizar la standardisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus.... cuando la escala de una característica es irrelevante o engañosa.
La mise à l'échelle des fonctionnalités aide essentiellement à normaliser les données dans une plage particulière. Normalement, divers types de classes communes contiennent une fonction de mise à l'échelle des caractéristiques pour mettre automatiquement à l'échelle les caractéristiques. Cependant, la classe SVR n'est pas un type de classe couramment utilisé, nous devrions donc faire une mise à l'échelle des fonctionnalités avec Python.
Paso 4: adapter SVR à l'ensemble de données
Le noyau est la caractéristique la plus importante. Il existe plusieurs types de noyaux: linéaire, gaussianos, etc. Chacun est utilisé en fonction de l'ensemble de données. Pour plus d'informations à ce sujet, lis ça: Machine à vecteur de soutien (SVM) en Python et R
Paso 5. Prédire un nouveau résultat
Ensuite, la prédiction pour y_pred (6, 5) ce sera 170,370.
Paso 6. Affichage des résultats SVR (para una résolutionLa "résolution" fait référence à la capacité de prendre des décisions fermes et d’atteindre les objectifs fixés.. Dans des contextes personnels et professionnels, Il s’agit de définir des objectifs clairs et d’élaborer un plan d’action pour les atteindre. La résolution est essentielle à la croissance personnelle et à la réussite dans divers domaines de la vie, car cela vous permet de surmonter les obstacles et de rester concentré sur ce qui compte vraiment.... más alta y una curva más suave)
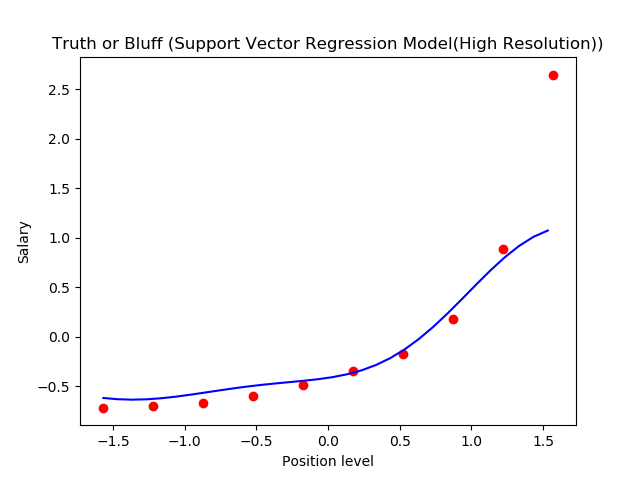
C'est ce que nous obtenons en sortie: la ligne de meilleur ajustement qui a un nombre maximum de points. Assez précis!
Remarques finales
Nous pouvons considérer la régression des vecteurs de support comme la contrepartie de SVM aux problèmes de régression. SVR reconnaît la présence de non-linéarité dans les données et fournit un modèle de prédiction compétent.
J'aimerais entendre vos réflexions et vos idées sur l'utilisation de SVR pour l'analyse de régression.. Connectez-vous avec moi dans la section des commentaires ci-dessous et trouvons!





