
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Si vous lisez cet article, Je suppose que vous êtes déjà dans le monde de la science des données et que vous avez une idée de l'apprentissage automatique. Si ce n'est pas comme ça, Il n'y a pas de problème. Je vais commencer par les terminologies de base que vous devez connaître avant de comprendre le principal sujet de discussion, c'est-à-dire, régression linéaire.
Cet article couvrira tout ce que vous devez savoir sur la régression linéaire., le premier algorithme d'apprentissage automatique en science des données.
Table des matières
- Brève introduction à l'apprentissage automatique et à ses types
- Comprendre la régression linéaire
- Hypothèses de régression linéaire.
- Comment faire face à la violation des hypothèses
- Métriques d'évaluation pour les problèmes de régression
Introduction à l'apprentissage automatique
L'apprentissage automatique est une branche de l'intelligence artificielle (IL) axé sur la création d'applications qui apprennent à partir des données et améliorent la précision au fil du temps sans être programmé pour le faire.
Types d'apprentissage automatique:
Apprentissage automatique supervisé: C'est une technique de ML dans laquelle les modèles sont entraînés avec des données étiquetées, c'est-à-dire, il est fourni un variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... de sortie dans ce type de problèmes. Ici, les modèles trouvent une fonction de mappage pour mapper les variables d'entrée à la variable de sortie ou aux étiquettes.
Régression et classification Les problèmes font partie de l'apprentissage automatique supervisé.
Apprentissage automatique non supervisé: C'est la technique dans laquelle les modèles ne reçoivent pas les données étiquetées et doivent trouver les modèles et la structure dans les données pour connaître les données.
Regroupement et association Les algorithmes font partie du ML non supervisé.
Comprendre la régression linéaire
Dans les mots les plus simples Régression linéaire est le modèle d'apprentissage automatique supervisé dans lequel le modèle trouve la ligne linéaire de meilleur ajustement entre la variable indépendante et dépendante c'est-à-dire, trouver la relation linéaire entre les variables dépendantes et indépendantes.
La régression linéaire est de deux types: Simple et multiple. Régression linéaire simple est où une seule variable indépendante est présente et le modèle doit trouver sa relation linéaire avec la variable dépendante
Alors que dans La régression linéaire multiple il y a plus d'une variable indépendante pour que le modèle trouve la relation.
Équation de régression linéaire simple, où bO est l'intersection, b1 est un coefficient ou une pente, x est la variable indépendante et y est la variable dépendante.
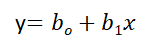

Équation de régression linéaire multiple, où bO est l'intersection, b1,B2,B3,B4…,BNord sont des coefficients ou des pentes des variables indépendantes x1,X2,X3,X4…,XNord et y est la variable dépendante.
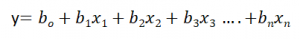

L'objectif principal d'un modèle de régression linéaire est de trouver la ligne linéaire qui correspond le mieux et les valeurs optimales d'intersection et de coefficients d'une manière qui minimise l'erreur.
L'erreur est la différence entre la valeur réelle et la valeur prédite et le but est de réduire cette différence.
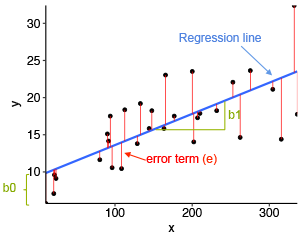
Comprenons cela à l'aide d'un schéma.
Source de l'image: des outils statistiques pour une analyse de données performante
Dans le schéma ci-dessus,
- x est notre variable dépendante qui est tracée sur l'axe des x et y est la variable dépendante qui est tracée sur l'axe des y.
- Les points noirs sont les points de données, c'est-à-dire, les valeurs réelles.
- BO est l'intersection qui est 10 et B1 est la pente de la variable x.
- La ligne bleue est la ligne de meilleur ajustement prédite par le modèle, c'est-à-dire, les valeurs prédites sont sur la ligne bleue.
La distance verticale entre le point de données et la ligne de régression est appelée erreur ou résidu. Chaque point de données a un reste et la somme de toutes les différences est appelée la somme des résidus / erreurs.
Approche mathématique:
Résiduel / Erreur = valeurs réelles – Valeurs prédites
Somme des résidus / erreurs = somme (valeurs réelles attendues)
Carré de la somme des résidus / erreurs = (Somme (valeurs réelles attendues))2
c'est-à-dire
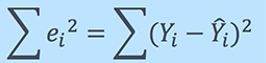
Pour une compréhension approfondie des mathématiques derrière la régression linéaire, voir pièce jointe explication vidéo.
Hypothèses de régression linéaire
Les hypothèses de base de la régression linéaire sont les suivantes:
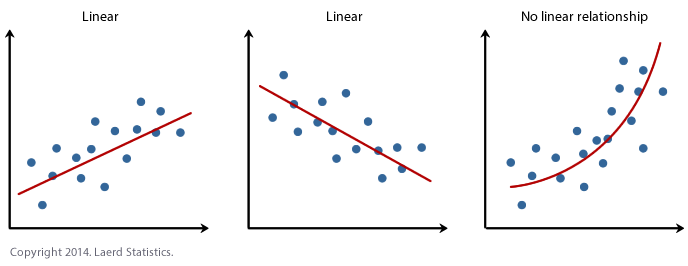
1. Linéarité: Établit que la variable dépendante Y doit être liée linéairement aux variables indépendantes. Cette hypothèse peut être vérifiée en traçant un diagramme de dispersion entre les deux variables.
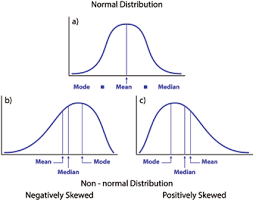
2. Normal: Les variables X et Y doivent avoir une distribution normale. Les histogrammes peuvent être utilisés, Graphes KDE et graphes QQ pour vérifier l'hypothèse de normalité.
Voir mon blog ci-joint pour une explication détaillée sur la façon de vérifier la normalité et de transformer les variables qui violent l'hypothèse.
La source: https://heljves.com/gallery/vol_1_issue_1_2019_8.pdf
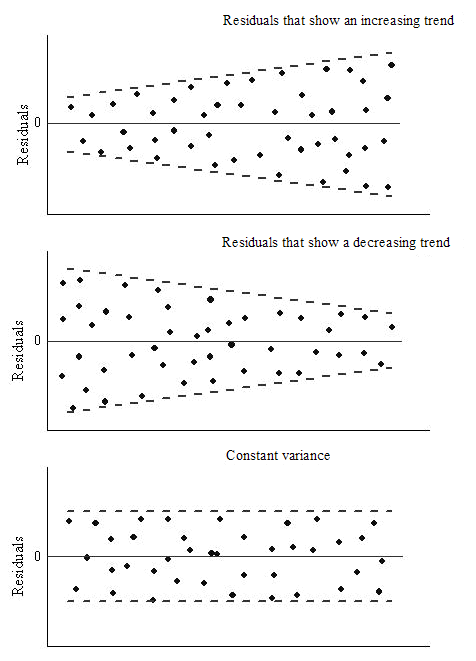
3. Homoscédasticité: La variance des termes d'erreur doit être constante, c'est-à-dire, la dispersion des résidus doit être constante pour toutes les valeurs de X. Cette hypothèse peut être vérifiée en traçant un graphe résiduel. Si l'hypothèse est violée, les points formeront un entonnoir, sinon ils seront constants.
La source: OriginLab
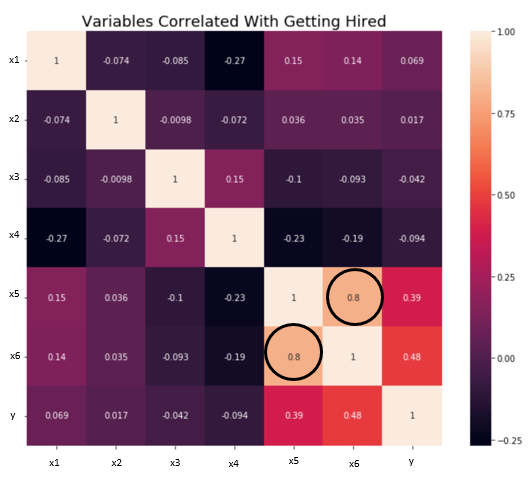
4. Indépendance / Pas de multicolinéarité: Les variables doivent être indépendantes les unes des autres, c'est-à-dire, il ne devrait pas y avoir de corrélation entre les variables indépendantes. Pour vérifier l'hypothèse, on peut utiliser une matrice de corrélation ou un score VIF. Si le score VIF est supérieur à 5, les variables sont fortement corrélées.
Dans l'image ci-dessous, il y a une forte corrélation entre les variables x5 et x6.
La source: vers la science des données
5. Les les termes d'erreur doivent être distribués normalement. Les graphiques QQ et les histogrammes peuvent être utilisés pour vérifier la distribution des termes d'erreur.
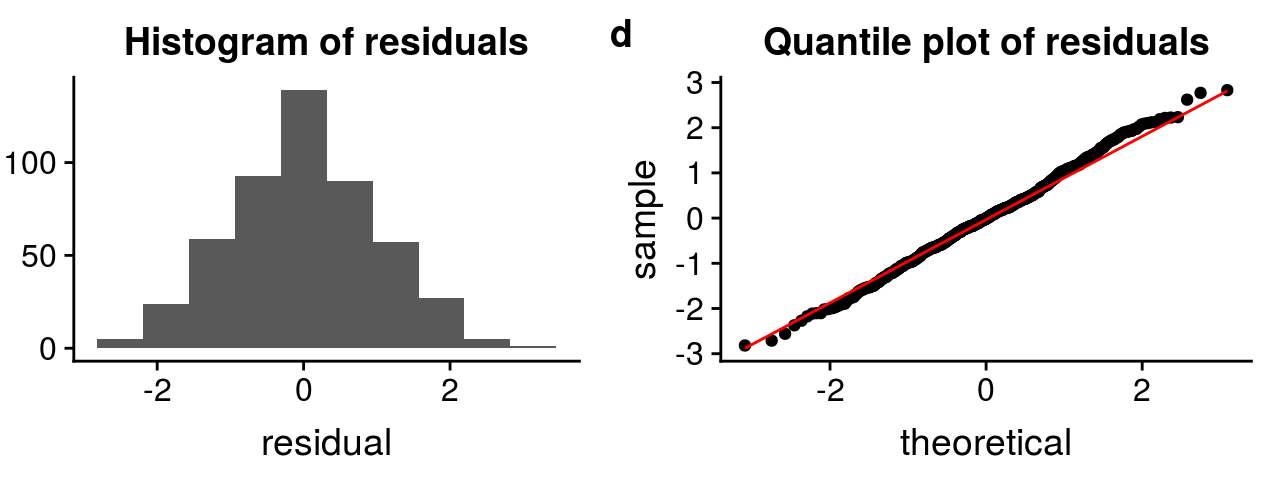
La source: http://rstudio-pubs-static.s3.amazonaws.com
6. Pas d'autocorrélation: Les termes d'erreur doivent être indépendants les uns des autres. L'autocorrélation peut être testée à l'aide du test de Durbin Watson. L'hypothèse nulle suppose qu'il n'y a pas d'autocorrélation. La valeur du test est comprise entre 0 Oui 4. Si la valeur de test est 2, pas d'autocorrélation.
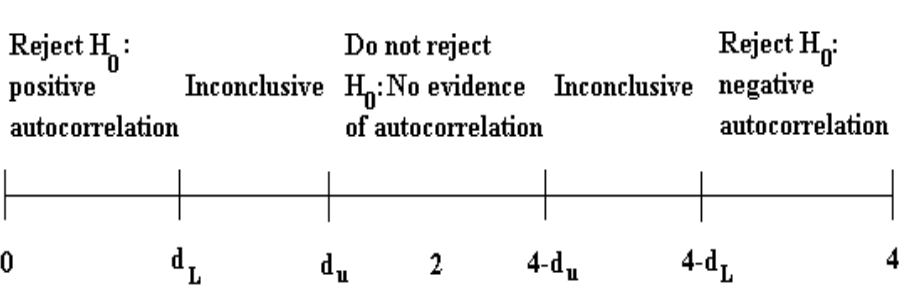
La source: itfeature.com
Comment faire face à la violation de l'une des hypothèses
La violation des hypothèses entraîne une diminution de la précision du modèle, donc les prédictions ne sont pas exactes et l'erreur est également élevée.
Par exemple, si l'hypothèse d'indépendance est violée, la relation entre la variable indépendante et la variable dépendante ne peut pas être déterminée avec précision.
Il existe diverses méthodes et techniques disponibles pour traiter la violation des hypothèses. Analysons certains d'entre eux ci-dessous.
Violation de l'hypothèse de normalité des variables ou des termes d'erreur
Pour traiter ce problème, nous pouvons transformer les variables en distribution normale en utilisant diverses fonctions de transformation comme la transformation logarithmique, Transformation Box-Cox réciproque.
Toutes les fonctions sont discutées dans cet article du mien: Comment passer à une distribution normale
Violation de l'hypothèse de multicolinéarité
Il peut être traité par:
- Ne fais rien (s'il n'y a pas de différence majeure de précision)
- Éliminer certaines des variables indépendantes fortement corrélées.
- Déduire une nouvelle caractéristique en combinant linéairement les variables indépendantes, comment les ajouter ou effectuer une opération mathématique.
- Réaliser une analyse conçue pour des variables fortement corrélées, telles que l'analyse en composantes principales.
Métriques d'évaluation pour l'analyse de régression
Pour comprendre les performances du modèle de régression, une évaluation du modèle est nécessaire. Certaines des mesures d'évaluation utilisées pour l'analyse de régression sont:
1. R au carré ou coefficient de détermination: La métrique la plus utilisée pour l'évaluation du modèle dans l'analyse de régression est R au carré. Il peut être défini comme un rapport de variation à la variation totale. La valeur de R au carré est comprise entre 0 Oui 1, le plus proche de 1, meilleur est le modèle.
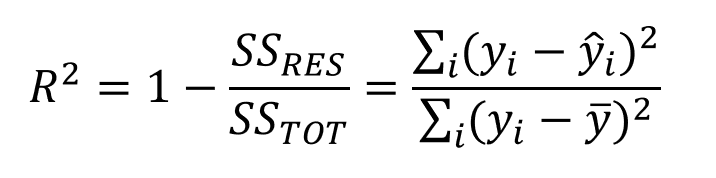
La source: medium.datadriveninvestor.com
où SSRES est la somme des carrés résiduelle et SSTOT est la somme des carrés totale
2. R carré ajusté: C'est l'amélioration de R au carré. Le problème / L'inconvénient de R2 est qu'au fur et à mesure que les fonctionnalités augmentent, la valeur de R2 augmente également, qui donne l'illusion d'un bon modèle. Ensuite, R2 ajusté résout le problème R2. Il ne considère que les caractéristiques qui sont importantes pour le modèle et montre l'amélioration réelle du modèle.
R2 ajusté est toujours inférieur à R2.
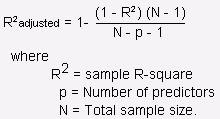
La source: stats.stackexchange.com
3. Erreur quadratique moyenne (MSE): Une autre mesure courante pour l'évaluation est l'erreur quadratique moyenne., qui est la moyenne de la différence au carré des valeurs réelles par rapport à celles prédites.
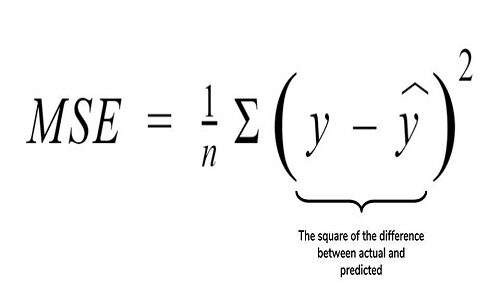
La source: cppsecrets.com
4. Erreur quadratique moyenne (RMSE): C'est la racine de MSE, c'est-à-dire, la racine de la différence moyenne des valeurs réelles et prévues. Le RMSE sanctionne les grosses erreurs, alors que MSE ne.
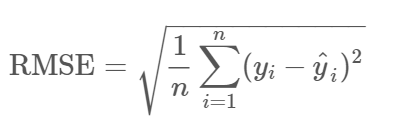
La source: communauté.qlik.com
Remarques finales
Nous avons couvert la plupart des concepts de modèle de régression sur ce blog.. Si vous voulez en savoir plus sur les mathématiques derrière le modèle, voir les liens attachés au blog.
S'il vous plait, n'hésitez pas à me contacter sur LinkedIn et partagez votre précieuse contribution. S'il vous plait, consultez mes autres articles ici.
A propos de l'auteur :
Soja Deepanshi Dhingra, Je travaille actuellement en tant que chercheur en science des données et j'ai une formation en analytique, l'analyse exploratoire des données, l’apprentissage automatique et l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé....
Cet article a été publié dans le cadre du Blogathon sur la science des données





