
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
Intéressé par l'analyse prédictive? Alors, recherche intelligence artificielle, l’apprentissage automatique et l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé.... .
Si vous êtes sur la voie de l'apprentissage de la science des données, comprendre ce qu'est l'apprentissage automatique. Dans le monde numérique d'aujourd'hui, tout le monde sait ce qu'est l'apprentissage automatique parce que c'était une technologie numérique à la mode partout dans le monde.
Chaque étape vers l'adaptation au monde futur est guidée par cette technologie actuelle, et cette technologie actuelle est dirigée par des data scientists comme vous et moi😌.
Ici on ne parle que de machine learning, si tu ne sais pas ce que c'est, nous vous donnons une brève introduction:
Apprentissage automatique est l'étude des algorithmes informatiques, qui s'améliorent automatiquement grâce à l'expérience et à l'utilisation des données. votre algorithme construit un modèle basé sur les données que nous fournissons lors de la construction du modèle. C'est la définition simple de l'apprentissage automatique, et quand on s'enfonce, nous avons constaté qu'il y a beaucoup d'algorithmes utilisés dans la construction de modèles. Généralement, les algorithmes d'apprentissage automatique les plus utilisés sont basés sur le type de problème, les gars sont fondamentalement régression, classification, etc... Mais ici nous ne parlerons que d'algorithmes de régression.
Faisons une brève introduction sur ce qu'est la régression. Régression est la méthode statistique des investissements, finance et autres disciplines qui tentent de déterminer la force et la relation entre les variables indépendantes et dépendantes. Généralement, les variables indépendantes sont les variables dans lesquelles leurs valeurs sont utilisées pour obtenir la sortie et les variables dépendantes sont celles dont la valeur dépend de valeurs indépendantes. Quand on parle d'algorithmes de régression, certains algorithmes de régression couramment utilisés sont utilisés pour entraîner le modèle d'apprentissage automatique, comme une simple régression linéaire, lien, crête, etc.
Donc, Parlons de la régression linéaire multiple et comprenons en détail en quoi la régression linéaire simple diffère de la régression linéaire multiple.
- Régression linéaire simple vs régression linéaire multiple
- Base de données
- Lire l'ensemble de données
- Variables indépendantes et dépendantes
- Gestion des variables catégorielles
- Division des données
- Application du modèle
Régression linéaire simple versus régression linéaire multiple
À présent, avant de continuer, analysons l'interaction derrière la régression linéaire simple, puis nous essayons de comparer la régression linéaire simple et multiple basée sur cette intuition que nous faisons réellement avec notre problème d'apprentissage automatique.
Régression linéaire simple
Nous considérons une régression linéaire simple dans n'importe quel algorithme d'apprentissage automatique en utilisant l'exemple,
À présent, Supposons que nous prenions un scénario de prix d'une maison où notre axe des x est la taille de la maison et l'axe des y est essentiellement le prix de la maison. Dans ce fond, nous avons deux caractéristiques, le premier est f1 et la seconde est f2, où,
f1 fait référence à la taille de la maison et,
f2 se réfère au prix de la maison
donc oui f1 devient la fonction autonome et f2 devient la caractéristique dépendante, nous savons généralement que chaque fois que la taille de la maison augmente, le prix augmente aussi, supposons que nous tirions des points de dispersion au hasard, à travers ce point de dispersion, nous essayons essentiellement de trouver la ligne de meilleur ajustement et cette ligne de meilleur ajustement est donnée par l'équation :
équation: y = A + Bx
Supposer, Oui être le prix de la maison et X être la taille de la maison, donc cette équation ressemble à ceci:
équation: prix = A + B (Taille)
où,
A est une intersection et B est une pente à cette intersection
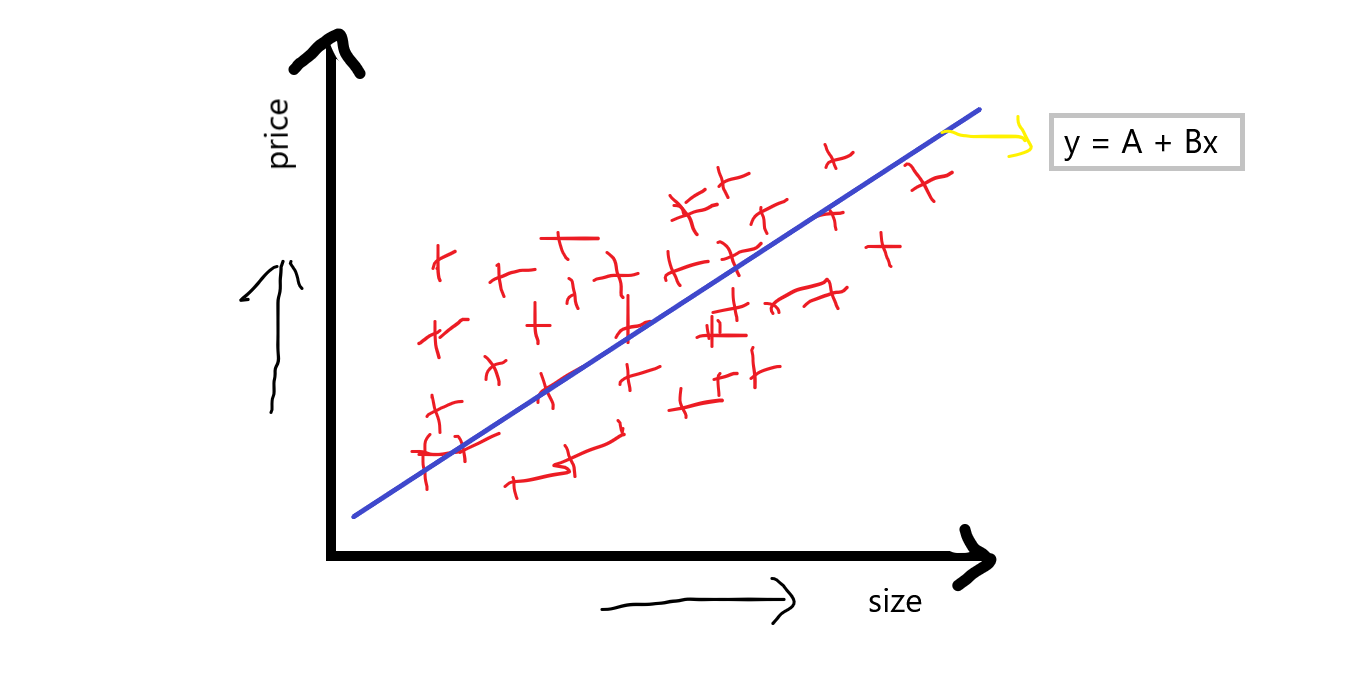
Lorsque nous discutons de cette équation, dans lequel l'intersection indique essentiellement quand le prix de la maison est 0 alors quel sera le prix de base de la maison, et la pente ou le coefficient indique qu'avec l'unité sa taille augmente, alors quelle sera l'unité augmente en pente.
Maintenant bien, En quoi est-ce différent par rapport à la régression linéaire multiple?
La régression linéaire multiple
La régression linéaire multiple indique essentiellement que nous aurons de nombreuses caractéristiques telles que f1, f2, f3, f4, et notre fonction de sortie f5. Si nous prenons le même exemple que nous avons discuté plus tôt, supposer:
f1 est la taille de la maison.
f2 Ce sont de mauvaises pièces dans la maison.
f3 est la ville de la maison.
f4 est l'état de la maison et,
f5 c'est notre caractéristique de sortie qui est le prix de la maison.
À présent, vous pouvez voir que plusieurs fonctionnalités autonomes ont également un impact important sur le prix de la maison, le prix peut varier d'une fonctionnalité à l'autre. Quand on parle de régression linéaire multiple, alors l'équation de régression linéaire simple y = A + Bx se transforme en quelque chose comme:
équation: y = A + B1X1+ B2X2+ B3X3+ B4X4
« Si on a une fonction dépendante et plusieurs fonctions indépendantes, nous l'appelons essentiellement la régression linéaire multiple. «
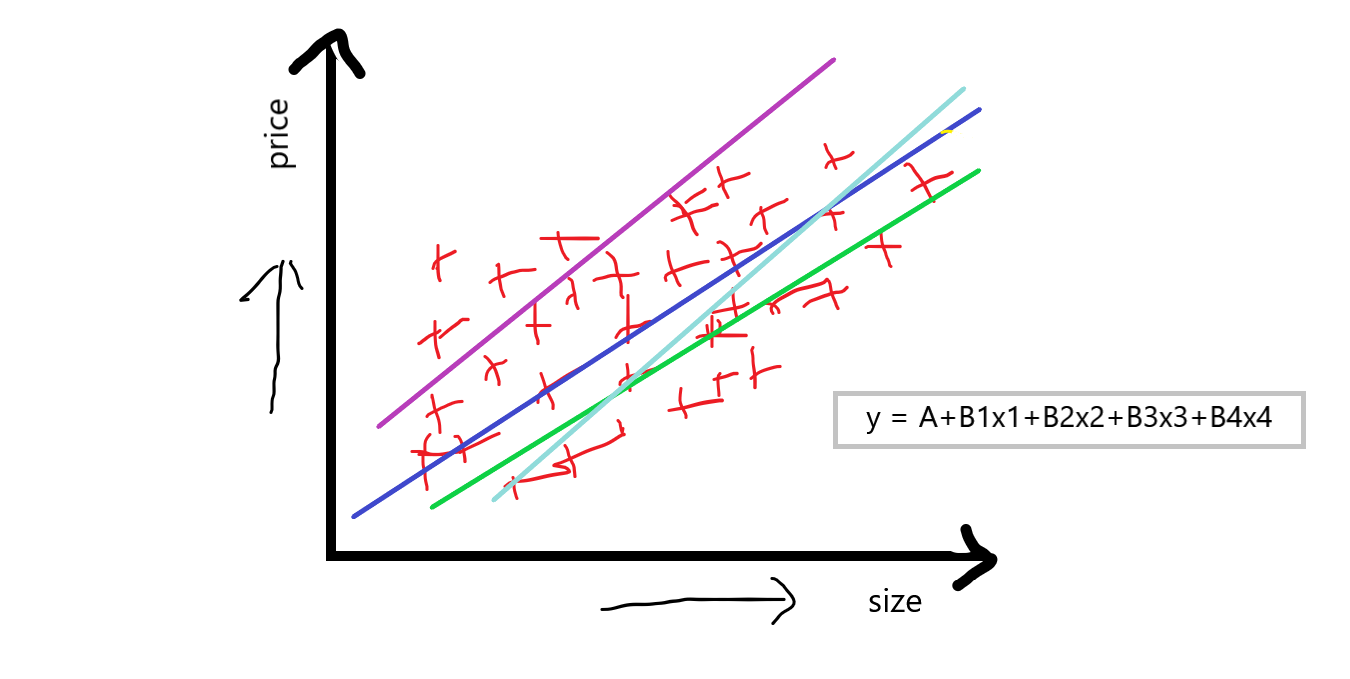
À présent, notre objectif en utilisant la régression linéaire multiple est que nous devons calculer UNE qu'est-ce qu'une intersection, Oui B1 B2 B3 B4 quelles sont les pentes ou coefficients se rapportant à cette caractéristique indépendante, ce qui indique essentiellement que si nous augmentons la valeur de X1 pour 1 conduire alors B1 dit quelle valeur affectera le prix de la maison, et c'était pareil par rapport aux autres B2 B3 B4
Ensuite, il s'agit d'une brève description théorique de la régression linéaire multiple. Nous allons maintenant utiliser la bibliothèque de régression linéaire scikit learn pour résoudre le problème de régression linéaire multiple.
Base de données
À présent, nous appliquons une régression linéaire multiple sur le 50_startups base de données, tu peux cliquer ici pour télécharger le jeu de données.
Lire l'ensemble de données
La plupart de l'ensemble de données est dans un fichier CSV, pour lire ce fichier nous utilisons la bibliothèque pandas:
df = pd.read_csv('50_Startups.csv')
df
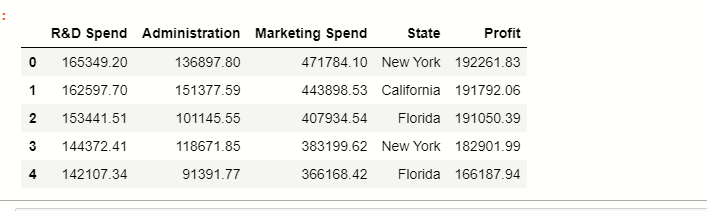
Ici vous pouvez voir ce qu'il y a 5 colonnes de l'ensemble de données où le état stocke des points de données catégoriques et le reste sont des caractéristiques numériques.
À présent, nous devons classer les caractéristiques indépendantes et dépendantes:
Variables indépendantes et dépendantes
Il y a un total de 5 caractéristiques dans l'ensemble de données, dans laquelle fondamentalement les profits sont notre caractéristique dépendante, et le reste d'entre eux sont nos caractéristiques indépendantes:
#séparer les autres attributs de l'attribut de prédiction
x = df.drop('Profit',axe=1)
#separte the predicting attribute into Y for model training
y = ['profit']
Gestion des variables catégorielles
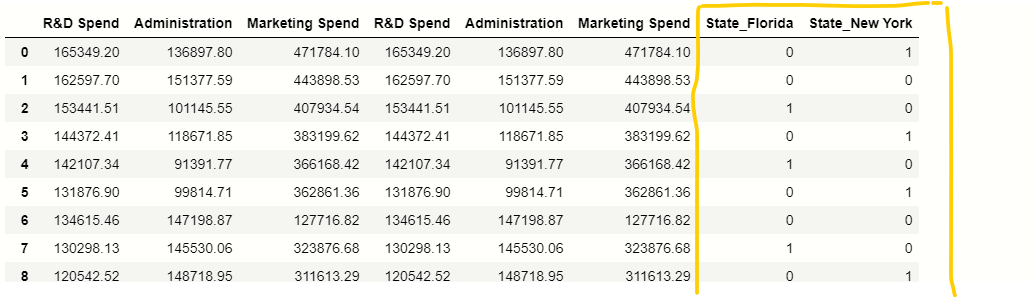
Dans notre jeu de données, il y a une colonne catégorique État, nous devons gérer ces valeurs catégorielles présentes à l'intérieur de cette colonne pour cela nous utiliserons des pandas get_dummies () une fonction:
# manipuler variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... categórica
estados = pd.get_dummies (X, drop_first = Vrai)
# suppression d'une colonne supplémentaire
x = x.drop (‘État’, axe = 1)
# concaténation de variables indépendantes et nouvelle variable catorique.
x = pd.concat ([X,États], axe = 1)
X
Division des données
À présent, tenemos que dividir los datos en partes de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... y prueba para las que usamos scikit-learn train_test_split () une fonction.
# importer train_test_split depuis sklearn
de sklearn.model_selection importer train_test_split
# fractionner les données
x_train, x_test, y_train, y_test = train_test_split(X, Oui, taille_test = 0.2, état_aléatoire = 42)
Application du modèle
À présent, nous appliquons le modèle de régression linéaire à nos données d'entraînement, en premier lieu, nous devons importer la régression linéaire de la bibliothèque scikit-learn, il n'y a pas d'autre bibliothèque pour implémenter la régression linéaire multiple, nous le faisons uniquement avec une régression linéaire.
# module d'importation
à partir de sklearn.linear_model importer LinearRegression
# créer un objet de classe LinearRegression
LR = Régression Linéaire()
# ajustement des données d'entraînement
LR.fit(x_train,y_train)
finalement, si nous exécutons ceci, alors notre modèle sera prêt, maintenant nous avons les données de x_test, Nous utilisons ces données pour la prédiction de profit.
y_prediction = LR.predict(x_test)
y_prediction
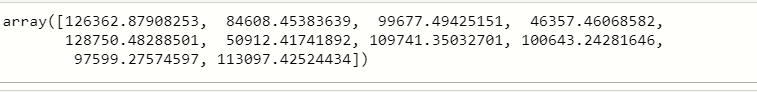
À présent, nous devons comparer les valeurs y_prediction avec les valeurs d'origine car nous devons calculer la précision de notre modèle, qui a été mis en œuvre par un concept appelé r2_score. discutons brièvement de r2_score:
r2_score: –
C'est une fonction au sein de sklearn. module de métriques, où la valeur de r2_score varie entre 0 Oui 100 pourcent, on peut dire qu'il est étroitement lié au MSE.
r2 est essentiellement calculé par la formule ci-dessous:
formule: r2 = 1 – (SSres / SSvouloir dire )
à présent, quand je dis SSres c'est-à-dire, est la somme des résidus et SSvouloir dire désigne la somme des moyennes.
où,
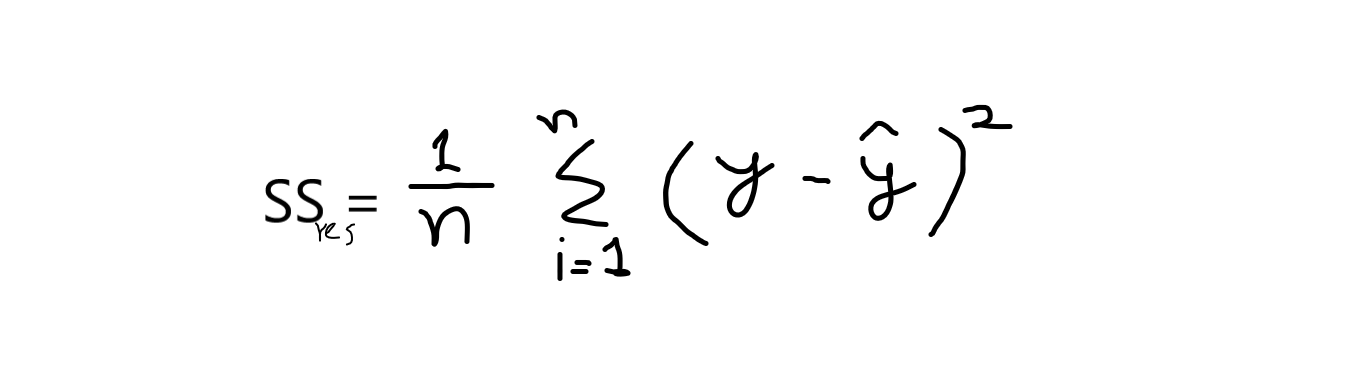
Oui = valeurs d'origine
et ^ = valeurs prédites. Oui,
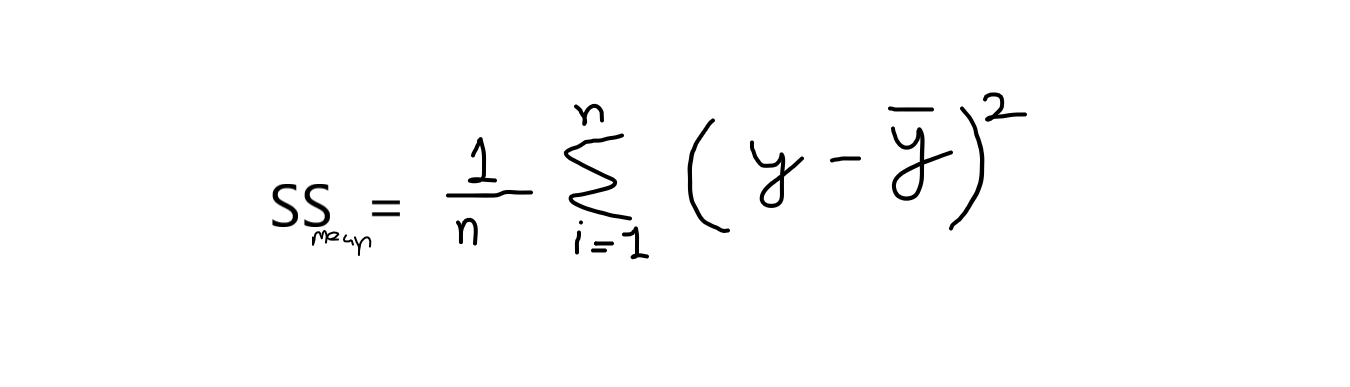
Si nous prenons le calcul de cette équation, alors il faut savoir que la valeur de la somme des moyennes est toujours supérieure à la somme des résidus. Si cette condition est remplie, donc notre modèle est bon pour les prédictions. Ses valeurs vont de 0,0 Oui 1.
« La proportion de la variance de la variable dépendante qui est prévisible à partir de la (s) variable (s) Indépendant ».
Le meilleur score possible est 1.0 et cela peut être négatif car le modèle peut être arbitrairement pire. Un modèle constant qui prédit toujours la valeur attendue de y, indépendamment des caractéristiques d'entrée, obtiendrait un score R2 de 0.0.
# importation du module r2_score
de sklearn.metrics importar r2_score
de sklearn.metrics importar Mean_squared_error
# prédire le score de précision
score = r2_score (y_test, y_prediction)
imprimer (‘r2 socre is’, ponctuation)
imprimer (‘mean_sqrd_error is ==’, Mean_squared_error (y_test, y_prediction))
imprimer (‘root_mean_squared error of is ==’, np.sqrt (Mean_squared_error (y_test, y_prediction)))
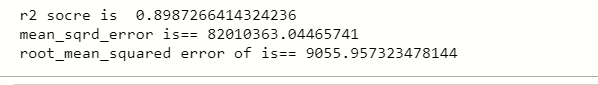
Vous pouvez voir que le score de précision est supérieur à 0,8, ce qui signifie que nous pouvons utiliser ce modèle pour résoudre des régressions linéaires multiples, et aussi le taux d'erreur quadratique moyen est également faible.
Remarques finales
Salut, scientifiques des données 😎 ci-dessus, nous avons pris une discussion détaillée sur la régression linéaire multiple, et l'exemple que nous utilisons est l'exemple parfait de régression linéaire multiple. J'espère que vous comprenez mieux maintenant la régression linéaire multiple.
J'espère que cela vous a plu!
Vous pouvez me connecter sur LinkedIn: www.linkedin.com/in/mayur-badole-189221199
En outre, lire mes autres articles: https://www.analyticsvidhya.com/blog/author/mayurbadole2407/
Merci.





