
Commençons par faire un bref énoncé du problème.
Énoncé du problème: créer un modèle de régression linéaire simple pour prédire l'augmentation de salaire en utilisant des années d'expérience.
Commencez par importer les bibliothèques nécessaires
les bibliothèques requises sont des pandas, NumPy pour travailler avec des blocs de données, matplotlib, Seaborn pour les visualisations et le sklearn, statsmodels pour construire des modèles de régression.
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
import seaborn as sns
from scipy import stats
from scipy.stats import probplot
import statsmodels.api as sm
import statsmodels.formula.api as smf
from sklearn import preprocessing
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score
Une fois que nous avons terminé avec l'importation des bibliothèques, nous créons une trame de données pandas à partir du fichier CSV
df = pd.read_csv(« Données_Salaire.csv »)
Effectuer l'EDA (l'analyse exploratoire des données)
Les étapes de base de l'EDA sont:
- Identifier le nombre de fonctionnalités ou de colonnes
- Identifier les caractéristiques ou colonnes
- Identifier la taille de l'ensemble de données
- Identification des types de données des caractéristiques
- Vérifier si l'ensemble de données a des cellules vides
- Identifier le nombre de cellules vides par caractéristiques ou colonnes
- Gestion des valeurs manquantes et des valeurs aberrantes
- Codage des variables catégorielles
- Analyse graphique univariée, bivarié
- NormalisationLa normalisation est un processus fondamental dans diverses disciplines, qui vise à établir des normes et des critères uniformes afin d’améliorer la qualité et l’efficacité. Dans des contextes tels que l’ingénierie, Formation et administration, La standardisation facilite la comparaison, Interopérabilité et compréhension mutuelle. Lors de la mise en œuvre des normes, La cohésion est favorisée et les ressources sont optimisées, qui contribue au développement durable et à l’amélioration continue des processus.... et la mise à l’échelle
len(df.colonnes) # identifier le nombre de fonctionnalitésdf.colonnes # identifier les caractéristiques
df.shape # identify the size of of the datasetUn "dataset" o conjunto de datos es una colección estructurada de información, que puede ser utilizada para análisis estadísticos, machine learning o investigación. Los datasets pueden incluir variables numéricas, categóricas o textuales, y su calidad es crucial para obtener resultados fiables. Su uso se extiende a diversas disciplinas, como la medicina, la economía y la ciencia social, facilitando la toma de decisiones informadas y el desarrollo de modelos predictivos....df.dtypes # identify the datatypes of the featuresdf.isnull().values.any() # checking if dataset has empty cellsdf.isnull().sum() # identify the number of empty cellsNotre jeu de données a deux colonnes: Années d'expérience, Un salaire. Et les deux sont de type de données flottant. Ont 30 enregistrements et nous n'avons pas de valeurs nulles ou aberrantes dans notre ensemble de données.
Analyse graphique univariée
Pour l'analyse univariée, avoir Histogramme, graphique de densité, boîte à moustaches O violon, Oui Graphique QQ normal. Ils nous aident à comprendre la distribution des points de données et la présence de valeurs aberrantes.
Un diagramme de violonLe diagramme du violon est une représentation graphique qui combine les caractéristiques d’une boîte à moustaches et d’un graphique de densité. Utilisé pour visualiser la distribution d’un ensemble de données, montrant à la fois la médiane et la variabilité par leur forme, qui ressemble à un violon. Ce type de graphique est très utile dans l’analyse statistique, puisqu’il permet de comparer plusieurs distributions de manière claire et efficace.... es un método para trazar datos numéricos. C'est similaire à une boîte à moustaches, avec l'ajout d'un diagramme de densité de grain tourné de chaque côté.
Code Python:
# Histogram
# We can use either plt.hist or sns.histplot
plt.figure(figsize=(20,10))
plt.subplot(2,4,1)
plt.hist(df['YearsExperience'], density=False)
plt.title("Histogram of 'YearsExperience'")
plt.subplot(2,4,5)
plt.hist(df['Salary'], density=False)
plt.title("Histogram of 'Salary'")

# Density plot
plt.subplot(2,4,2)
sns.distplot(df['YearsExperience'], kde=True)
plt.title("Density distribution of 'YearsExperience'")
plt.subplot(2,4,6)
sns.distplot(df['Salary'], kde=True)
plt.title("Density distribution of 'Salary'")

# boxplot or violin plot
# A violin plot is a method of plotting numeric data. It is similar to a box plot,
# with the addition of a rotated kernel density plot on each side
plt.subplot(2,4,3)
# plt.boxplot(df['YearsExperience'])
sns.violinplot(df['YearsExperience'])
# plt.title("Boxlpot of 'YearsExperience'")
plt.title("Violin plot of 'YearsExperience'")
plt.subplot(2,4,7)
# plt.boxplot(df['Salary'])
sns.violinplot(df['Salary'])
# plt.title("Boxlpot of 'Salary'")
plt.title("Violin plot of 'Salary'")

# Normal Q-Q plot
plt.subplot(2,4,4)
probplot(df['YearsExperience'], plot=plt)
plt.title("Q-Q plot of 'YearsExperience'")
plt.subplot(2,4,8)
probplot(df['Salary'], plot=plt)
plt.title("Q-Q plot of 'Salary'")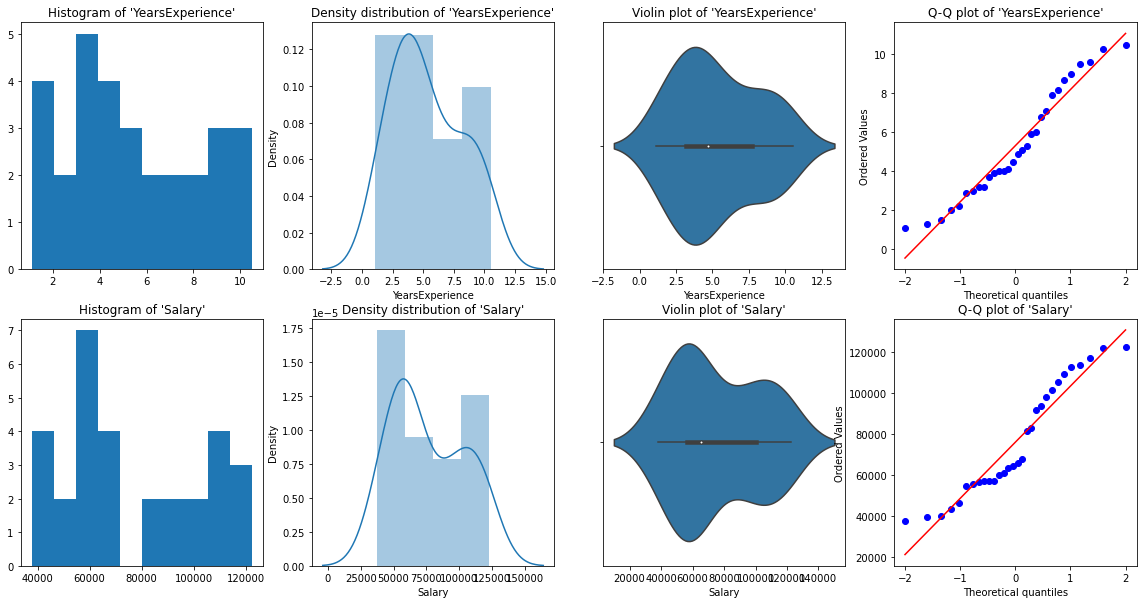
A partir des représentations graphiques ci-dessus, nous pouvons dire qu'il n'y a pas de valeurs aberrantes dans nos données, Oui YearsExperience looks like normally distributed, and Salary doesn't look normal. Nous pouvons vérifier cela en utilisant Shapiro Test.
Code Python:
# Def a function to run Shapiro test

# Defining our Null, Alternate Hypothesis
Ho = 'Data is Normal'
Ha="Data is not Normal"

# Defining a significance value
alpha = 0.05
def normality_check(df):
    for columnName, columnData in df.iteritems():
        print("Shapiro test for {columnName}".format(columnName=columnName))
        res = stats.shapiro(columnData)
#         print(res)
        pValue = round(res[1], 2)

        # Writing condition
        if pValue > alpha:
            print("pvalue = {pValue} > {alpha}. We fail to reject Null Hypothesis. {Ho}".format(pValue=pValue, alpha=alpha, Ho=Ho))
        else:
            print("pvalue = {pValue} <= {alpha}. We reject Null Hypothesis. {Ha}".format(pValue=pValue, alpha=alpha, Ha=Ha))


# Drive code
normality_check(df)
Notre instinct graphique était correct. Années L'expérience est normalement distribuée et le salaire n'est normalement pas distribué.
Affichage bivarié
pour les données numériques vs les données numériques, on peut tracer les graphiques suivants
- Nuage de points
- Graphique linéaire
- Carte de chaleur pour la corrélation
- Terrain commun
Code Python pour plusieurs parcelles:
# Scatterplot & Line plots
plt.figure(figsize=(20,10))
plt.subplot(1,3,1)
sns.scatterplot(data=df, x="YearsExperience", y="Salary", hue="YearsExperience", alpha=0.6)
plt.title("Scatter plot")
plt.subplot(1,3,2)
sns.lineplot(data=df, x="YearsExperience", y="Salary")
plt.title("Line plot of YearsExperience, Salary")
plt.subplot(1,3,3)
sns.lineplot(data=df)
plt.title('Line Plot')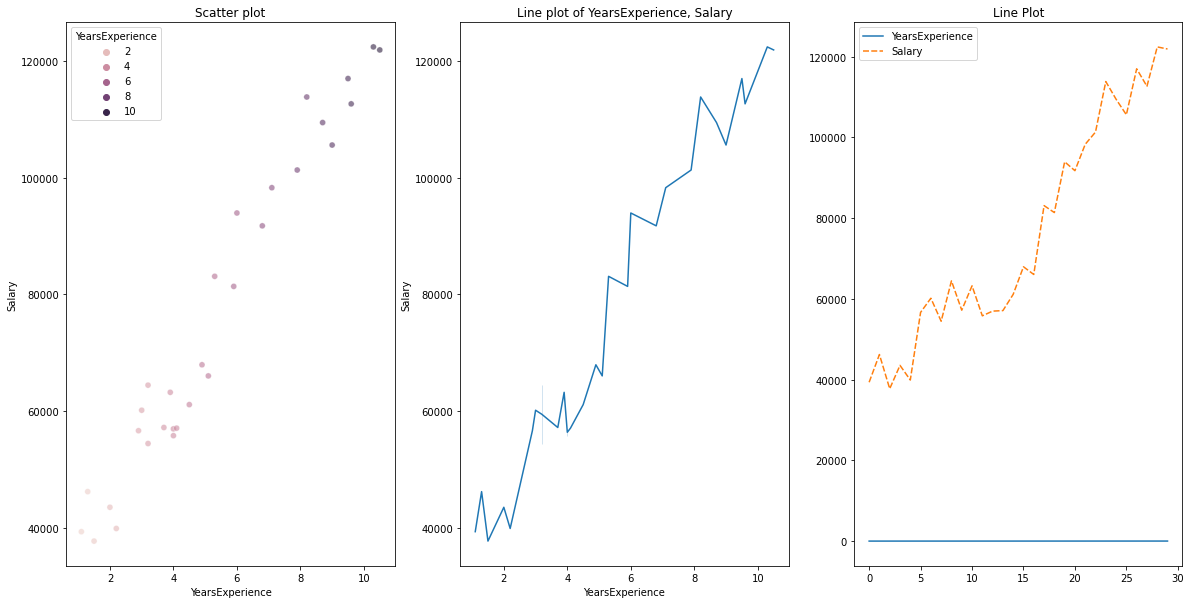
# heatmap
plt.figure(figsize=(10, 10))
plt.subplot(1, 2, 1)
sns.heatmap(data=df, cmap="YlGnBu", annot = True)
plt.title("Heatmap using seaborn")
plt.subplot(1, 2, 2)
plt.imshow(df, cmap ="YlGnBu")
plt.title("Heatmap using matplotlib")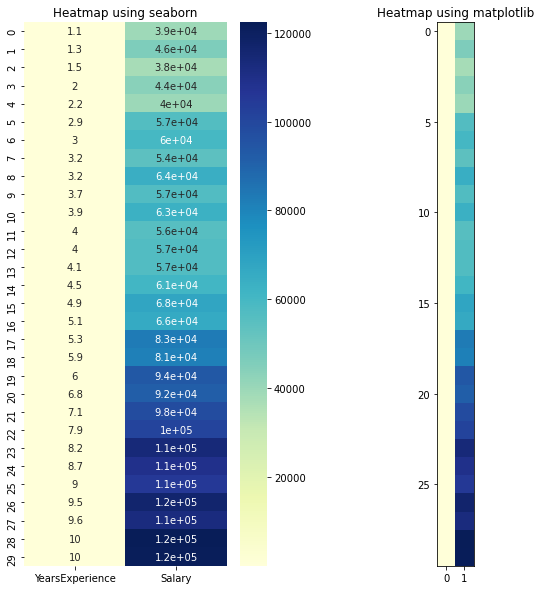
# Joint plot
sns.jointplot(x = "YearsExperience", y = "Salary", kind = "reg", data = df)
plt.title("Joint plot using sns")
# kind can be hex, kde, scatter, reg, hist. When kind='reg' it shows the best fit line.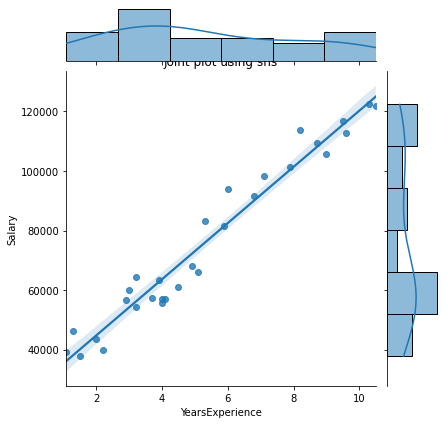
Vérifiez s'il existe une corrélation entre les variables à l'aide de df.corr ()
print("Correlation: "+ 'n', df.corr()) # 0.978 which is high positive correlation
# Draw a heatmap for correlation matrix
plt.subplot(1,1,1)
sns.heatmap(df.corr(), annot=True)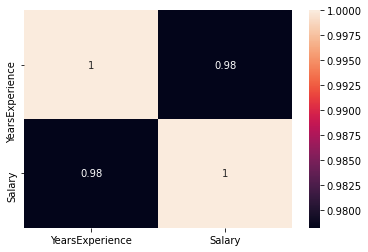
corrélation = 0,98, ce qui est une corrélation positive élevée. Esto significa que la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dependiente aumenta a medida que aumenta la variable independiente.
Normalisation
Comme nous pouvons le voir, il y a une grande différence entre les valeurs des colonnes YearsExperience, Un salaire. On peut utiliser Normalization pour modifier les valeurs des colonnes numériques dans l'ensemble de données pour utiliser une échelle commune, sans fausser les différences de plages de valeurs ni perdre d'informations.
Nous utilisons sklearn.preprocessing.Normalize normaliser nos données. Renvoie des valeurs entre 0 Oui 1.
# Create new columns for the normalized values
df['Norm_YearsExp'] = preprocessing.normalize(df[['YearsExperience']], axis=0)
df['Norm_Salary'] = preprocessing.normalize(df[['Salary']], axis=0)
df.head()
Régression linéaire avec scikit-learn
LinearRegression(): LinearRegression est conforme à un modèle linéaire avec des coefficients β = (1,…, p) pour minimiser la somme résiduelle des carrés entre les cibles observées dans l'ensemble de données et les cibles prédites par l'approximation linéaire.
def regression(df):
#     defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
    # print(x,y)

    # Instantiating the LinearRegression object
    regressor = LinearRegression()

    # Training the model
    regressor.fit(x,y)

    # Checking the coefficients for the prediction of each of the predictor
    print('n'+"Coeff of the predictor: ",regressor.coef_)

    # Checking the intercept
    print("Intercept: ",regressor.intercept_)

    # Predicting the output
    y_pred = regressor.predict(x)
#     print(y_pred)

    # Checking the MSE
    print("Mean squared error(MSE): %.2f" % mean_squared_error(y, y_pred))
    # Checking the R2 value
    print("Coefficient of determination: %.3f" % r2_score(y, y_pred)) # Evaluates the performance of the model # says much percentage of data points are falling on the best fit line

    # visualizing the results.
    plt.figure(figsize=(18, 10))
    # Scatter plot of input and output values
    plt.scatter(x, y, color="teal")
    # plot of the input and predicted output values
    plt.plot(x, regressor.predict(x), color="Red", linewidth=2 )
    plt.title('Simple Linear Regression')
    plt.xlabel('YearExperience')
    plt.ylabel('Salary')


# Driver code
regression(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
regression(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy
Nous atteignons une précision de 95,7% con scikit-apprendre, pero no hay mucho margeLa marge est un terme utilisé dans divers contextes, comme la comptabilité, Économie et imprimerie. En comptabilité, fait référence à la différence entre les revenus et les coûts, qui permet d’évaluer la rentabilité d’une entreprise. Dans le domaine de l’édition, La marge est l’espace blanc autour du texte d’une page, qui le rend facile à lire et offre une présentation esthétique. Sa bonne gestion est essentielle.. para comprender la información detallada sobre la relevancia de las características de este modelo. Construisons donc un modèle en utilisant statsmodels.api, statsmodels.formula.api
Régression linéaire à l'aide de statsmodel.formula.api (smf)
Les prédicteurs dans statsmodels.formula.api doivent être répertoriés individuellement. Et dans cette méthode, une constante est automatiquement ajoutée aux données.
def smf_ols(df):
    # defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
#     print(x)
    # train the model
    model = smf.ols('y~x', data=df).fit()
    # print model summary
    print(model.summary())

    # Predict y
    y_pred = model.predict(x)
#     print(type(y), type(y_pred))
#     print(y, y_pred)

    y_lst = y.Salary.values.tolist()
#     y_lst = y.iloc[:, -1:].values.tolist()
    y_pred_lst = y_pred.tolist()

#     print(y_lst)

    data = [y_lst, y_pred_lst]
#     print(data)
    res = pd.DataFrame({'Actuals':data[0], 'Predicted':data[1]})
#     print(res)

    plt.scatter(x=res['Actuals'], y=res['Predicted'])
    plt.ylabel('Predicted')
    plt.xlabel('Actuals')

    res.plot(kind='bar',figsize=(10,6))

# Driver code
smf_ols(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
# smf_ols(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy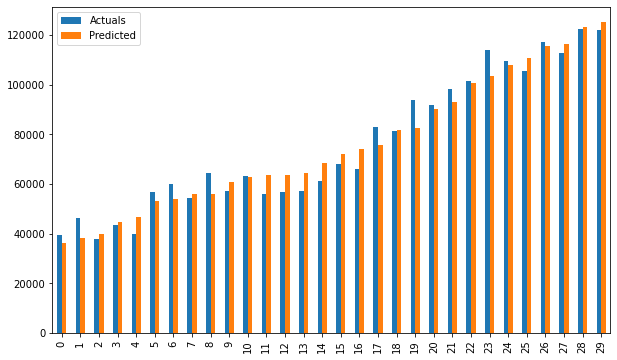
Régression à l'aide de statsmodels.api
Il n'est plus nécessaire de lister les prédicteurs individuellement.
statsmodels.regression.linear_model.OLS (même, exog)
endogest la variable dépendanteexogest la variable indépendante. Une interception n'est pas incluse par défaut et doit être ajoutée par l'utilisateur (en utilisant add_constant).
# Create a helper function
def OLS_model(df):
    # defining the independent and dependent features
    x = df.iloc[:, 1:2]
    y = df.iloc[:, 0:1]
    # Add a constant term to the predictor
    x = sm.add_constant(x)
#     print(x)
    model = sm.OLS(y, x)
    # Train the model
    results = model.fit()
    # print('n'+"Confidence interval:"+'n', results.conf_int(alpha=0.05, cols=None)) #Returns the confidence interval of the fitted parameters. The default alpha=0.05 returns a 95% confidence interval.
    print('n'"Model parameters:"+'n',results.params)
    # print the overall summary of the model result
    print(results.summary())

# Driver code
OLS_model(df[['Salary', 'YearsExperience']]) # 0.957 accuracy
OLS_model(df[['Norm_Salary', 'Norm_YearsExp']]) # 0.957 accuracy
Nous atteignons une précision de 95,7%, ce qui est plutôt bien 🙂
¿Qué dice la table de résuméLa "table de résumé" est un outil efficace qui condense les informations clés d'un sujet spécifique dans un format visuel et accessible. Utilisée dans divers domaines, comme l'éducation et la recherche, facilite la compréhension et l'analyse des données. Sa structure permet aux utilisateurs d'identifier rapidement les points essentiels, promoviendo una mejor retención del conocimiento y una comparación más sencilla entre diferentes conceptos o variables.... du modèle? ??
Il est toujours important de comprendre certains termes dans le tableau récapitulatif du modèle de régression afin que nous puissions connaître les performances de notre modèle et la pertinence des variables d'entrée.
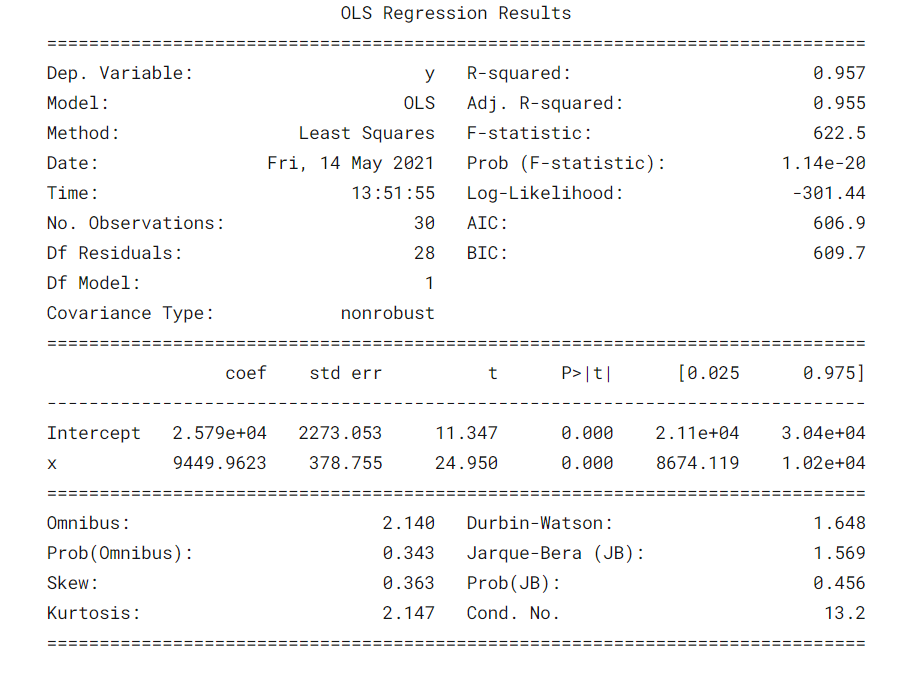
Certains paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... importantes que deben tenerse en cuenta son el valor de R cuadrado, Ajuster. Valeur R au carré, F statistique, prob (F statistique), coefficient d'interception et variables d'entrée, p> | t |.
- R-Squared est le coefficient de détermination. Une mesure statistique qui indique qu'une grande partie des points de données sont sur la ligne de meilleur ajustement. Une valeur de R au carré plus proche de 1 pour qu'un modèle aille bien.
- Ajuster. R-carré pénalise la valeur de R-carré si nous continuons à ajouter les nouvelles fonctionnalités qui ne contribuent pas à la prédiction du modèle. Si Adj. Valeur R au carré <Valeur R au carré, est un signe que nous avons des prédicteurs non pertinents dans le modèle.
- La estadística F o prueba F nos ayuda a aceptar o rechazar la hypothèse nulleL’hypothèse nulle est un concept fondamental en statistique qui établit une déclaration initiale sur un paramètre de population. Son but est d’être testé et, s’il est réfuté, nous permet d’accepter l’hypothèse alternative. Cette approche est essentielle dans la recherche scientifique, car il fournit un cadre pour évaluer les preuves empiriques et prendre des décisions fondées sur des données. Sa formulation et son analyse sont cruciales dans les études statistiques..... Comparez le modèle d'interception uniquement avec notre modèle avec fonctionnalités. L'hypothèse nulle est « tous les coefficients de régression sont égaux à zéro et cela signifie que les deux modèles sont égaux ». La hipótesis alternativa es ‘interceptar el único modelo es peor que nuestro modelo, ce qui signifie que nos coefficients ajoutés ont amélioré les performances du modèle. Si prob (F statistique) <0.05 et la statistique F est une valeur élevée, nous rejetons l'hypothèse nulle. Cela signifie qu'il existe une bonne relation entre les variables d'entrée et de sortie.
- coef affiche les coefficients estimés des caractéristiques d'entrée correspondantes
- T-test parle de la relation entre la sortie et chacune des variables d'entrée individuellement. L'hypothèse nulle est ‘el coeficiente de una característica de entrada es 0’. La hipótesis alternativa es ‘el coeficiente de una característica de entrada no es 0’. Si pvaleur 0.05.
Bon, maintenant nous savons comment tirer des inférences importantes à partir du tableau récapitulatif du modèle, Alors maintenant, regardons les paramètres de notre modèle et évaluons notre modèle.
Dans notre cas, la valeur de R au carré (0,957) est proche de Adj. La valeur de R au carré (0,955) est un bon signe que les caractéristiques d'entrée contribuent au modèle prédictif.
La statistique F est un nombre élevé et p (F statistique) c'est presque 0, ce qui signifie que notre modèle est meilleur que le modèle à intersection unique.
La valeur p du test t pour la variable d'entrée est inférieure à 0.05, il y a donc une bonne relation entre la variable d'entrée et la variable de sortie.
Donc, nous concluons en disant que notre modèle fonctionne bien ✔😊
Dans ce blog, Nous avons appris les bases de la régression linéaire simple (reflex), construire un modèle linéaire à l'aide de différentes bibliothèques Python et faire des inférences à partir du tableau récapitulatif des modèles statistiques OLS.
Les références:
Interprétation du tableau récapitulatif à partir du modèle statistique OLS
Visualisations: Histogramme, Graphique de densité, trame de violon, boîte à moustaches, Graphique QQ normal, Nuage de points, graphique linéaire, carte de chaleur, parcelle commune
Voir le carnet complet de mon GitHub dépôt.
J'espère que c'est un blog informatif pour les débutants. S'il vous plait, Veuillez voter si vous trouvez cela utile 🙌 Vos commentaires sont grandement appréciés. Bon apprentissage !! ??
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





