
introduction
Bonjour à tous pour cette introduction pratique à l'apprentissage automatique à l'aide de la régression linéaire simple.. Alors commençons:
Ensuite, faisons connaissance avec les termes qui seront utilisés:
Apprentissage automatique (ML): ML est une application d'intelligence artificielle (IL) qui donne aux systèmes la capacité d'apprendre et de s'améliorer automatiquement à partir de l'expérience sans être explicitement programmés. ML se concentre sur le développement de programmes informatiques qui peuvent accéder aux données et les utiliser pour apprendre par eux-mêmes.
Base de données: Une collection d'ensembles d'informations connexes qui est composé d'éléments séparés mais peut être manipulé comme une unité par un ordinateur.
Visualisation de données: C'est une représentation de données ou d'informations dans un graphique, graphique ou d'autres formats visuels utiles pour l'analyse, comme l'analyse prédictive, qui peut servir de visualisation utile pour présenter.
Nettoyage des données: C'est le processus de correction ou de suppression des données incorrectes, corrompu, mal formaté, doublons ou incomplets dans un ensemble de données.
Enseignement superviséL’apprentissage supervisé est une approche d’apprentissage automatique dans laquelle un modèle est formé à l’aide d’un ensemble de données étiquetées. Chaque entrée du jeu de données est associée à une sortie connue, permettre au modèle d’apprendre à prédire les résultats pour de nouvelles entrées. Cette méthode est largement utilisée dans des applications telles que la classification d’images, Reconnaissance vocale et prédiction de tendances, soulignant son importance dans...: Le modèle est entraîné en utilisant ‘des données étiquetées’. On dit que les ensembles de données contiennent des étiquettes qui incluent paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... d'entrée et de sortie. Pour simplifier: ‘Les données sont déjà étiquetées avec la réponse correcte’.
Régression linéaire simple: C'est un modèle de régression qui estime la relation entre la variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... variable indépendante et la variable dépendante en utilisant une ligne droite [y = mx + c], où les deux variables doivent être quantitatives.
Des modèles: Les résultats sont obtenus à l'aide d'algorithmes et sont composés de données du modèle et d'un algorithme de prédiction..
Modèle de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines....: En apprentissage supervisé, un algorithme ML crée un modèle en examinant de nombreux exemples et en essayant de trouver un modèle qui minimise les pertes et améliore la précision des prédictions.
Ce sont les quelques termes qui sont utilisés dans cet article et avec lesquels se familiariser. Commençons maintenant par l'analyse et la prédiction du modèle. Dans ce tutoriel, J'utiliserai des données supervisées et une régression linéaire simple pour l'analyse et la prédiction. L'objectif ultime est de prédire la taille d'une personne et de fournir son âge en utilisant le modèle entraîné aussi précisément que possible en utilisant les données disponibles.. J'ai utilisé le langage de programmation universel préféré pour ML, c'est-à-dire. Piton pour créer et former le modèle ML et l'environnement Google Colab.
Les étapes impliquées sont:
1. Importation d'ensembles de données.
2. Visualisation de données
3. Nettoyage des données
4. Construisez le modèle et entraînez-le
5.Faire des prédictions sur des données invisibles
—————————————————————————————————————————————————— ————————
1. Importation d'ensemble de données:
La première et la plus importante chose à faire est d'importer l'ensemble de données. Nous avons plusieurs sites Web qui ont ces ensembles de données à utiliser par n'importe qui. de la même manière, commençons par importer l'ensemble de données que nous allons utiliser dans ce tutoriel.

Cette seule ligne de code nous aide à obtenir les données utilisées pour le didacticiel directement à partir de l'URL.
Base de données <- Cliquez sur le lien pour obtenir l'ensemble de données qui est l'url mentionné ci-dessus.
2. Visualisation de données:
Dans cette étape, après avoir importé les données et les avoir montées avec Colab, obtenons un aperçu de l'ensemble de données en important un module appelé pandas. Étant donné que l'ensemble de données que nous avons a une extension de .pkl, on le voit juste par la fonction disponible dans la bibliothèque pandas.
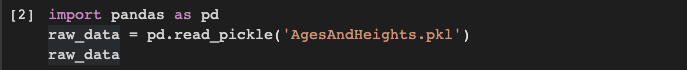
Nous importons la bibliothèque pour lire l'ensemble de données et le stockons dans une variable appelée données brutes. Ensuite, nous montrons le contenu de données brutes qui est sous forme de tableau.
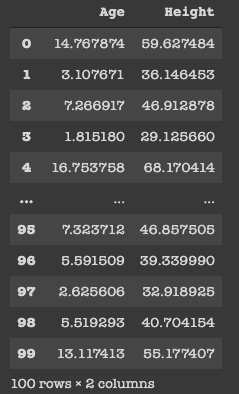
Nous pouvons voir les données que nous avons et ne contiennent que 2 Colonnes, a savoir, Âge (dans des années) et hauteur (en pouces) Oui 100 Lignes, qui est en fait la représentation d'une personne.
Cette seule ligne de code a un impact énorme sur la façon dont nous regardons l'ensemble de données. Nous n'avions qu'une vue numérique de l'ensemble de données, mais maintenant nous pouvons exécuter cette cellule pour obtenir une vue d'histogramme de l'ensemble de données, ce qui est très utile. Représente les données présentes dans les colonnes individuelles sous forme de graphiques individuels.
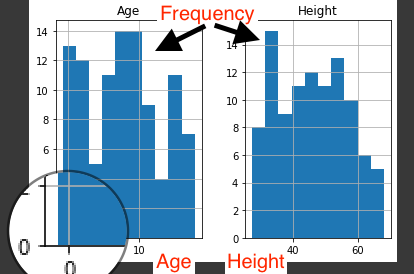
L'axe Y dans les deux graphiques fait référence à la fréquence et l'axe X représente l'âge et la taille respectivement..
3. Nettoyage des données:
Nous devons construire le modèle en utilisant des ensembles de données valides et nettoyer les données non comptables. Dans l'image ci-dessus, nous pouvons savoir qu'il y a des entrées qui ont un âge inférieur à zéro, ce qui n'a pas de sens. Donc, nous devons nettoyer ces données pour obtenir plus de précision.
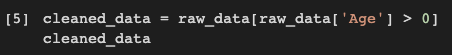
j'utilise des variables données_nettoyées pour stocker des valeurs d'âge valides et les afficher à l'utilisateur.
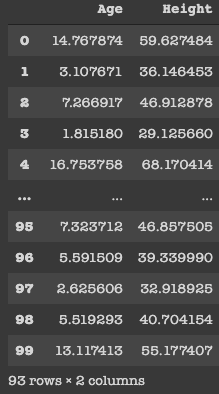
Initialement, nous avons eu 100 Lignes, mais après avoir fait le nettoyage des données, il est assez clair qu'il y a sept rangées qui ont un âge <0 et nous les avons supprimés. En tant que professionnel, nous ne sommes pas censés supprimer les données, puisque nous les réduisons et, donc, la précision de notre modèle est réduite. Pour faire simple, je viens de les supprimer.
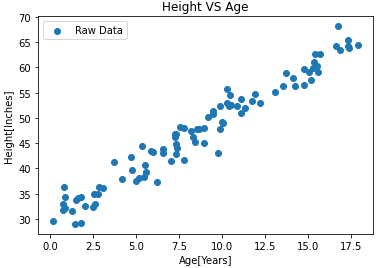
Visualisez des données propres: maintenant j'ai utilisé les données propres et je les ai visualisées sous forme de graphique.
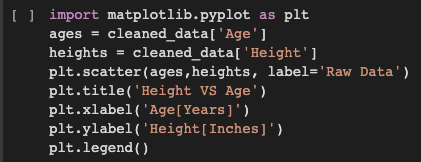
Pour tracer des graphiques Python, J'importe la bibliothèque matplotlib.pyplot. Je représente l'âge sur l'axe X et la taille sur l'axe Y. Les points sur le graphique se réfèrent aux données brutes.
4. Construisez le modèle et entraînez-le:
C'est là qu'intervient l'algorithme ML., c'est-à-dire, régression linéaire simple.
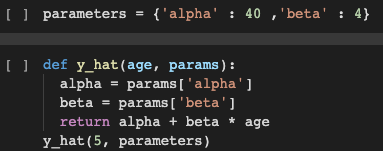
J'ai utilisé un dictionnaire appelé parameters qui a alfa Oui bêta comme clé avec 40 Oui 4 comme valeurs respectivement. j'ai aussi défini une fonction y_hat qui prend l'âge et les paramètres comme paramètres. Cette fonction utilise l'équation de base en ligne droite et renvoie y, c'est-à-dire, hauteur comme dans notre cas. Si nous passons les paramètres requis et exécutons la fonction, nous constatons que la taille que nous obtenons pour l'âge en entrée ne correspond pas. Donc, nous utilisons la fonction mentionnée ci-dessous pour faire pleuvoir le modèle.
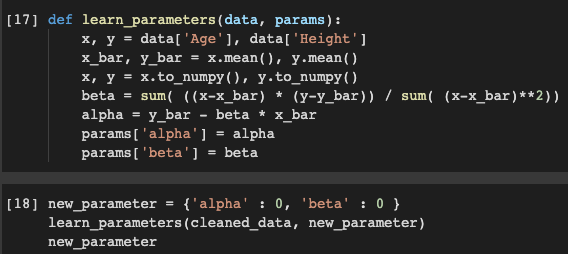
C'est là que nous utilisons une méthode pour trouver l'alpha et le bêta corrects. La fonction apprendre_paramètres vous acceptez données_nettoyées et un dictionnaire factice nouveau_paramètre qui peut avoir n'importe quelle valeur pour alpha et bêta. Ensuite, quand on les passe en arguments aux paramètres et que la fonction s'exécute, nous pouvons obtenir la valeur correcte de alpha et bêta qui est proche de 30 Oui 2 respectivement et remplacer les anciennes valeurs par les nouvelles.
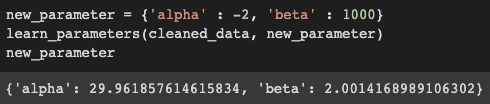
Nous avons trouvé avec précision les valeurs alpha et bêta, et notre prochain objectif est de former les données. Mais laissez-moi les valeurs prédites non entraînées à quel point elles sont précises.
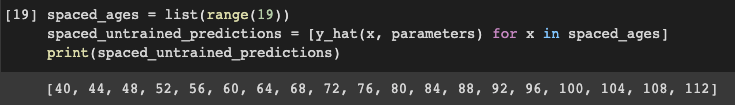
J'utilise une liste appelée spatiaux_âges qui a des valeurs de 0 une 18 (final – 1). Puis une autre liste appelée spaced_untrained_predictions qui a les valeurs prédites pour la hauteur utilise le y_hat fonction définie ci-dessus pour le prédire. Ces valeurs sont reportées sur un graphique et affichées.
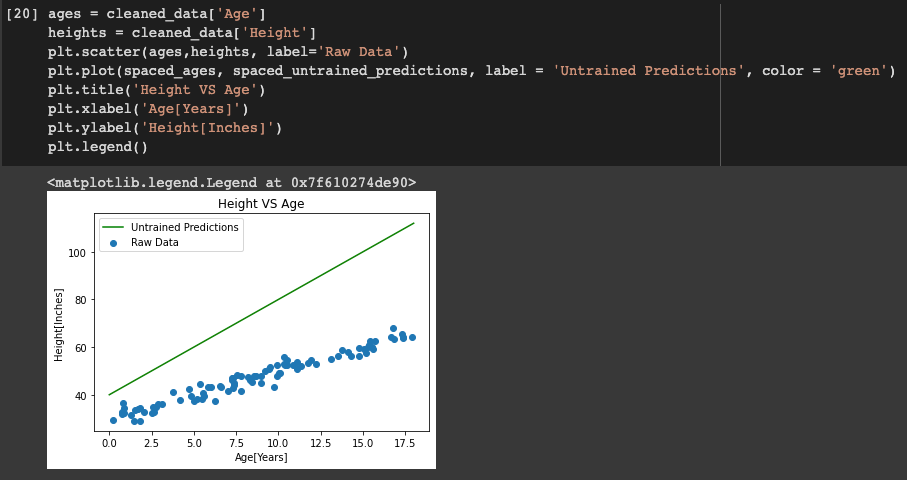
La ligne verte indique que le spaced_untrained_predictions ont beaucoup dévié des valeurs réelles et la précision est très mauvaise. Donc, il faut augmenter la précision pour laquelle on doit entraîner les données.
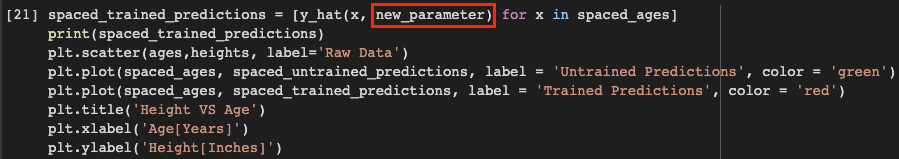
Alors au lieu d'utiliser paramètres nous utilisons nouveaux_paramètres car il contient la valeur exacte de alfa Oui bêta et le stocke dans une liste appelée spaced_trained_predictions. Ensuite, lorsque nous traçons un graphique pour cela, nous pouvons voir une différence visible et la précision a beaucoup augmenté. Donc, nous avons construit et entraîné avec succès le modèle. La preuve en sont les valeurs de spaced_trained_predictions et le graphique.
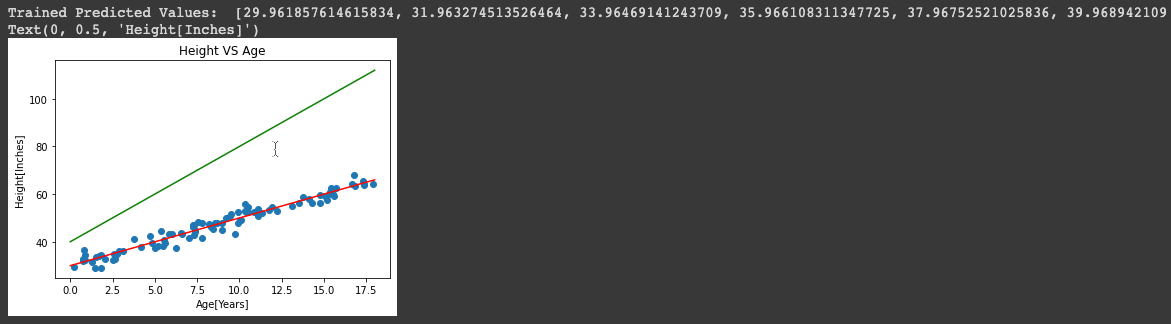
La ligne verte fait référence aux valeurs de spaced_untrained_predictions et Redline se réfère aux valeurs de spaced_trained_predictions.
5.Faire des prédictions sur des données invisibles:
Avec l'aide de ce modèle entraîné, maintenant nous pouvons faire des prédictions précises.
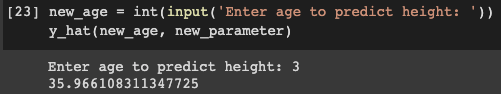
Ensuite, on peut voir que pour un âge donné on trouve la hauteur possible en pouces. Finalement, nous avons entraîné le modèle avec succès et avec la plus grande précision, qui est l'objectif final de ce tutoriel.
Comme référence, j'ai collé le Lien vers le bloc-notes tu joues avec lui. J'espère me connecter via LinkedIn aussi et partagez vos précieux commentaires. Restez à l'écoute pour plus de blogs de ce type😊.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





