
Cet article a été publié dans le cadre du Blogathon sur la science des données
introduction
Dans cet article, nous allons apprendre comment une des techniques de l'apprentissage en profondeurL'apprentissage en profondeur, Une sous-discipline de l’intelligence artificielle, s’appuie sur des réseaux de neurones artificiels pour analyser et traiter de grands volumes de données. Cette technique permet aux machines d’apprendre des motifs et d’effectuer des tâches complexes, comme la reconnaissance vocale et la vision par ordinateur. Sa capacité à s’améliorer continuellement au fur et à mesure que de nouvelles données lui sont fournies en fait un outil clé dans diverses industries, de la santé... utilisées pour trouver la précision de Ensemble de données sur le cancer du sein, mais je sais que la plupart des techniciens ne savent pas de quoi nous parlons, nous allons commencer par les bases, puis passer à notre sujet. En premier lieu, nous ferons une brève introduction à l'apprentissage en profondeur, puis, qu'est-ce que le neuronal rougeLes réseaux de neurones sont des modèles computationnels inspirés du fonctionnement du cerveau humain. Ils utilisent des structures appelées neurones artificiels pour traiter et apprendre des données. Ces réseaux sont fondamentaux dans le domaine de l’intelligence artificielle, permettant des avancées significatives dans des tâches telles que la reconnaissance d’images, Traitement du langage naturel et prédiction de séries temporelles, entre autres. Leur capacité à apprendre des motifs complexes en fait des outils puissants.. artificiel?
Qu'est-ce que l'apprentissage en profondeur?
Si nous parlons d'apprentissage en profondeur, il suffit de comprendre qu'il s'agit d'un sous-ensemble ou d'une sous-partie de l'apprentissage automatique. Nous pouvons dire que l'apprentissage en profondeur est une fonction d'IA qui imite le cerveau humain et traite ces données et crée des modèles à utiliser dans la prise de décision.
L'apprentissage en profondeur est le type d'apprentissage automatique qui ressemble un peu au cerveau humain. Utilise une structure multicouche d'algorithmes appelés réseaux de neurones. Leurs algorithmes tentent de copier les données que les humains analyseraient avec une certaine structure logique. Également connu sous le nom de réseau de neurones profonds ou d'apprentissage neuronal profond.
Dans l'apprentissage en profondeur, il existe un concept appelé réseau de neurones artificiels que nous aborderons brièvement ci-dessous.:
Neuronal artificiel rouge
Comme son nom l'indique, réseau de neurones artificiels, est le réseau de neurones artificiels. Fait référence à un modèle biologiquement inspiré dans le cerveau. On peut dire qu'il s'agit généralement d'un réseau informatique basé sur des réseaux de neurones biologiques qui construisent la structure du cerveau humain.
Vous savez tous que les neurones sont interconnectés les uns avec les autres dans notre cerveau et le processus de transmission des données. Il est similaire aux neurones du cerveau humain qui sont interconnectés les uns avec les autres, le réseau de neurones est constitué d'un grand nombre de neurones artificiels, appelées unités disposées en une séquence de couches. ayant les différentes couches de neurones et formant un réseau complet. ces neurones sont appelés nœuds.
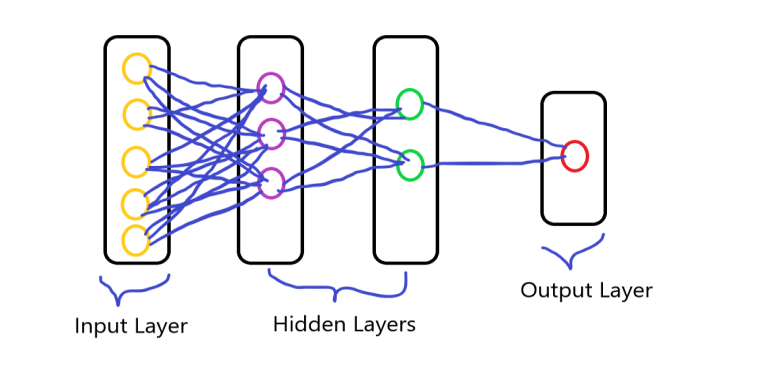
Il se compose de trois couches qui sont:
- Couche d'entréeLa "couche d'entrée" fait référence au niveau initial d’un processus d’analyse de données ou d’architectures de réseaux de neurones. Sa fonction principale est de recevoir et de traiter l’information brute avant qu’elle ne soit transformée par les couches suivantes. Dans le contexte de l’apprentissage automatique, Une bonne configuration de la couche d’entrée est cruciale pour garantir l’efficacité du modèle et optimiser ses performances dans des tâches spécifiques....
- Cape cachée
- Couche de sortieLa "Couche de sortie" est un concept utilisé dans le domaine des technologies de l’information et de la conception de systèmes. Il s’agit de la dernière couche d’un modèle logiciel ou d’une architecture qui est chargée de présenter les résultats à l’utilisateur final. Cette couche est cruciale pour l’expérience utilisateur, puisqu’il permet une interaction directe avec le système et la visualisation des données traitées....
Créer un ANN à l'aide d'un ensemble de données sur le cancer du sein
Passons maintenant à notre sujet, ici, nous allons prendre l'ensemble de données, puis créer le réseau de neurones artificiels et classer le diagnostic, premier, nous prenons un ensemble de données sur le cancer du sein, puis nous avançons.
Base de données: Ensemble de données sur le cancer du sein
Après avoir téléchargé le jeu de données, nous importerons les bibliothèques importantes qui sont nécessaires pour un traitement ultérieur.
Importer des bibliothèques
#importer des pandas
importer des pandas au format pd
#import numpy
importer numpy en tant que np
importer matplotlib.pyplot en tant que plt
importer seaborn en tant que qn
Ici, nous importons des pandas, NumPy et certaines bibliothèques d'affichage.
Maintenant, nous chargeons notre ensemble de données à l'aide de pandas:
df = pd.read_csv('Breast_cancer.csv')
df
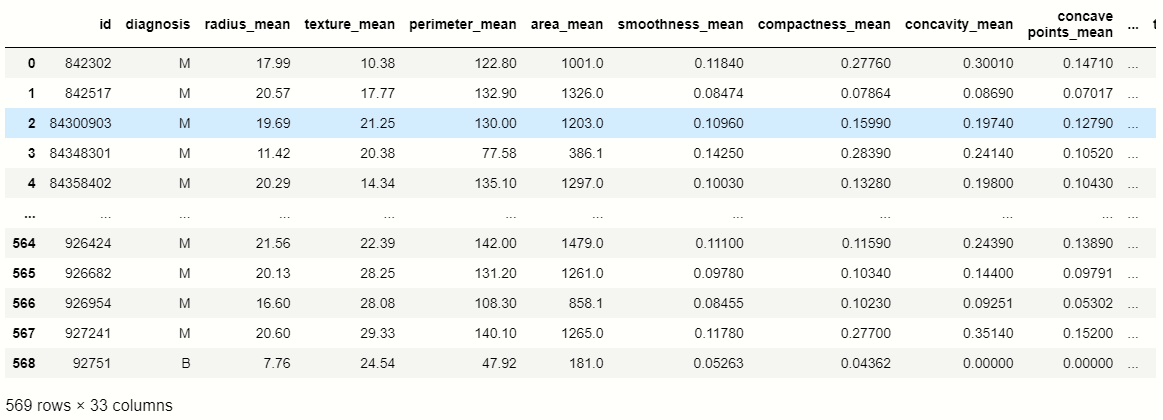
Dans cet ensemble de données, nous visons le ‘diagnostic’ colonne caractéristiques, nous vérifions donc le nombre de valeurs de cette colonne à l'aide de pandas:
# counting values of variables in 'diagnosis'
df['diagnosis'].value_counts()
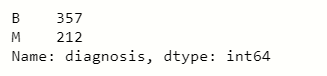
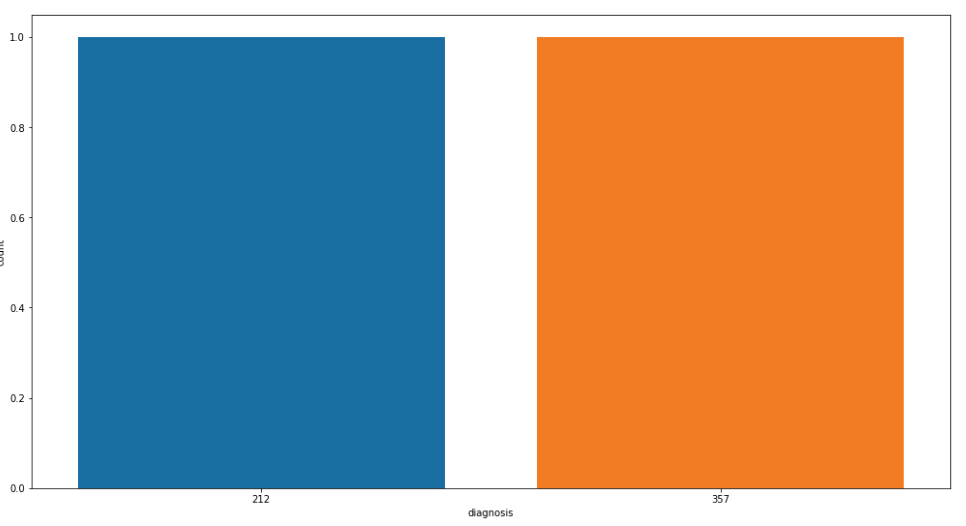
Maintenant, nous visualisons le comptage des valeurs des ‘colonnes de diagnostic: pour mieux comprendre
Afficher les comptes de valeur
plt.figure(taille de la figue=[17,9])
sb.countplot(df['diagnosis'].value_counts())
plt.show()
Valeurs nulles
Dans le jeu de données, nous devons vérifier les valeurs nulles présentes à l'intérieur des variables pour lesquelles nous utilisons des pandas:
df.isnull().somme()
Après avoir exécuté le programme, nous en arrivons à la conclusion que le nom de la fonction ‘Sans nom: 32’ contient toutes les valeurs nulles, donc nous supprimons ou supprimons cette colonne.
#fonction de chute
df.drop(['Unnamed: 32','id'],axe=1,inplace=True)
Variables indépendantes et dépendantes
Il est maintenant temps de diviser l'ensemble de données en variables indépendantes et dépendantes, pour cela on crée deux variables, l'un représente indépendant et l'autre représente dépendant.
# variables indépendantes
x = df.drop('diagnosis',axe=1)
#variables dépendantes
y = df.diagnostic
Gestion de la valeur catégorielle
Lorsque nous imprimons le variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendant Oui alors nous voyons qu'ils contiennent des données catégorielles et nous devons convertir les données catégorielles au format binaire pour un traitement ultérieur. Donc, nous utilisons Scikit learn Label Encoder pour encoder les données catégorielles.
de sklearn.preprocessing importer LabelEncoder
#créer l'objet
lb = LabelEncoder()
y = lb.fit_transform(Oui)
Division des données
Il est maintenant temps de diviser les données en parties de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... et tester:
de sklearn.model_selection importer train_test_split
xtrain,xtest,ytrain,ytest = train_test_split(X,Oui,test_size=0.3,random_state=40)
Mettre les données à l'échelle
Quand nous avons créé le réseau de neurones artificiels, nous devons redimensionner les données à des nombres plus petits car l'algorithme d'apprentissage en profondeur multiplie les poids et les données d'entrée des nœuds et cela prend beaucoup de temps, donc pour réduire ce temps, nous mettons les données à l'échelle.
escalader, nous utilisons scikit learn Grimpeur standard module, nous adaptons l'ensemble de données d'entraînement et de test:
#importation de StandardScaler
de sklearn.preprocessing importer StandardScaler
#création d'objet
sc = StandardScaler()
xtrain = sc.fit_transform(xtrain)
xtest = sc.transform(xtest)
De là, nous commençons à créer le réseau de neurones artificiels, pour cela nous importons les bibliothèques importantes qui sont utilisées pour créer ANN:
#importation de keras
importer des keras
#importation du module séquentiel
à partir de keras.models Importation séquentielle
# importer un module dense pour les couches cachées
de keras.layers importer Dense
#importation de fonctions d'activation
de keras.layers importer LeakyReLU,PRELU,ELU
à partir de keras.layers import Dropout
Création de calques
Après avoir importé ces bibliothèques, nous créons les trois types de couches:
- Couche d'entrée
- Cape cachée
- Couche de sortie
Premier, nous créons le modèle:
#création de modèle
classificateur = Séquentiel()
UNE séquentiel Le modèle est approprié pour une pile simple de couches où chaque couche a exactement un tenseurLes tenseurs sont des structures mathématiques qui généralisent des concepts comme les scalaires et les vecteurs. Ils sont utilisés dans diverses disciplines, y compris la physique, le génie et l'apprentissage automatique, pour représenter des données multidimensionnelles. Un tenseur peut être visualisé comme une matrice à plusieurs dimensions, ce qui permet de modéliser des relations complexes entre différentes variables. Leur polyvalence et leur capacité à gérer de grands volumes d'informations en font des outils fondamentaux dans l'analyse et le traitement des données.... une entrée et un tenseur de sortie.
Maintenant, nous créons les couches du réseau de neurones:
#première couche cachée
classificateur.ajouter(Dense(units=9,kernel_initializer="il_uniforme",activation='relu',input_dim=30))
#deuxième couche cachée
classificateur.ajouter(Dense(units=9,kernel_initializer="il_uniforme",activation='relu'))
# dernière couche ou couche de sortie
classificateur.ajouter(Dense(units=1,kernel_initializer="glorot_uniform",activation='sigmoid'))
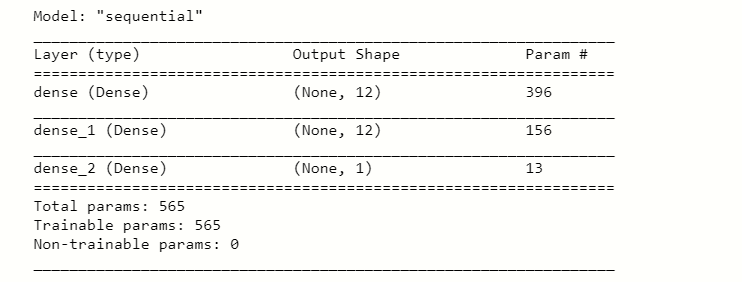
Dans le code suivant, la méthode Dense est utilisée pour créer les couches, dans lequel nous utilisons paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.... fondamentaux. Le premier paramètre est Nœuds de sortie, les Le second est l'initialiseur de la matrice des poids du noyau, le troisième est le fonction de réveilLa fonction d’activation est un composant clé des réseaux de neurones, puisqu’il détermine la sortie d’un neurone en fonction de son entrée. Son objectif principal est d’introduire des non-linéarités dans le modèle, vous permettant d’apprendre des modèles complexes dans les données. Il existe différentes fonctions d’activation, comme le sigmoïde, ReLU et tanh, chacun avec des caractéristiques particulières qui affectent les performances du modèle dans différentes applications.... et le dernier paramètre est le nombre de nœuds d'entrée ou le nombre de caractéristiques indépendantes.
Après avoir exécuté ce code, nous en prenons le résumé en utilisant:
#prise de résumé des couches
classificateur.résumé()
En remplissant ANN
Maintenant, nous compilons notre modèle avec l'optimiseur:
#compilation de l'ANN
classificateur.compile(optimiseur="Adam",perte ="binary_crossentropy",métriques=['précision'])
Adaptation de l'ANN aux données d'entraînement
Après avoir compilé le modèle, nous devons ajuster l'ANN dans les données d'entraînement pour la prédiction:
 #fitting the ANN to the training set
model = classifier.fit(xtrain,ytrain,batch_size=100,epochs=100)
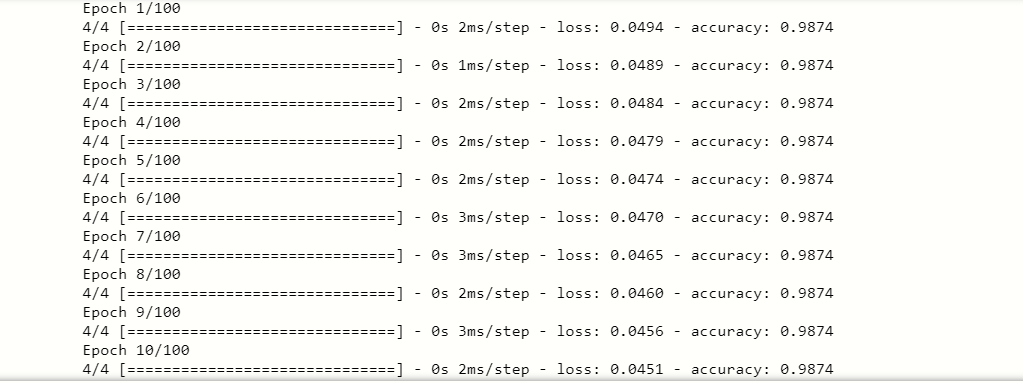
Les pour se adapter à() La méthode adapte l'ANN aux données d'entraînement, dans les paramètres, nous définissons les valeurs spécifiques de chaque variable en tant que taille de lot, époques, etc. Enfin, nous avons trouvé un excellent score de précision, notre modèle est donc parfaitement adapté aux données d'entraînement.
Après avoir formé les données, nous devons également tester le score de précision des données de test, voyons la suite:
#teste maintenant les données de test
y_pred = classifier.predict(test)
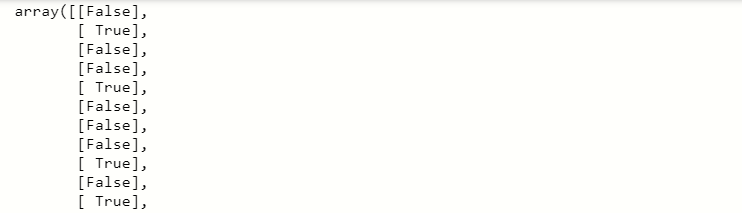
Lors de l'exécution de ce code, nous avons trouvé que y_pred contenait les différentes valeurs, nous convertissons donc les valeurs de prédiction en valeurs de seuil en tant que True, Faux.
#conversion de valeurs
y_pred = (y_pred>0.5)
imprimer(y_pred)
Matrice de ponctuation et de confusion
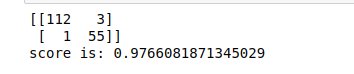
Maintenant, nous vérifions la matrice de confusion et le score des valeurs prédites.
à partir de sklearn.metrics importer confusion_matrix
de sklearn.metrics importer precision_score
cm = confusion_matrice(ytest,y_pred)
score = precision_score(ytest,y_pred)
imprimer(cm)
imprimer('score est:',But)
Production:-
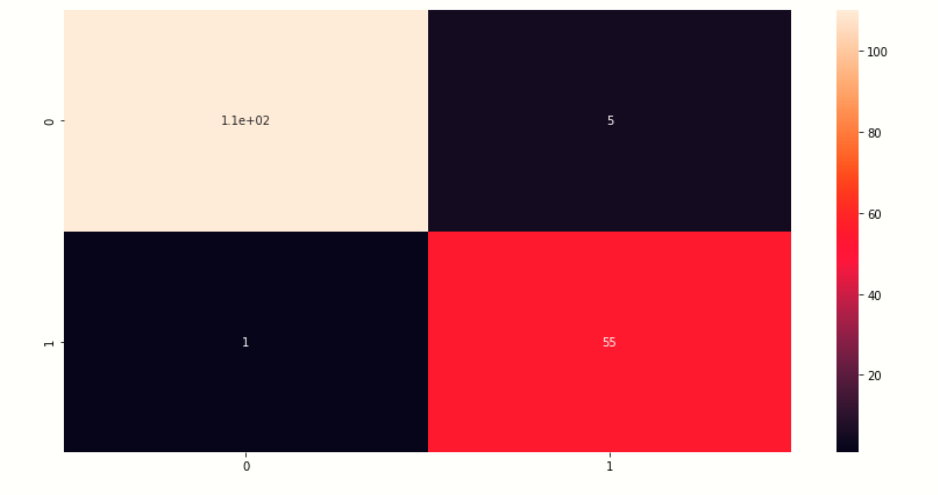
Visualiser la matrice de confusion
Ici, nous visualisons la matrice de confusion des valeurs de prédiction.
# création de la carte thermique de la matrice de comfusion
plt.figure(taille de la figue=[14,7])
qn.heatmap(cm,annot=Vrai)
plt.show()
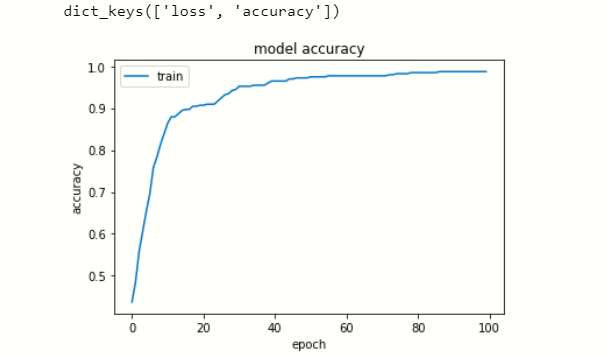
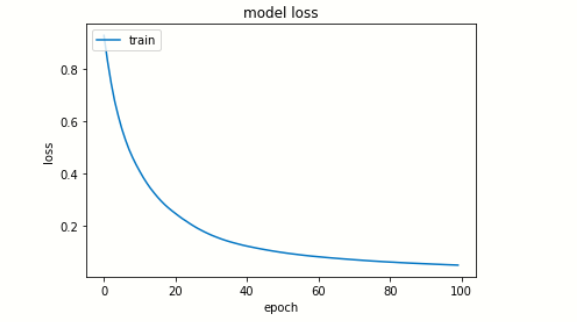
Afficher l'historique des données
Maintenant, nous visualisons la perte et la précision à chaque époque.
# liste toutes les données de l'historique
imprimer(model.history.keys())
# résumer l'histoire pour plus de précision
plt.plot(modèle.historique['précision'])
plt.titre('précision du modèle')
plt.ylabel('précision')
plt.xlabel('époque')
plt.légende(['entraînement', 'test'], loc ="en haut à gauche")
plt.show()
# résumer l'historique de la perte
plt.plot(modèle.historique['perte'])
plt.titre('perte du modèle')
plt.ylabel('perte')
plt.xlabel('époque')
plt.légende(['entraînement', 'test'], loc ="en haut à gauche")
plt.show()
Modèle d'épargne
Enfin, nous sauvegardons notre modèle.
#enregistrer le modèle
classificateur.sauvegarder('Nom_du_fichier.h5')
Note de fin
Ceci est mon premier ANN créé en deep learning, Je suis débutant en deep learning. Je fais de mon mieux pour expliquer cet article, j'éspère que vous aimez. Merci d'avoir lu cet article.
Connectez-vous avec moi sur LinkedIn: Profil
Merci.
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





