
Tout sera connecté au cloud et aux données … Tout cela sera médiatisé par le logiciel – Satya Nadella
introduction:
zing les résultats du modèle, ou essayer d'adapter le modèle, les éléments visuels facilitent l'interprétation du résultat.
Conventionnellement, Les images sont générées à partir d'un plug-in ou d'une bibliothèque et sont représentées dans des applications Web qui permettent à l'utilisateur final d'interagir et d'interpréter les résultats. Ces images peuvent être statiques ou partiellement interactives en silos.
Ensuite, Existe-t-il un moyen de réunir le meilleur de la visualisation de données et des technologies Web en un seul endroit? Oui, c'est possible et ces applications sont appelées applications de données.
la source: brillant.rstudio.com
Les applications de données permettent aux experts en la matière de, les décideurs commerciaux ou les consommateurs interagissent avec les données, grands et petits.
Ils diffèrent des rapports BI statiques en ce qu'ils offrent une interaction ad hoc via une interface intuitive adaptée au cas d'utilisation spécifique.. Elles se distinguent également de l analytiqueL’analytique fait référence au processus de collecte, Mesurer et analyser les données pour obtenir des informations précieuses qui facilitent la prise de décision. Dans divers domaines, Comme les affaires, Santé et sport, L’analytique peut identifier des modèles et des tendances, Optimiser les processus et améliorer les résultats. L’utilisation d’outils et de techniques statistiques de pointe est essentielle pour transformer les données en connaissances applicables et stratégiques.... automatisation basée sur l'apprentissage automatique, puisqu'ils sont conçus pour le « humain à vélo » par opposition à la prise de décision automatisée.
Cela les rend parfaits pour les analyses qui nécessitent une combinaison de données et d'intuition.. Ces applications facilitent l'exploration et la recherche de données. L'enquête sur les données se produit en réaction à un événement ou une anomalie spécifique.
L'utilisateur combine des données d'événement avec d'autres sources de données et des données historiques pour identifier la cause première et prendre des mesures. Cela conduit à des centaines ou des milliers de petites idées qui font une grande différence ensemble..
Il existe plusieurs bibliothèques à la fois dans R (Brillant) comme en python (Plotly Dash, Streamlit, Vague, etc.) créer des applications de données.
Dans cet article, Nous explorerons comment le brillant R peut être utilisé pour créer une application qui permet à l'utilisateur de diviser l'ensemble de données lors de la formation. / tester, construire plusieurs modèles, générer des métriques de modèle, visualiser le résultat et prendre la décision à la volée.
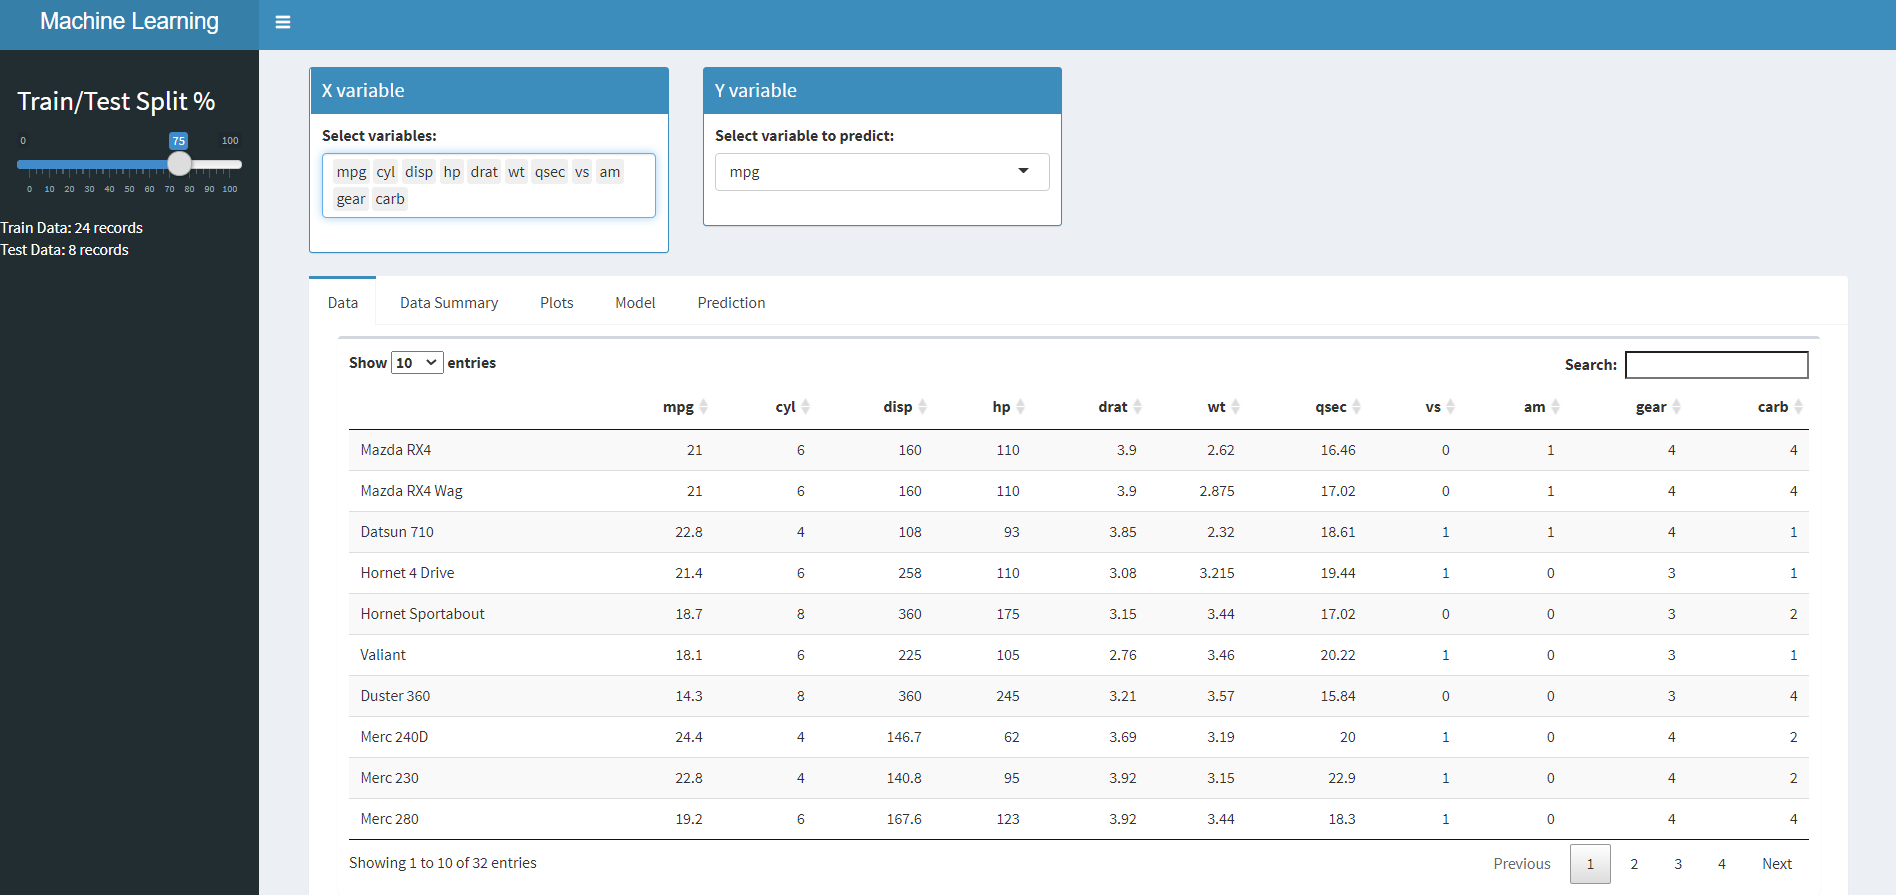
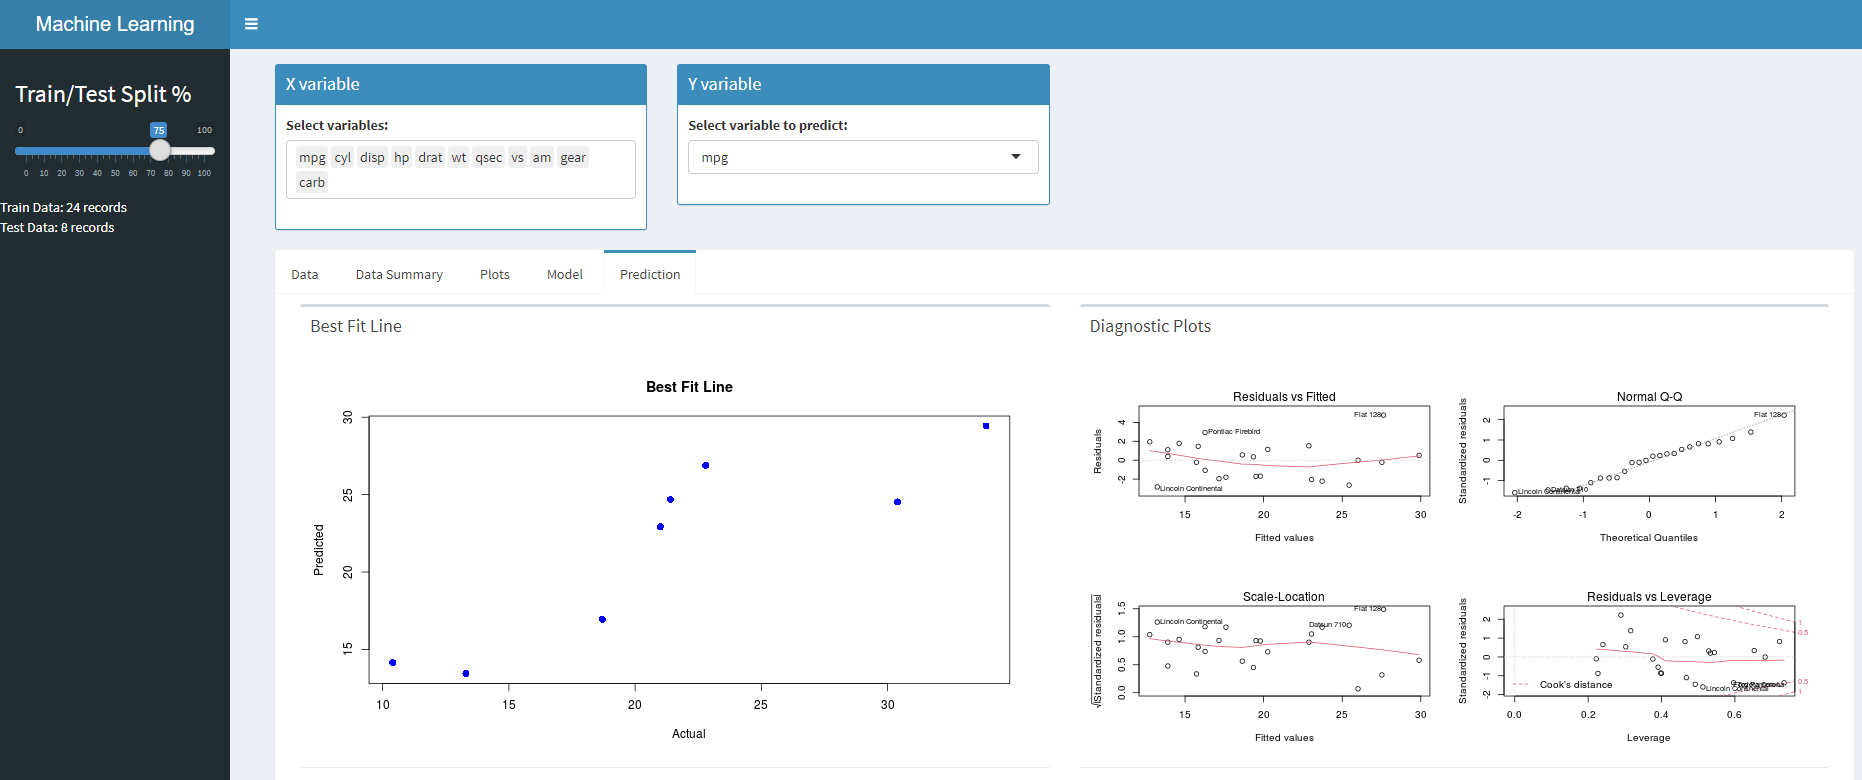
A la fin de cet article, nous allons créer l'application suivante. Veuillez noter les différents onglets sur la page d'accueil.
Départ:
Nous utiliserons mtcars ensemble de données pour cette application. Une fois que nous avons testé et vérifié que l'interface utilisateur et les fonctionnalités du serveur fonctionnent comme prévu, nous pouvons modifier l'ensemble de données et l'application devrait fonctionner aussi bien avec un traitement de données minimal si nécessaire.
Premier, installons le brillant et chargeons-le. L'application Shiny a principalement deux fichiers, une interface utilisateur et un serveur:
install.paquets("brillant")
une bibliothèque("brillant")
Interface utilisateur (Interface utilisateur):
C'est ici que vous définissez votre conception: signetsLes "signets" sont des outils linguistiques utilisés pour guider la structure et le flux d’un texte. Sa fonction principale est de mettre en évidence les relations entre les idées, en tant qu’ajout, contraste ou cause à effet. Voici quelques exemples courants "en outre", "cependant" Oui "donc". Ces éléments améliorent non seulement la cohésion de l’écriture, mais aussi faciliter la compréhension du lecteur, Rendre le contenu plus accessible et plus clair.... de position qui sera complétée à l'exécution à partir des données / graphiques traités par le serveur.
Serveur:
C'est là que vous écrivez la plupart de la logique, discussion sur les données, la disposition, etc. La plupart des tâches lourdes se font ici.
Ajoutons les deux champs déroulants, une pour les variables indépendantes et l'autre pour sélectionner l'objectif.
  tableau de bordCorps(
    fluidePage(
    boîte(
      selectEntrée(
        "SélectionnerX",
        étiquette = "Sélectionner des variables:",
        choix = noms(mtcars),
        multiple = VRAI,
        sélectionné = noms(mtcars)
      ),
      solidHeader = VRAI,
      largeur = "3",
      statut = "primaire",
      titre = "variable X"
    ),
    boîte(
      selectEntrée("SélectionnezY", étiquette = "Sélectionnez la variable à prédire:", choix = noms(mtcars)),
      solidHeader = VRAI,
      largeur = "3",
      statut = "primaire",
      titre = "Et variable"
    )
Ensuite, nous ajouterons un curseur sur le panneauUn panel est un groupe d’experts qui se réunit pour discuter et analyser un sujet spécifique. Ces forums sont courants lors des conférences, Séminaires et débats publics, où les participants partagent leurs connaissances et leurs points de vue. Les panneaux peuvent aborder une variété de domaines, De la science à la politique, et son objectif est d’encourager l’échange d’idées et la réflexion critique entre les participants.... côté pour diviser le jeu de données pour l'entraînement et le test en fonction de la sélection de l'utilisateur.
tableau de bordBarre latérale(
    curseurEntrée(
      "Curseur1",
      étiquette = h3("Séparation Train/Test %"),
      min = 0,
      max = 100,
      valeur = 75
    ),
    sortie de texte("cntTrain"),
    sortie de texte("cntTest"),
À présent, nous allons créer plusieurs onglets, dont chacun a des fonctionnalités spécifiques comme détaillé ci-dessous:
Données – Pour afficher les données brutes sous forme de tableau,
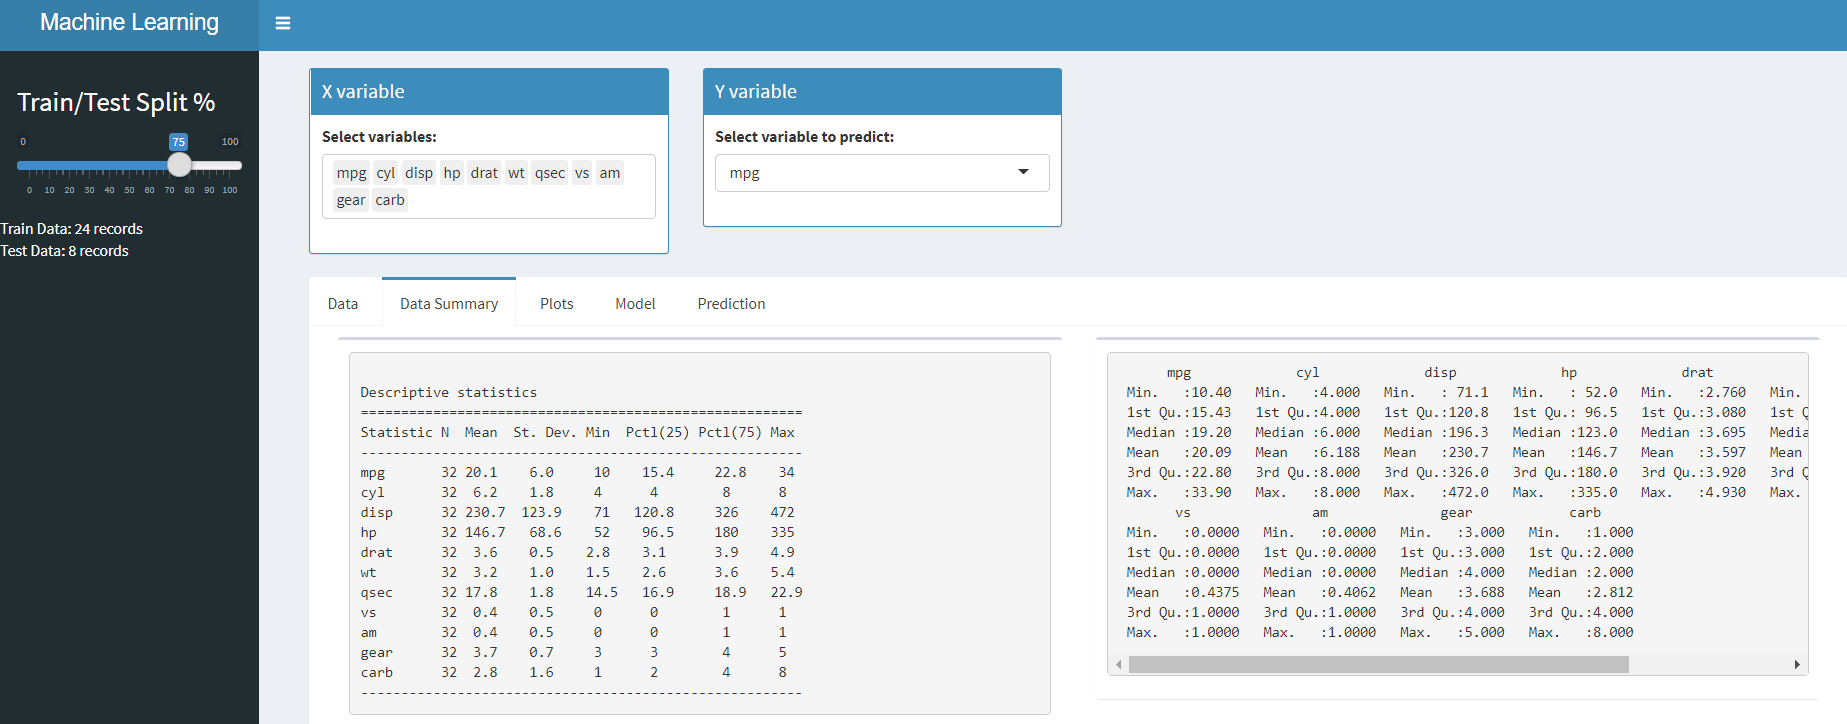
Résumé des données – Voir les statistiques de base de notre ensemble de données.
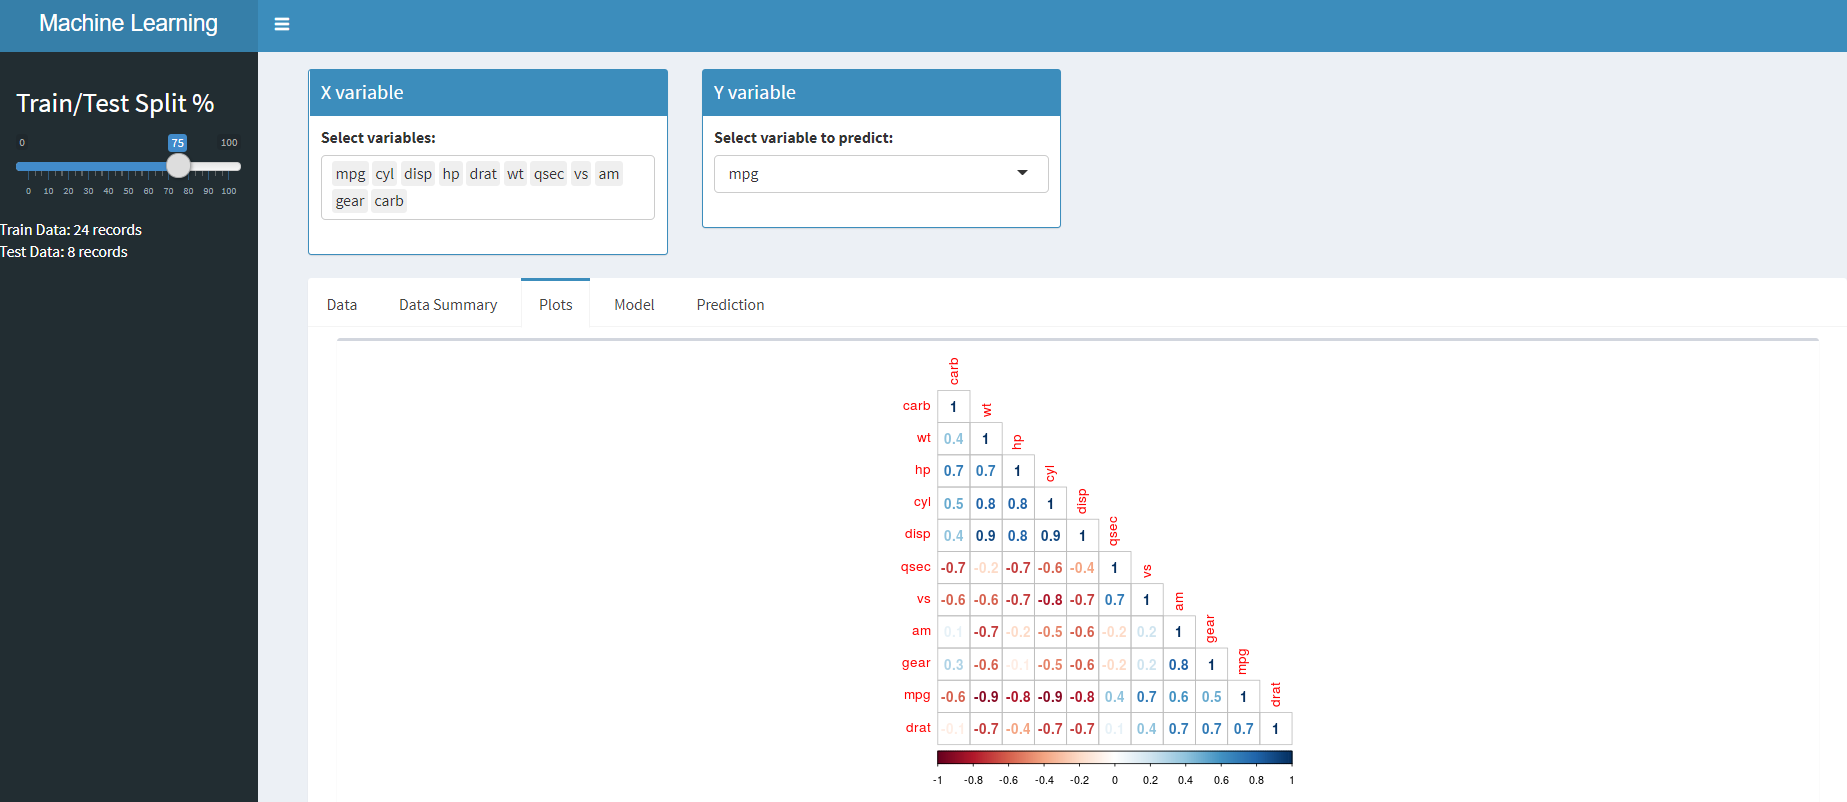
colis – Dans ce cas, nous allons créer un seul graphique de corrélation, mais des graphiques plus pertinents peuvent être ajoutés si nécessaire.
Modèle – Construire un modèle de régression linéaire basé sur la sélection par l'utilisateur des variables X, Et et divisions de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... / test
Prédiction – Prédire dans l'ensemble de test.
fluidePage(
      tabBox(
      identifiant = "tabset1",
      hauteur = "1000px",
      largeur = 12,
      tabPanel("Données",
               boîte(avec Spinner(Sortie DT(
                 "Données"
               )), largeur = 12)),
      tabPanel(
        "Résumé des données",
        boîte(avec Spinner(verbatimTextOutput("Somme")), largeur = 6),
        boîte(avec Spinner(verbatimTextOutput("Summ_old")), largeur = 6)
      ),
      tabPanel("Parcelles",
               boîte(avec Spinner(plotSortie(
                 "Corr"
               )), largeur = 12)),
      #boîte(avec Spinner(verbatimTextOutput("CorrMatrice")), largeur = 12),
      tabPanel(
        "Modèle",
        boîte(
          avec Spinner(verbatimTextOutput("Modèle")),
          largeur = 6,
          titre = "Résumé du modèle"
        ),
        boîte(
          avec Spinner(verbatimTextOutput("ImpVar")),
          largeur = 5,
          titre = "Importance variable"
        )
      ),
      #sortie de texte("corrélation_précision"),
      tabPanel(
        "Prédiction",
        boîte(avec Spinner(plotSortie("Prédiction")), largeur = 6, titre = "Meilleure ligne d'ajustement"),
        boîte(avec Spinner(plotSortie("parcelles résiduelles")), largeur = 6, titre = "Diagrammes de diagnostic")
      )
    )
Maintenant que nous avons créé notre interface utilisateur, nous procéderons à la mise en œuvre de la logique du serveur pour compléter l'interface utilisateur en fonction de la sélection de l'utilisateur: interactivité.
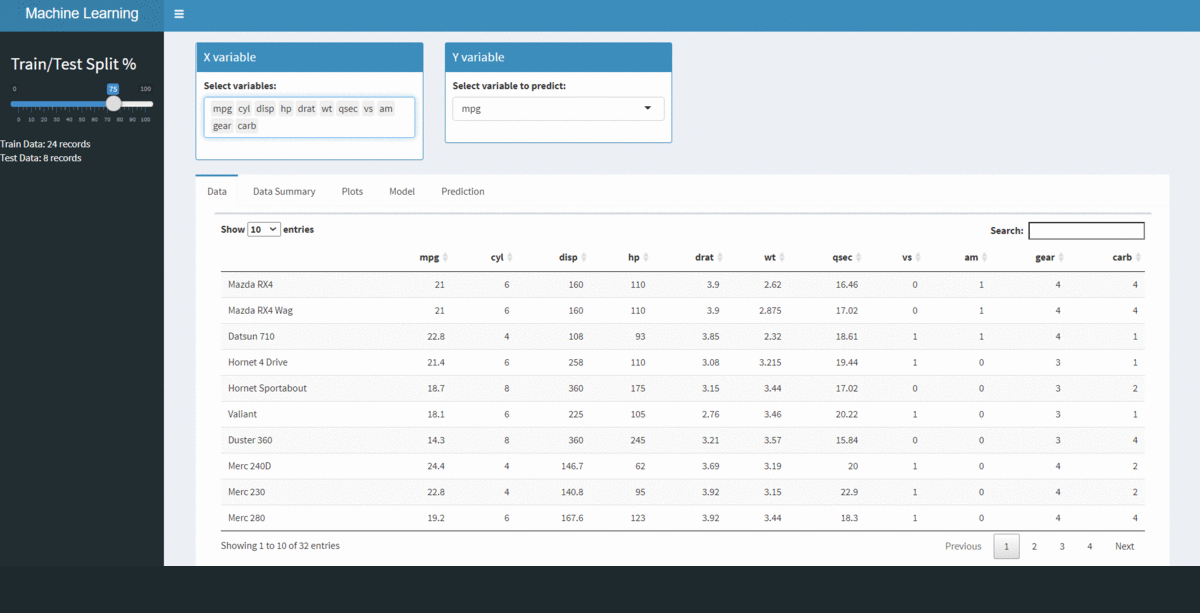
Remplir l'onglet données: Nous utilisons le cadre de données mtcars et l'enregistrons dans un objet par nom Jeu de données d'entrée puis remplissez l'interface utilisateur en utilisant renduDT () une fonction.
Veuillez noter l'utilisation d'accolades à la fin de l'objet Jeu de données d'entrée (). Ceci est fait car c'est un objet réactif, ce qui signifie que toute modification de cet objet aura un impact sur les autres endroits où il est référencé dans l'application.
 Jeu de données d'entrée <- réactif({
    mtcars
  })
 sortie$Données <- renduDT(Jeu de données d'entrée())
Sur des lignes similaires, Vous pouvez utiliser résumé() Oui corrélation fonction pour compléter le résumé et la corrélation des données terrain languette. Vous pouvez accéder au code côté serveur à partir de GitHub
Maintenant que nous avons vu comment les données sont complétées, construisons un modèle de régression linéaire et voyons aussi l'importance des variables.
F <- réactif({
    comme.formule(pâte(input$SelectY, "~."))
})
Linéaire_Modèle <- réactif({
    lm(F(), données = données d'entraînement())
  })
  sortie$Modèle <- renderPrint(sommaire(Linéaire_Modèle()))
  sortie$Modèle_nouveau <-
    renderPrint(
      astronome(
        Linéaire_Modèle(),
        taper = "texte",
        titre = "Résultats du modèle",
        chiffres = 1,
        dehors = "table1.txt"
      )
    )
 tmpImp <- réactif({
    #varImp(Linéaire_Modèle())
    lutin <- as.data.frame(varImp(Linéaire_Modèle()))
    lutin <- trame de données(global = imp$Overall,
                      noms = noms de lignes(lutin))
    lutin[ordre(imp$globale, décroissant = T),]
  })
  sortie$ImpVar <- renderPrint(tmpImp())
Implémentons la logique de la prédiction onglet où nous utiliserons notre modèle de la section précédente pour prédire l'ensemble de données de test et également générer des parcelles résiduelles.
  current_preds <-
    réactif({
      trame de données(cbind(courant = tmp(), prédit = price_predict()))
    })
  Ajuster <-
    réactif({
      (
        terrain(
          current_preds()$courant,
          current_preds()$prédit,
          pch = 16,
          cex = 1.3,
          col = "bleu",
          principal = "Meilleure ligne d'ajustement",
          xlab = "Réel",
          ylab = "Prévu"
        )
      )
    })
  sortie$Prédiction <- renderPlot(Ajuster())
  output$reidualPlots <- renderPlot({
    par(mfrow = c(2, 2)) # Changez la disposition du panneau en 2 X 2
    terrain(Linéaire_Modèle())
    par(mfrow = c(1, 1)) # Revenir à 1 X 1
  })
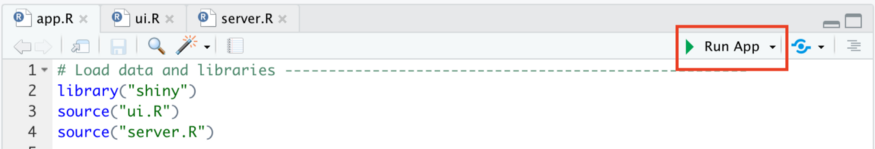
Vous pouvez accéder au code complet à partir de GitHub. Une fois que vous exécutez votre application, vous verrez la page d'accueil chargée. Vous pouvez naviguer vers différentes sections, apporter des modifications aux variables, créer des modèles et également prédire le test à la volée en suivant les étapes ci-dessous.
Paso 1:
Sélectionnez la division des données de train / test préféré sur le panneau de gauche.
Paso 2:
Sélectionnez les variables X et Y dans les menus déroulants.
Paso 3:
Naviguez vers les onglets respectifs pour voir le résultat:
conclusion:
L'objectif du blog était de créer une application de données utilisant R Shiny. Il s'agissait d'une implémentation très basique avec tous les contrôles intégrés.
Juste pour le rendre un peu plus intéressant, J'ai choisi d'apporter un aspect de création de modèles à l'application pour montrer comment les applications basées sur des modèles peuvent être créées en un rien de temps.
Avec les éléments brillants, vous pouvez utiliser des éléments HTML pour styliser votre contenu dans votre application.
Bon apprentissage !!!!
Vous pouvez vous connecter avec moi – Linkedin
Vous pouvez trouver le code pour référence: Github
Les références
https://shiny.rstudio.com/tutorial/
https://unsplash.com/
Les médias présentés dans cet article ne sont pas la propriété de DataPeaker et sont utilisés à la discrétion de l'auteur.





