
Cet article a été publié dans le cadre du Blogathon sur la science des données.
Avertissement: cet article est pour les débutants absolus, Je suppose que vous venez d'entrer dans le domaine de l'apprentissage automatique avec des compétences en mathématiques au lycée et un codage de base, mais ce n'est même pas obligatoire.
introduction
La régression linéaire est l'algorithme d'apprentissage automatique supervisé le plus basique. Surveiller dans le sens où l'algorithme peut répondre à votre question en fonction des données balisées que vous fournissez à l'algorithme. La réponse serait de savoir comment prédire les prix des maisons, classer les chiens par rapport aux chats. Ici, nous allons parler d'une tâche de régression utilisant la régression linéaire. À la fin, nous allons prédire les prix des maisons en fonction de la superficie de la maison.
Je ne veux pas vous ennuyer en jetant tous les mots du jargon de l'apprentissage automatique, Au début, alors permettez-moi de commencer par l'équation linéaire la plus basique. (y = mx + b) que nous savons tous de nos jours d'école.
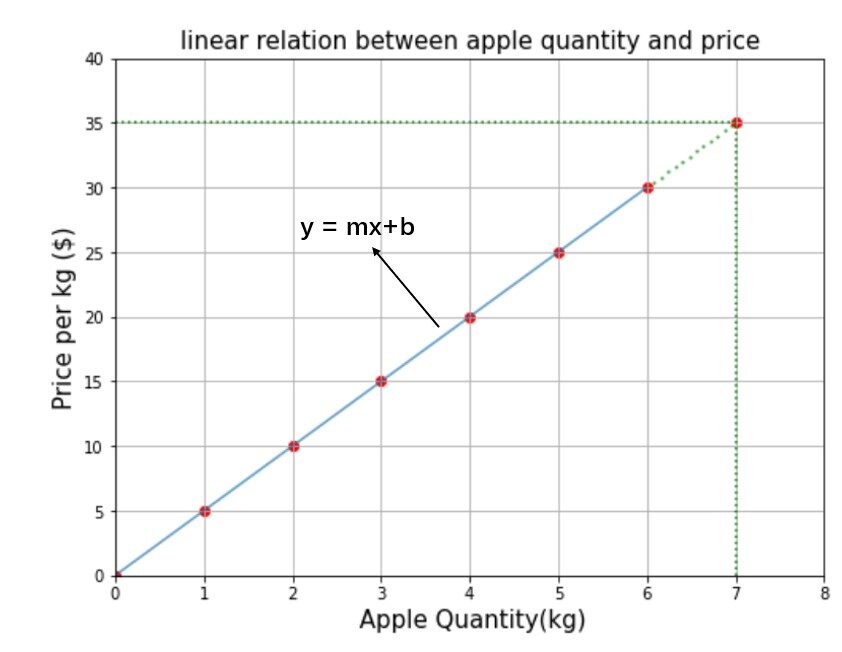
La chiffre"Chiffre" est un terme utilisé dans divers contextes, De l’art à l’anatomie. Dans le domaine artistique, fait référence à la représentation de formes humaines ou animales dans des sculptures et des peintures. En anatomie, désigne la forme et la structure du corps. En outre, en mathématiques, "chiffre" Il est lié aux formes géométriques. Sa polyvalence en fait un concept fondamental dans de multiples disciplines.... anterior muestra la relación entre la cantidad de manzana y el precio de costo. Combien devez-vous payer 7 kg de pommes? je sais que c'est facile. Et 1 frais de kilogrammes 5 $, ensuite 7 coût en kg 7 * 5 = 35 $ ou il tracera simplement une ligne perpendiculaire à partir du point 7 le long de l'axe des y jusqu'à ce qu'il touche l'équation linéaire et la valeur correspondante sur l'axe des y est la réponse comme indiqué. par la ligne pointillée verte sur le graphique. Mais nous allons résoudre en utilisant la formule d'une équation linéaire.

À présent, si je dois trouver le prix de 9,5 kg de pomme, selon notre modèle mx + b = 5 * 9.5 + 0 = $ 47.5 Est la réponse. À ce point, tu as peut-être compris que métro Oui B sont les principaux ingrédients de l'équation linéaire ou en d'autres termes métro Oui B Elles sont appelées paramètresLes "paramètres" sont des variables ou des critères qui sont utilisés pour définir, mesurer ou évaluer un phénomène ou un système. Dans divers domaines tels que les statistiques, Informatique et recherche scientifique, Les paramètres sont essentiels à l’établissement de normes et de standards qui guident l’analyse et l’interprétation des données. Leur sélection et leur manipulation correctes sont cruciales pour obtenir des résultats précis et pertinents dans toute étude ou projet.....
Malheureusement, ce n'est pas le problème de l'apprentissage automatique et l'équation linéaire n'est pas un algorithme de prédiction, mais heureusement la régression linéaire génère le résultat de la même manière que l'équation linéaire fait. L'objectif principal de l'algorithme de régression linéaire est de trouver la valeur de métro Oui B qui correspondent au modèle et après cela métro Oui b sont utilisés pour prédire le résultat des données d'entrée données.
Prédire les prix des maisons
Nous allons maintenant approfondir un peu la solution du problème de régression. Regardez les échantillons de données ou également nommés comme ejemplos de entraînementLa formation est un processus systématique conçu pour améliorer les compétences, connaissances ou aptitudes physiques. Il est appliqué dans divers domaines, Comme le sport, Éducation et développement professionnel. Un programme d’entraînement efficace comprend la planification des objectifs, Pratique régulière et évaluation des progrès. L’adaptation aux besoins individuels et la motivation sont des facteurs clés pour obtenir des résultats réussis et durables dans toutes les disciplines.... donné dans la figure ci-dessous.
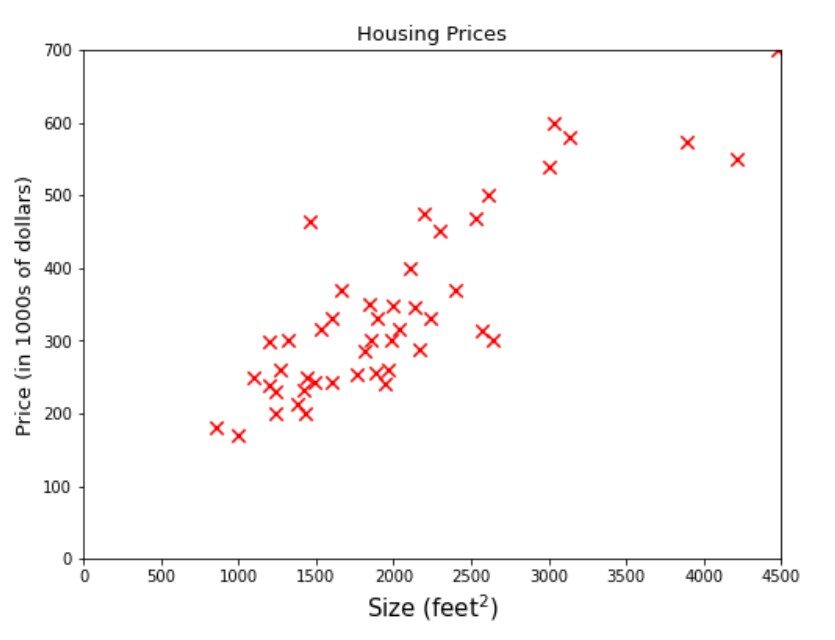
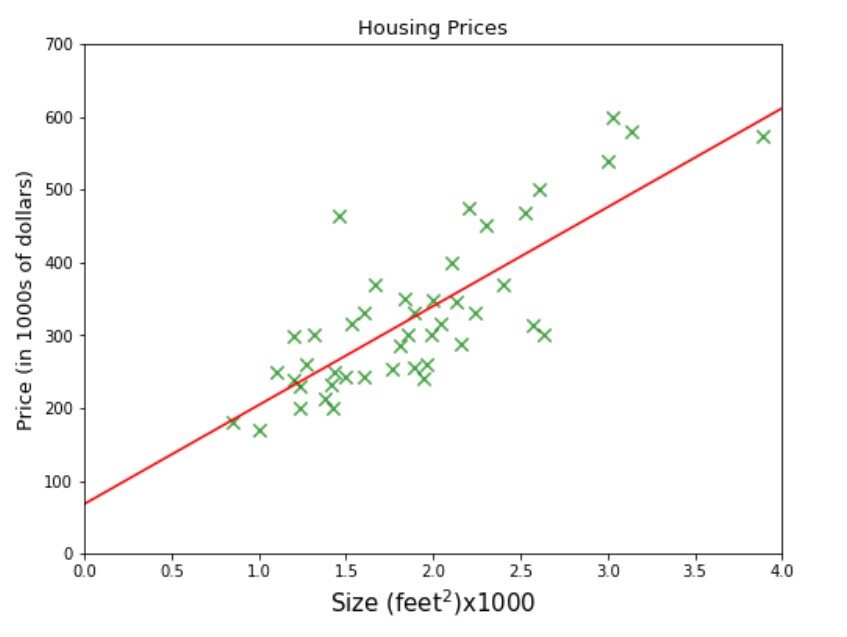
Le nom d'une entreprise A B C vous offre un Les données sur le taille de la maison Oui son prix. L'entreprise exige leur fournir un modèle d'apprentissage automatique qui peut prévoir les prix des maisons pour tout donné Taille. Disons quel serait le meilleur prix estimé pour une zone de 3000 pieds carrés. Si vous pensez à enrouler une ligne quelque part entre l'ensemble de données et tracez une ligne verticale à partir de 3000 sur l'axe des x jusqu'à ce qu'il touche la ligne puis la valeur correspondante sur l'axe des y, c'est-à-dire 470 serait la réponse, alors tu es sur la bonne voie, est représenté par la ligne pointillée verte dans la figure ci-dessous.
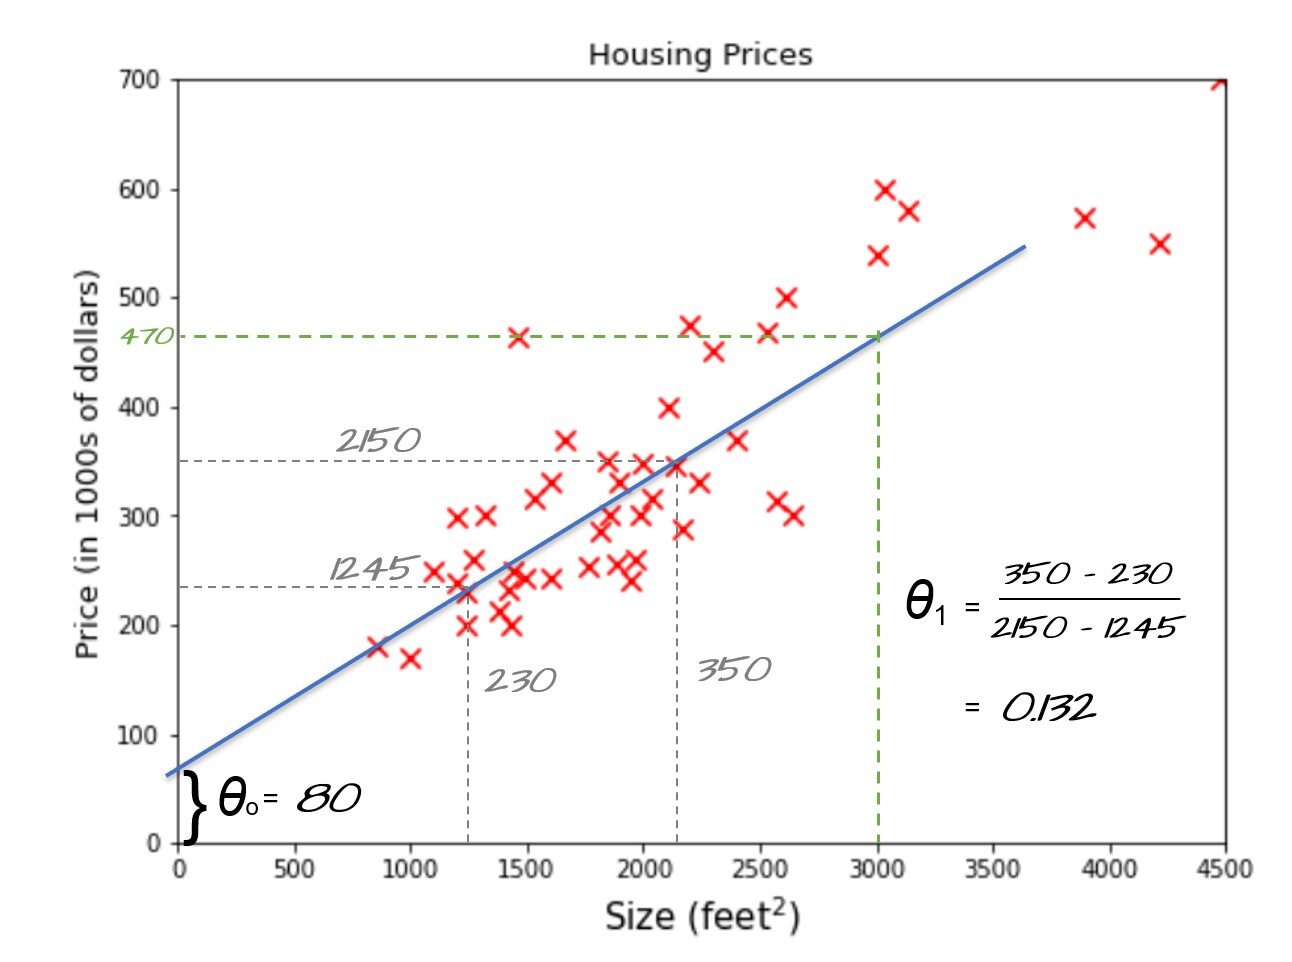
Faisons-le autrement, si on pouvait trouver l'équation de la droite y = mx + b que nous utilisons pour ajuster les données représentées par la ligne oblique bleue, alors nous pouvons facilement trouver le modèle qui peut prédire les prix des logements pour une zone donnée. . Basé sur le jargon de l'apprentissage automatique y = mx + b On l'appelle aussi fonction d'hypothèse où myb peut être représenté par theta0 et theta1 respectivement. theta0 est aussi appelé terme de biais et thêta1, thêta2, .. ils s'appellent pesos.
Voir la ligne bleue dans l'image ci-dessus. Lors du prélèvement de deux échantillons qui se touchent ou très près de la ligne, nous pouvons trouver le thêta1 (en attendant) = 0.132 Oui zéro thêta = 80 comme le montre l'image. Nous pouvons maintenant utiliser notre fonction d'hypothèse pour prédire le prix de l'immobilier pour une taille de 3000 pieds carrés, c'est-à-dire. 80 + 3000 * 0,132 = 476. $ 476,000 pourrait être le meilleur prix estimé pour une maison de 3000 pieds carrés et cela peut être un moyen raisonnable de préparer un modèle d'apprentissage automatique lorsque vous venez de terminer 50 échantillons et avec seulement une caractéristique (Taille).
Mais l'ensemble de données du monde réel pourrait être de l'ordre de milliers voire de millions et le nombre d'entités pourrait varier entre (5–100) ou même en milliers. À ce moment-là, notre intuition ne sera pas utile pour trouver des milliers de paramètres simplement en regardant un ensemble de données, c'est pourquoi nous avons besoin d'un algorithme d'apprentissage automatique pour effectuer un calcul aussi complexe. Prenez une tasse de café, rafraîchissez-vous et revenez car à partir de maintenant vous comprendrez comment fonctionne l'algorithme et vous serez initié à beaucoup de nouvelles terminologies. Préparer!!
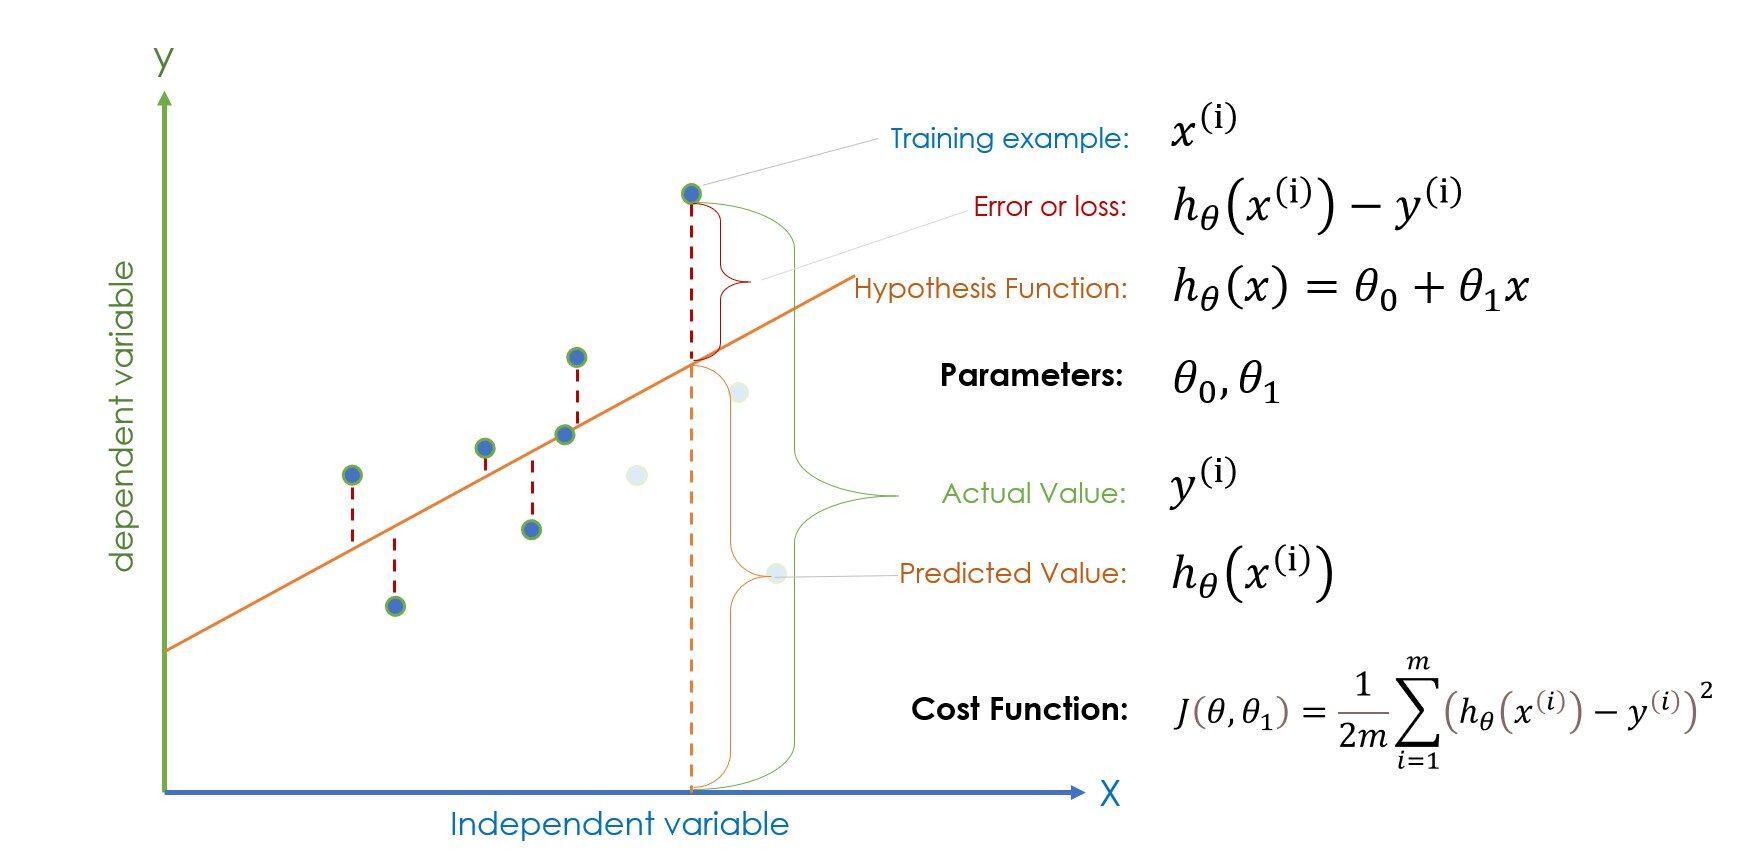
Noter: (je) dans l'équation représente le i-ième exemple d'apprentissage, pas le pouvoir.
Si les terminologies données dans la figure ci-dessus vous semblent extraterrestres, prenez quelques minutes pour vous familiariser et essayez de trouver un lien avec chaque terme. Si vous savez dans une certaine mesure, allons-nous en. Une fois les valeurs des paramètres, c'est-à-dire terme de biais Oui thêta1 initialiser au hasard, la fonction d'hypothèse est prête pour la prédiction, et puis le Erreur (|valeur prédite – valeur actuelle|) est calculé pour vérifier si le paramètre initialisé de manière aléatoire donne la prédiction correcte ou non.
Si l'erreur est trop élevée, puis l'algorithme met à jour les paramètres avec une nouvelle valeur, si l'erreur est à nouveau élevée, mettra à jour les paramètres avec la nouvelle valeur à nouveau. L'algorithme continue ce processus jusqu'à ce que l'erreur soit minimisée. À minimiser l'erreur nous avons une fonction spéciale appelée Descente de penteLe gradient est un terme utilisé dans divers domaines, comme les mathématiques et l’informatique, pour décrire une variation continue de valeurs. En mathématiques, fait référence au taux de variation d’une fonction, pendant la conception graphique, S’applique à la transition de couleur. Ce concept est essentiel pour comprendre des phénomènes tels que l’optimisation dans les algorithmes et la représentation visuelle des données, permettant une meilleure interprétation et analyse dans... mais avant ça, comprenons ce que Fonction de coût c'est et comment ça marche?
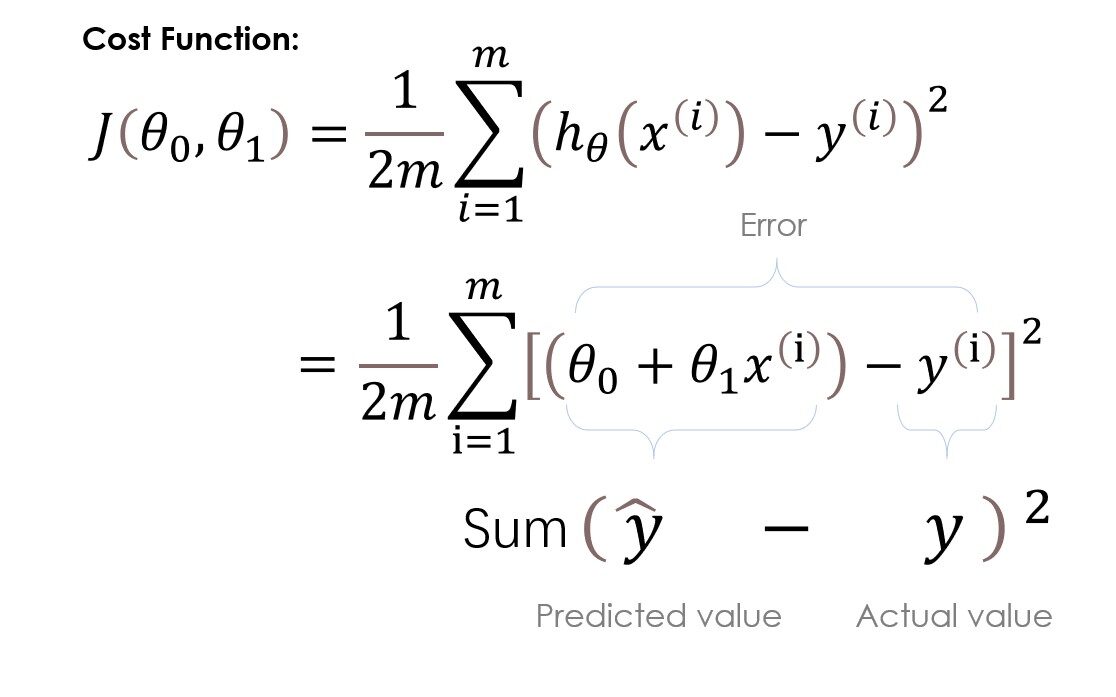
Ici, dans la fonction de coût, nous essayons de trouver le carré du différences entre la valeur prédite et la valeur réelle de chaque exemple d'entraînement, puis ajoutez tous les différences ensemble ou en d'autres termes, nous trouvons le carré d'erreur de chacun exemple de formation, puis résumer toutes les erreurs ensemble. La sortie que nous obtenons est simplement la moyenne erreur au carré d'un ensemble particulier de paramètres. D'accord, plus de mots, faisons le calcul. Pour simplifier le calcul, nous n'utiliserons qu'un seul paramètre thêta1 et un ensemble de données très simple.
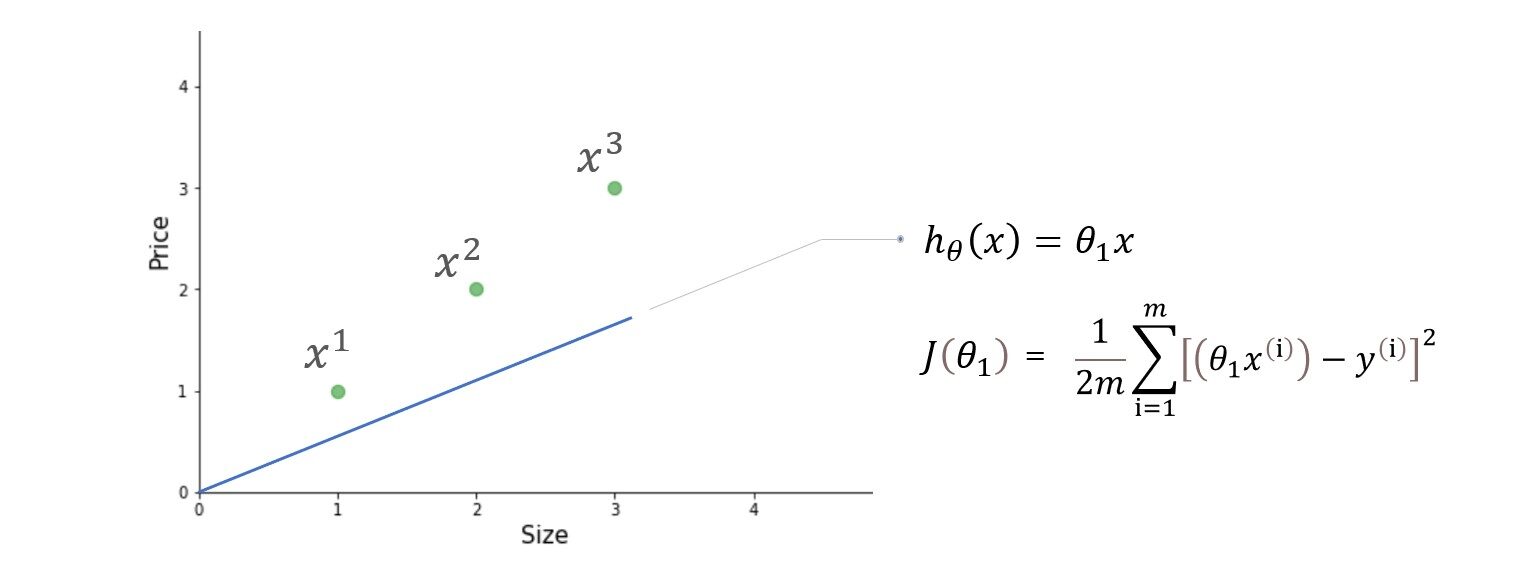
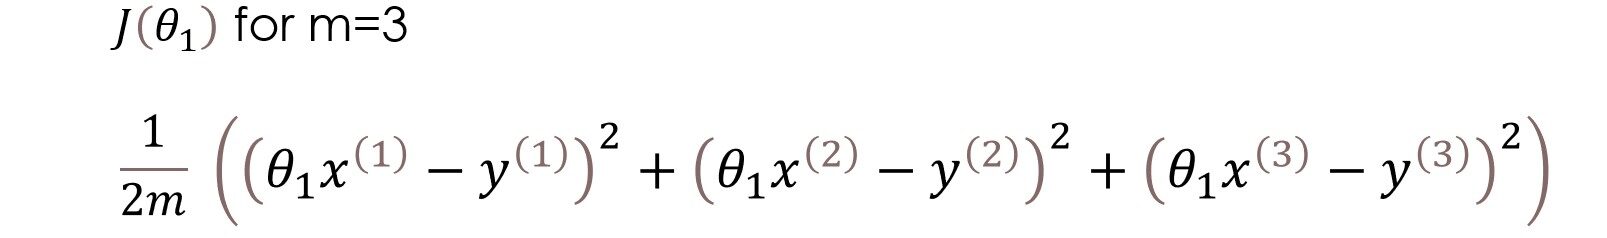
Nous avons trois exemples de formation (X1 = 1, y1 = 1), (X2 = 2, y2 = 2) Oui (X3 = 3, y3 = 3). la figure de gauche est la fonction d'hypothèse et la figure de droite est la fonction de coût représentée graphiquement pour différentes valeurs du paramètre.
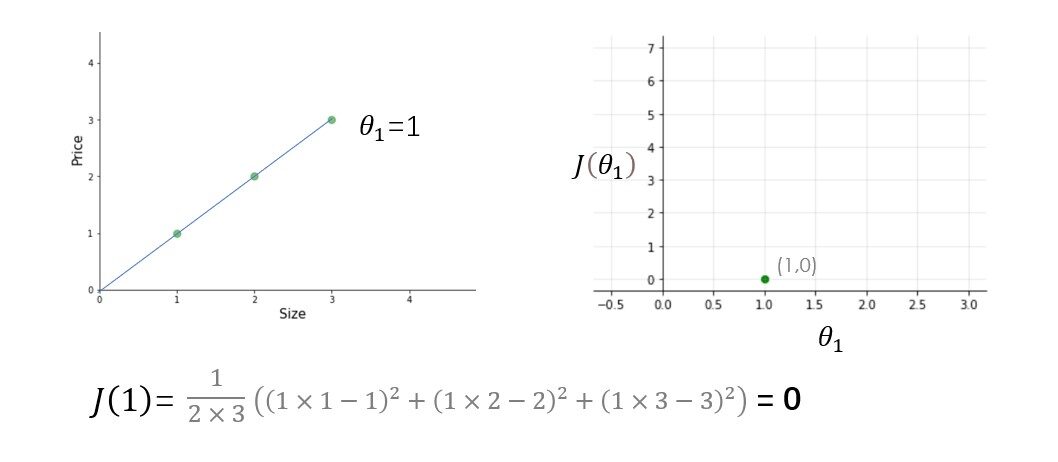
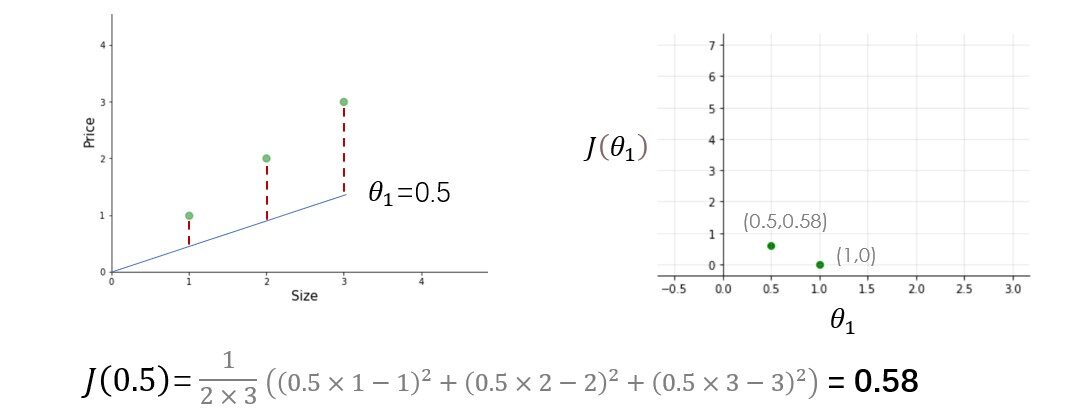
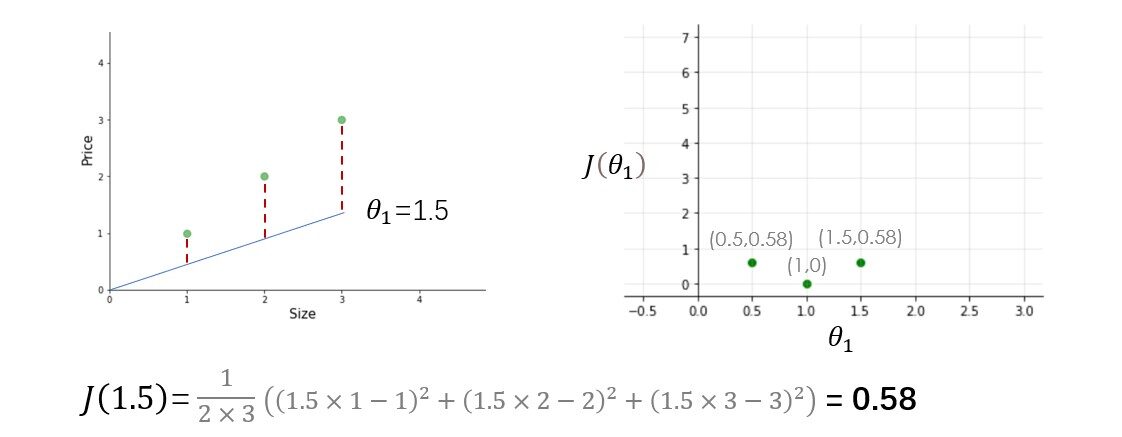
Essayez vous-même d'autres valeurs de thêta1 et calculez le coût de chaque valeur de thêta1. Une fois que j'ai dessiné tous ces points, la fonction de coût ressemblera à une courbe en forme de bol comme le montre la figure ci-dessous.
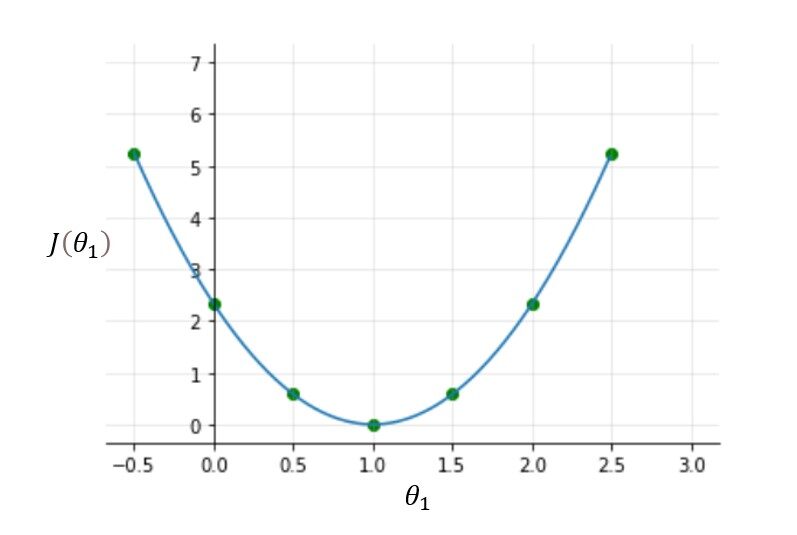
A partir de la figure et du calcul, il est clair que la fonction de coût est minimale à theta1 = 1 ou au bas de la courbe en forme de bol. Le but de tout ce travail acharné n'est pas de calculer la valeur minimale de la fonction de coût, nous avons une meilleure façon de le faire, à sa place, nous essayons de comprendre le relation amoureuse Entre paramètres, fonction d'hypothèse, Oui fonction de coût. Assurez-vous de bien comprendre tous ces concepts avant d'aller plus loin..
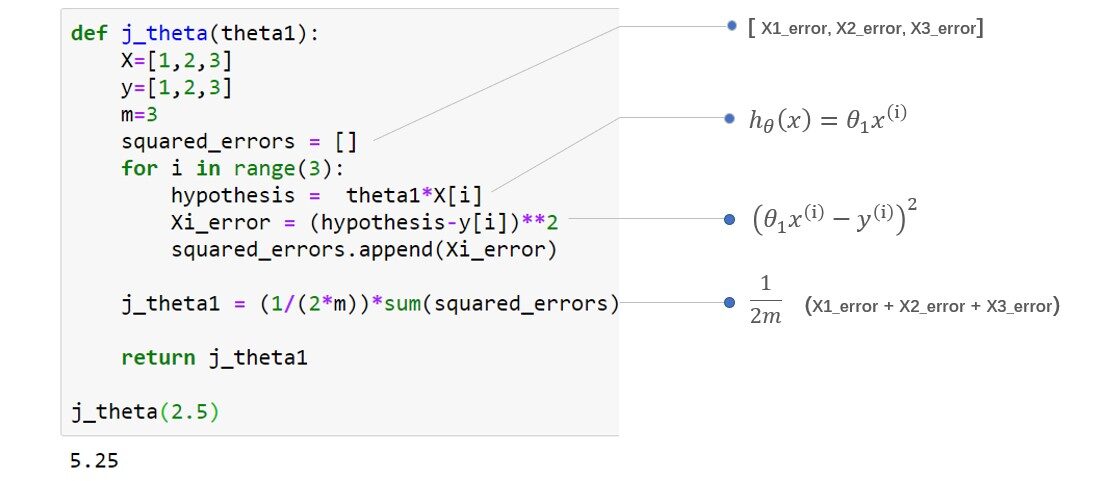
Fonction de coût de codage:
Descente graduelle:
Pourquoi avons-nous besoin d'une descente en pente?
- Bientôt minimiser la fonction de coût, Mais comment? Nous allons voir
La fonction de coût ne fonctionne que lorsque vous connaissez les valeurs des paramètres. Dans l'exemple ci-dessus, on choisit manuellement la valeur des paramètres à chaque fois, mais lors du calcul algorithmique, une fois les valeurs des paramètres initialisées aléatoirement, c'est la descente de la pente qui doit décider quels paramètres. valeur à choisir à l'itération suivante pour minimiser l'erreur, c'est la descente du gradient qui décide de combien augmenter ou diminuer les valeurs des paramètres.
Analogie: Comment fonctionne la descente de gradient?
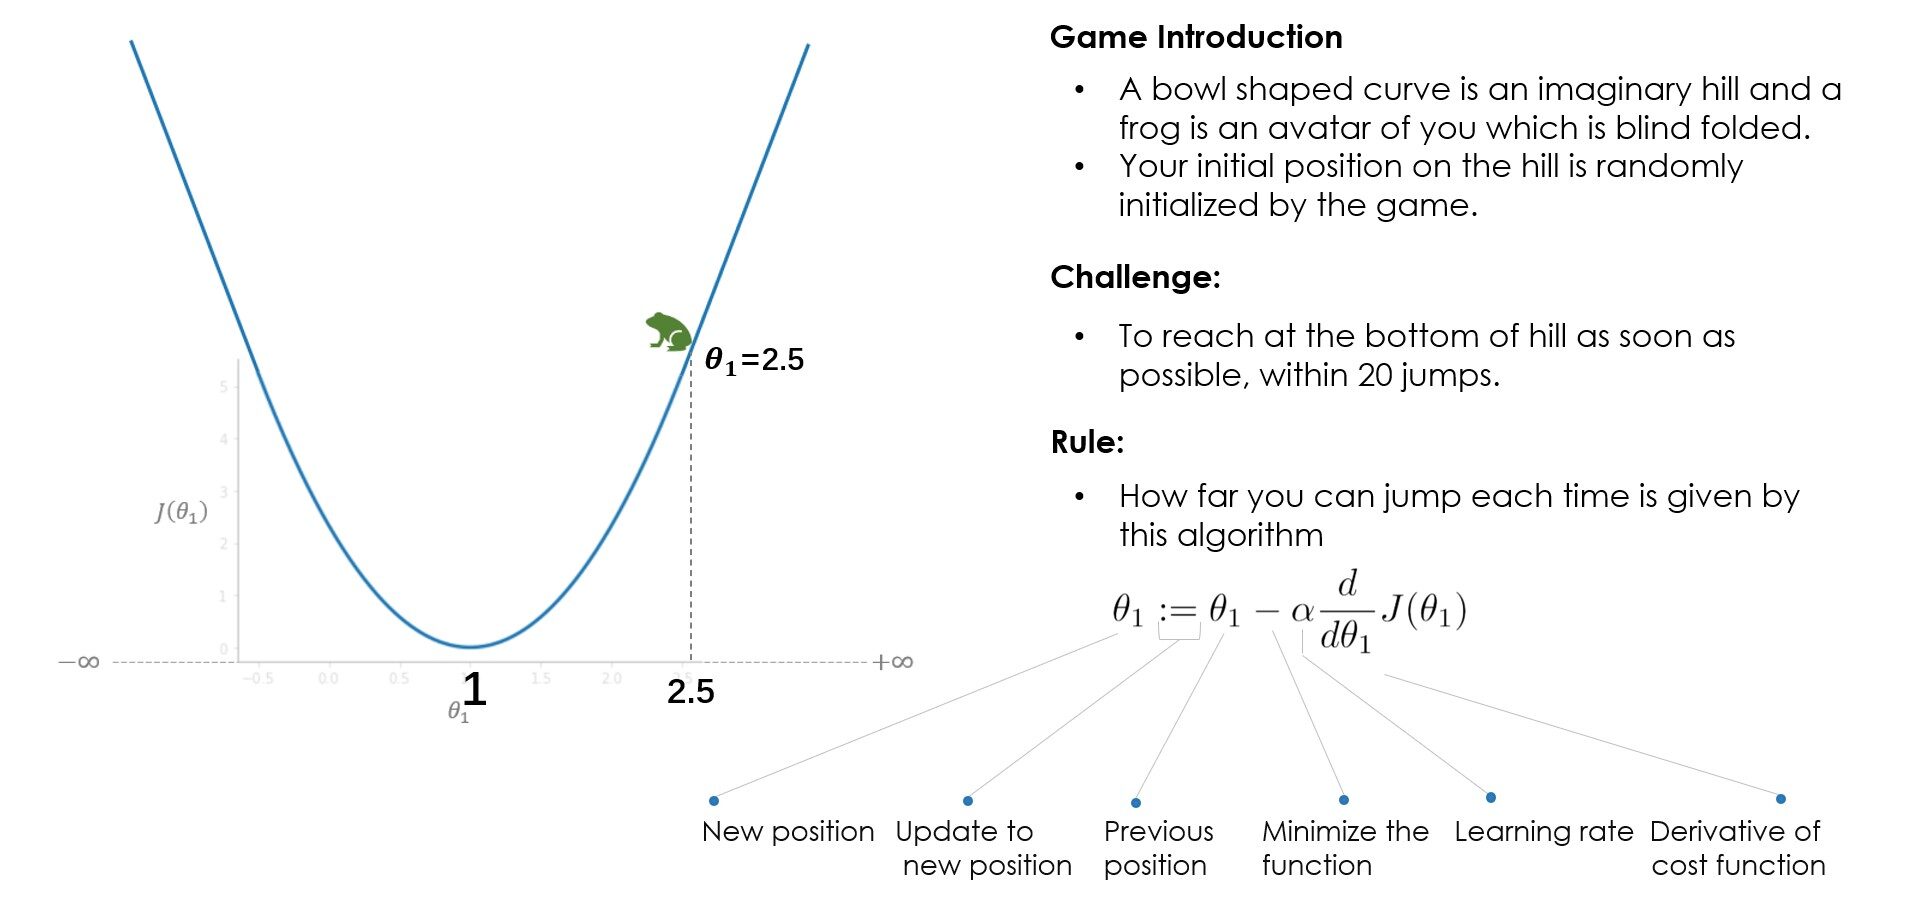
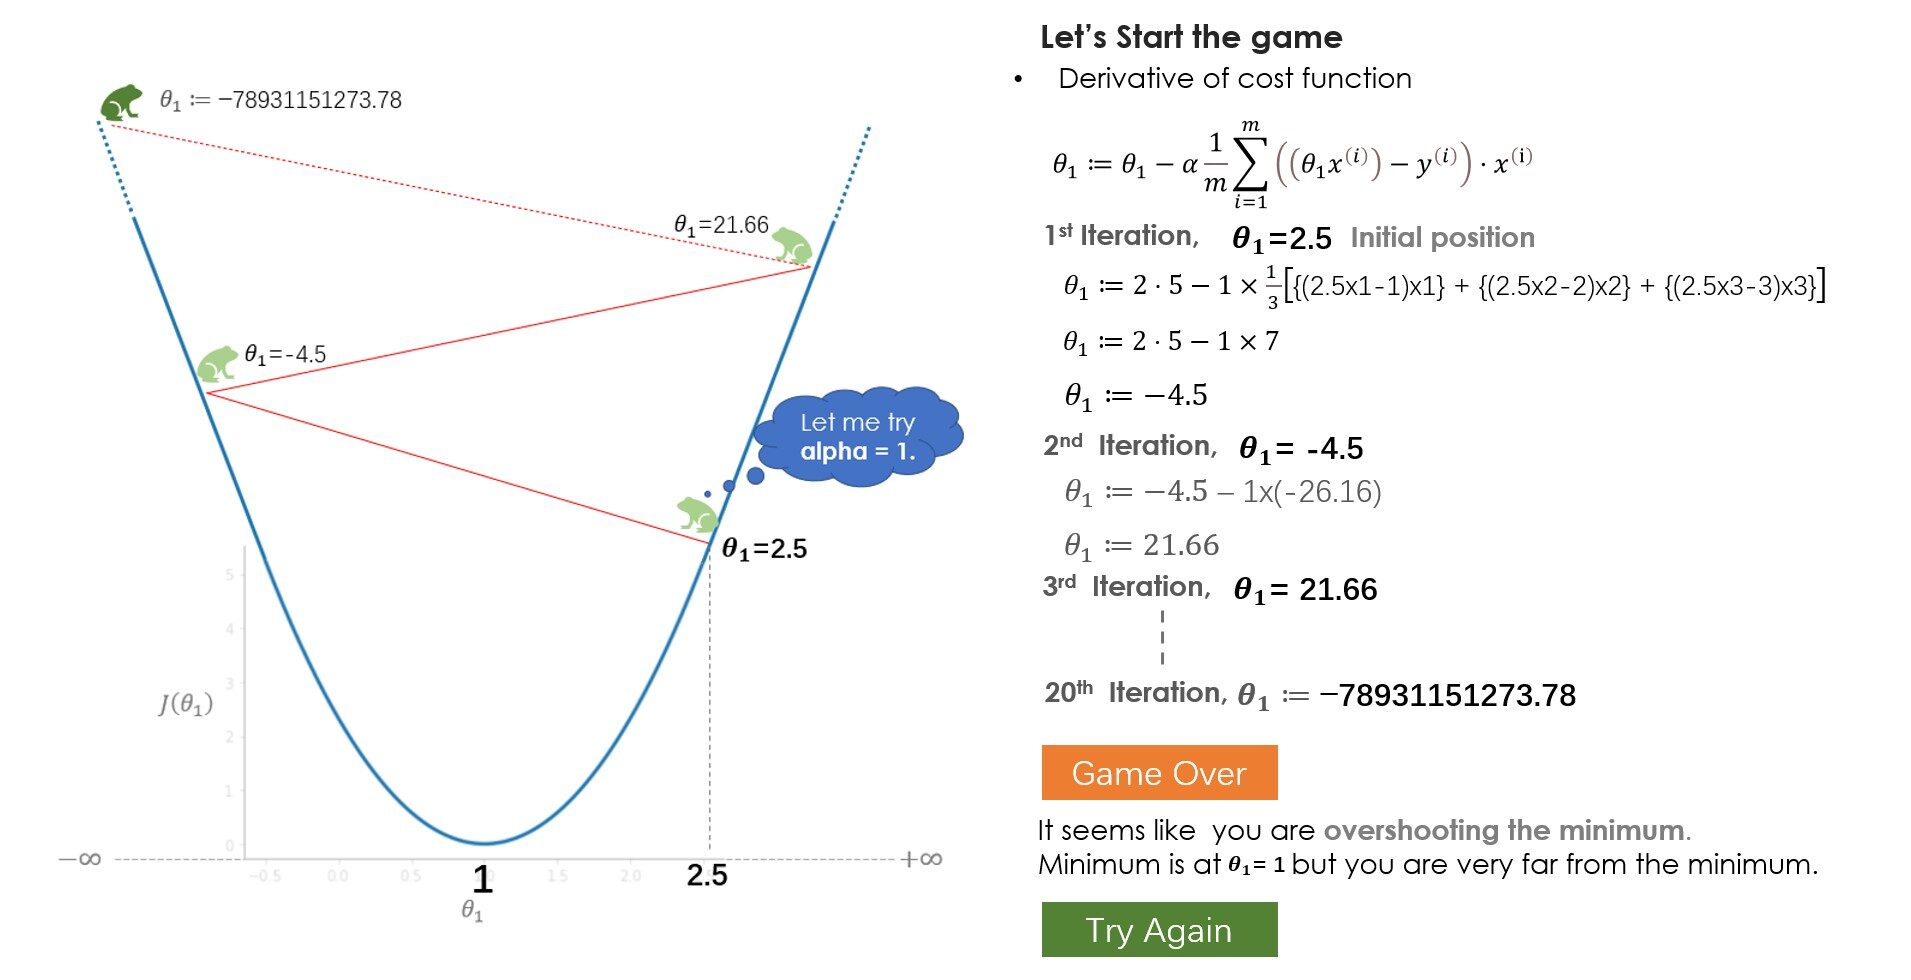
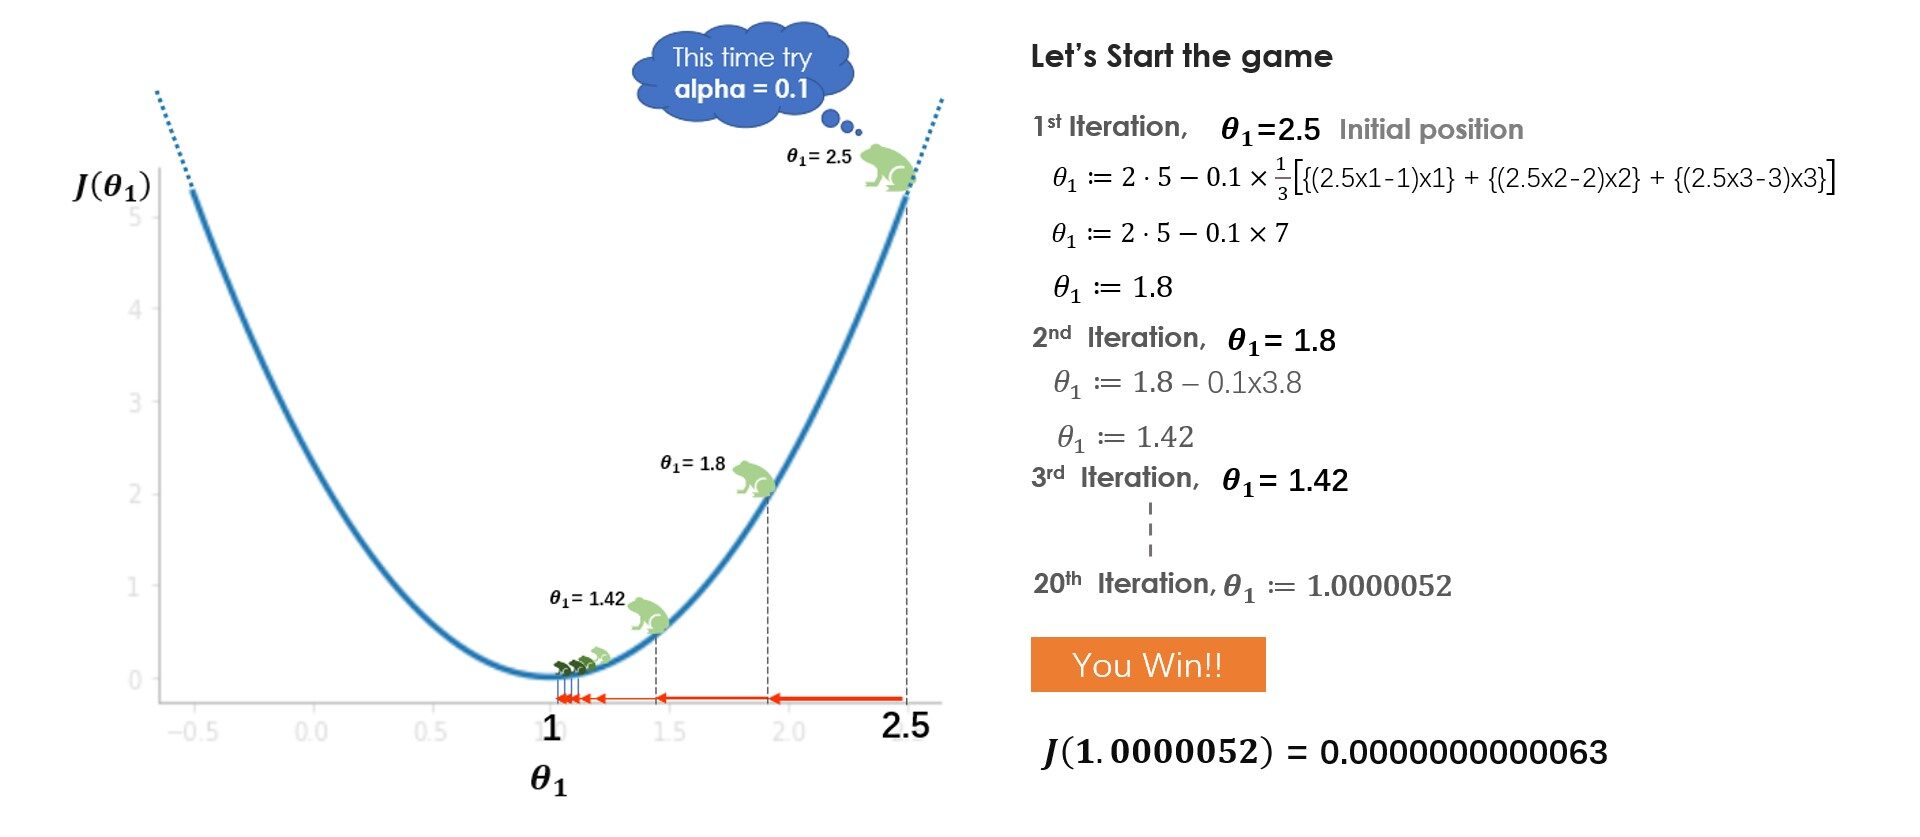
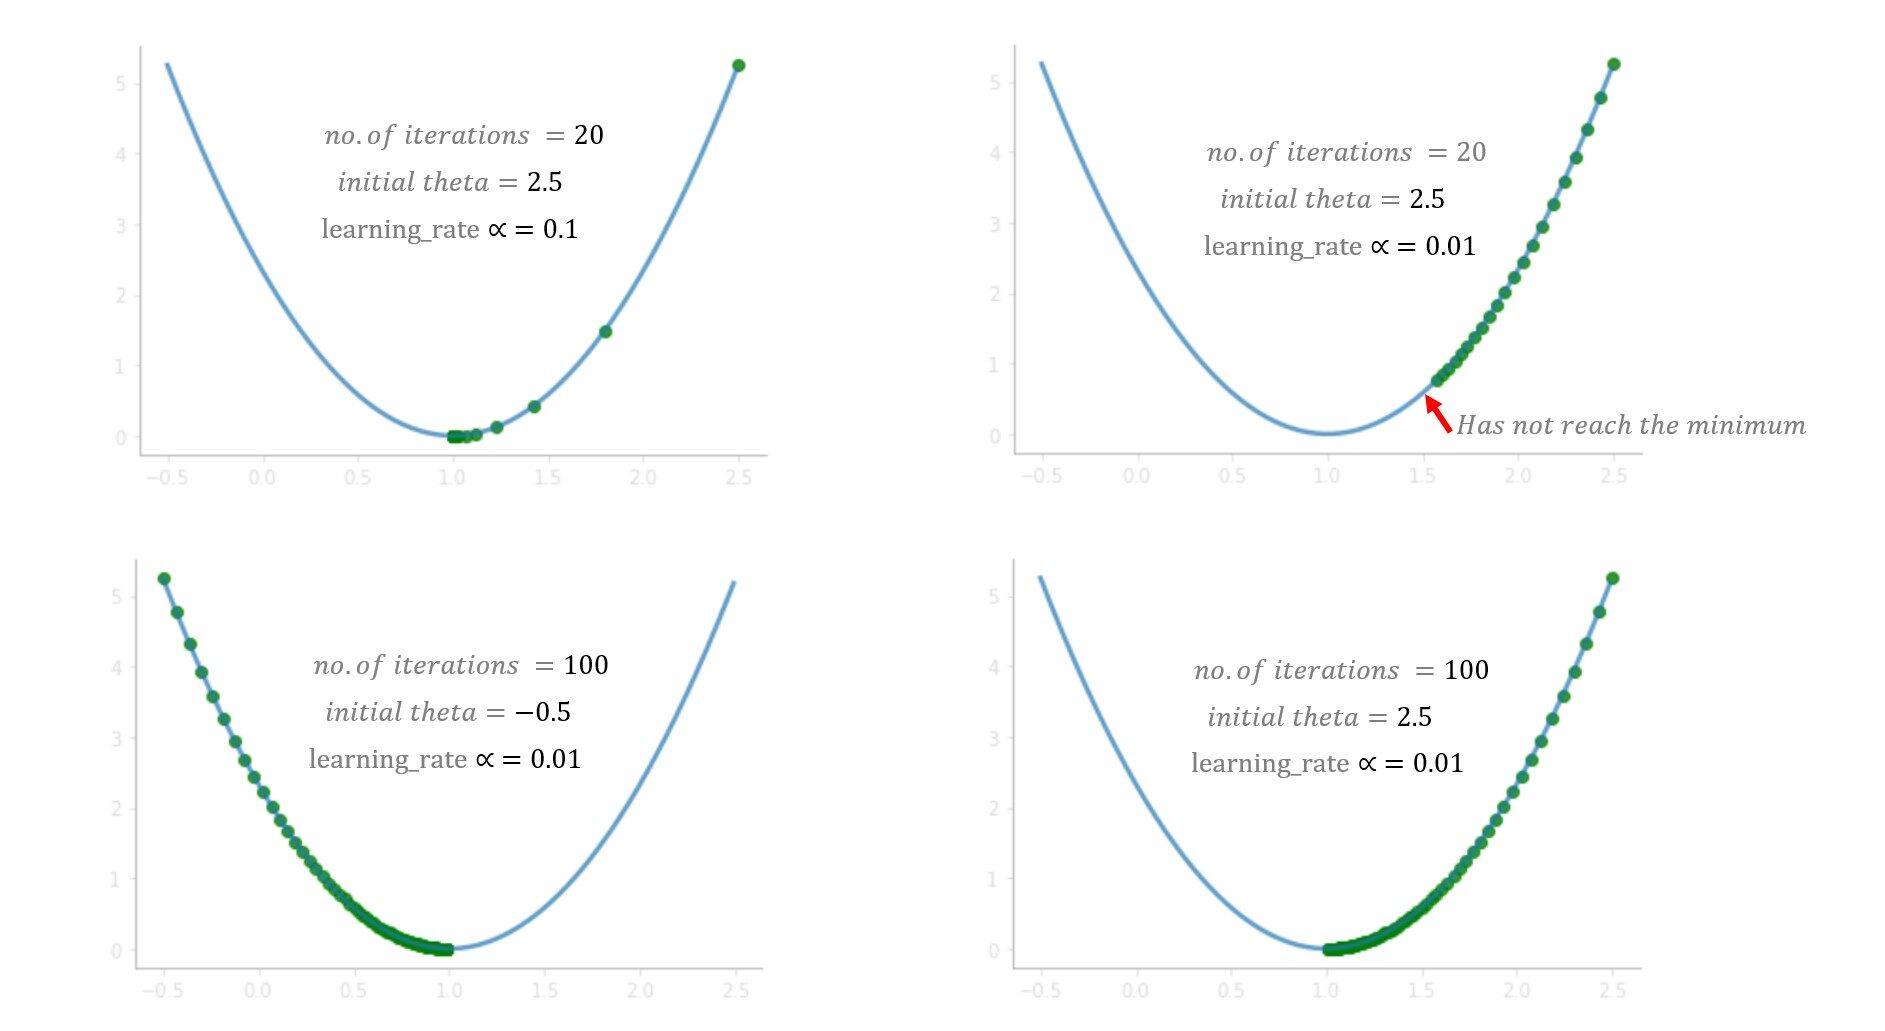
Qu'avez-vous appris du jeu? Au début, vous essayez un taux d'apprentissage (alfa) = 1 mais tu n'atteint pas le minimum, car les plus grands pas dépassent le minimum. Dans le prochain match, tu essaies avec alpha = 0.1, et cette fois tu as réussi à aller au fond en toute sécurité. Et si vous aviez essayé alpha = 0.01? Bon, dans ce cas, tu descendras progressivement mais tu n'arriveras pas au fond, 20 les sauts ne suffisent pas pour aller au fond avec alpha = 0.01, 100 des sauts peuvent suffire. Tout en résolvant un problème du monde réel, normalement un alpha entre 0,01 et 0,1 devrait fonctionner correctement, mais cela varie avec le nombre d'itérations que prend l'algorithme, certains problèmes peuvent nécessiter 100 ou 1000 itérations.
Sur la base de ces facteurs, vous pouvez essayer différentes valeurs alpha. Bien que l'ajustement de la valeur alpha soit l'une des tâches importantes pour comprendre l'algorithme, Je vous suggère de regarder d'autres parties de l'algorithme ainsi que les parties dérivées, le signe moins, mettre à jour les paramètres et comprendre quels sont les rôles de vos individus.
Codage descente de pente
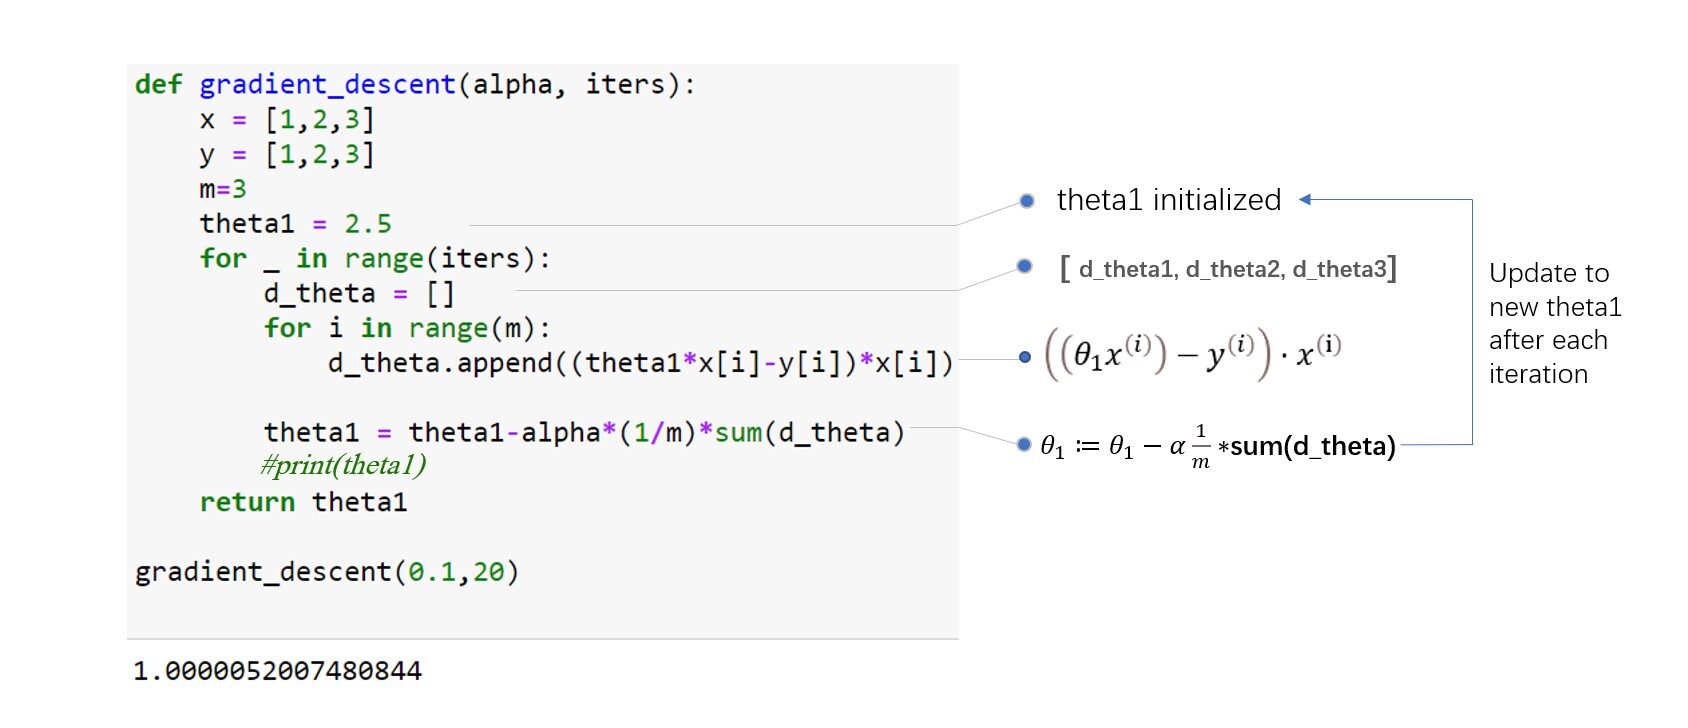
Jusqu'à maintenant, nous n'utilisons qu'un seul paramètre pour calculer la fonction de coût et les algorithmes. À quoi ressemble la fonction de coût et comment fonctionne l'algorithme lorsque nous avons deux paramètres ou plus? Voir la figure ci-dessous pour une compréhension intuitive. Imaginez-vous quelque part au sommet de la montagne et luttant pour descendre la base de la montagne les yeux bandés..
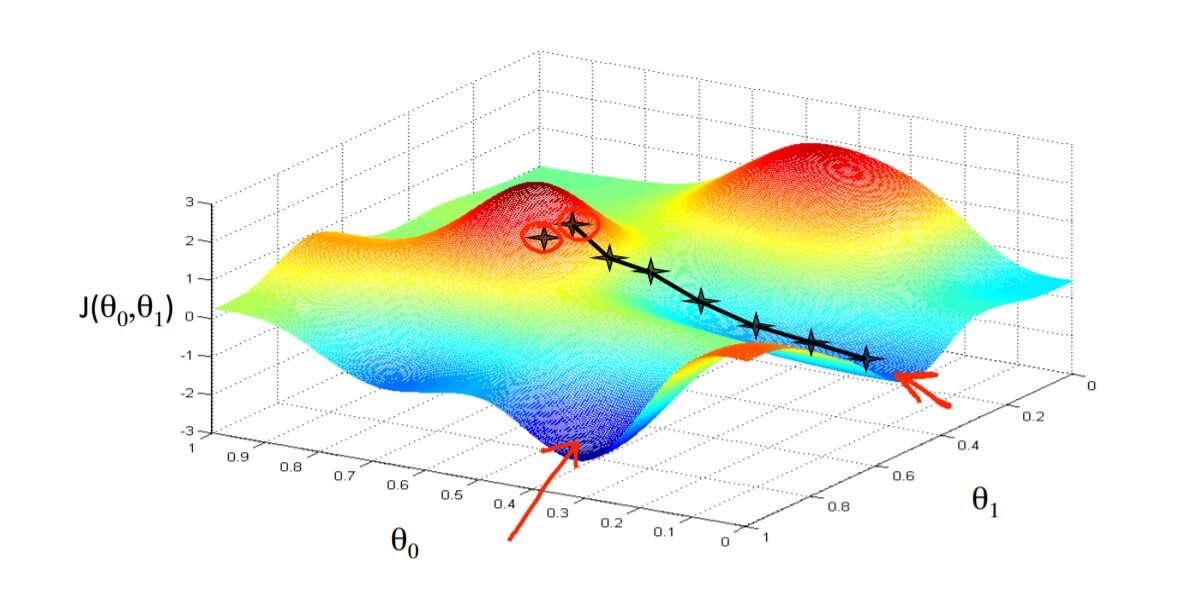
Le principe de fonctionnement de l'algorithme est le même pour un nombre quelconque de paramètres, c'est juste que plus il y a de paramètres plus le sens de la pente est important. Dans l'exemple ci-dessus de la courbe en forme de bol, il suffit d'observer la pente de theta1, mais maintenant l'algorithme doit regarder dans les deux sens pour minimiser la fonction de coût. Codonnons et comprenons l'algorithme. Veuillez vous référer à la figure ci-dessous pour référence:
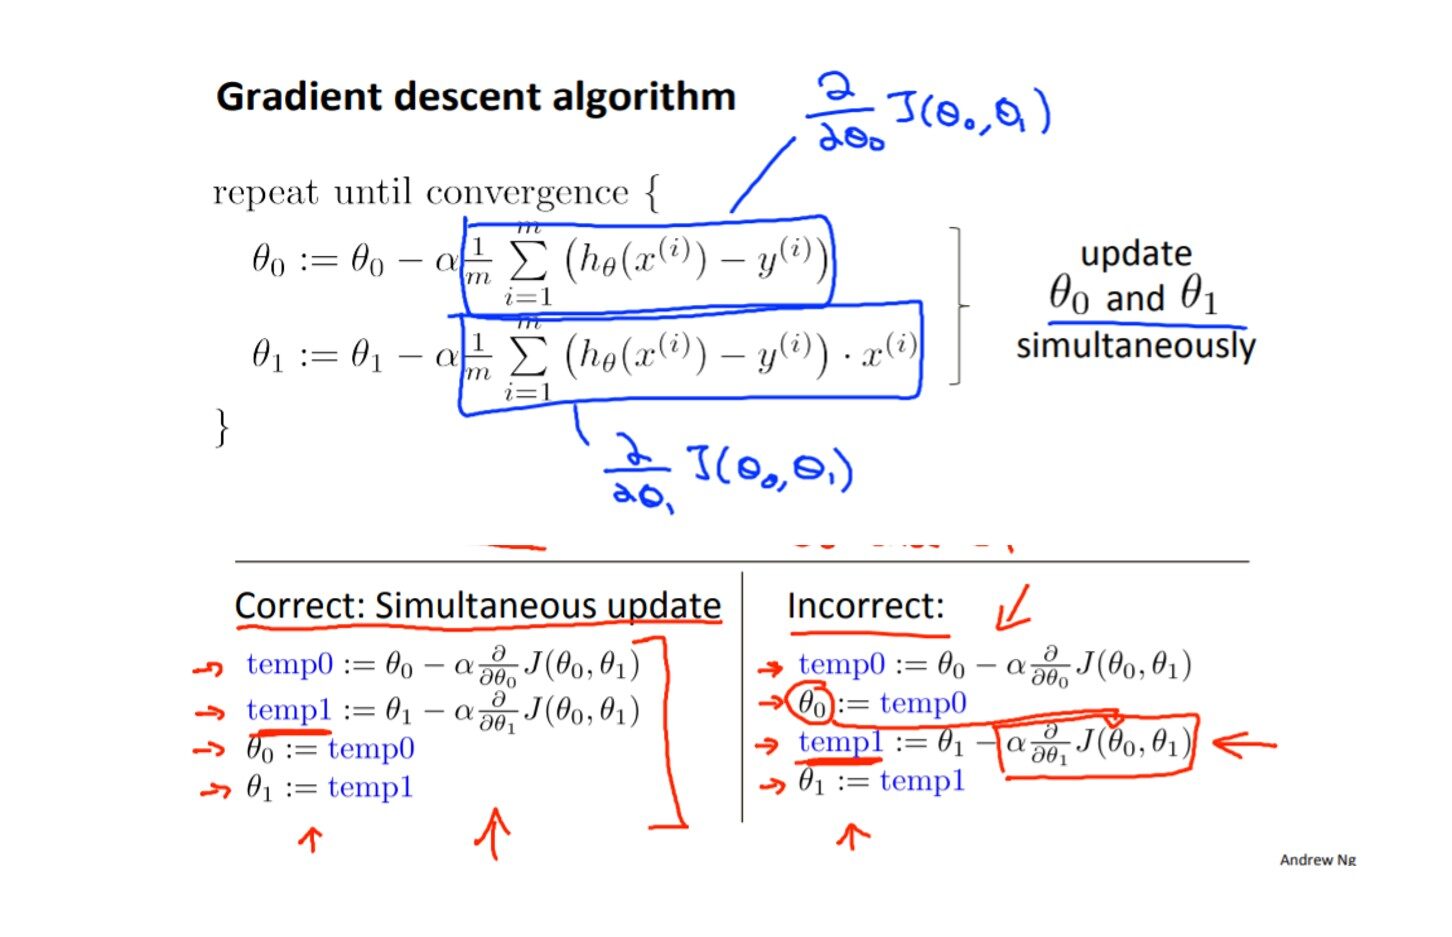
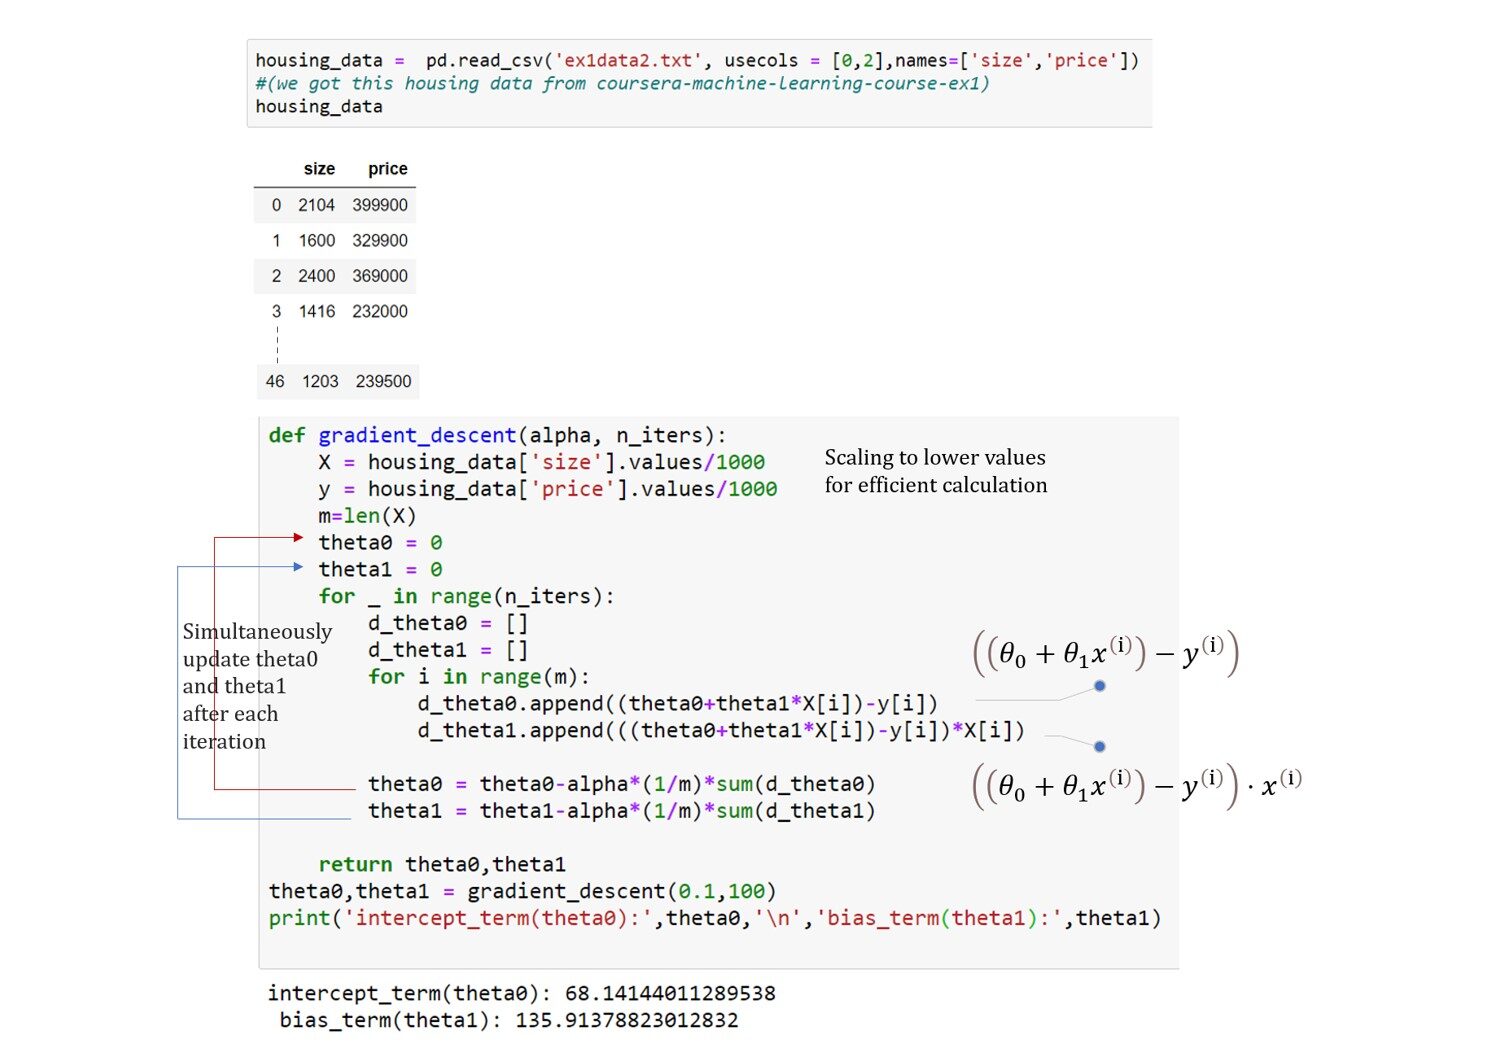
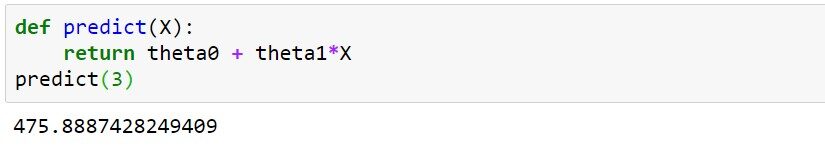
Nous y voilà, notre modèle prédit 475,88 * 1000 = $ 475,880 pour la taille de la maison 3 * 1000 pieds carrés. C'est très proche de notre prédiction que nous avons faite au début en utilisant notre intuition.
conclusion
En tant que débutant, il peut être un peu difficile de comprendre tous les concepts de régression linéaire en un temps de lecture aussi court. Je ne dirais pas que vous savez tout sur la régression linéaire à partir de cet article. Le but de cet article est de rendre les algorithmes compréhensibles le plus simplement possible. Suivez le lien de ressource ci-dessous pour une meilleure compréhension. J'espère que vous avez apprécié la lecture de l'article. Merci pour la lecture.
Moyens:
lien de code
https://github.com/ravi235/LinearRegression
Maths de descente de gradient
https://www.youtube.com/watch?v=jc2IthslyzM&ab_channel=TheCodingTrain
Régression linéaire Andrew Ng
https://www.youtube.com/watch?v=kHwlB_j7Hkc&t=8s&ab_channel=ArtificialIntelligence-AllinOne





