
Cet article a été publié dans le cadre du Blogathon sur la science des données.
introduction
Table des matières
-
Qu'est-ce que la régression linéaire?
-
Importance de la régression linéaire dans l'analyse prédictive.
-
Application pratique de la régression linéaire à l'aide de R.
-
Application de l'ensemble de données sur la pression artérielle et l'âge.
Qu'est-ce qu'une régression linéaire?
L'analyse de régression linéaire simple est une technique pour trouver l'association entre deux variables. Les deux variables impliquées sont une variableEn statistique et en mathématiques, ongle "variable" est un symbole qui représente une valeur qui peut changer ou varier. Il existe différents types de variables, et qualitatif, qui décrivent des caractéristiques non numériques, et quantitatif, représentation de grandeurs numériques. Les variables sont fondamentales dans les expériences et les études, puisqu’ils permettent l’analyse des relations et des modèles entre différents éléments, faciliter la compréhension de phénomènes complexes.... dépendante qui répond au changement et la variable indépendante. Notez que nous ne calculons pas la dépendance de la variable dépendante sur la variable indépendante, juste l'association.
Par exemple, une entreprise investit une certaine somme d'argent dans la commercialisation d'un produit et a également collecté des données de vente au fil des ans en analysant la corrélation entre le budget marketing et les données de vente, nous pouvons prédire la vente de l'année prochaine si l'entreprise alloue une certaine somme d'argent au service marketing. L'idée de prédiction ci-dessus semble magique, mais c'est de la statistique pure. La régression linéaire consiste essentiellement à ajuster une ligne droite à notre ensemble de données afin que nous puissions prédire les événements futurs.
La droite la mieux ajustée serait de la forme:
Y = B0 + B1X
Où, Oui – Variable dépendante
X – Variable indépendante
B0 et B1 – Paramètre de régression
Prédiction de la pression artérielle par âge par régression en R
Équation de la droite de régression dans notre ensemble de données.
TA = 98,7147 + 0,9709 Âge
Importer un jeu de données
Importez un ensemble de données Age vs Blood Pressure qui est un fichier CSV à l'aide de la fonction read.csv () dans R et stockez cet ensemble de données dans une base de données bp.
pb <- lire.csv ("bp.csv")
Créer un bloc de données pour prédire les valeurs
Création d'une base de données qui stockera l'âge de 53 ans. Et ce bloc de données sera utilisé pour prédire la pression artérielle à 53 ans après la création d'un modèle de régression linéaire.
p <-  as.data.frame(53)
noms de colonne(p) <- "Âge"
Créant un Diagramme de dispersionLe nuage de points est un outil graphique utilisé en statistiques pour visualiser la relation entre deux variables. Il se compose d’un ensemble de points dans un plan cartésien, où chaque point représente une paire de valeurs correspondant aux variables analysées. Ce type de graphique vous permet d’identifier des modèles, Tendances et corrélations possibles, faciliter l’interprétation des données et la prise de décision sur la base des informations visuelles présentées.... en utilisant la bibliothèque ggplot2
Prendre l'aide de la bibliothèque ggplot2 dans R, on peut voir qu'il y a une corrélation entre la tension artérielle et l'âge, car nous pouvons voir que l'augmentation de l'âge est suivie d'une augmentation de la pression artérielle.
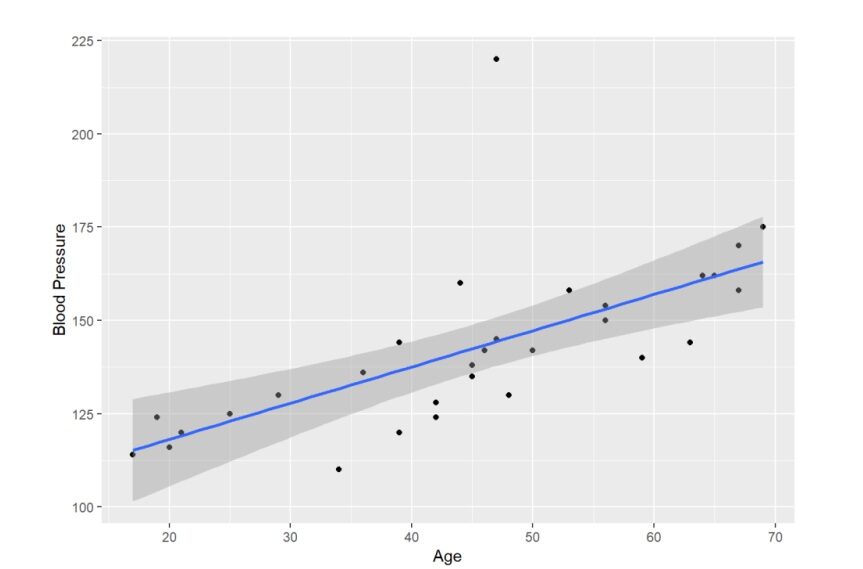
Il est tout à fait évident à partir du graphique que la distribution sur le graphique est dispersée de telle manière que nous pouvons ajuster une ligne droite à travers les points.
Calculer la corrélation entre l'âge et la tension artérielle
Nous pouvons également vérifier notre analyse précédente qu'il existe une corrélation entre la pression artérielle et l'âge en prenant l'aide de la fonction cor () dans R qui est utilisé pour calculer la corrélation entre deux variables.
cor(pb$BP,bp$Âge)
[1] 0,6575673
Créer un modèle de régression linéaire
À présent, à l'aide de la fonction lm (), faisons un modèle linéaire. La fonction lm () a deux attributs, est d'abord une formule où nous allons utiliser « TA ~ Âge » parce que l'âge est une variable indépendante et la pression artérielle est une variable dépendante et la seconde est des données, où nous donnerons le nom de la trame de données qui contient des données qui dans ce cas est la trame de données bp.
maquette <- lm(TA ~ Âge, données = pb)
Résumé de notre modèle de régression linéaire
sommaire(maquette)
Production:
##
## Appel:
## lm(formule = TA ~ Âge, données = pb)
##
## Résidus:
## Min 1Q Médiane 3Q Max
## -21.724 -6.994 -0.520 2.931 75.654
##
## Coefficients:
## Estimation standard. Erreur t valeur Pr(>|t|)
## (Intercepter) 98.7147 10.0005 9.871 1.28e-10 ***
## Âge 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Erreur standard résiduelle: 17.31 au 28 degrés de liberté
## R-carré multiple: 0.4324, R-carré ajusté: 0.4121
## F-statistique: 21.33 au 1 et 28 DF, valeur p: 7.867e-05
Interprétation du modèle
## Coefficients:
## Estimation standard. Erreur t valeur Pr(>|t|)
## (Intercepter) 98.7147 10.0005 9.871 1.28e-10 ***
## Âge 0.9709 0.2102 4.618 7.87e-05 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
B0 = 98.7147 (Oui- intercepter)
B1 = 0.9709 (Coefficient d'âge)
TA = 98.7147 + 0.9709 Âge
Cela signifie qu'un changement dans une unité d'âge apportera 0.9709 unités pour changer la pression artérielle.
Erreur standard C'est la variabilité attendue du coefficient qui capture la variabilité d'échantillonnage, donc la variation de l'intersection peut aller jusqu'à 10.0005 et la variation de l'âge sera 0.2102 pas plus que ça
Valeur T: la valeur t est le coefficient divisé par l'erreur standard, il s'agit essentiellement de la taille estimée par rapport à l'erreur, plus le coefficient est grand par rapport à Std. erreur plus le score t est élevé et le score t est livré avec une valeur p car sa distribution La valeur p est la mesure dans laquelle la variable est statistiquement significative pour le modèle pour un niveau de confiance du 95% nous comparerons cette valeur avec alpha qui sera 0.05 , donc dans notre cas, la valeur p de l'intersection et de l'âge est inférieure à alpha (alfa = 0.05), cela implique que les deux sont statistiquement significatifs pour notre modèle.
## Erreur standard résiduelle: 17.31 dans 28 degrés de liberté
## R carré multiple: 0,4324, R carré ajusté: 0,4121
## F statistique: 21,33 dans 1 Oui 28 DF, valeur p: 7,867e-05
Erreur standard résiduelle ou l'erreur standard du modèle est fondamentalement l'erreur moyenne pour le modèle qui est 17.31 dans notre cas et signifie que notre modèle peut avoir une erreur moyenne de 17.31 tout en prédisant la pression artérielle. Plus l'erreur est petite, meilleur sera le modèle lors de la prédiction.
R-carré multiple est la raison de (1- (somme de l'erreur au carré / somme du total au carré))
R carré ajusté:
Si on ajoute des variables, peu importe si c'est significatif dans la prédiction ou non, la valeur de R au carré augmentera, raison pour laquelle R au carré ajusté est utilisé car si la variable agrégée n'est pas significative pour la prédiction du modèle, la valeur R ajustée au carré réduira, est l'un des outils les plus utiles pour éviter de surajuster le modèle.
F – statistiques est le rapport entre le carré moyen du modèle et le carré moyen de l'erreur, en d'autres termes, c'est la raison pour laquelle le modèle fonctionne bien et qu'est-ce qui fait l'erreur, et plus la valeur F est élevée, mieux le modèle fonctionne par rapport à l'erreur.
L'un est le degré de liberté du numérateur de la statistique F et 28 est le degré de liberté des erreurs.
Prédire la valeur de la pression artérielle à 53 ans
TA = 98,7147 + 0,9709 Âge
La formule ci-dessus sera utilisée pour calculer la pression artérielle à l'âge de 53 années et ceci sera réalisé en utilisant la fonction de prédiction () nous allons d'abord écrire le nom du modèle de régression linéaire en le séparant par une virgule donnant la valeur du nouvel ensemble de données en p depuis l'âge 53 a été précédemment enregistré dans le bloc de données p.
prédire(maquette, nouvelles données = p)
## 1
## 150.1708
Ensuite, la valeur prédite de la pression artérielle est 150,17 aux 53 ans.
Comment nous avons prédit la pression artérielle avec l'association de l'âge, maintenant, il peut y avoir plus d'une variable indépendante impliquée montrant une corrélation avec une variable dépendante appelée régression multiple.
Modèle de régression linéaire multiple
L'analyse de régression multilinéaire est une technique statistique pour trouver l'association de plusieurs variables indépendantes dans la variable dépendante.. Par exemple, le revenu généré par une entreprise dépend de plusieurs facteurs, y compris la taille du marché, le prix, la promotion, le prix du concours, etc. Essentiellement, le modèle de régression linéaire multiple établit une relation linéaire entre une variable dépendante et plusieurs variables indépendantes.
L'équation de régression linéaire multiple est la suivante:
Y = B0 + B1X1 + B2X2 + .. + BnXk + E
Où
Oui – Variable dépendante
X – Variable indépendante
B0, B1, B3,. – Coefficients de régression linéaire multiple
E- Erreur
Prenant un autre exemple du jeu de données Wine et avec l'aide d'AGST, HarvestRain prédit le prix du vin.
Importation du jeu de données
Utilisation de la fonction read.csv (), importer l'ensemble de données wine.csv et wine_test.csv dans le cadre de données wine et wine_test respectivement.
vin <- lire.csv("vin.csv")
test_vin <- lire.csv("test_vin.csv")
Téléchargez le jeu de données ci-dessous
Trouver la corrélation entre différentes variables
Utilisation de la fonction cor () et la fonction ronde () nous pouvons arrondir la corrélation entre toutes les variables de l'ensemble de données sur le vin à deux décimales.
tour(cor(vin),2)
Production:
Année Prix WinterRain AGST HarvestRain Age FrancePop
## Année 1.00 -0.45 0.02 -0.25 0.03 -1.00 0.99
## Prix -0.45 1.00 0.14 0.66 -0.56 0.45 -0.47
## HiverPluie 0.02 0.14 1.00 -0.32 -0.28 -0.02 0.00
## AGST -0.25 0.66 -0.32 1.00 -0.06 0.25 -0.26
## RécoltePluie 0.03 -0.56 -0.28 -0.06 1.00 -0.03 0.04
## Âge -1.00 0.45 -0.02 0.25 -0.03 1.00 -0.99
## FrancePop 0.99 -0.47 0.00 -0.26 0.04 -0.99 1.00
Parcelles éparses
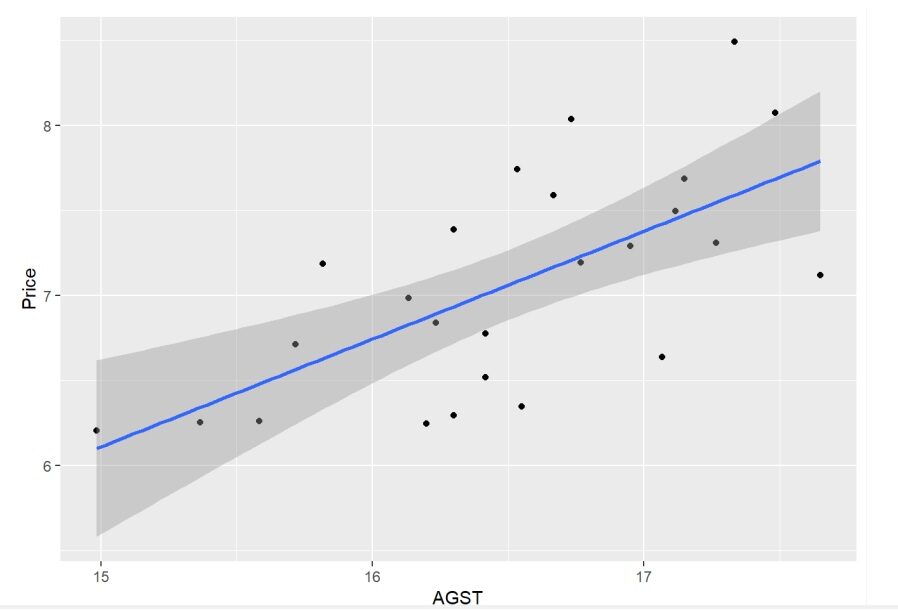
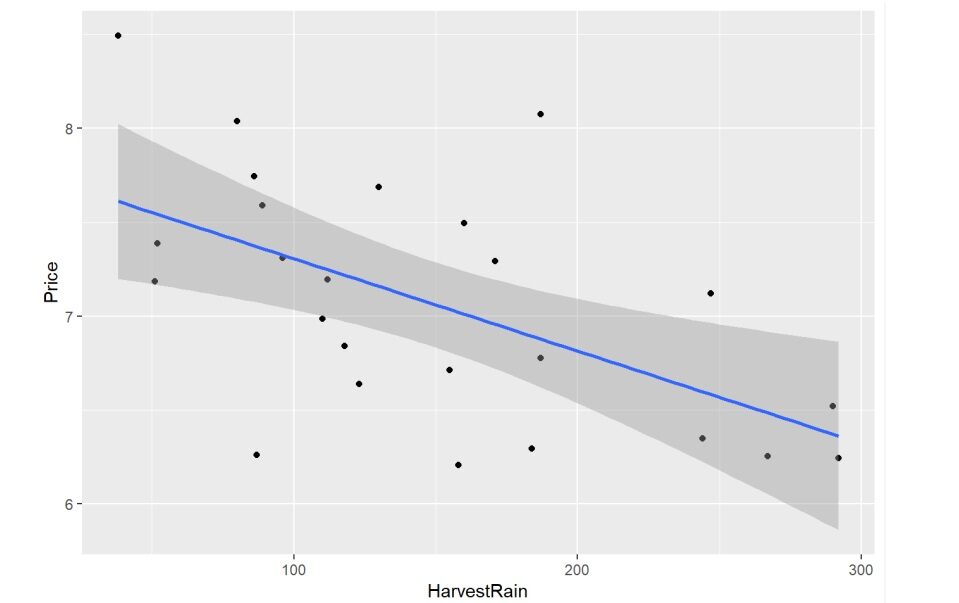
Lors de l'utilisation de la bibliothèque ggplot2 dans R, créer un nuage de points qui peut clairement montrer que l'AGST et le prix du vin sont fortement corrélés. De la même manière, les nuage de pointsUn nuage de points est une représentation visuelle qui montre la relation entre deux variables numériques à l’aide de points sur un plan cartésien. Chaque axe représente une variable, et l’emplacement de chaque point indique sa valeur par rapport aux deux. Ce type de graphique est utile pour identifier des modèles, Corrélations et tendances dans les données, faciliter l’analyse et l’interprétation des relations quantitatives.... entre HarvestRain et le prix du vin montre également leur corrélation.
ggplot(vin,aes(x = AGST, y = Prix)) + geom_point() +geom_smooth(méthode = "lm")
ggplot(vin,aes(x = RécoltePluie, y = Prix)) + geom_point() +geom_smooth(méthode = "lm")
Créer un modèle de régression multilinéaire
modèle1 <- lm(Prix ~ AGST + RécoltePluie,données = vin) sommaire(modèle1)
Production:
##
## Appel:
## lm(formule = Prix ~ AGST + RécoltePluie, données = vin)
##
## Résidus:
## Min 1Q Médiane 3Q Max
## -0.88321 -0.19600 0.06178 0.15379 0.59722
##
## Coefficients:
## Estimation standard. Erreur t valeur Pr(>|t|)
## (Intercepter) -2.20265 1.85443 -1.188 0.247585
## AGST 0.60262 0.11128 5.415 1.94e-05 ***
## RécoltePluie -0.00457 0.00101 -4.525 0.000167 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Erreur standard résiduelle: 0.3674 au 22 degrés de liberté
## R-carré multiple: 0.7074, R-carré ajusté: 0.6808
## F-statistique: 26.59 au 2 et 22 DF, valeur p: 1.347e-06
Interprétation du modèle
## Coefficients: ## Estimation standard. Erreur t valeur Pr(>|t|) ## (Intercepter) -2.20265 1.85443 -1.188 0.247585 ## AGST 0.60262 0.11128 5.415 1.94e-05 *** ## RécoltePluie -0.00457 0.00101 -4.525 0.000167 *** ## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1 B0 = 98.7147 (Oui- intercepter) B1 = 0.9709 (Coefficient d'âge) Prix = -2.20265 + 0.60262 AGST - 0.00457 RécoltePluie
Cela signifie qu'un changement d'unité dans AGST apportera 0,60262 unités de changer de prix et un changement d'unité dans HarvestRain apportera 0,00457 unités pour changer de prix.
Erreur standard est la variabilité attendue du coefficient qui capture la variabilité d'échantillonnage, donc la variation de l'intersection peut aller jusqu'à 1.85443 et la variation de l'AGST sera 0.11128 et la variation de HarvestRain est 0.00101 pas plus que ça
Valeur T: la valeur t est le coefficient divisé par l'erreur standard, il s'agit essentiellement de la taille estimée par rapport à l'erreur, plus le coefficient est grand par rapport à Std. erreur plus le score t est élevé et le score t est livré avec une valeur p car il s'agit d'une distribution. La valeur p est la mesure dans laquelle la variable est statistiquement significative pour le modèle pour un niveau de confiance du 95% nous comparerons cette valeur avec alpha pour être 0.05, donc dans notre cas la p-valeur de l'intersection, AGST et HarvestRain est inférieur à l'alpha (alfa = 0.05), cela implique qu'ils sont tous statistiquement significatifs pour notre modèle.
## Erreur standard résiduelle: 0.3674 dans 22 degrés de liberté
## R carré multiple: 0,7074, R carré ajusté: 0,6808
## F statistique: 26.59 dans 2 Oui 22 DF, valeur p: 1.347e-06
Erreur standard résiduelle ou l'erreur standard du modèle est fondamentalement l'erreur moyenne pour le modèle qui est 0.3674 dans notre cas et signifie que notre modèle peut avoir une différence moyenne de 0.3674 en prévoyant le prix des vins. Plus l'erreur est petite, meilleur sera le modèle lors de la prédiction.
R-carré multiple est la raison de (1- (somme de l'erreur au carré / somme du total au carré))
R carré ajusté:
Si on ajoute des variables, peu importe si c'est significatif dans la prédiction ou non, la valeur de R au carré augmentera, raison pour laquelle R au carré ajusté est utilisé car si la variable agrégée n'est pas significative pour la prédiction du modèle, la valeur R ajustée au carré réduira, est l'un des outils les plus utiles pour éviter de surajuster le modèle.
F – statistiques est le rapport entre le carré moyen du modèle et le carré moyen de l'erreur, en d'autres termes, c'est la raison pour laquelle le modèle fonctionne bien et qu'est-ce qui fait l'erreur, et plus la valeur F est élevée, mieux le modèle fonctionne par rapport à l'erreur.
Deux sont les degrés de liberté du numérateur de la statistique F et 22 est le degré de liberté des erreurs.
Prédiction des valeurs pour notre suite de tests
prédiction <- prédire(modèle1, newdata = wine_test)
Valeurs prédites avec l'ensemble de données de test
dégustation de vins
## Année Prix WinterRain AGST HarvestRain Age FrancePop
## 1 1979 6.9541 717 16.1667 122 4 54835.83
## 2 1980 6.4979 578 16.0000 74 3 55110.24
prédiction
## 1 2
## 6.982126 7.101033
conclusion
Comme nous pouvons le voir, à partir de l'ensemble de données disponible, nous pouvons créer un modèle de régression linéaire et entraîner ce modèle, si suffisamment de données sont disponibles, nous pouvons prédire avec précision de nouveaux événements ou, en d'autres termes, résultats futurs.





